2026年10月28日、ComfyUI 本体に MiniMax H3 向けの機能が2つ入りました。動画の下書きを潜在空間のまま拡大する「潜在アップスケール」と、デコードを速くする「Sol-H3-VAE」への対応です。
この記事では、768p で作った H3 の動画を 2K(2560×1440)に仕上げるワークフローを組みました。RTX 5090 で、どの段階に何秒かかるかを測っています。使ったのは ComfyUI 本体のノードだけで、カスタムノードは入れていません。
この記事でわかること
- 2K に仕上げるワークフローの組み方(配布 JSON あり)と、各段階の時間と VRAM(低解像度生成・拡大・再サンプリング・デコード)
- 2K を直接生成した場合、従来の「画像に戻して拡大」した場合との比較
- 標準 VAE と Sol-H3-VAE の速さと画質の違い、音声がどう扱われるか
先に結論(今回のテスト条件で)
| 経路(5秒・124フレーム) | 時間 |
|---|---|
| 2K(2560×1440)を直接生成(Turbo 8ステップ) | 1,138秒 |
| 768p で生成 → 潜在アップスケール → 3ステップ再サンプリング → Sol int8 でデコード | 503秒 |
- 768p で作って 2K に仕上げると、直接生成より 約56%短く(約2.3倍速く)なりました。ただし同じシードでも、直接生成とは構図が違う絵になります。
- 潜在アップスケールの処理そのものは 1.5秒 です。画像に戻して拡大し、再エンコードする従来の方法より約60秒短くなります。
- 2K のデコードは、Sol-H3-VAE(int8)が 7.1秒、標準 VAE(int8)が18.5秒でした。約2.6倍速い代わりに、VRAM を多く使います。
- 2K 仕上げで一番時間がかかるのは 再サンプリング で、1ステップ約129秒でした。通しの約77%を占めます。
- denoise 0.30・3ステップがおすすめです。0.44 にすると、絵の中身まで変わりました。
- 音声は拡大ではそのまま通ります。再サンプリングすると音も作り直されるので、元の音を残したいときは音声だけ1段目のものに戻します。
試した環境
| 項目 | 内容 |
|---|---|
| GPU | RTX 5090(32GB)、ドライバー 621.01。計測前に他アプリが使っていた VRAM は約1.8GB |
| CPU / RAM | Ryzen 9 9950X3D / 128GB |
| OS | Windows 11 |
| ComfyUI | ポータブル版+master コミット 17ff1dcce963bd9f23095ec9b28febbfc4db8388(2026-11-01 19:14 UTC、v0.43.0-26-g17ff1dcc)。フロントエンド 1.57.6 |
| Python / PyTorch | 3.13.14 / 2.14.0+cu130 |
| カスタムノード | なし |
| 生成条件 | 5秒(124フレーム・24fps)、同じプロンプト・シード(20261102) |
| モデル | fl2va pruned int8 / qwen3vl nvfp4 / 映像 VAE int8 / 音声 VAE fp32 / 公式 Turbo LoRA(fl2v 8step、強さ1.0) |
| 1段目の設定 | res_multistep・simple・8ステップ |
| 測り方 | ノードごとの実行時間。モデル読み込み後(2回目以降)の値で、初回の読み込み込みは別に記載。VRAM・RAM は1秒ごとに記録したピーク |
2つの機能が入っていることは、git で確かめました。
| PR | 内容 | マージコミット | マージ日時(UTC) |
|---|---|---|---|
| #17412 | 潜在アップスケール | 35060f0 | 2026-10-28 20:05 |
| #17411 | Sol-H3-VAE 対応 | 0df1646 | 2026-10-28 23:46 |
2つの新機能で何が変わる?
潜在アップスケール(PR #17412)
H3 が作った動画の latent(潜在)を、画像に戻さずに拡大する機能です。latent は、画像を圧縮した中間データのことです。
- ノード:
MiniMax H3 Latent Upscale With Model(出力の既定は 2560×1440、32刻み) - 読み込み:既存の
Load Latent Upscale Modelで読みます - 重み:LBH-123-AI/Minimax_h3_latent_Upscaler の
minimax_h3_latent_upscaler_3d_conv_v1_bf16.safetensors(690.6MB)。models\latent_upscale_modelsに置きます - 音声:拡大しても音声の latent はそのまま通ります
前回の記事で紹介したサードパーティの Latent Upscaler と同じ重みを、ComfyUI 本体のノードで使えるようにしたものです。
アップスケーラーのモデルカードには、次のように書かれています(当サイトの実測ではありません)。
| 項目 | モデルカードの記載 |
|---|---|
| ライセンス | Apache-2.0(リポジトリに LICENSE ファイルはなし) |
| パラメーター数 | 345,280,216 |
| サイズ | bf16・fp16 各約691MB、fp32 .pth 約1.38GB |
| 学習データ | 約8万ペア(動画約7万、2K 画像約8千)。出所の記載なし |
| 倍率 | 1.0〜4.0倍 |
Sol-H3-VAE 対応(PR #17411)
Sol-H3-VAE は、H3 の標準デコーダー(36層)を、24層・16.2億パラメーターの非因果デコーダーに蒸留したものです(モデルカードの説明)。蒸留は、大きなモデルの動きを小さなモデルに覚えさせる方法です。新しいノードはなく、ふつうの Load VAE で読めます。
今回使ったファイルは3つです。どれも models\vae に置きます。
| ファイル | 入手元 | サイズ |
|---|---|---|
minimax_h3_sol_vae_int8_convrot.safetensors | Comfy-Org/MiniMax-H3 の vae/ | 1.99GB |
minimax_h3_sol_vae_fp16.safetensors | 同上 | 3.60GB |
sol_h3_vae.safetensors(fp32、デコーダーのみ) | Efficient-Large-Model/Sol-H3-VAE | 6.47GB |
モデルカードと PR の値(当サイトの実測ではありません)
| 出典・条件 | 標準 VAE | Sol |
|---|---|---|
| モデルカード:768p・RTX 5090(eager) | 12.5秒 | 5.0秒 |
| モデルカード:720p・GB200(CUDA グラフ) | 6.16秒 | 0.34秒 |
| モデルカード:2K・GB200(CUDA グラフ) | 14.5秒 | 0.89秒 |
| PR #17411:1344×768×124 フレーム・RTX 5090 | fp16 10.7秒 / int8 4.61秒 | fp16 3.28秒 / int8 1.70秒 |
PSNR(元の画像にどれだけ近いかを表す数値。高いほど近い)は、検証用の latent で45.4dB、生成した 768p の動画で38.2dB とされています。2K の値は GB200 と CUDA グラフの条件なので、RTX 5090 の目安にはなりません。
ComfyUI を master にする
リリース版には入っていないので、master の ComfyUI を用意します。いま使っている環境を壊さないように、別のフォルダーに用意するのがおすすめです。当サイトでは、ポータブル版をもう1つ作り、ComfyUI 本体だけ master に入れ替えました。
git clone https://github.com/Comfy-Org/ComfyUI.git
cd ComfyUI
git checkout 17ff1dcc
git log --oneline -1
git checkout 17ff1dcc は、当サイトが測ったコミットに固定する手順です。当サイトでは、clone した時点の master の先端がこのコミットでした。最新の master で試すときは、この行を飛ばします。
master は毎日変わるので、動かなくなったときのためにコミットを控えておきます。モデルは extra_model_paths.yaml で既存のフォルダーを読ませると、二重に置く必要がありません。
ワークフローの組み方
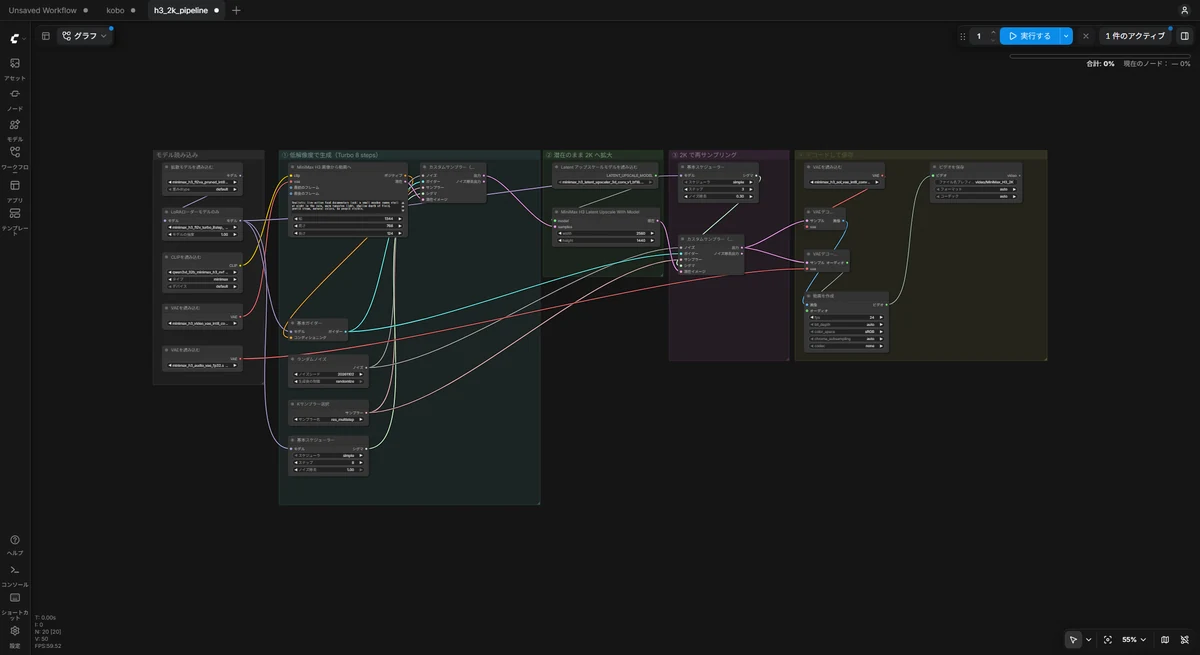
- 1段目:いつもの H3 T2V を 1344×768・Turbo 8ステップで作ります
- 拡大:
Load Latent Upscale Model→MiniMax H3 Latent Upscale With Model(2560×1440) - 2段目:拡大した latent を、同じモデル・同じシードで再サンプリングします。BasicScheduler を steps 3・denoise 0.30 にします。テキストは1段目のものをそのまま使います
- デコード:
Load VAEで Sol int8 を読み、VAE Decode → 動画として保存
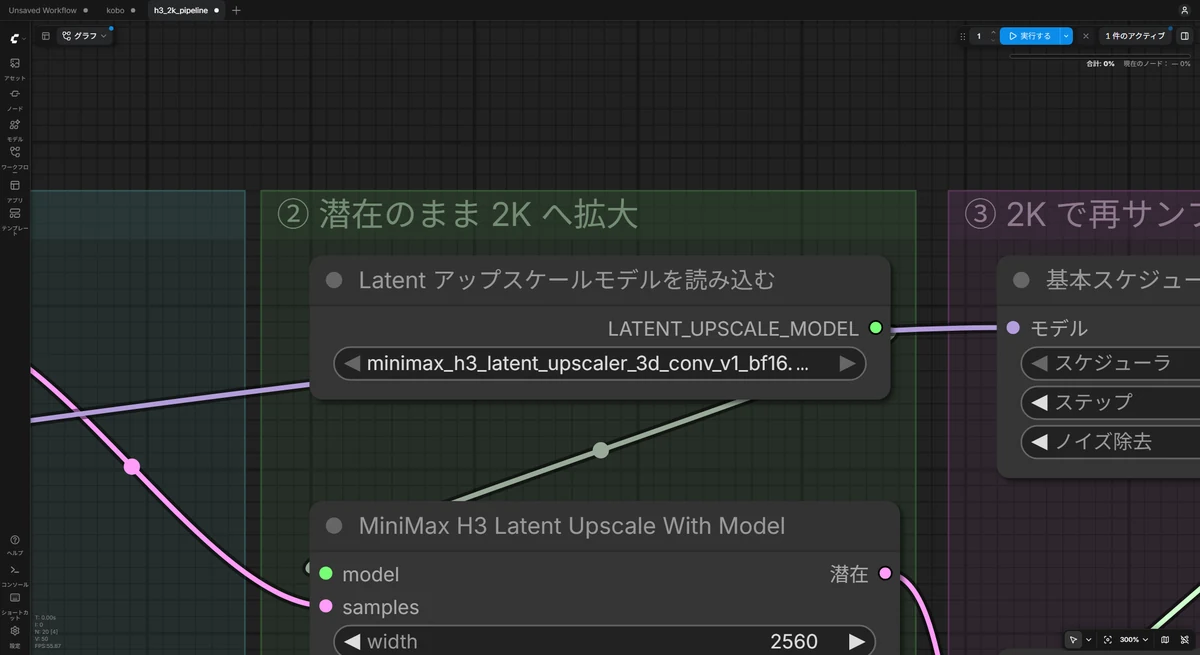
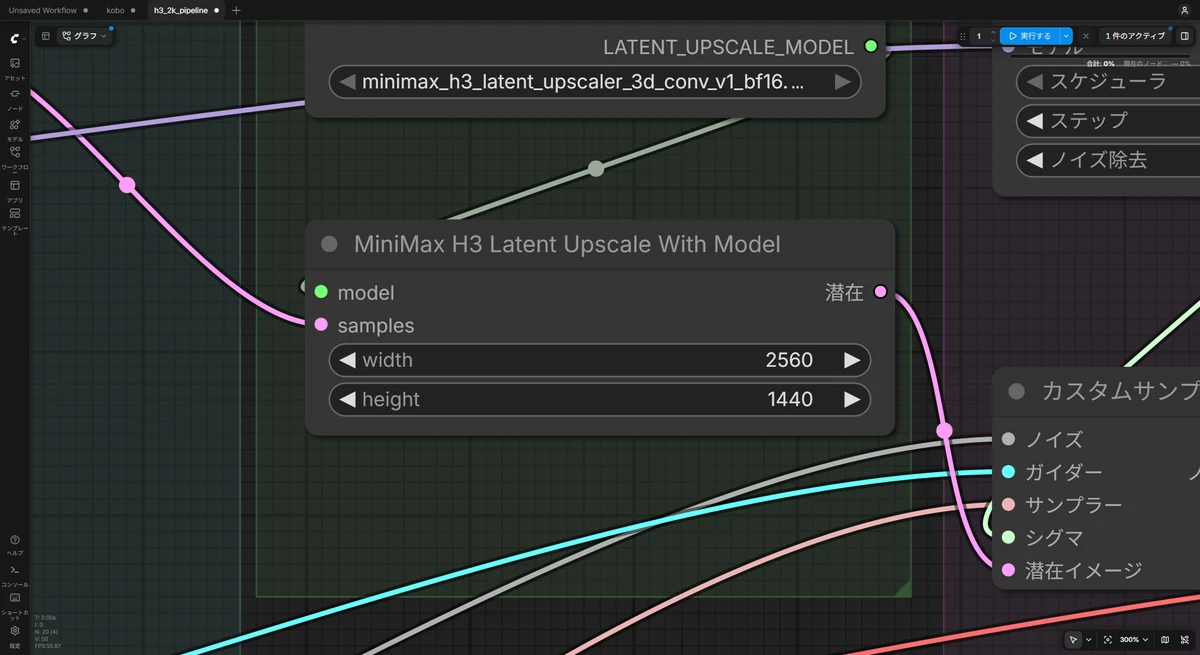
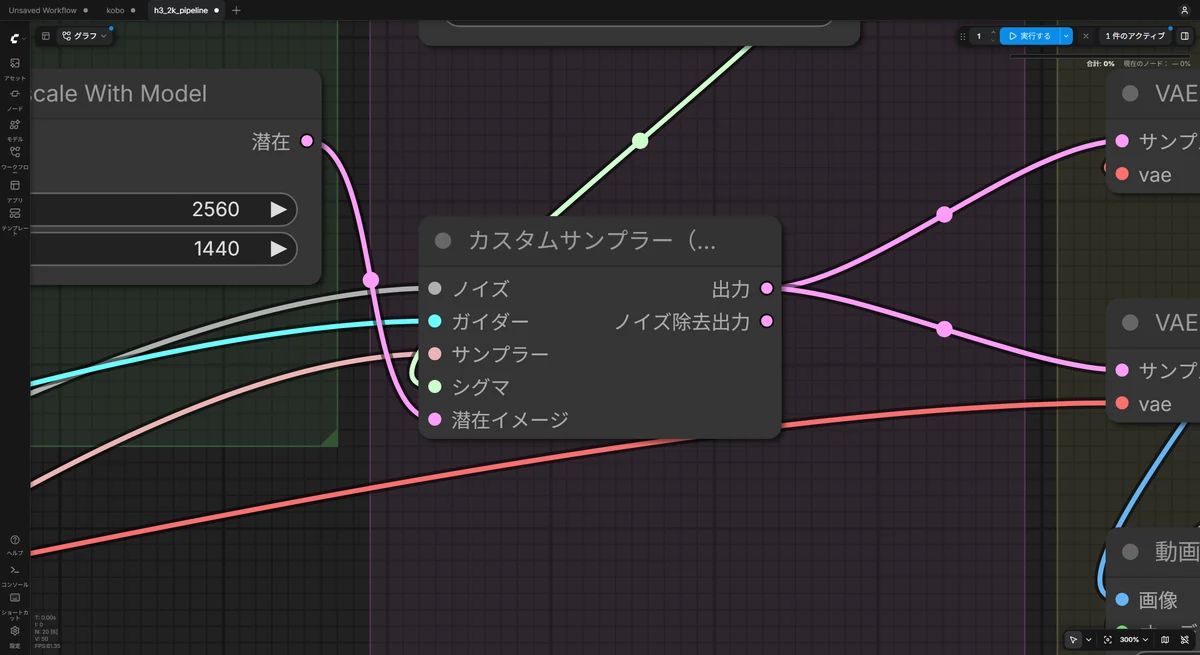
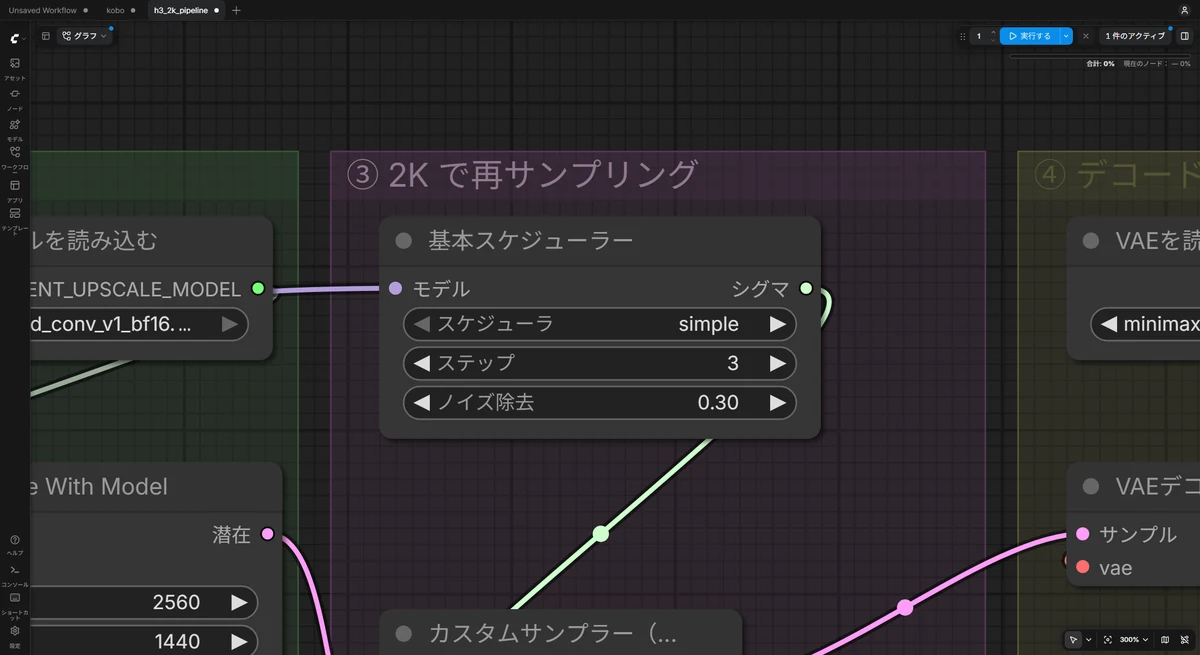
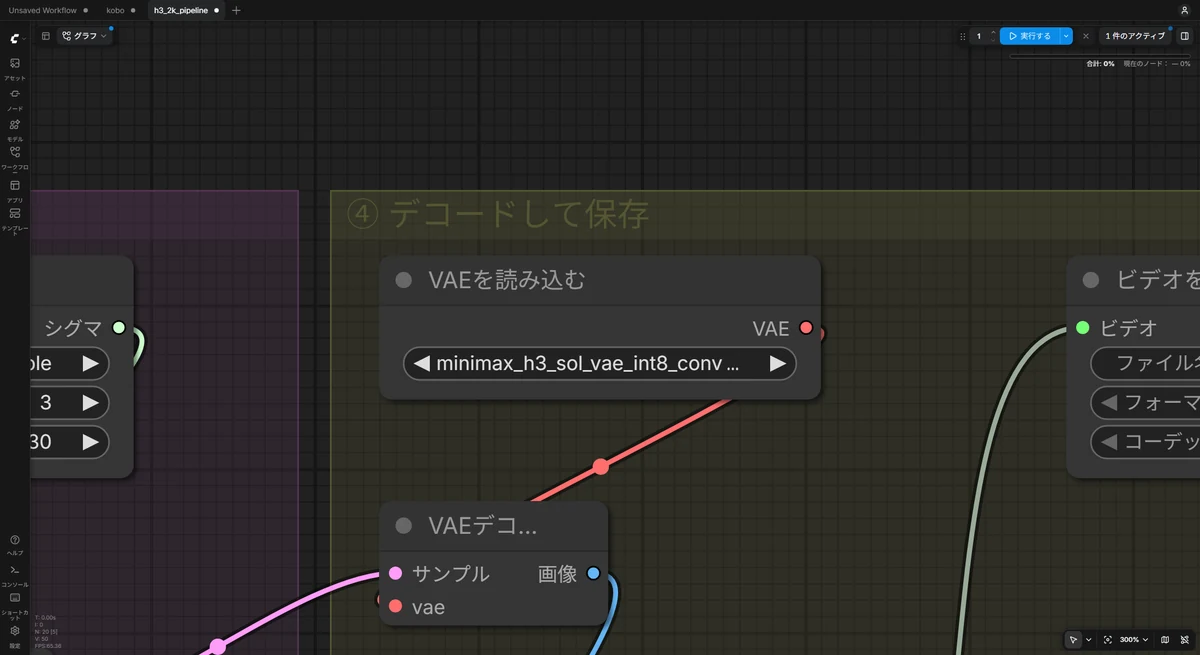
- minimax_h3_768p_to_2K_3step_d030_sol_int8.jsonComfyUI にドラッグして読み込みます(768p→2K、3ステップ・denoise 0.30、Sol int8)
コアのノードだけ(20個)で組んでいます。当サイトで読み込んで実行し、503.5秒で 2560×1440・124フレーム(音声つき)ができることを確かめました。シードは固定にしてあります。
実測結果
段階ごとの時間
| 条件 | 解像度 | ステップ・denoise | 時間 | 内訳 | VRAM ピーク | 所見 |
|---|---|---|---|---|---|---|
| A 基準(1段目だけ) | 1344×768 | 8・1.0 | 107秒 | サンプラー99.5秒(12.4秒/ステップ)、標準 int8 デコード4.9秒 | 31.2GB | 3回で106.6〜107.2秒 |
| A 初回(読み込み込み) | 1344×768 | 8・1.0 | 427秒 | テキストエンコーダー99.5、サンプラー291、デコード25.9 | 31.7GB | モデルは HDD に置いている |
| 拡大のみ | 1344×768→2560×1440 | – | 1.5秒 | 6.1GB | 読み込み込みで6.8〜9.3秒 | |
| 通し(おすすめ) | 1344×768→2560×1440 | 8 → 3・0.30 | 503秒 | 1段目98.8、拡大1.5、再サンプリング387、Sol int8 デコード7.2 | 31.2GB | 2回。再サンプリングが約77% |
| 通し(denoise 0.44) | 同上 | 8 → 3・0.44 | 503秒 | 1段目99.3、拡大1.5、再サンプリング387、Sol int8 7.1 | 31.3GB | |
| 通し(標準 VAE でデコード) | 同上 | 8 → 3・0.44 | 534秒 | デコード37.5秒(VAE の載せ直しを含む) | 31.3GB | 1回 |
| 通し(起動直後の初回) | 同上 | 8 → 3・0.44 | 580秒 | テキストエンコーダー49、1段目102、拡大7.7、再サンプリング386、デコード20.7 | 31.6GB | |
| E 2K を直接生成 | 2560×1440 | 8・1.0 | 1,138秒 | サンプラー1,081秒(135秒/ステップ)、デコード41秒 | 31.5GB | 1回。OOM にはならなかった |
ComfyUI 自体の RAM 使用は、1344×768 で43GB、2K の通しで47〜50GB でした。PC 全体では最大94GB です。
2K は直接作るより2段で作るほうが速い
RTX 5090 では、2K を直接作ることもできました。ただし時間は1,138秒で、2段で作る503秒の2倍以上です。
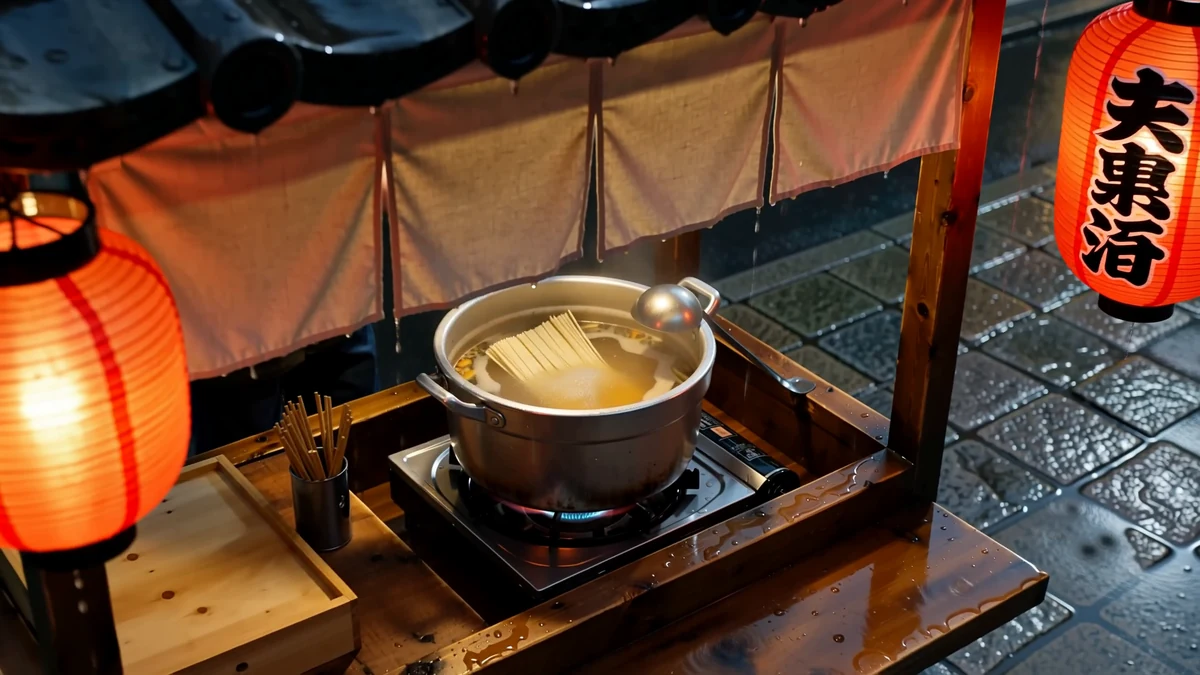
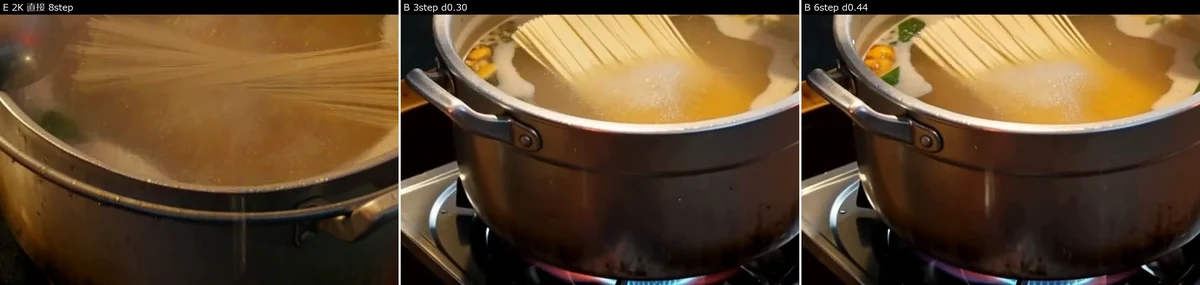
同じシードでも、直接生成した 2K と 768p の絵は一致しません。今回は、直接生成のほうが鍋に大きく寄り、画面からはみ出しました。768p で中身を確かめてから仕上げられるのも、2段に分ける利点です。
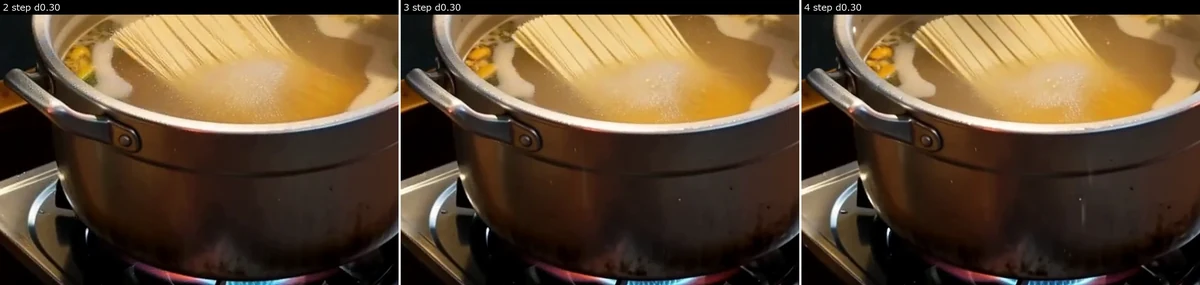
再サンプリングは denoise 0.30・3ステップがおすすめ
| denoise | ステップ | 全体(1段目の latent から、標準 int8 デコード込み) | 再サンプリング | 所見 |
|---|---|---|---|---|
| 0.30 | 2 | 285秒 | 258秒 | 構図は1段目に近い。縁や持ち手の細部が増える |
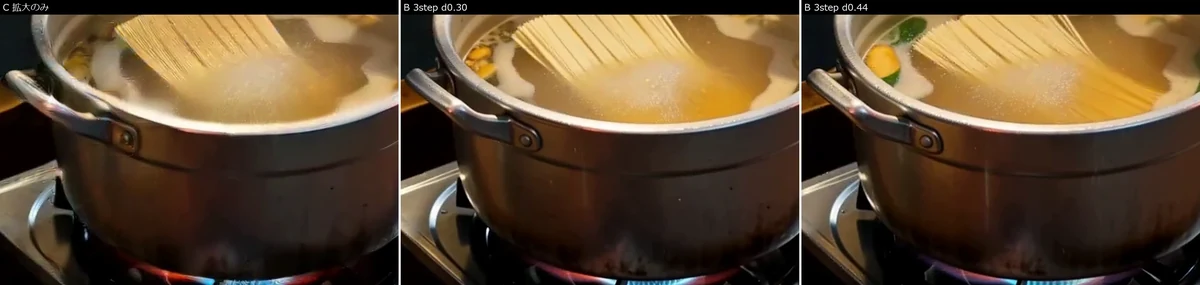
| 0.30 | 3 | 415秒 | 388秒 | 構図を保ったまま細部が増える(おすすめ) |
| 0.30 | 4 | 542秒 | 515秒 | 麺の筋がやや太く、はっきりする |
| 0.30 | 6 | 800秒 | 773秒 | |
| 0.44 | 2 | 285秒 | 258秒 | |
| 0.44 | 3 | 415秒 | 388秒 | 鍋に緑と黄色の具が現れ、麺の形も変わる |
| 0.44 | 4 | 542秒 | 515秒 | |
| 0.44 | 6 | 799秒 | 773秒 |
1段目(768p 生成 約99秒)を含めた3ステップの通しは、503秒(Sol int8)、534秒(標準 int8、VAE の載せ直し込み)です。
- どの条件も1ステップ約129秒で、時間はステップ数に比例しました。denoise を変えても時間は変わりません。
- denoise 0.44 は、アップスケーラーの作者のワークフロー(2段目のシグマ 0.9035, 0.6316, 0.3158, 0)に近い値です(当サイトの換算)。作者のシグマをそのまま使っても414秒で、0.44 と同じように中身が変わりました。PR #17412 には推奨値の記載はありません。
- 2ステップでも細部は増えます。急ぐなら 2ステップ(通しで約366秒の見込み、段階の足し算)も選べます。
解像度ごとの1ステップの時間
| 解像度 | 1ステップの時間 |
|---|---|
| 864×480 | 2.9秒 |
| 1344×768 | 12.4秒 |
| 1920×1088 | 44秒 |
| 2560×1440 | 129秒 |
目安として、画素数が約2倍で時間は約3〜4倍になりました(区間別:画素2.49倍→時間4.3倍、2.02倍→3.5倍、1.76倍→2.9倍)。解像度を上げるほど急に重くなります。理由は調べていません。
1080p 相当(864×480 → 1920×1088、3ステップ)も試しました。1080 は32の倍数ではないので 1088 にしています。
| 段階 | 解像度 | ステップ・denoise | 時間 | VRAM ピーク |
|---|---|---|---|---|
| 1段目 | 864×480 | 8・1.0 | 27秒 | 31.0GB |
| 拡大 | 864×480→1920×1088 | – | 1.2秒 | 3.0GB |
| 再サンプリング+Sol int8 | 1920×1088 | 3・0.44 | 142秒(再サンプリング133、デコード4.1) | 31.1GB |
1080p 相当なら、通しで約170秒です。2K が重いと感じたら、1080p 相当で止めるのも手です。
拡大だけでは、形のある細部は増えない
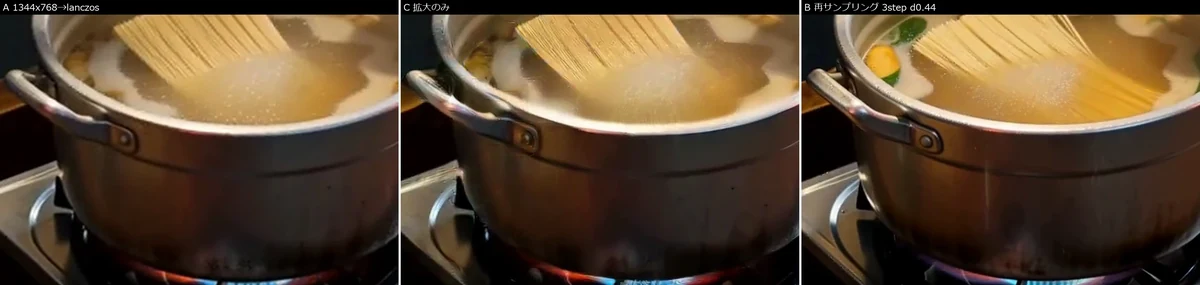
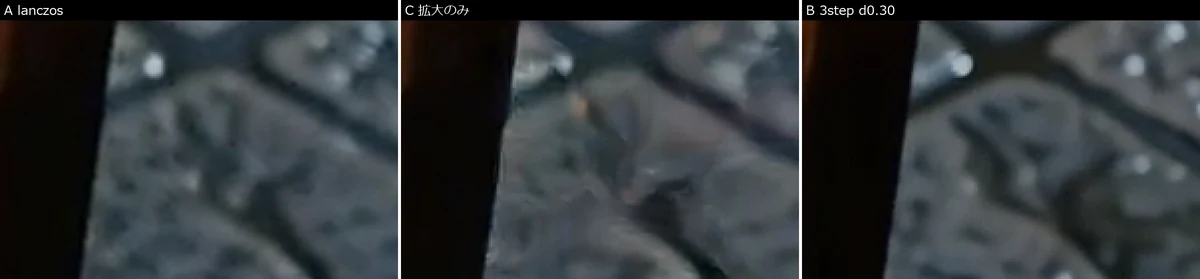
再サンプリングをせずに拡大だけした動画は、輪郭が少し立っただけでした。
測る前は「拡大だけなら細部は増えない」と想定していました。ところが数値で見ると、細かい模様の量(ラプラシアン分散。2K にそろえて中央フレームで測定)は増えています。
| 経路 | 細かい模様の量 |
|---|---|
| 1段目を画像で拡大(lanczos) | 18.1 |
| 拡大のみ(標準 int8 デコード) | 51.3 |
| 拡大のみ(Sol int8 デコード) | 44.0 |
| 従来経路(後述) | 23.2 |
| 2K 直接生成 | 35.8 |
| 再サンプリング 0.30・3ステップ | 63.4 |
| 再サンプリング 0.44・3ステップ | 60.9 |
ただし4倍に拡大して見ると、拡大のみで増えた分は輪郭の乱れやオレンジ色のにじみでした。石畳の形は、画像で拡大したものより崩れています。「細かい模様は増えるが、形のある細部ではない」というのが正確なところです。2K らしい見た目にするには、再サンプリングが必要です。
従来経路(画像に戻して拡大)より約60秒短い
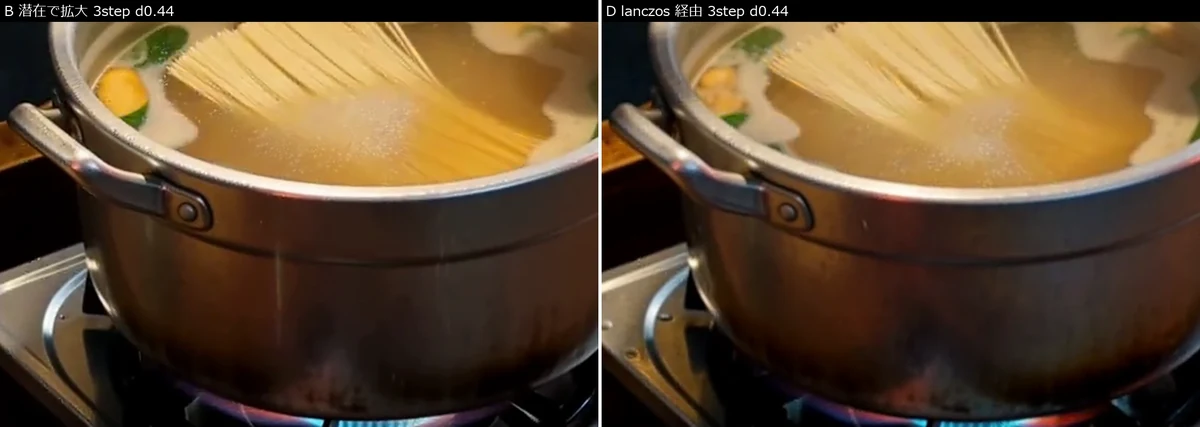
1段目の動画をいったんデコードし、画像として拡大(lanczos)してから、もう一度エンコードして再サンプリングする方法と比べました。再サンプリングの設定は同じ(3ステップ・0.44)です。
| 経路 | 拡大部分の時間 | 全体(1段目の latent から) | ComfyUI の RAM | 見た目 |
|---|---|---|---|---|
| 潜在アップスケール | 1.5秒 | 約415秒 | 48GB | くっきり |
| 従来経路 | 63〜67秒(デコード5〜6+拡大8〜10+エンコード48〜53) | 476〜483秒 | 56GB | 麺の筋が柔らかい |
差は拡大部分の約60秒です。RAM も8GB 少なく済み、見た目も潜在アップスケールのほうがくっきりしていました(中央フレーム1枚の目視)。
デコード単体の速さ(同じ latent、VAE を交互に3回ずつ)
| 解像度 | VAE | 時間 | 1回目(読み込み込み) | VRAM ピーク | 開始からの増加 |
|---|---|---|---|---|---|
| 2560×1440 | 標準 int8 | 18.5秒 | 18.2秒 | 12.4GB | 約5GB |
| 2560×1440 | 標準 fp16 | 42.8秒 | 80.6秒 | 12.1GB | 約7.2GB |
| 2560×1440 | Sol fp32 | 14.0秒 | 48.8秒 | 23.3GB | 約16GB |
| 2560×1440 | Sol fp16 | 13.8秒 | 26.6秒 | 21.7GB | 約13GB |
| 2560×1440 | Sol int8 | 7.1秒 | 7.1秒 | 16.2GB | 約10.5GB |
| 1344×768 | 標準 int8 | 5.3〜5.5秒 | – | 10.7GB | 約3.5GB |
| 1344×768 | 標準 fp16 | 12.0秒 | – | 10.6GB | 約5.8GB |
| 1344×768 | Sol fp32 | 4.0〜4.4秒 | – | 16.0GB | 約8.9GB |
| 1344×768 | Sol fp16 | 3.8秒 | – | 19.4GB | 約6GB |
| 1344×768 | Sol int8 | 2.0〜2.1秒 | – | 9.9GB | 約4.2GB |
時間は2回目以降の値で、1回目(読み込み込み)は各 VAE の最初のデコードです(2K は3回、768p は2回)。開始からの増加は、デコードを始めたときから増えた VRAM の量です。VRAM ピークには、前の処理の残りも含みます。
- 2K では、Sol int8 が標準 int8 の約2.6倍速くなりました。開始からの増加は約2倍です(標準 int8 約5GB、Sol int8 約10.5GB)。
- Sol の fp32 と fp16 は、時間も画質(後述)もほぼ同じでした。ファイルの大きい fp32 を選ぶ利点は、測った範囲ではありません。
- 768p の結果は、PR #17411 の表(標準 int8 4.61秒、Sol int8 1.70秒)より少し遅くなりました。環境の違いの内訳は調べていません。
- 通しの中で見ると、2K のデコード差は約11秒で、全体の2%ほどです。Sol で一番大きく縮むのは、再サンプリングのない「拡大のみ」や、デコードを何度もやり直すときです。
画質:標準 VAE と Sol
同じ latent を標準 VAE(int8)でデコードした結果を基準に、PSNR を測りました。124フレーム全体の値です。
| 素材 | 標準 fp16 | Sol fp32 / fp16 | Sol int8 | Sol の最低フレーム |
|---|---|---|---|---|
| ラーメン屋台 2K | 57.4dB | 37.7dB | 37.7dB | 35.0dB |
| 顔のアップ 2K | 59.3dB | 43.3dB | 43.3dB | 39.2dB |
| 顔のアップ 768p | 59.2dB | 42.6dB | 42.6dB | 39.9dB |
- Sol は、fp32・fp16・int8 でほぼ同じ値でした(int8 との差は0.03dB)。
- 差が大きく出たのは絵柄のほうです。雨粒や石畳が多いラーメン屋台は、顔より約5〜6dB 低くなりました。
- モデルカードの値(38.2〜45.4dB)と近い範囲です。
128px の継ぎ目
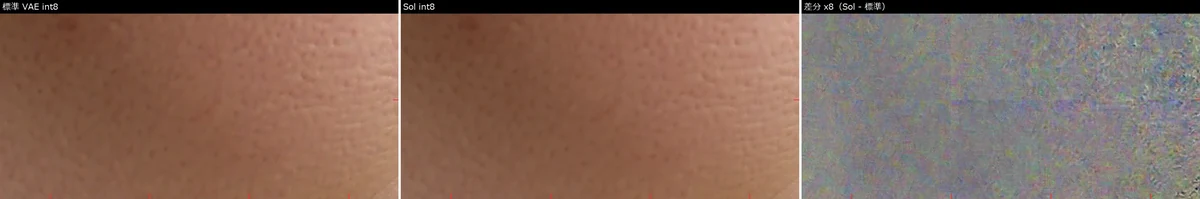
Sol を使うと、肌などの平らな面に 128px ごとの薄い継ぎ目が出るという報告があります(ComfyUI issue #17429)。隣り合う画素の差を、128px の境界とそれ以外で比べました。1.0 なら境界に段差がありません。
| 素材 | 標準 int8(横 / 縦) | Sol(横 / 縦) |
|---|---|---|
| ラーメン屋台 2K | 1.14 / 1.07 | 1.29 / 1.23 |
| 顔のアップ 2K | 1.15 / 1.27 | 1.23 / 1.58 |
| 顔のアップ 768p | 1.14 / 1.19 | 1.27 / 1.53 |
Sol は境界の段差が数値の上で増え、特に縦方向で大きくなりました。報告と同じ傾向です。標準 VAE との差を8倍に強調すると、格子が見えます。
ただし、頬の中央フレームを2倍に拡大して見た範囲では、線は目で見て分かりませんでした。今回の肌は2段目で毛穴の質感が出ていて、報告のような平らな肌とは条件が違います。動画を再生したときの見え方と、ほかのフレームは確かめていません。気になる場合は、最後のデコードだけ標準 VAE に戻してください。標準 VAE では境界の段差が小さくなりました(2K で約11秒遅くなります)。
音声は拡大では変わらず、再サンプリングで作り直される
| 確認したこと | 結果 |
|---|---|
| 拡大の前後の音声 latent | 完全に一致 |
| 拡大だけしてデコードした音 | 1段目と同じ(データが一致) |
| 再サンプリング後 | 音声 latent も変わる(音が作り直される) |
| 音声だけ1段目に戻す | 1段目と同じ音になる |
| Sol 経路 | 音声も出る(AAC、5.17秒) |
H3 の latent は、映像と音声がセットです。潜在アップスケールは映像だけを拡大し、音声はそのまま通します。
ただし2段目の再サンプリングでは、音声も一緒に作り直されます。1段目の音を残したいときは、2段目のあとで映像と音声の latent を分け、音声だけ1段目のものに入れ替えてからデコードしてください(ComfyUI の分離・結合ノードを使用)。音声は別の VAE を通るので、Sol の影響は受けません。
1段目と2段目のどちらの音が良いかは、耳では確かめていません。
VRAM が少ない人へ
今回の測定は RTX 5090(32GB)だけです。2K の再サンプリング中は31.7GB まで使っていますが、これは空いている VRAM に載せられるだけ載せた値です。24GB 以下で動くかは確かめていません。
Sol-H3-VAE は画像を分けてデコードする(タイル分割)ことができず、解像度と長さに比例してメモリが増えます(PR #17411 の説明)。2K のデコードでは、開始からの増加で比べると、標準 int8 より5.5GB ほど多く使いました(Sol int8 約10.5GB − 標準 int8 約5GB)。VRAM が厳しいときは、まず 1080p 相当(1920×1088)で試すのがおすすめです。
よくある質問(FAQ)
Q. ComfyUI のリリース版で使えますか?
2026年11月2日時点では使えません。master か nightly ビルドが必要です。
Q. MiniMax H3 で 2K の動画は作れますか?
RTX 5090 では作れました。2K を直接生成すると1,138秒、768p で作ってから潜在アップスケールで仕上げると503秒でした(5秒の動画)。公式の 2K 用ローカルテンプレートはまだありません。
Q. Sol-H3-VAE を使うと全体はどれだけ速くなりますか?
2K のデコードは18.5秒から7.1秒になりました。ただし通し全体(約500秒)から見ると、約11秒の短縮です。全体を速くしているのは、潜在アップスケールで小さい解像度から仕上げられることのほうです。
Q. 再サンプリングは何ステップがいいですか?
当サイトでは、denoise 0.30・3ステップをおすすめにしました。2ステップでも細部は増えます。1ステップ約129秒なので、時間と相談して決めてください。
Q. 音声は壊れませんか?
拡大ではそのまま通ります。再サンプリングで音も作り直されるので、元の音を使いたいときは、音声の latent だけ1段目のものに戻します。
Q. Sol-H3-VAE でエンコードできますか?
公式リポジトリの sol_h3_vae.safetensors はデコーダーだけなので、できません。エンコードには標準 VAE を使ってください。
まとめ
- 768p で作って 2K に仕上げる方法は、5秒の動画で503秒でした。2K を直接作る1,138秒の半分以下です。時間の大半は 2K での再サンプリング(1ステップ約129秒)で、潜在アップスケール(1.5秒)と Sol-H3-VAE(デコード7.1秒)は、どちらも短い時間で済みます。
- おすすめの設定は、1344×768・Turbo 8ステップ → 2560×1440 に拡大 → 3ステップ・denoise 0.30 → Sol int8 でデコードです。
- 音声は拡大では変わりませんが、再サンプリングで作り直されます。
H3 の導入や基本の使い方は、こちらの記事にまとめています。
検証メモ(ライセンスなど未確定の点)
- Sol-H3-VAE のライセンス:リポジトリに LICENSE ファイルはありません(2026年11月2日確認)。README の License 節の原文は次のとおりです。”The code is released under Apache-2.0. The weights are distilled from the MiniMax-H3 VAE and are subject to the MiniMax-H3 license.”
- MiniMax H3 のライセンスとの関係:MiniMax H3 Community License では、蒸留で作ったモデルも「Model Derivatives」に含まれます。対象地域外(EU・英国・韓国・米国)での利用の制限、年商2,000万ドルを超える場合の別途許可などが、Sol の重みにもかかると読めます。当サイトでは法的な判断はしていません。使う前にライセンス原文を確認してください。
- Comfy-Org 版の Sol(int8 / fp16):Comfy-Org/MiniMax-H3 リポジトリで配布されています。リポジトリのカードには MiniMax H3 のライセンスが示されていますが、ファイルごとの表記はありません。
- アップスケーラーのライセンス:モデルカードに Apache-2.0 と書かれていますが、リポジトリに LICENSE ファイルはありません。学習データの出所も書かれていません。
- デコードの1回目:2K の標準 int8 と Sol int8 だけ、1回目と2回目以降がほぼ同じでした(18.2秒と18.5秒、7.1秒と7.1秒)。この2つはデコード単体の前の通しの測定で使っていて、ほかの3つはこの測定で初めて読みました。ファイルが OS のキャッシュに残っていた可能性がありますが、キャッシュの状態は記録していないので、理由は未確認です。
- 測定の順序:2K の再サンプリングが1ステップ129秒と重かったので、途中で測定の順序を入れ替えました。そのとき、始まった直後の1条件を2度中断して破棄し、後でやり直しています(中断した分は数値に含みません)。
- 測定中の CPU 作業:2K 直接生成(1,138秒)と denoise 0.30・3ステップの1回目の測定中は、画面の読み込みと解析を CPU で並行した時間があります。
- Sol の CPU デコード:CPU でのテストは9分で終わらず、ほかの計測への影響を避けるために中断しました。GPU では成功しています。
- 未確認のこと:音の聞き比べ、動画を再生したときのちらつき、24GB 以下の GPU での動作、128px の継ぎ目の他のフレームでの見え方。