この記事について(広告・アフィリエイトリンクはありません)
Fizgig は無料(Apache-2.0)で、PC だけで使えます(レンタル GPU は使っていません)。試した環境の一覧は検証の記録にあります。
Fizgig は、Anima や MiniMax H3 など13系統のモデルの LoRA を学習できる無料のスタジオです。Anima のキャラ LoRA を20枚・50エポック(1,000ステップ)で学習すると、RTX 5090 で約16分、GPU のメモリは学習中6.8GB でした。 できた LoRA は、ComfyUI の標準の LoRA ローダーにそのまま読み込めました。
今回は画面ではなく、コマンド(CLI)で学習しました。インストールは約9分です。所要時間は1時間ほど、難しさは中級です。
先に結論(今回のテスト条件で)
| 試したこと | 結果 |
|---|---|
| 導入(install_fizgig.py) | 約9分。Python 3.12 の venv に PyTorch 2.10(CUDA 12.8)などが入った |
| キャッシュ(20枚) | 画像の潜在 19秒、文字の埋め込み 69秒(初回はトークナイザーの取得を含む) |
| 学習(rank 16、1e-4、50エポック) | 1,000ステップで約16分(0.70秒/ステップ)。学習中の VRAM 6.8GB、プレビュー時 9.9GB |
| ComfyUI で読み込み | 標準の LoraLoaderModelOnly でそのまま効いた |
| バッチサイズ 4 と 1(12エポック) | 1エポックあたりの時間はほぼ同じ(約17秒) |
Fizgig とは?
shootthesound/Fizgig は、LoRA とファインチューンの学習スタジオです(Apache-2.0)。2026年11月7日時点でスターは682、コミットは3,500を超え、今回は 9.0.8(ee4a7f8)を使いました。
対応するのは Flux 2 Klein 9B、Krea 2、MiniMax H3、Qwen Image 2.1、MOSS-Image、Z-Image、SDXL、Anima などです。学習のほか、LoRA のブロックごとの調整(Studio)、エポックの見比べ(LoRA Royale)、低ランクへの抽出(Extract)もできます。
画面(GUI)は、裏でコマンドを組み立てて実行しているだけで、同じことがコマンドからもできると説明されています。
導入
git clone https://github.com/shootthesound/Fizgig
cd Fizgig
install_fizgig.bat
インストーラーは PATH の python で venv を作ります。conda の Python からは作れない(文字が出なくなるため)と書かれていて、今回の PC では python が別のアプリの環境を指していたので、ふつうの Python 3.12 を指定して install_fizgig.py を直接実行しました。
Anima のモデル(anima-base-v1.0、qwen_image_vae、qwen_3_06b_base)は、ComfyUI で使っているものをそのまま指定できました。入手先はAnima の導入記事と同じです。
学習の手順(コマンド)
学習は「画像の潜在をキャッシュ」「文字の埋め込みをキャッシュ」「学習」の3段です。データセットは、画像と同じ名前の .txt(キャプション)を並べたフォルダーで、設定は TOML に書きます。
[general]
resolution = [1024, 1024]
caption_extension = ".txt"
batch_size = 1
enable_bucket = true
bucket_no_upscale = true

[[datasets]]
image_directory = "L:/fizgig/data/chihaya/images"
cache_directory = "L:/fizgig/data/chihaya/cache"
python src/fizgig/families/cache.py --family anima --stage latents --dataset_config chihaya.toml --model qwen_image_vae.safetensors
python src/fizgig/families/cache.py --family anima --stage text --dataset_config chihaya.toml --model qwen_3_06b_base.safetensors
python src/fizgig/families/train.py --family anima --dataset_config chihaya.toml ^
--dit anima-base-v1.0.safetensors --output_dir out --output_name chihaya_fizgig ^
--network_dim 16 --network_alpha 16 --learning_rate 1e-4 --max_train_epochs 50 ^
--save_every_n_epochs 10 --precision auto --blocks_to_swap -1 --compile_blocks auto ^
--ema_decay 0.98 --optimizer_type adamw --log_per_image_loss ^
--vae qwen_image_vae.safetensors --text_encoder qwen_3_06b_base.safetensors ^
--sample_prompts sample_prompts.txt --sample_every_n_epochs 10 --sample_at_first値は、公式の CLI の説明にある Anima の例に合わせました。--compile_blocks auto で、最初の2エポックはブロックのコンパイルのため遅くなると表示されます。
学ばせたキャラ
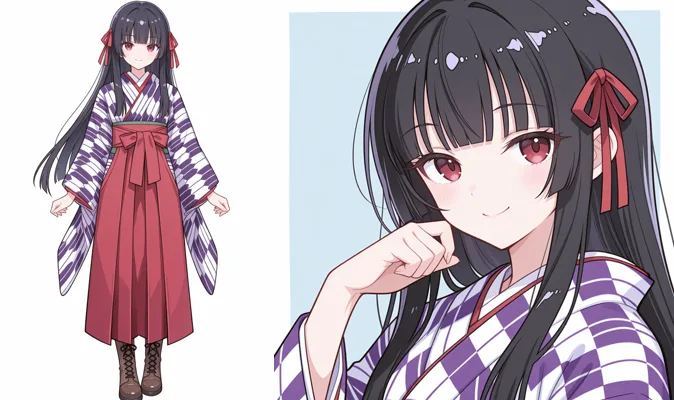
当サイトの LoRA 図鑑で作った、オリジナルのキャラ(黒髪・赤いリボン・紫の矢絣の着物・赤い袴・ブーツ)の画像20枚を使いました。キャプションは「トリガー語+構図」だけで、見た目のタグは入れていません。
エポックごとのプレビュー
学習中に、10エポックごとにプレビューが作られます。左から0、10、20、30、50エポックです。
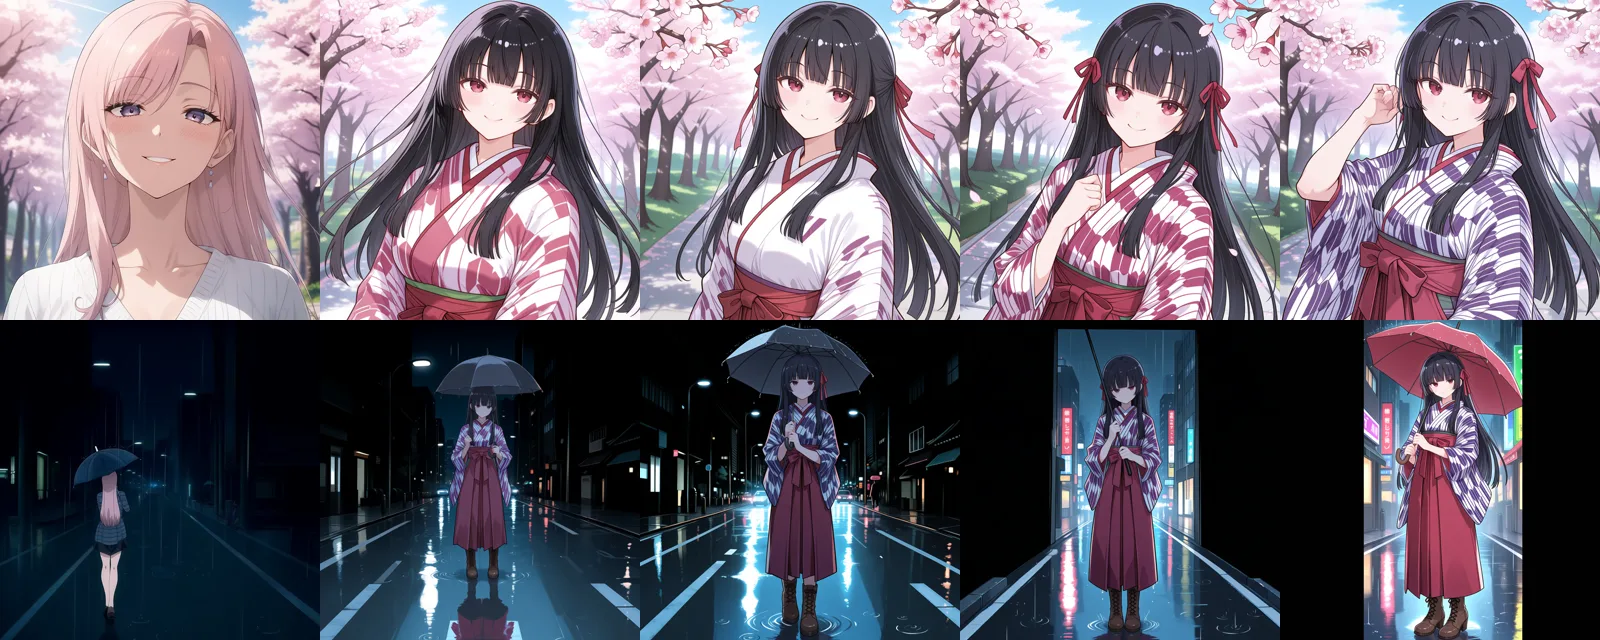
10エポックで黒髪と着物・袴は出ましたが、着物の色は赤っぽく、リボンもありませんでした。30エポックでリボンが出て、50エポックで紫と白の矢絣になりました。このデータでは、プリセットどおり50エポックまで回したほうが、元の絵に近づきました。
ComfyUI で使う
できた LoRA(46MB)を ComfyUI の loras フォルダーに入れ、Anima base v1.0 に LoraLoaderModelOnly で当てました。変換は要りませんでした。
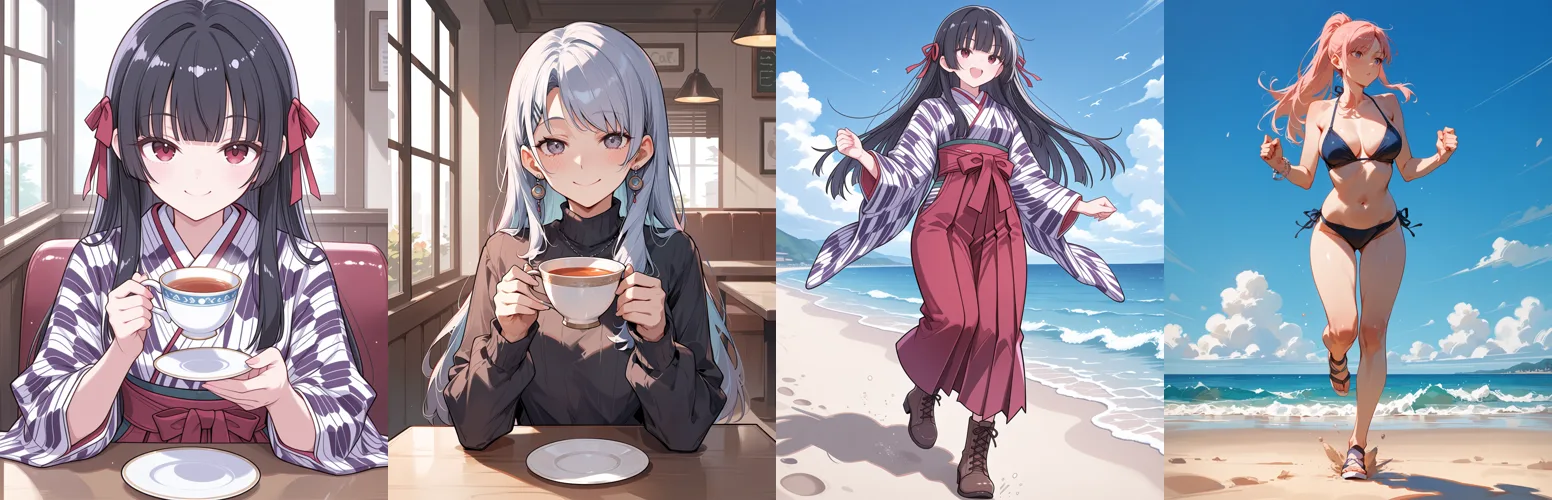
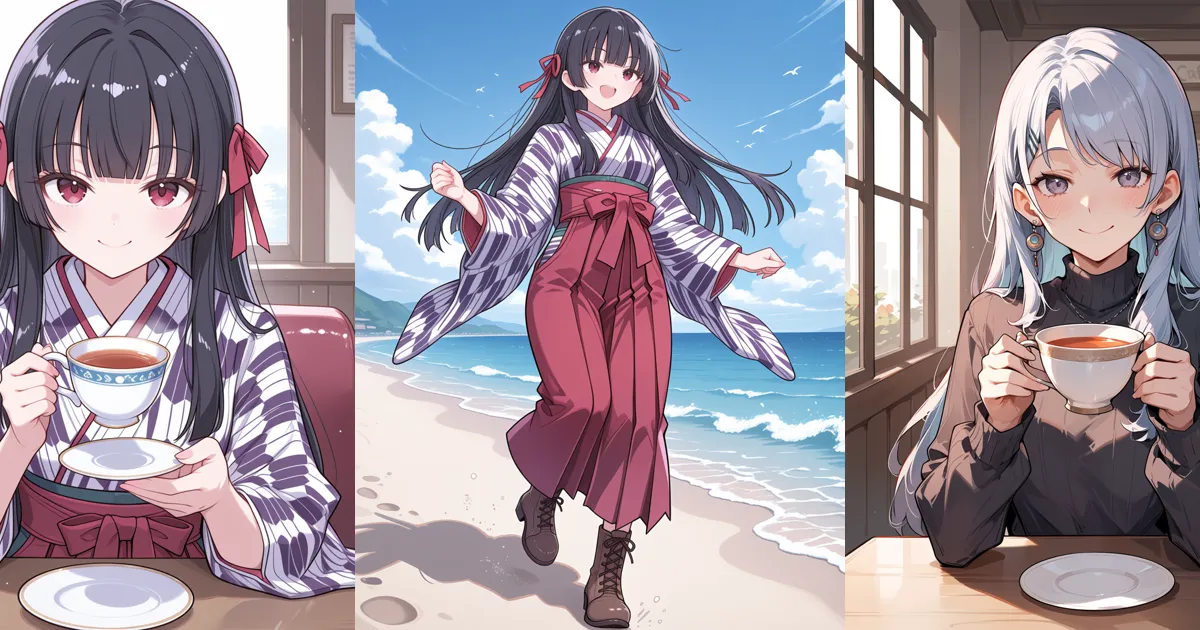
学習データにない場面(カフェで紅茶、海辺を走る)でも、髪・リボン・着物・袴・ブーツが保たれました。LoRA なしでは、同じシードでも別の人物になります。30ステップ、CFG 4.5、er_sde で1枚約6.5秒でした。
バッチサイズは速くならなかった
9.0.5 で入ったバッチサイズを、4 と 1 で12エポックずつ比べました。1エポックあたりの時間は、どちらも約17秒でした。
| batch_size | ステップ数(12エポック) | 1ステップ | 合計 | VRAM |
|---|---|---|---|---|
| 4 | 72 | 2.88秒 | 230秒 | 10.4GB |
| 1 | 240 | 0.87秒 | 224秒 | 6.1GB |
画像の縦横比がばらばらで、同じ大きさのグループ(バケット)ごとにしかまとめられず、20枚が6回ずつにしか分かれなかったためと考えられます。作者の「Anima で2.6倍」は RTX 4090 での値で、条件も違います。縦横比をそろえたデータなら結果は変わるかもしれません。
商用で使える?
Fizgig のコードは Apache-2.0 です。ただし Anima は CircleStone Labs の非商用ライセンスで、Fizgig の説明でも、学習した LoRA は Anima の派生物としてその条件に従うと書かれています(生成した画像は商用で使えるとも書かれています)。配布や販売の前に、Anima のライセンスの原文を確かめてください。
RTX 5090 以外の人へ
学習中の VRAM は6.8GB、プレビューを作るときで9.9GB でした。Fizgig の説明では、Anima は8GB のカードから学習でき、空き VRAM に合わせて bf16・INT8・NF4 を自動で選ぶとされています。今回は bf16 のみで、ほかの精度は試していません。
よくある質問(FAQ)
Q. Fizgig とは?
Anima・MiniMax H3・Krea 2・Qwen Image 2.1 など13系統のモデルの LoRA を学習できる、無料の学習スタジオです。画面からもコマンドからも使えます。
Q. Fizgig で Anima の LoRA を学習する時間は?
RTX 5090 で、20枚・50エポック(1,000ステップ)が約16分でした。学習中の VRAM は6.8GB でした。
Q. Fizgig の LoRA は ComfyUI で使える?
使えます。標準の LoRA ローダーにそのまま読み込めました。
Q. バッチサイズを上げると速くなる?
今回のデータ(縦横比がばらばら)では、4 と 1 で1エポックの時間はほぼ同じでした。
まとめ
Fizgig は、Anima のキャラ LoRA を16分ほどで作れ、そのまま ComfyUI で使えました。コマンドでも全部の機能が使えるので、AI に学習を任せる使い方とも相性がよいです。
プリセットのまま50エポック。10エポックごとのプレビューで見比べて選ぶ。
検証メモ
- データ:オリジナルキャラの60枚から3枚おきに20枚。キャプションは図鑑で付けたもの(トリガー語+構図・表情・背景)。
- 学習:AdamW、rank 16 / alpha 16、1e-4、EMA 0.98、bf16(precision auto)、コンパイル auto、シード 42。GUI のプリセットは Muon を使うと説明されていますが、今回は CLI の説明の例どおり AdamW にしました。
- 時間:16分(959秒)はプレビュー6回分を含みます。バッチの比較は12エポックの短い学習で、最初の2エポックの準備時間を含みます。
- 試していないこと:GUI の画面、Studio・LoRA Royale・Profiler・Extract、MiniMax H3 など他のモデル、INT8/NF4、Muon。