この記事について(広告・アフィリエイトリンクはありません)
紹介しているモデルとノードは、すべて無料で入手できるものです。
Anima Role Ref KV は、参照画像1枚とプロンプトから、同じキャラの別のポーズや服の画像を作るアダプターです。キャラごとの LoRA の学習は要りません。
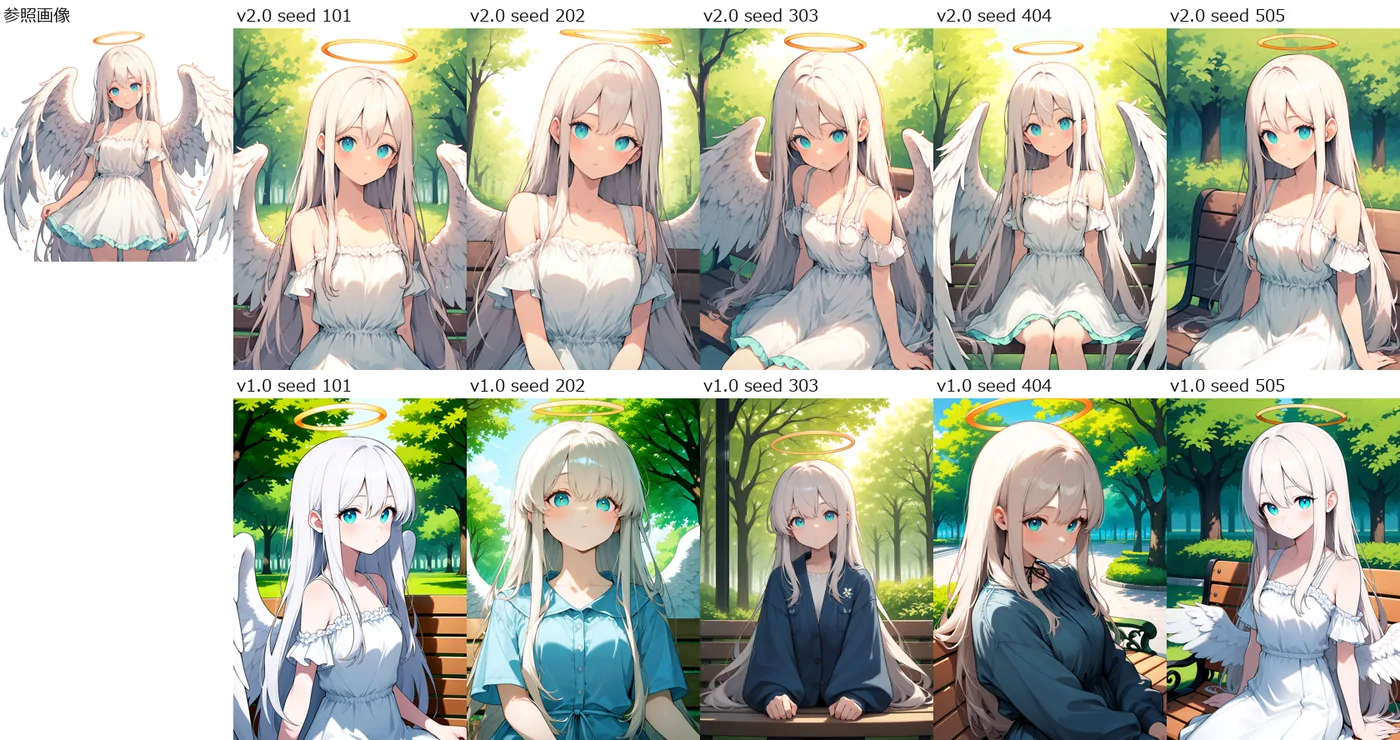
配布ページの評価では、v2.0 で「キャラの似かた」と「色が抜ける失敗の少なさ」が良くなったとされています。自分で作った2枚の参照画像で、v2.0 と v1.0 を60枚比べました。服や髪を保ったのは v2.0、背景の指定が出たのは v1.0 です。
Anima の基本はAnima の使い方を見てください。
キャラの見た目は v2.0、背景は v1.0(今回のテスト条件で)
| 見たところ | v2.0 | v1.0 |
|---|---|---|
| 服を指定しないときに参照の服を保つ(天使の子、タグ、5枚) | 5枚 | 2枚 |
| 同じ(天使の子、自然文、5枚) | 5枚 | 4枚 |
| 「classroom」で教室らしい背景が出る(10枚) | 2枚 | 8枚 |
| 1枚の時間(2枚目以降) | 約11.0秒 | 約11.0秒 |
| VRAM ピーク | 約9.8GB | 約9.6GB |
- キャラの見た目を保ちたいなら v2.0 が向いていました。
- 背景もプロンプトどおりにしたいなら、v1.0 も試す価値があります。v2.0 は白い背景のままになる画像が目立ちました。
- 配布ページの「色が抜ける失敗が31.1%から3.2%に減った」は、今回の少ない枚数では再現できていません(後述)。
どちらも2つの参照画像でしか試していません。判定は私の目視です。
試した環境
| 項目 | 内容 |
|---|---|
| GPU | RTX 5090(32GB)、ドライバー 621.01 |
| CPU / RAM | Ryzen 9 9950X3D / 128GB |
| OS | Windows 11 |
| ComfyUI | ポータブル版+master 17ff1dcc(v0.43.0-26)。入れたカスタムノードはこれだけ |
| ノード | Anima Role Ref KV の comfyui フォルダ(v2.1.0) |
| ベース | Anima-Base v1.0、qwen_3_06b_base、qwen_image_vae |
| 設定 | 832×1216、28 ステップ、CFG 4(配布ページの推奨) |
| シード | 101、202、303、404、505 |
| 検証日 | 2026年11月4日 |
ノードとモデルの両方を入れる
ノードとモデルの両方が要ります。ふつうの LoRA のように LoRA ローダーで読むものではありません。
- Hugging Face の comfyui フォルダを、
ComfyUI\custom_nodes\anima-role-ref-kvとして置きます。 - 下のモデルを置きます。
- ComfyUI を再起動します。
カスタムノードの入れ方はこちらにまとめています。
| ファイル | 置き場所 |
|---|---|
| anima-role-ref-kv-v2.0.safetensors(約264MB) | models\loras |
| anima-role-ref-kv-v1.0.safetensors(比べたいときだけ) | models\loras |
| anima-base-v1.0.safetensors | models\diffusion_models |
| qwen_3_06b_base.safetensors | models\text_encoders |
| qwen_image_vae.safetensors | models\vae |
配布ページによると、今のモデルは BF16 で、古い FP32 用のノードでは読めません。以前入れた人は、ノードのフォルダを置き換えてください。
下の JSON を画面に読み込むと、そのまま使えます。
- anima_role_ref_kv_v2_workflow.jsonComfyUI にドラッグして読み込みます(832×1216、28 ステップ、CFG 4)。「画像を読み込む」で自分の参照画像を選んでください
画面から実行して、成功を確かめました。ComfyUI を再起動した直後の1枚目で、ログで 14.71秒です。
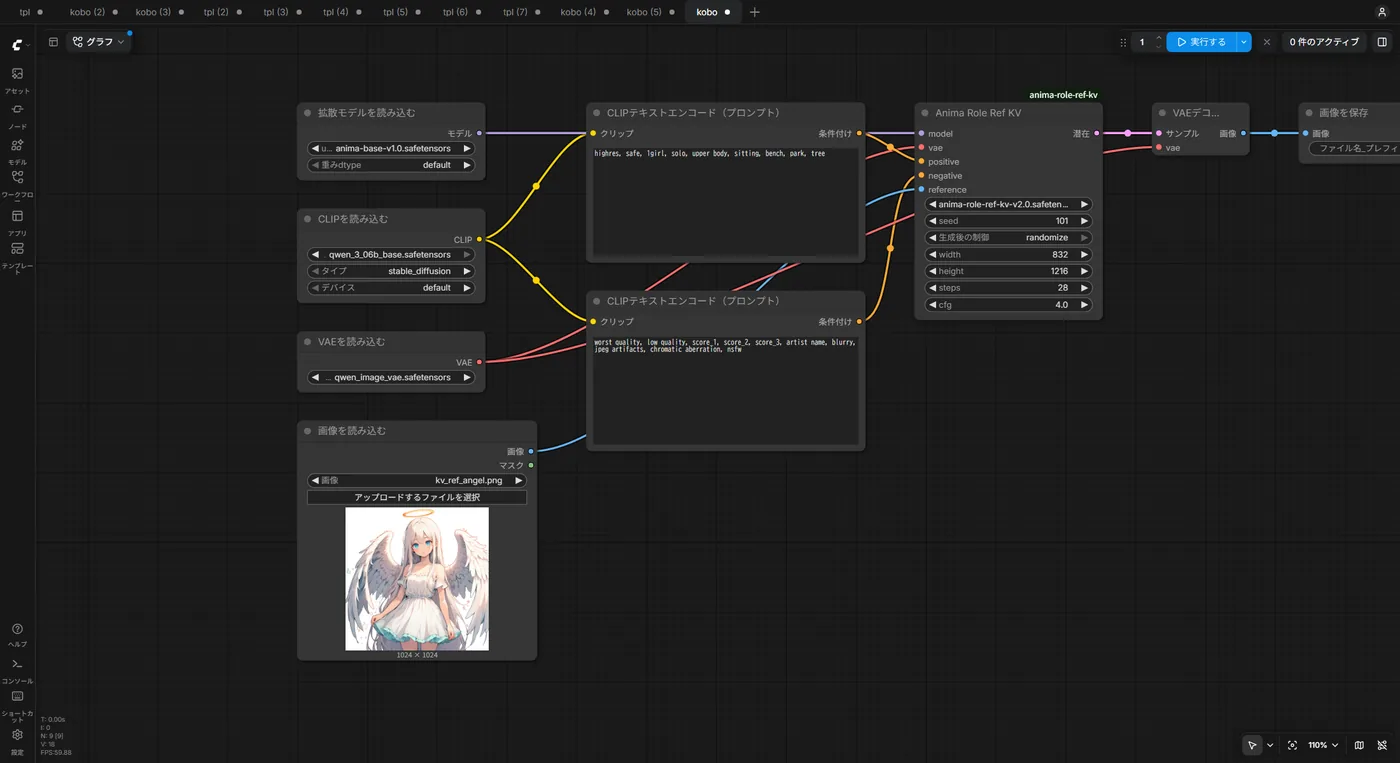
プロンプトにキャラの見た目は書かない
配布ページの形式です。今回はこの形で試しました。
- タグ:
highres, safe, 1girl, solo, upper body, sitting, bench, park, tree - 自然文:
safe, 1girl. Upper body shot from the waist up. She is sitting on a bench in a park with trees. - ネガティブ:
worst quality, low quality, score_1, score_2, score_3, artist name, blurry, jpeg artifacts, chromatic aberration(今回は末尾にnsfwを足しました)
配布ページでは、参照のキャラの見た目をプロンプトに書かず、ポーズや服、背景を書くように案内しています。参照画像は、キャラが1人だけのわかりやすいものを使います。
v2.0 と v1.0 はどこが違う?
参照は、白い服と翼の「天使の子」と、黒い長髪に制服の子の2枚です。プロンプト3種類×5シード×2バージョンで60枚です。
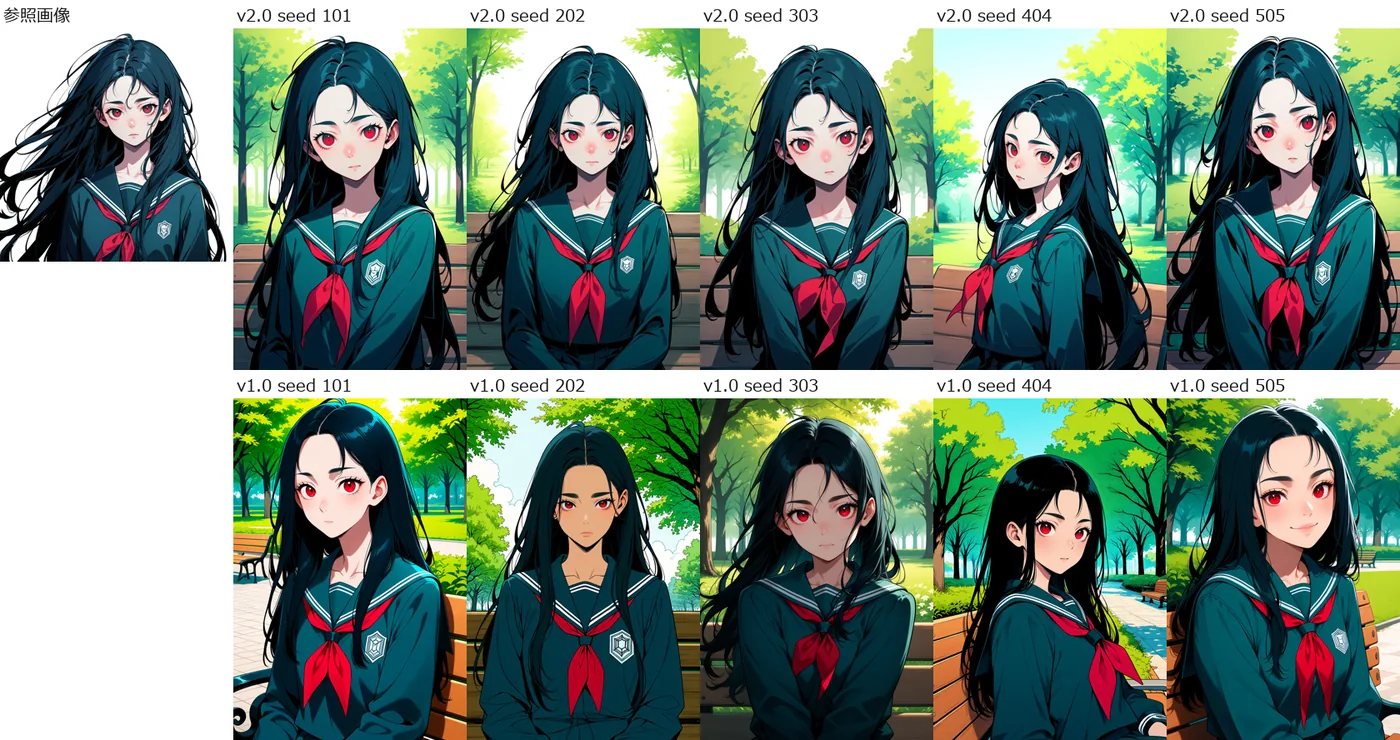
キャラの再現は v2.0 が安定
服を指定しないと、v2.0 は参照の服をほぼ保ちました。上の画像のタグの条件では、v1.0 は5枚中3枚で別の服になりました。v2.0 は5枚とも白いワンピースです。
黒髪の子でも、v2.0 のほうが髪の量や流れが参照に近く見えました。v1.0 は髪が短くなったり、肌の色が変わったりする画像があります。
背景は v1.0 のほうが出た
school uniform, classroom, smile で全身を作ると、差がはっきり出ました。教室らしい背景が出たのは、2つの参照の合計10枚で、v2.0 が2枚、v1.0 が8枚です。v2.0 は白い背景のままの画像が多く、1枚は青い四角の背景でした。
服の変更そのものは、どちらも効いています。ただし v2.0 の天使の子のうち1枚は、制服と参照のワンピースが混ざりました。
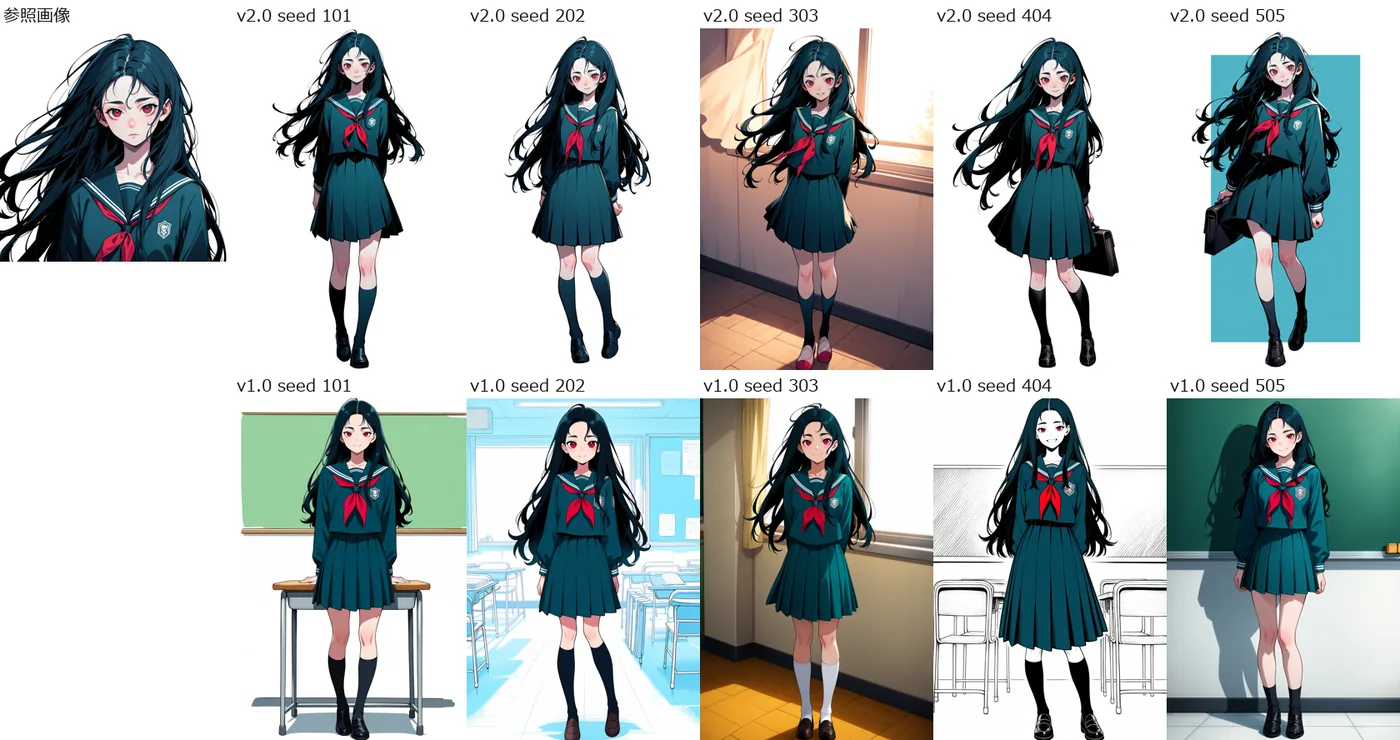
配布ページの評価でも、v2.0 はタグの反映が 91.2% から 90.3% へわずかに下がったとされています。今回の背景の差は、それよりずっと大きく見えました。ただし今回は枚数が少なく、背景の1語だけの結果です。
「色が抜ける失敗」は確かめきれなかった
配布ページでは、自然文のプロンプトで色の薄い画像の割合が 31.1% から 3.2% に減ったとされています。3,008枚での評価で、作者の開発評価です。
私は彩度の平均を測りました。これは作者の指標とは別のものです。
| 条件(各5枚) | v2.0 の平均彩度 | v1.0 の平均彩度 | 彩度0.10未満の枚数(v2.0 / v1.0) |
|---|---|---|---|
| 天使の子・タグ | 0.222 | 0.412 | 0 / 0 |
| 天使の子・自然文 | 0.222 | 0.299 | 0 / 0 |
| 天使の子・制服 | 0.115 | 0.143 | 3 / 2 |
| 黒髪の子・タグ | 0.569 | 0.703 | 0 / 0 |
| 黒髪の子・自然文 | 0.548 | 0.655 | 0 / 0 |
| 黒髪の子・制服 | 0.235 | 0.326 | 0 / 0 |
今回の自然文では、v1.0 でも色の薄い画像は出ませんでした。そのため改善の幅は確かめられません。平均の彩度は、6条件すべてで v2.0 のほうが低めです。
v2.0 は参照の白い服や背景の白さに寄るので、彩度が低いことが悪いとは限りません。鮮やかな絵がほしいときは v1.0 を試してください。
1枚約11秒、VRAM の増加は約8GB
| 項目 | 結果 |
|---|---|
| 最初の1枚(この比較の1本目。ディスクからの読み込み込み) | 24.5秒 |
| 2枚目以降 | 約11.0秒(v2.0、v1.0 とも) |
| VRAM ピーク | 約9.6〜9.8GB |
| ComfyUI の RAM ピーク | 約8GB |
9.8GB は v2.0 の1本目だけの値です。それ以外の最大は v2.0、v1.0 とも約9.6GB で、版の差ではありません。
ピークは、開始時に 1.6GB ほど使っていた分を含みます。
RTX 5090 以外の人へ
--reserve-vram は、OS などのために VRAM を残しておく設定です。v2.0 のタグの条件で、各2枚試しました。
--reserve-vram | 結果 | 1枚目(読み込み込み) | 2枚目 | VRAM ピーク(開始時からの増加) |
|---|---|---|---|---|
| 指定なし | 成功 | 24.5秒 | 約11.0秒 | 9.8GB(約8.2GB) |
| 20(計算上の残り 約12.1GB) | 成功 | 14.7秒 | 11.0秒 | 9.8GB(約8.2GB) |
| 24(計算上の残り 約8.0GB) | 成功 | 14.9秒 | 11.0秒 | 9.8GB(約8.2GB) |
どの指定でも増加は約8.2GB で変わりませんでした。指定 24 では、総 VRAM の 32,580MB から指定分を引いた残り(約8.0GB)を少し上回っています。今回はどの指定でも失敗していません。どこまで減らすと失敗するかは測っていません(未確認)。
VRAM 容量が少ない環境を想定した簡易テストです。実際の 8GB・12GB 搭載 GPU での動作を再現・保証するものではありません。 「指定なし」の1枚目(24.5秒)は、この日の最初の生成です。モデルを読むノードが 7.54秒かかりました。20 と 24 の1枚目と、上の画面からの実行(14.71秒)は、どれも ComfyUI を起動し直した直後ですが、その直前まで同じファイルで生成を続けていて、このノードは約1.2秒でした。ファイルが OS のキャッシュに残っていた差と考えられますが、キャッシュの状態は測っていません。VRAM 不足の対処はこちらにまとめています。
商用で使うときの条件は?
- モデル:CircleStone Labs Non-Commercial License v1.0 です。モデルの利用は非商用が条件です。
- 出力:同じライセンスの Outputs の項に、禁止事項を除いて商用を含む目的に使える旨があります。ただし出力で競合するモデルを学習することは禁止です。商用で使う前に、全文を確認してください(法的な助言ではありません)。
- ノード:
comfyuiフォルダは GPL-3.0、Python の推論コードは Apache-2.0 です。
他の人のキャラクターや絵を参照画像に使うときは、その権利者の条件が別にかかります。
よくある質問(FAQ)
Q. キャラの LoRA の学習は要りますか?
要りません。参照画像1枚で使えます。ただし今回の2枚でも、シードごとに顔の印象は変わりました。何百枚も同じ顔でそろえたいときは、LoRA と比べて決めてください。
Q. v2.0 と v1.0 のどちらがいいですか?
今回は、キャラの見た目を保つなら v2.0、背景の指定を効かせたいなら v1.0 でした。両方を入れて、ノードの中で切り替えられます。
Q. ふつうの LoRA ローダーで使えますか?
使えません。配布ページでも、専用の仕組みが必要で単体の LoRA ではないと説明されています。
Q. 読み込むとエラーになります。
古いノードは BF16 のモデルを読めません。ノードのフォルダを新しいものに置き換えてください。
Q. 商用で使えますか?
モデルの利用は非商用が条件です。出力の扱いと商用ライセンスは、ライセンスの全文を確認してください。
まとめ
- 参照画像1枚で、学習なしで同じキャラの画像を作れました。
- v2.0 は服や髪をよく保ち、背景の指定は v1.0 より出にくい結果でした。
- 1枚約11秒、VRAM の増加は約8GB でした(今回の条件で)。
検証メモ
- 枚数:参照2枚×プロンプト3種類×5シード×2バージョンの60枚と、
--reserve-vramの4枚、画面からの1枚です。 - 判定:服と背景の数は私の目視です。全員の顔が同じ人物に見えるかの数値は測っていません。
- 彩度:256×256 に縮小した画像の HSV の彩度の平均です。作者の「low-color rate」とは別の指標です。
- 作者の評価:1つの学習シードの自動の指標で、作者自身の開発評価です。頭部の類似度 1.23→1.72 も、私は確かめていません。
- 公開日:Hugging Face のリポジトリは 2026-10-26 に作られ、v2.0 のコミットは 2026-11-03 です。
- 未確認のこと:男性キャラ、複数人の画像、他の解像度、Apply ノード、Diffusers 版、実際の 8GB・12GB GPU。