この記事について(広告・アフィリエイトリンクはありません)
VibeVoice-ASR は無料(MIT)で、API キーも要りません。試した環境の一覧は検証の記録にあります。
VibeVoice-ASR は、Microsoft の文字起こしモデルです。誰が・いつ・何を話したかを1回でまとめて出します。日本語の2人の会話(2分19秒)では、話者26行すべてを正しく分け、文字の誤りは約9.5%、用語を渡すと約3.5%になりました。 RTX 5090 で32〜46秒、GPU のメモリは約18GB でした。
ただし、9分の会話では、後半ほど話者の区切りがまとまってしまい、行ごとの話者の正解率が6割ほどに落ちました。所要時間は30分ほど(モデル15.5GB のダウンロードを除く)、難しさは中級です。
先に結論(今回のテスト条件で)
| 試したこと | 時間 | 文字の誤り率 | 話者 |
|---|---|---|---|
| VibeVoice-ASR(2分19秒) | 46秒 | 9.5% | 26行すべて正しい |
| VibeVoice-ASR+用語のヒント(2分19秒) | 32秒 | 3.5% | 26行中25行(最後の2行が1人分にまとまった) |
| Whisper large-v3-turbo(2分19秒、比較用) | 15秒 | 9.5% | 出せない |
| VibeVoice-ASR+用語のヒント(9分16秒) | 88秒 | 3.0% | 後半ほど区切りがまとまり、104行中71行 |
時間は文字起こしだけで、モデルの読み込み(約10秒)を含みません。文字の誤り率(CER)は、台本と比べて句読点と空白を除いて数えました。GPU のメモリは、2分19秒で17.8GB、9分16秒で22.1GB でした。
VibeVoice-ASR とは?
microsoft/VibeVoice は、Microsoft の音声 AI のモデル群です(MIT ライセンス、2026年11月7日時点でスター約5万6千)。読み上げ(TTS)と文字起こし(ASR)のモデルがあり、この記事では文字起こしの VibeVoice-ASR(7B)を試しました。
README によると、最長60分の音声を区切らずに1回で処理し、話者の区別(話者分離)とタイムスタンプも同時に出します。50以上の言語に対応し、日本語も入っています。
導入
Transformers 5.3 以降に入った、VibeVoice-ASR-HF を使うのがかんたんです。GitHub のリポジトリを入れる必要はありません。
pip install torch --index-url https://download.pytorch.org/whl/cu128
pip install "transformers>=5.3.0" accelerate librosa
モデルは15.5GB で、最初の実行で Hugging Face からダウンロードされます。今回は Python 3.12、PyTorch 2.11(CUDA 12.8)、Transformers 5.22.2 で動かしました。
import torch, librosa
from transformers import AutoProcessor, VibeVoiceAsrForConditionalGeneration
m = "microsoft/VibeVoice-ASR-HF"
processor = AutoProcessor.from_pretrained(m)
model = VibeVoiceAsrForConditionalGeneration.from_pretrained(m, device_map="cuda", dtype=torch.bfloat16)
audio, _ = librosa.load("talk.wav", sr=24000)
inputs = processor.apply_transcription_request(audio, prompt="ComfyUI, LoRA, ノード").to(model.device, model.dtype)
out = model.generate(**inputs)
ids = out[:, inputs["input_ids"].shape[1]:]
print(processor.decode(ids, return_format="parsed")[0])
prompt は省略できます。return_format="parsed" にすると、区間ごとに Start・End・Speaker・Content の一覧で返ります。
試した音声
正解がわかる音声にするため、ローカルの読み上げ(Irodori-TTS)で、女性と男性の2人が画像生成について話す会話(26行、2分19秒)を作りました。「ComfyUI」「RTX 5090」「MiniMax H3」「LoRA」「KOBO Lab」などの用語を入れています。
話者と時刻は正確だった
用語のヒントなしでも、26行すべてで話者(0と1)が正しく分かれました。区間の始まりは、正解との差が平均0.28秒でした。出力は次のような形です。
0 12.41-17.19 いいですね。グラフィックボードは何を使っていますか?
1 17.31-24.48 L2S5090です。メモリが32ギガがあるので、大きなモデルも入ります。
0 24.65-31.48 それなら、動画の生成も試せますね。ミニマックスH3は使いましたか?
話者分離のない Whisper large-v3-turbo は、時間は15秒と速いものの、文字だけが続けて出てきます。会議や対談の記録では、VibeVoice-ASR のほうが手直しが少なく済みます。
用語を渡すと誤りが減る
ヒントなしでは、「ComfyUI」が「コムフォUI」、「LoRA」が「ローラ」、「ノード」が「濃度」になりました。用語を prompt で渡すと、これらは正しく出て、誤り率は9.5%から3.5%に下がりました。
「RTX 5090」は、ヒントを渡しても「L2S 5090」のままでした。Whisper も「LTS」「エットリエス」と聞き取っているので、読み上げの音声の発音がはっきりしなかった可能性があります。
一方で、ヒントありでは、男性の「えっ」が女性の行の終わりに付き、最後の2行(女性と男性)が1つの区間にまとまりました。誤り率は下がっても、区切りが少し粗くなることがあります。
長い音声では話者の区切りがまとまる
2分19秒の会話を4回つないで、9分16秒にして試しました。文字の誤り率は3.0%と低いままでしたが、区間は104行に対して49個になり、後半ほど複数の行が1つの区間にまとまりました。
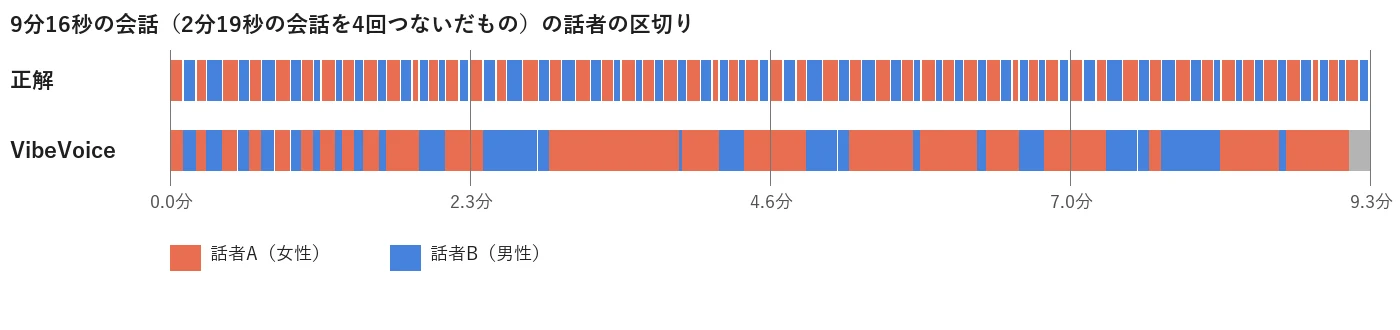
行ごとの話者の正解率は、1回目の2分19秒が26行中23行、2〜4回目は15〜17行でした。長い音声で話者を正確に分けたいときは、区切って処理するか、結果を見直す前提で使うほうがよさそうです。同じ会話を繰り返した、やや不自然な音声での結果です。
商用で使える?
コードとモデルの重みは、どちらも MIT ライセンスです。ただし README には、追加の試験と開発をせずに商用や実際の用途に使うことは勧めない、研究開発向けのモデルだと書かれています。
また、音声の AI 全般の注意として、なりすましや偽の音声に使われる危険にも触れられています。人の声を文字起こしするときは、話した人の同意を得てください。
RTX 5090 以外の人へ
7B のモデルを bf16 で動かすと、2分の音声で約18GB、9分で約22GB を使いました。24GB の GPU なら動く見込みですが、16GB 以下では足りません。README には、CPU で動く BitNet 版や、話しながら文字にするストリーミング版もあります(今回は試していません)。
よくある質問(FAQ)
Q. VibeVoice-ASR とは?
Microsoft の文字起こしモデルです。話者の区別とタイムスタンプを含めて、最長60分の音声を1回で文字にします。MIT ライセンスで、Transformers 5.3 以降で使えます。
Q. VibeVoice-ASR は日本語に対応している?
対応しています。2人の会話で、文字の誤り率は約9.5%、用語のヒントを渡すと約3.5%でした。
Q. VibeVoice-ASR に必要な VRAM は?
bf16 で、2分19秒の音声に17.8GB、9分16秒に22.1GB を使いました(RTX 5090)。
Q. Whisper との違いは?
VibeVoice-ASR は話者とタイムスタンプを一緒に出せます。Whisper large-v3-turbo は話者を出せませんが、今回は3倍ほど速く、文字の誤り率は同じくらいでした。
まとめ
VibeVoice-ASR は、2〜3分の会話なら、話者と時刻まで含めて手直しの少ない文字起こしができました。用語のヒントは効果が大きく、長い音声では話者の区切りを確かめる必要があります。
用語を prompt で渡し、長い録音は区切って処理する。
検証メモ
- 音声:Irodori-TTS v4 Small の Voice Design で、女性と男性の声を作り、26行の台本を読ませて0.6秒の間を入れてつなぎました(24kHz)。正解は台本の文字と、つないだときの時刻です。
- 誤り率:NFKC で正規化し、句読点・記号・空白・長音を除いて、台本全体と出力全体の編集距離を数えました。読み上げ側の発音の誤り(RTX など)も誤りに含まれます。
- 話者の正解率:台本の各行の中央の時刻を含む区間の話者を、多数決で決めた対応(女性=0、男性=1)と比べました。
- Whisper:Transformers の pipeline で、日本語を指定して長い音声をそのまま処理しました。30秒ずつ並列に処理する設定では、つなぎ目で文が重なり、「ご視聴ありがとうございました」が入り込んだため、使っていません。
- 試していないこと:実際の録音(雑音・重なり・3人以上)、60分の音声、BitNet 版・ストリーミング版、vLLM での実行、読み上げ(TTS)のモデル。