この記事について(広告・アフィリエイトリンクはありません)
使ったモデルとソフトは、すべて無料で入手できます。試した環境の一覧は検証の記録にあります。
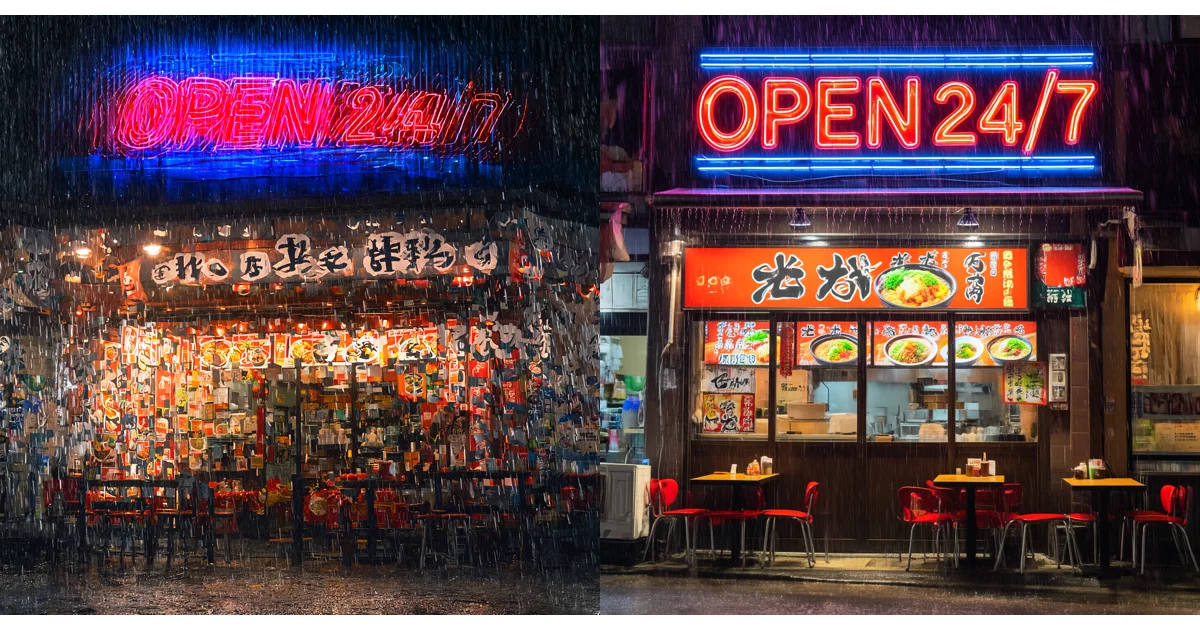
P-H3-Image を6ステップにすると、1枚が約14秒から約9秒になりました。ただし、Turbo LoRA の配布ページの手順どおりでは、6ステップでも4ステップでも絵が崩れました。 ComfyUI の「MiniMax H3 Sigma Shift」のビデオシフトを 1 から 10 に上げると、6ステップでも崩れずに描けています。
意外だったのは、シフトを10にすれば、LoRA なしでも6ステップで描けたことです。今回の比較では、LoRA を入れたときとの差ははっきりしませんでした。
先に結論(今回のテスト条件で)
| 条件 | 1枚の時間(中央値) | 崩れなかった枚数 |
|---|---|---|
| 公式の8ステップ(シフト 1) | 14.2秒 | 9枚中9枚 |
| 配布ページの手順の6ステップ(シフト 1、LoRA あり) | 9.0秒 | 9枚中0枚 |
| 同じ手順の4ステップ(LoRA あり) | 6.9秒 | 9枚中0枚 |
| 6ステップ・シフト 10・LoRA なし | 約9.1秒 | 19枚中19枚 |
| 6ステップ・シフト 10・LoRA あり | 約9.1秒 | 19枚中19枚 |
| 4ステップ・シフト 10・LoRA あり | 約6.8秒 | 9枚中0枚 |
8MP(2912×2912)、w4a8 の一式、RTX 5090。3つのプロンプト×シード3つの9枚に、看板のプロンプトでシード10個を足して数えました(19枚)。「崩れなかった」は筆者の目視です。
配布ページの手順どおりだとどうなる?
Turbo LoRA の配布ページには、ComfyUI での使い方として「Load LoRA (Bypass, Model Only) を入れ、ManualSigmas を BasicScheduler(simple、6ステップ)に替える」と書かれています。その手順どおりに組むと、モザイクのように崩れた絵になりました。
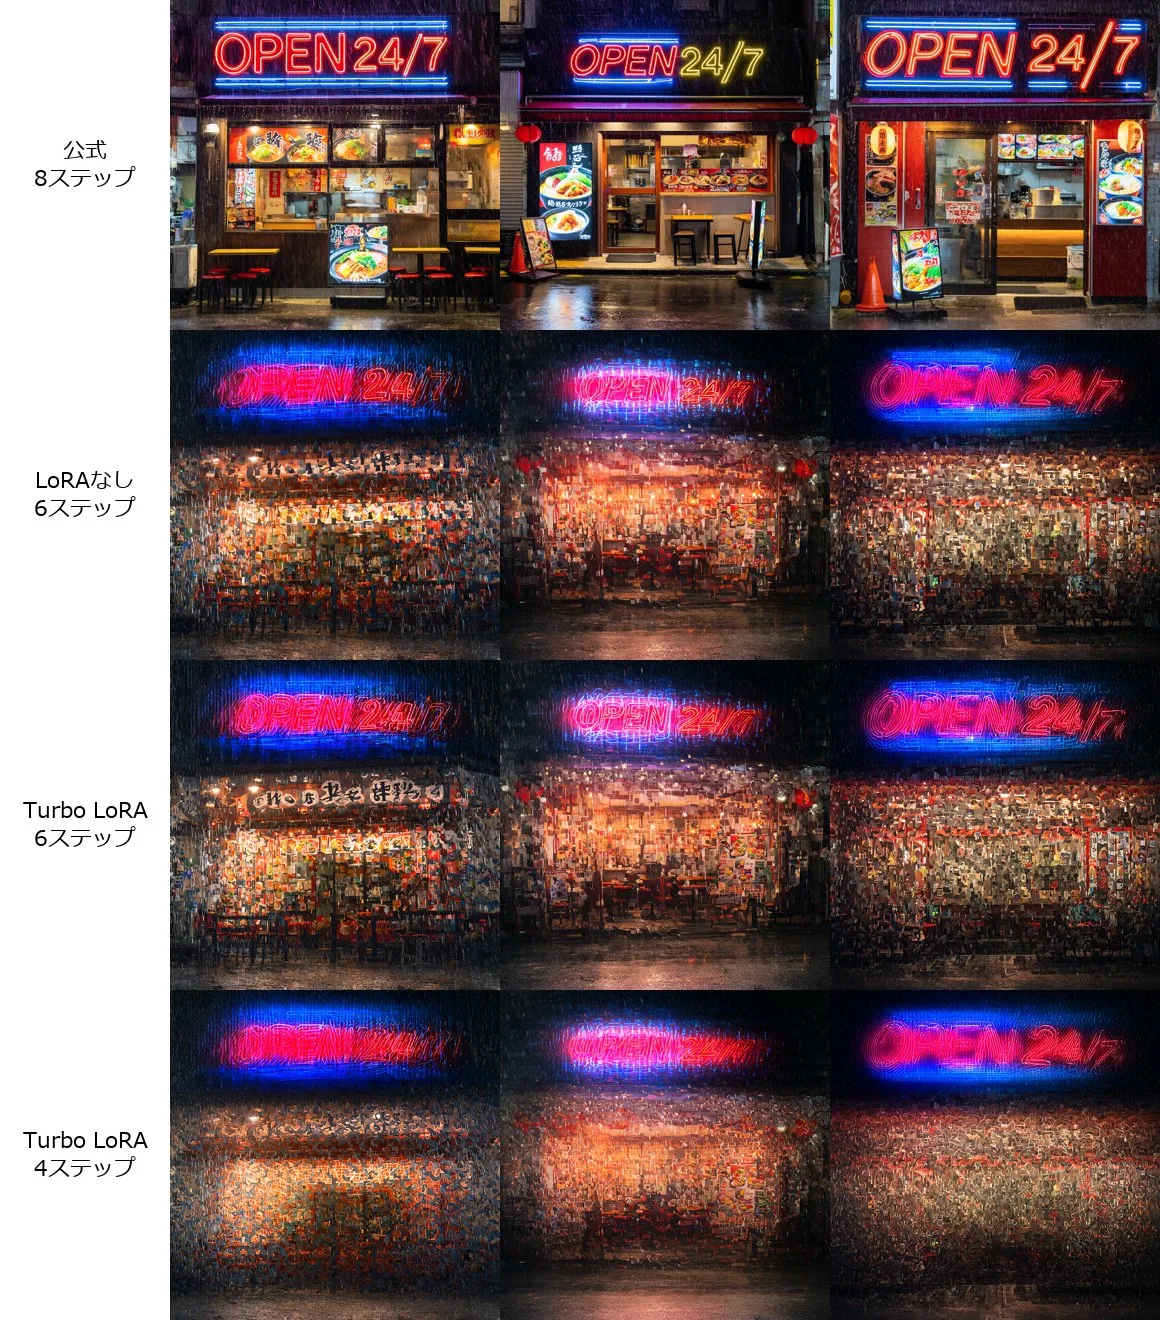
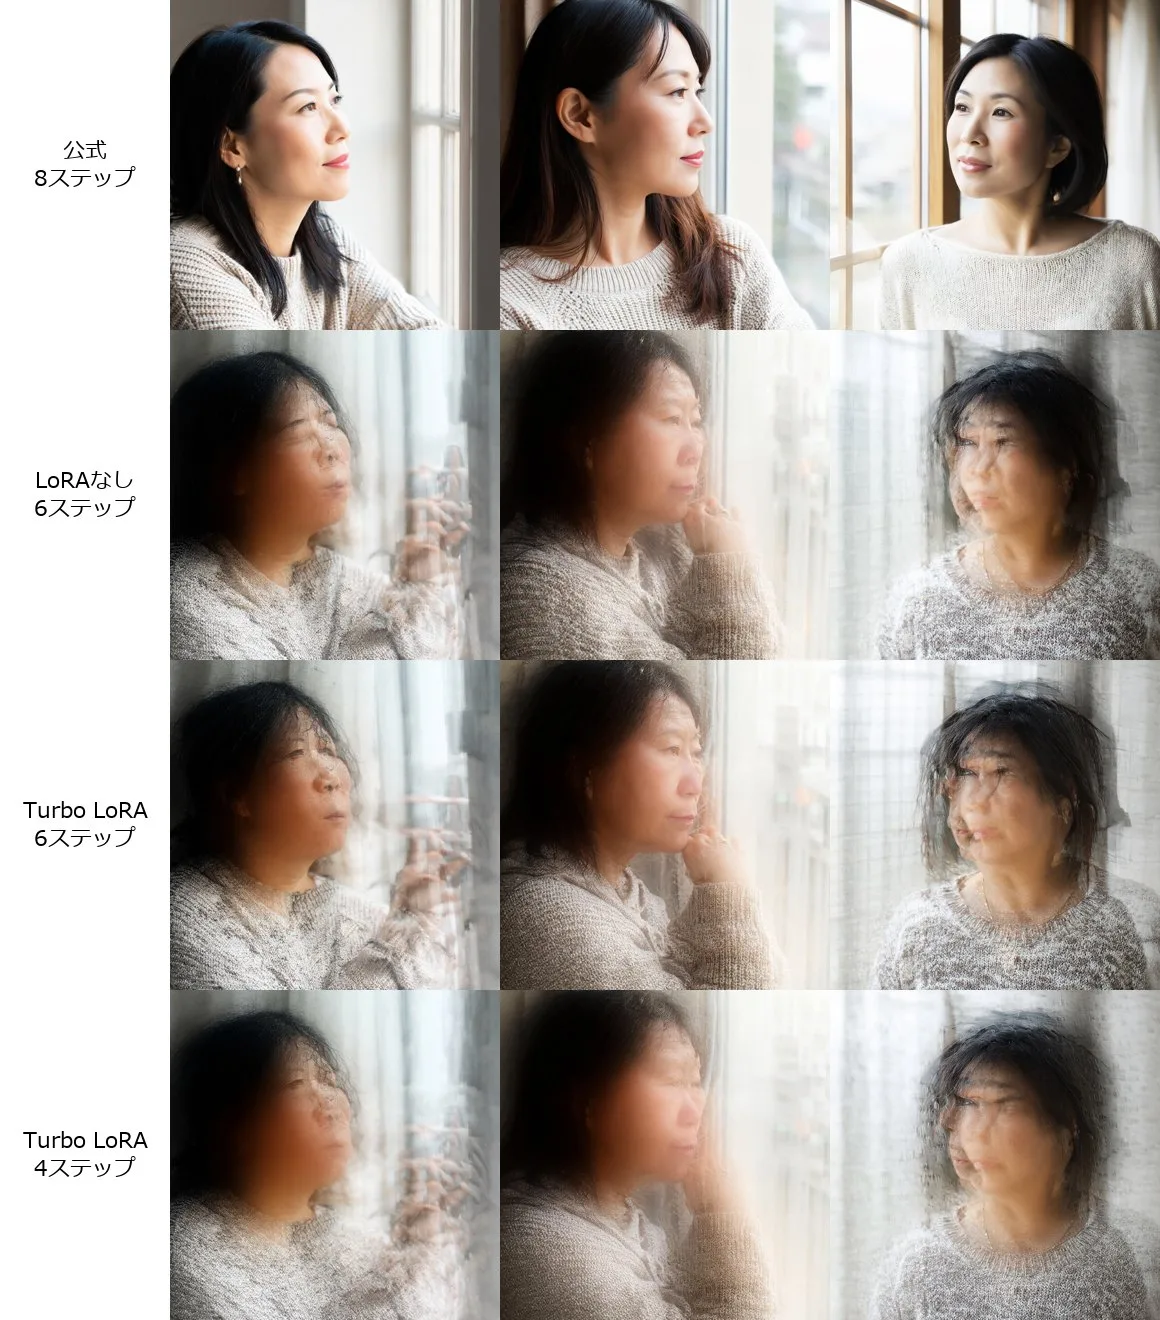
LoRA ありでもなしでも、同じように崩れています。原因は LoRA ではなく、ステップの刻み方のほうでした。公式の8ステップは、最初のほうを細かく刻む決まった値(ManualSigmas)を使っています。simple のスケジューラーに替えると、この刻み方が大きく変わります。
シフトを10にすると描ける
「MiniMax H3 Sigma Shift」のビデオシフトを上げると、刻み方が最初のほうに寄ります。公式の8ステップの刻み方に近づけるつもりで 10 にしたところ、6ステップで崩れなくなりました。
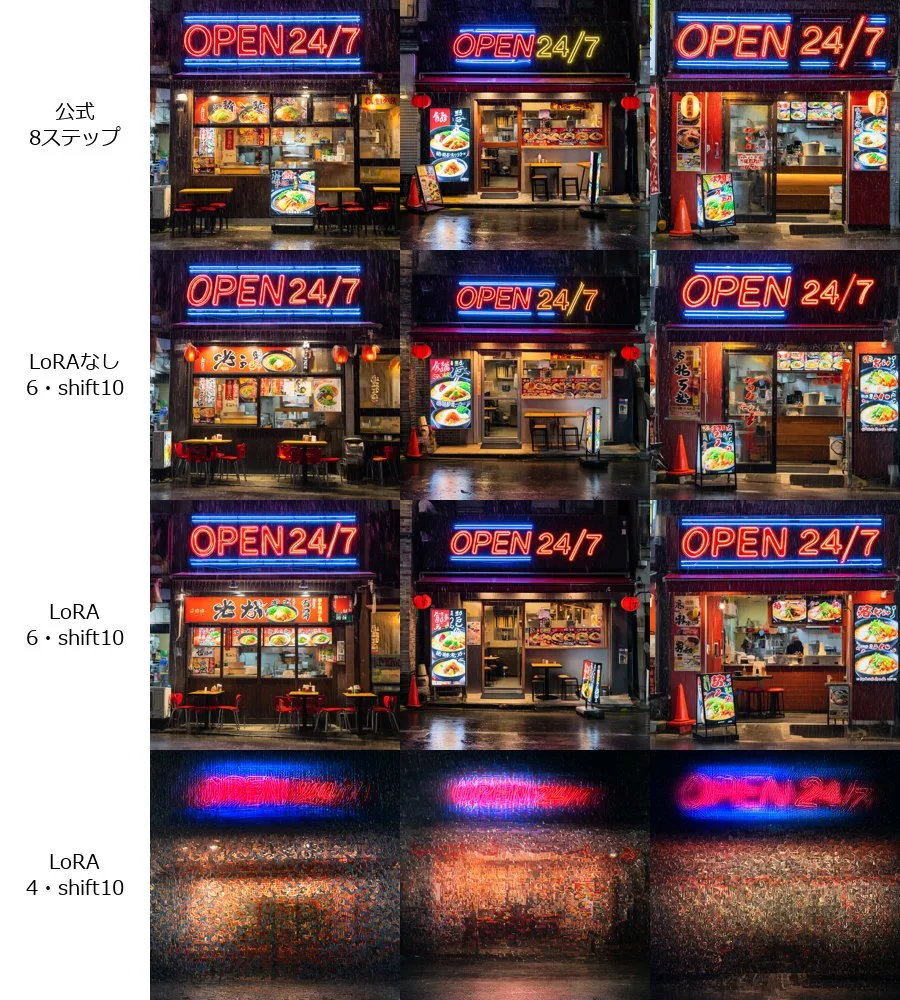
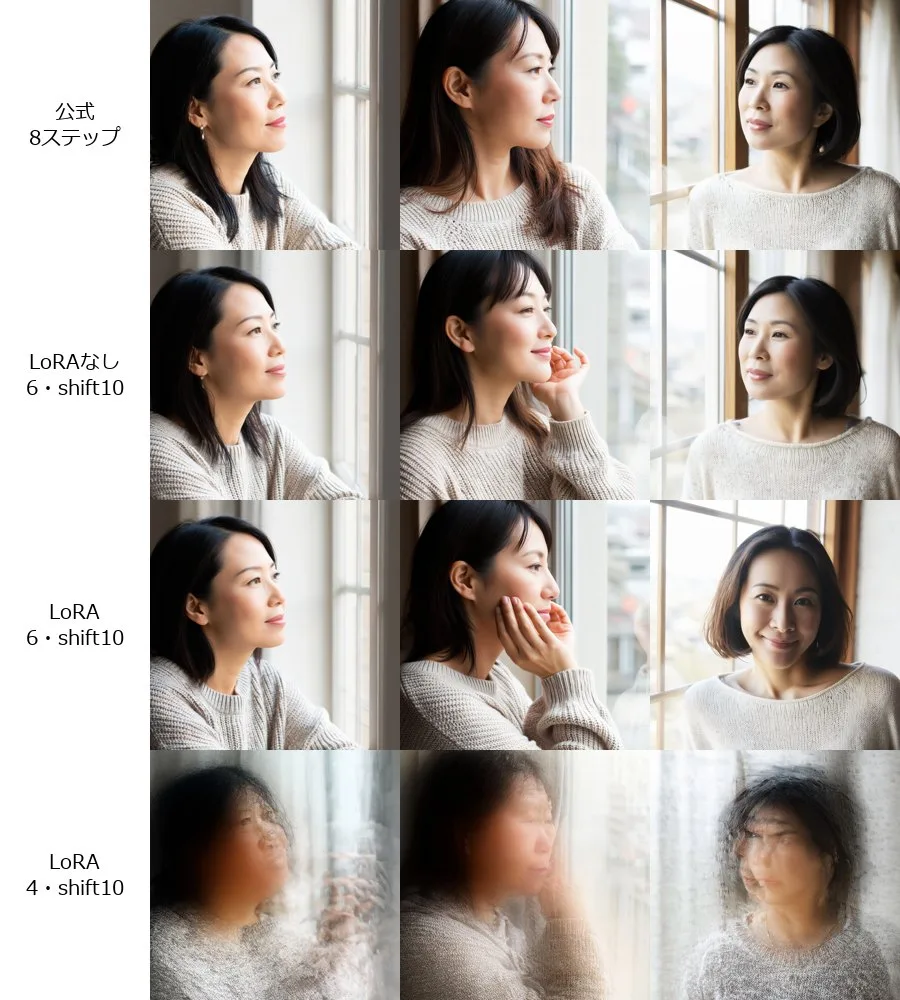
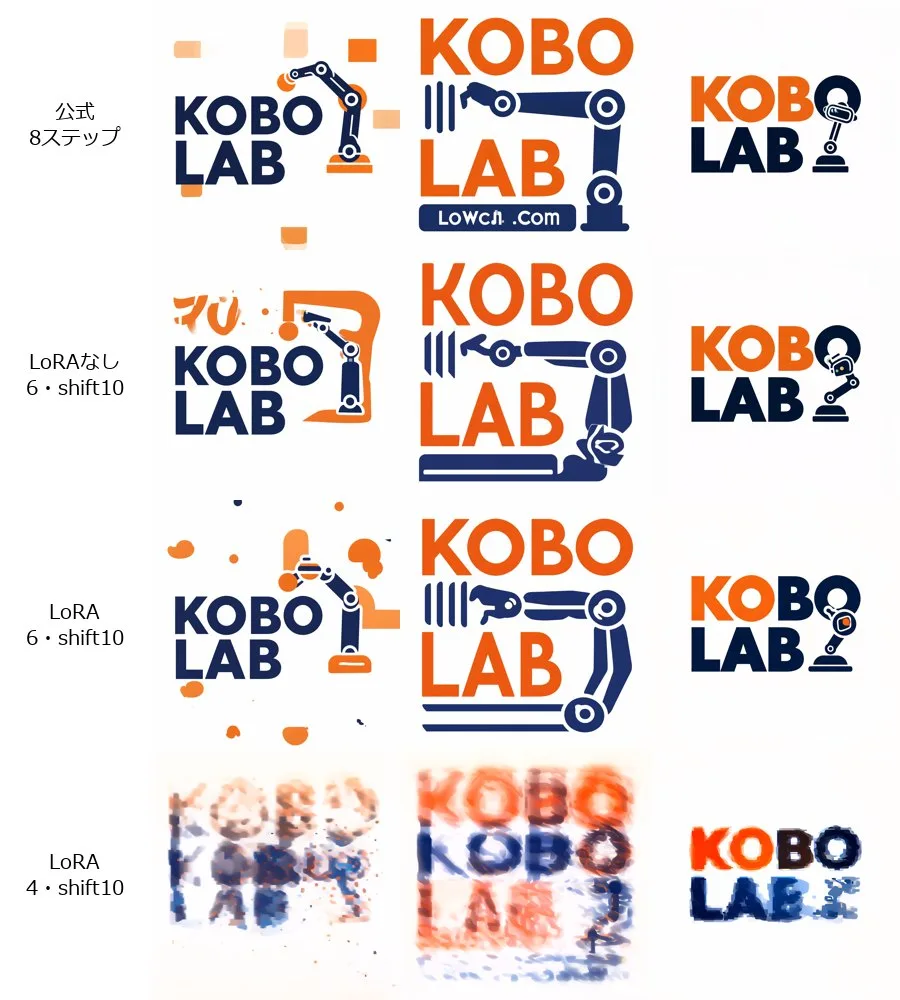
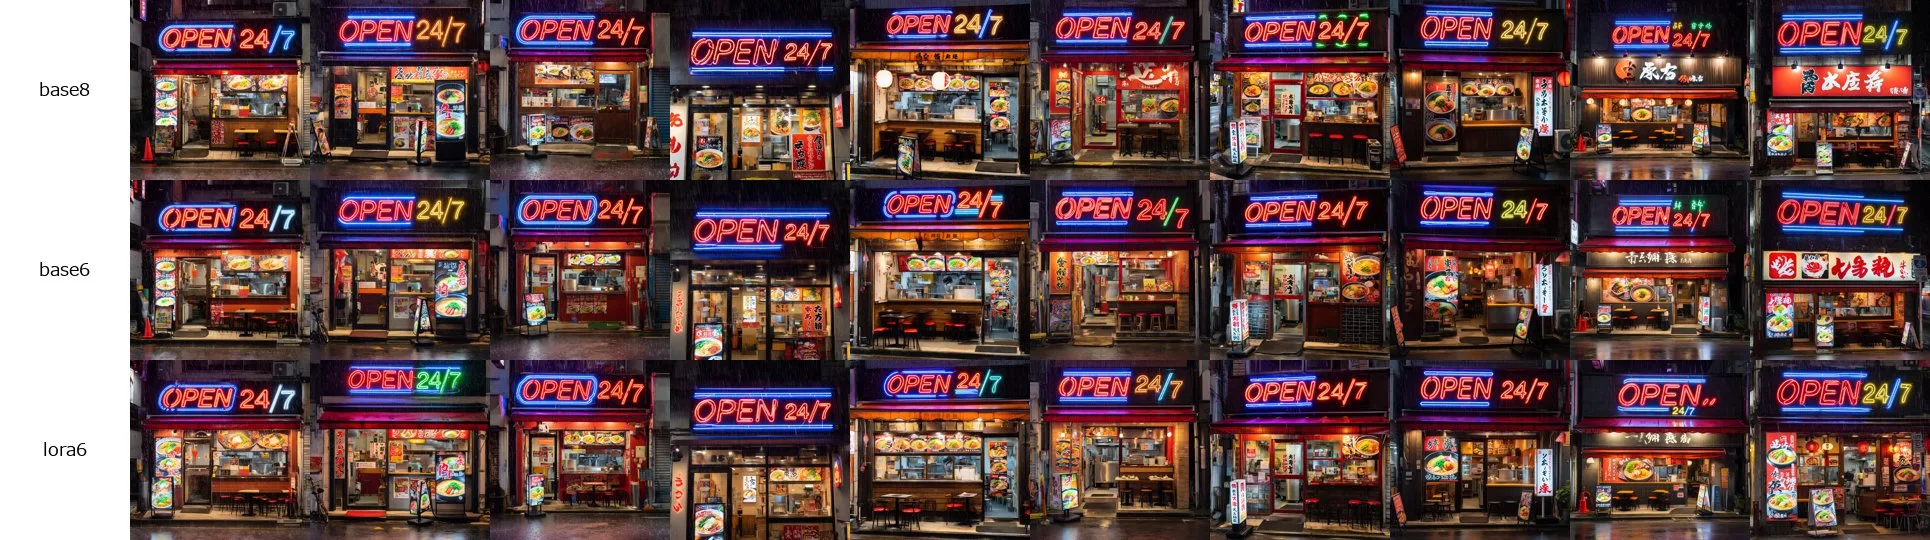
ポスターだけは、6ステップでまわりにオレンジの点が散る回がありました。文字「KOBO LAB」はどの6ステップでも読めています。4ステップは、シフトを10にしても崩れたままでした。
シードを10個に増やしても、6ステップ・シフト10は LoRA ありでもなしでも10枚とも崩れませんでした。
Turbo LoRA は効いている?
6ステップ・シフト10で、LoRA ありとなしを同じシードで並べると、構図はほぼ同じで細部が少し変わる程度でした。どちらがきれいかは、筆者には決められませんでした。
配布ページでは、元の環境(diffusers、bf16、H200)で6ステップの LoRA ありが8ステップより好まれたとしています。ComfyUI で量子化版を使う今回の条件では、その差は再現できていません。
LoRA を読み込むときの注意
配布ページにある「Load LoRA (Bypass, Model Only)」は、量子化版(w4a8 と int8)のモデルではエラーになりました。
mat1 and mat2 shapes cannot be multiplied (1x16 and 2688x16)ふつうの「LoRAローダーモデルのみ(LoraLoaderModelOnly)」に替えると、w4a8 でも int8 でも動きました。bf16 の本体では試していません。
ワークフローと設定
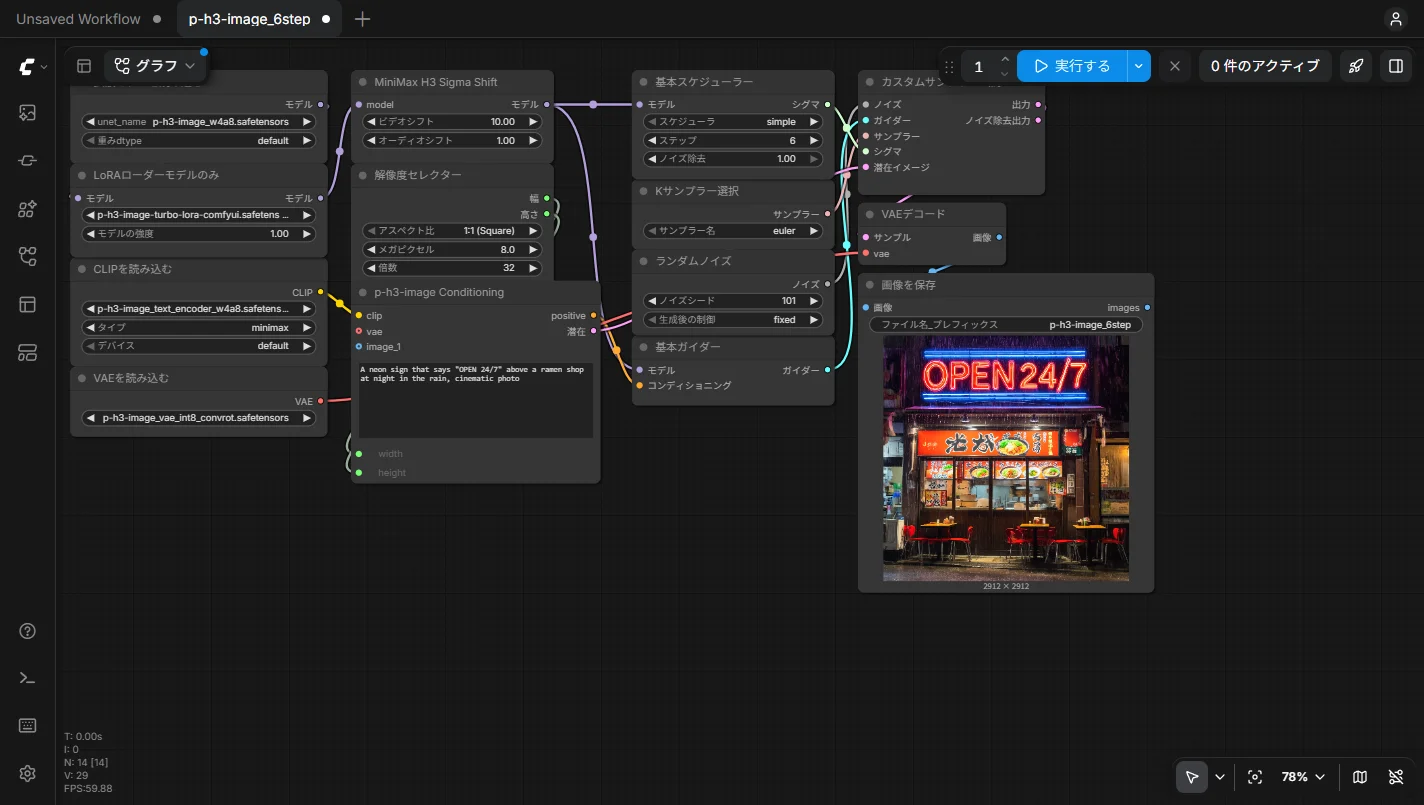
| 項目 | 公式の8ステップ | 今回の6ステップ |
|---|---|---|
| シグマ | ManualSigmas(決まった8ステップの値) | BasicScheduler(simple、6ステップ) |
| ビデオシフト | 1 | 10 |
| Turbo LoRA | なし | あり・なしどちらも可(強さ 1.0) |
| LoRA の読み込み | — | LoraLoaderModelOnly |
- P-H3-Image 6ステップ(シフト10・Turbo LoRA)のワークフロー(JSON)ComfyUI v0.44.0 以降でドラッグして読み込みます。LoRA を使わないときは LoRA のノードを外してつなぎ直します
| ファイル | 大きさ | 置き場所 |
|---|---|---|
| p-h3-image-turbo-lora-comfyui.safetensors | 0.78GB | models\loras |
本体、テキストエンコーダー、VAE の入れ方はP-H3-Image を ComfyUI で使う方法にまとめています。
RTX 5090 以外の人へ
今回は --reserve-vram の簡易テストをしていません。8MP の w4a8 一式は、配布元の説明では最大で約21GB の VRAM を使います。VRAM の目安はP-H3-Image の記事の「RTX 5090 以外の人へ」も見てください。
商用で使える?
Turbo LoRA の配布ページは、ライセンスを MiniMax H3 Community License としています(P-H3-Image と同じ規約へのリンク)。この規約には地域の制限と使い方の制限があります。MiniMax H3 本体の規約は導入編でも説明しています。LoRA のもとになった変換元は Apache-2.0 と書かれています。規約の中身は P-H3-Image の記事でまとめています。
よくある質問(FAQ)
Q. P-H3-Image を速くする方法は?
今回の検証では、6ステップにして MiniMax H3 Sigma Shift のビデオシフトを 10 にすると、1枚が約14秒から約9秒になりました。4ステップはどの設定でも崩れました。
Q. P-H3-Image-Turbo LoRA で絵が崩れるのはなぜ?
BasicScheduler(simple)に替えたとき、ビデオシフトが 1 のままだと崩れました。シフトを 10 に上げると崩れなくなりました。
Q. 「mat1 and mat2 shapes cannot be multiplied」と出る
量子化版(w4a8・int8)で Load LoRA (Bypass, Model Only) を使ったときに出ました。ふつうの LoraLoaderModelOnly に替えると動きました。
Q. Turbo LoRA は必要?
今回の条件では、シフト10の6ステップなら LoRA なしでも崩れず、ありとの差ははっきりしませんでした。
まとめ
P-H3-Image の高速化で効いたのは、LoRA よりもステップの刻み方でした。6ステップにするなら、シフトを10に上げるのがポイントです。
確実なのは公式の8ステップ、速くするなら6ステップ・シフト10。 4ステップは今回、使える絵になりませんでした。
検証メモ
- 本数:看板・人物・ポスターの3つのプロンプト×シード 101・202・303 を各条件で作りました。シフト10の6ステップは、看板のプロンプトでシード10個を足しています。シフト6も各1枚だけ試し、崩れませんでした。
- 時間:ComfyUI の実行開始から完了まで。読み込みを除くため、各条件の前に1枚空回ししました。
- 一度だけの崩れ:シフト10・LoRA ありの6ステップで、画面から実行した1回と、その直後の API からの1回だけ崩れた絵が出ました。同じ設定とシードで実行し直すと崩れず、原因は確かめられていません。
- シフトの値:10 は、公式の8ステップの値に近づけるつもりで選んだ値で、最適な値は探していません。
- 未確認のこと:bf16 の本体、編集(参照画像あり)、8MP 以外、ほかの GPU、
--reserve-vramの簡易テスト。