この記事について(広告・アフィリエイトリンクはありません)
紹介しているソフトとモデルは、すべて無料で入手できるものです。検証の記録に、試した環境の一覧があります。
Viggle Remake は RTX 5090 で問題なく動き、832×480、約9.4秒の動画を1本約155秒で作り直せました。 動きとカメラは元の動画のまま、人物や物だけが変わり、音声も残ります。
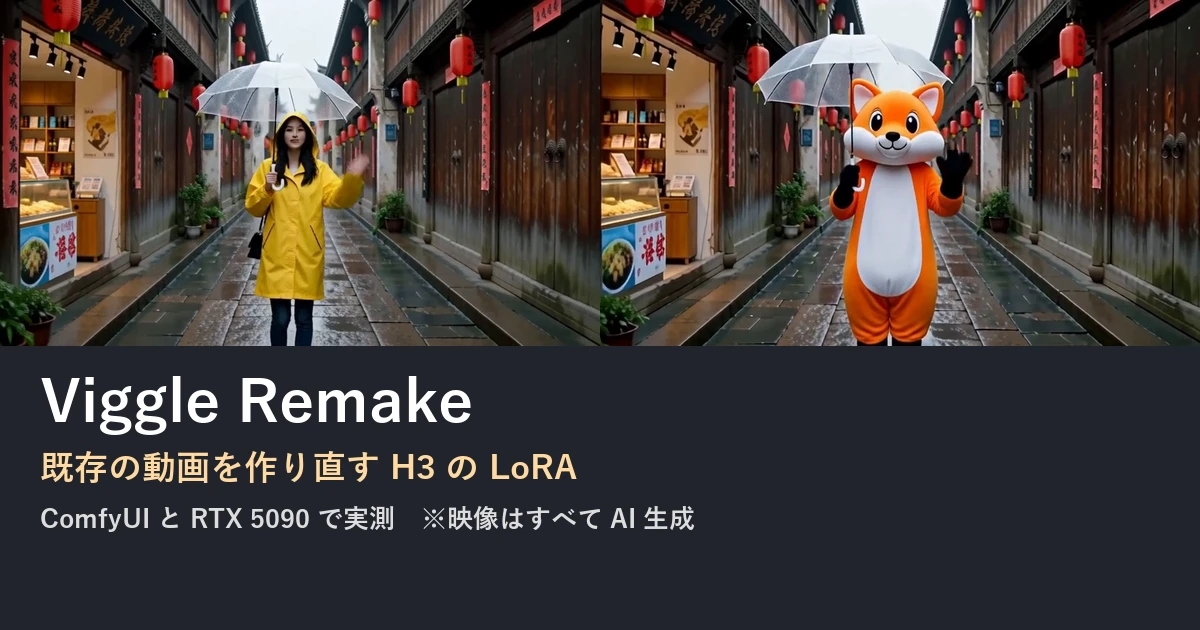
Viggle Remake は、MiniMax H3 で既存の動画を作り直すための LoRA です。人物やキャラクターを替える swap と、物や背景を変える edit の2種類があります。ComfyUI では、専用ノード3個と標準のノードで動きます。
先に結論(今回のテスト条件で)
832×480、226 フレーム(約9.4秒)、6 ステップ、モデルの読み込み後の時間です。
| モデル | ファイル | 1ステップ | 1本 | VRAM ピーク(全体) |
|---|---|---|---|---|
| 公式 int8(LoRA 結合済み) | 21.0GB | 23.1〜24.1秒 | 152〜156秒 | 31.6GB |
| H3 int8+LoRA(バイパス) | 3.8GB を追加 | 25.5〜26.4秒 | 166〜171秒 | 31.4GB |
| 公式 GGUF Q4_K_M | 14.3GB | 30.9〜31.6秒 | 198〜201秒 | 27.3GB |
- 迷ったら公式 int8 です。 いちばん速く、ComfyUI-GGUF も要りません。
- H3 の int8 をすでに持っているなら、LoRA だけ足す方法でも同じ内容の動画になりました。
- ファイルは大きめです。 公式 int8 は edit と swap で別々なので、両方で 42GB になります。
どんな動画ができる?
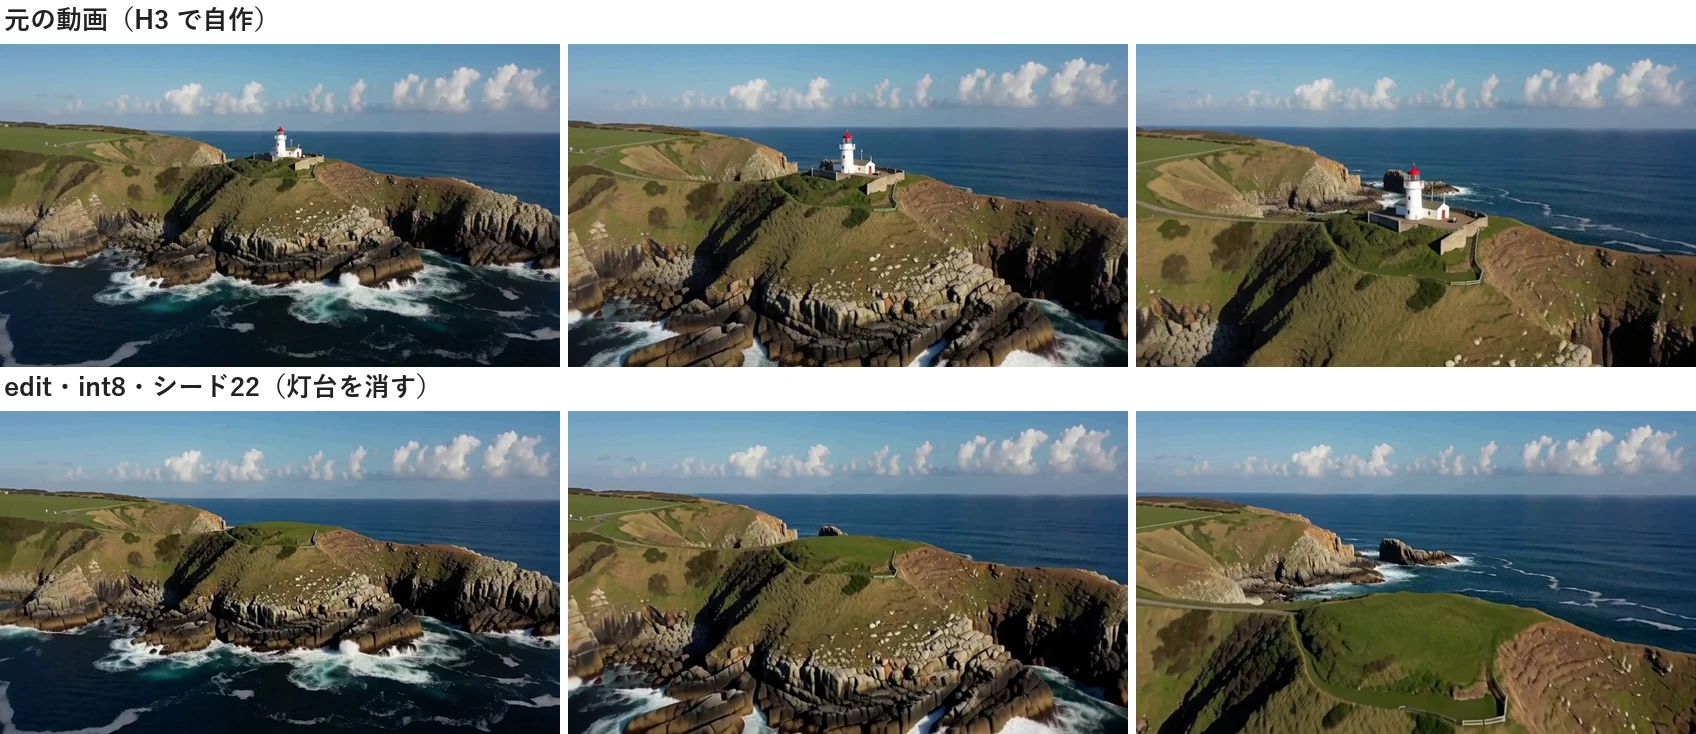
edit:灯台だけを消す
元の動画は MiniMax H3 で自作しました。岬に立つ灯台を消す指定です。同じ指定で作った 15 本すべてで、灯台は戻りませんでした。
swap:人物をマスコットに替える
雨の路地を歩く架空の女性を、キツネの着ぐるみのマスコットに替えました。これも 15 本すべてで替わり、確かめたコマに人の顔や髪は出ていません。歩く速さ、手を振る動き、背景は元の動画に沿っています。
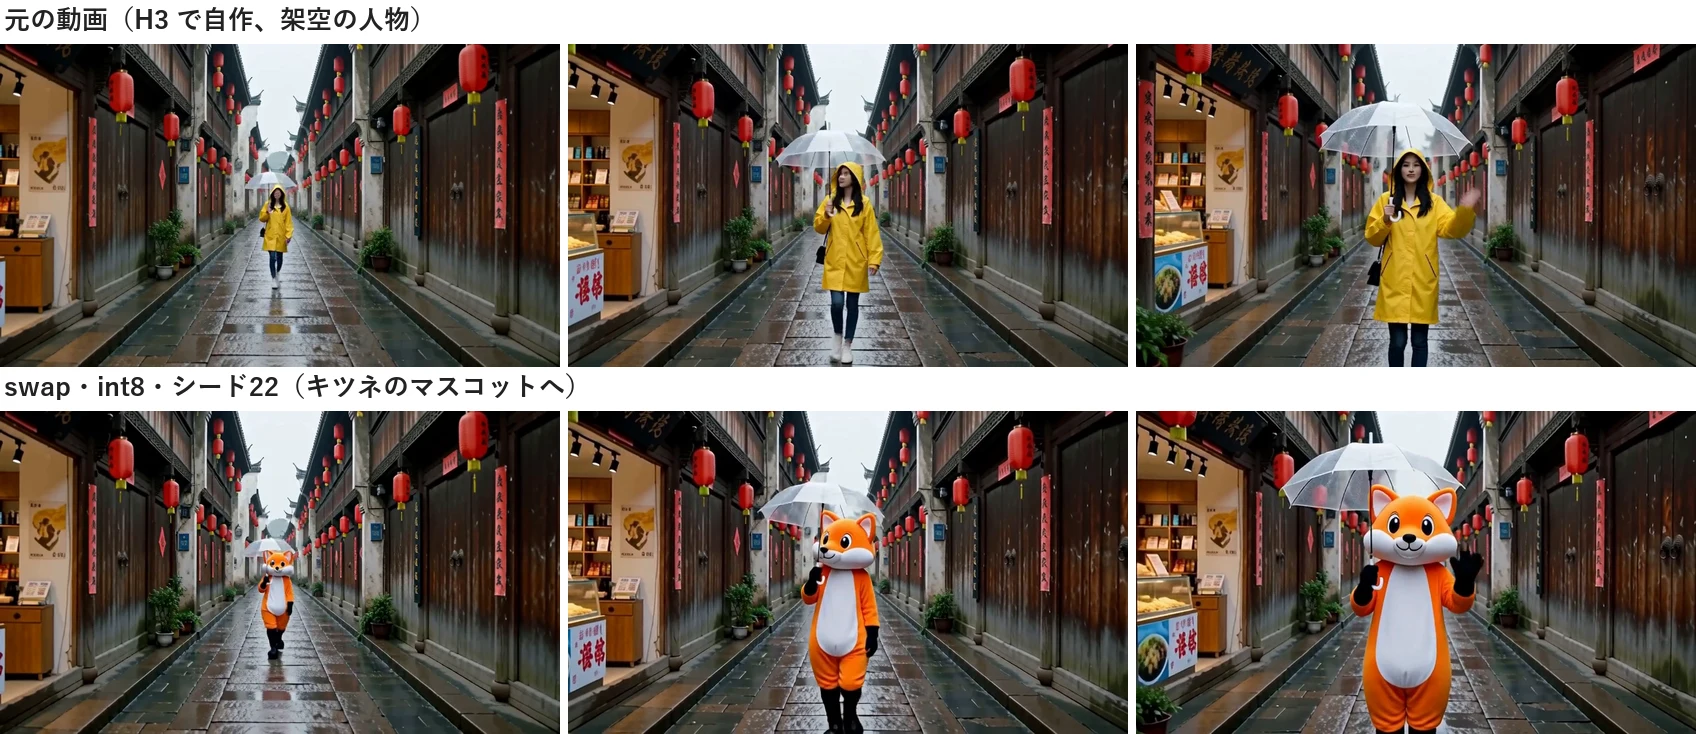
音声は元のものが残る?
残ります。元の音声と出力の音声を比べると、相関は 0.96〜0.98、時間のずれは 0 サンプルでした。音声は VAE を通るので波形は完全には一致しませんが、音を新しく作る仕組みではありません。
試した環境
| 項目 | 内容 |
|---|---|
| GPU | RTX 5090(32GB)、PyTorch 2.14.0+cu130 |
| CPU / RAM | Ryzen 9 9950X3D / 128GB |
| ComfyUI | v0.44.0 ポータブル版。公式のテストは 0.42.0 |
| モデルの置き場所 | USB 接続の HDD |
| テキストエンコーダー | qwen3vl nvfp4(公式の例は bf16) |
| VAE | 映像 fp16、音声 fp32 |
| 設定 | euler、公式の ManualSigmas の 6 ステップ、keyframe_until 0.9 |
| 検証日 | 2026年11月5日 |
導入の手順
ComfyUI で動かすには、ノードの導入、モデルの配置、ワークフローの読み込みの順に進めます。H3 の導入がまだなら、先に MiniMax H3 の導入記事を見てください。
専用ノードを入れる
Hugging Face の comfyui/ComfyUI-Viggle-Remake を custom_nodes に置いて、ComfyUI を起動し直します。git clone はしないでください。 公式の説明では、リポジトリ全体が約210GB あります。
hf download Viggle/Viggle-Remake --include "comfyui/ComfyUI-Viggle-Remake/*" --local-dir Viggle-Remakeダウンロードしたフォルダーの ComfyUI-Viggle-Remake を ComfyUI\custom_nodes へ移します。増えるノードは Viggle Remake Conditioning、Keyframe Until、Noise の3個です。
モデルを置く
| ファイル | サイズ | 置き場所 |
|---|---|---|
| viggle_remake_edit_pruned_int8_convrot.safetensors | 21.0GB | models\diffusion_models |
| viggle_remake_swap_pruned_int8_convrot.safetensors | 21.0GB | models\diffusion_models |
| qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors | 15.7GB | models\text_encoders |
| minimax_h3_video_vae_fp16.safetensors | 5.2GB | models\vae |
| minimax_h3_audio_vae_fp32.safetensors | 0.6GB | models\vae |
int8 のファイルには LoRA が結合済みです。上に LoRA を重ねないでください。 edit のファイルには edit のシグマ、swap のファイルには swap のシグマを使います。下のワークフローは設定済みです。
ワークフローを読み込む
公式のグラフを int8 用に組み替えたものです。プロンプトは今回の検証のものが入っているので、自分の動画に合わせて書き替えてください。
- viggle_remake_edit_int8_workflow.jsonComfyUI にドラッグして読み込みます(edit、int8、832×480、226 フレーム。ComfyUI-Viggle-Remake が必要です)
- viggle_remake_swap_int8_workflow.jsonComfyUI にドラッグして読み込みます(swap、int8、832×480、226 フレーム。ComfyUI-Viggle-Remake が必要です)
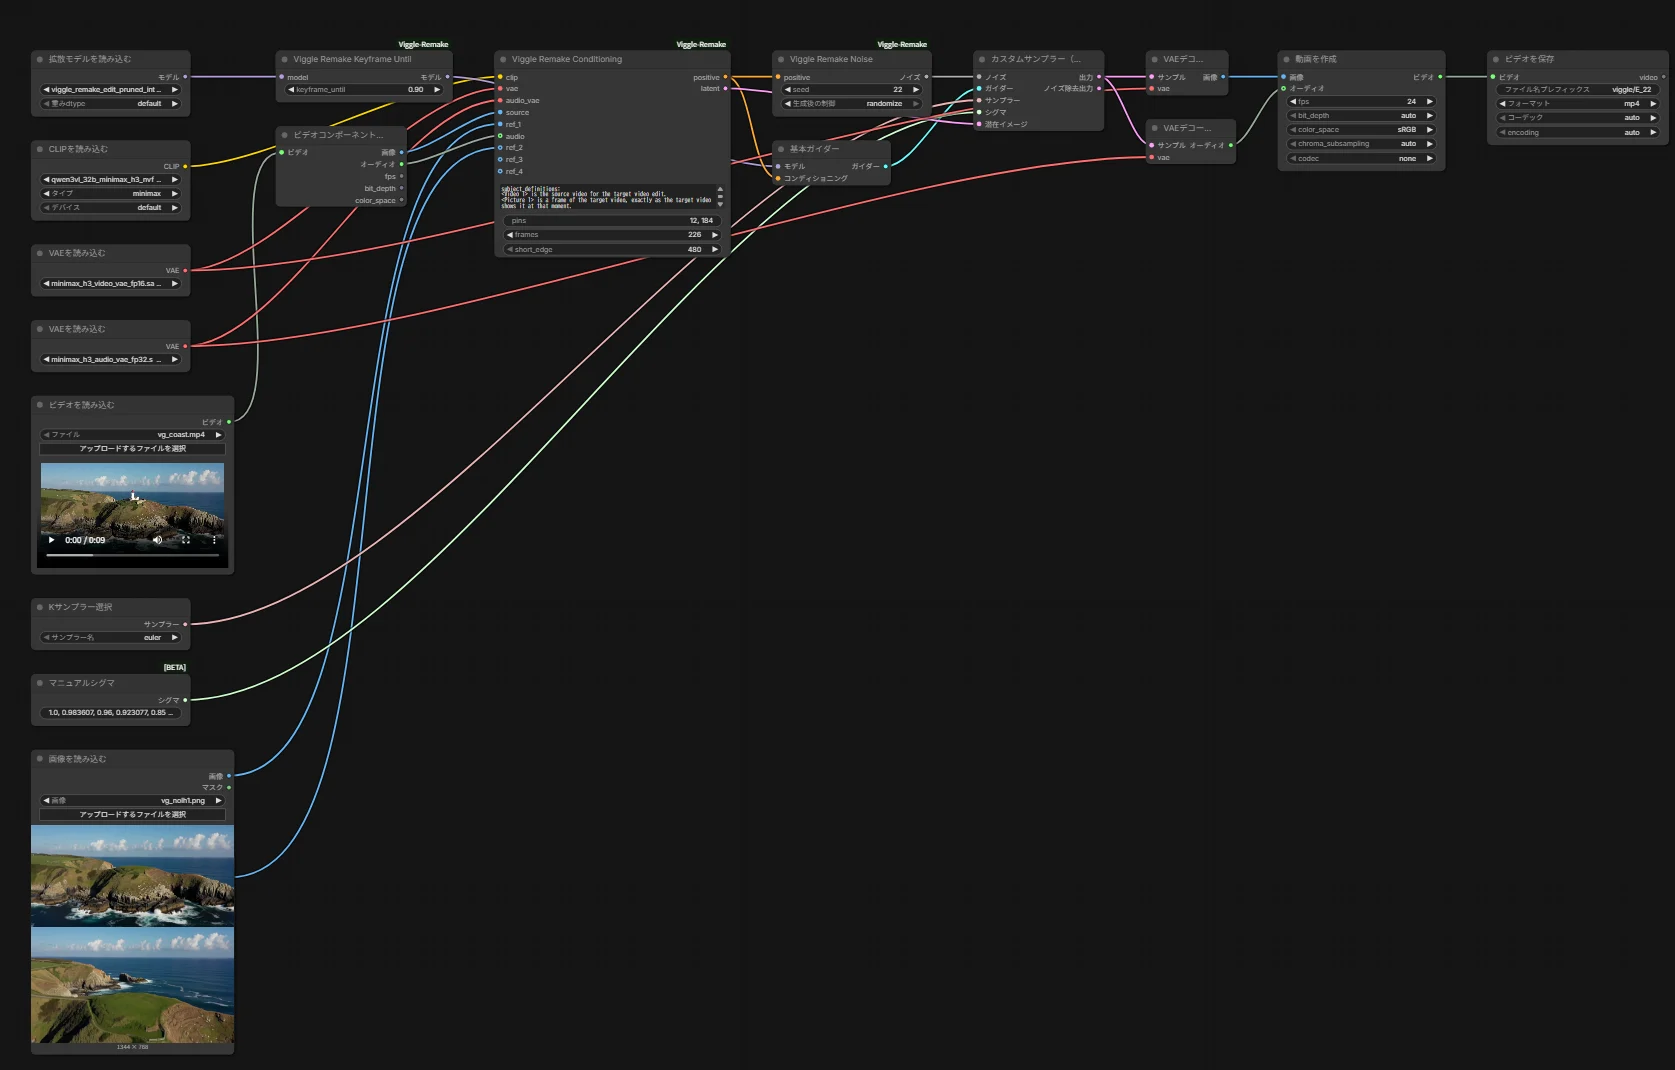
edit のワークフローは画面から実行して、成功を確かめました(347秒、モデルの読み込みを含みます)。下の「公式の表と違った点」の 469〜594秒とは別の日時・別の ComfyUI での1本目です。モデルの初期化が 75.85秒と短かった理由は確かめていません。swap は同じ構成を API から実行しています。
自分の動画を入れるときの決まり
| 項目 | 決まり |
|---|---|
| 元の動画 | 24fps にしておく。公式の例は ffmpeg -i in.mp4 -r 24 source.mp4 |
frames | 17n+5 で 90〜345。226 で約9.4秒、124 で約5.2秒 |
short_edge | 480(832×480)か 736(1280×736) |
pins | 参照画像を置くフレーム番号。参照と同じ数か、空欄 |
| プロンプト | 公式の6節の形式。節の順番も決まっている |
プロンプトの書き方は公式の PROMPTING.md にあります。「替えて」と指示するのではなく、完成した動画の説明として書き、retention_analysis の節で何が変わるかを示します。
参照画像は構図を合わせる
出来をいちばん左右したのは、参照画像でした。
参照画像は、元の動画の1コマを描き替えたものです。公式の例は有料の gpt-image で作られています。私は無料の範囲で試すために、P-H3-Image の編集機能をローカルで使いました。
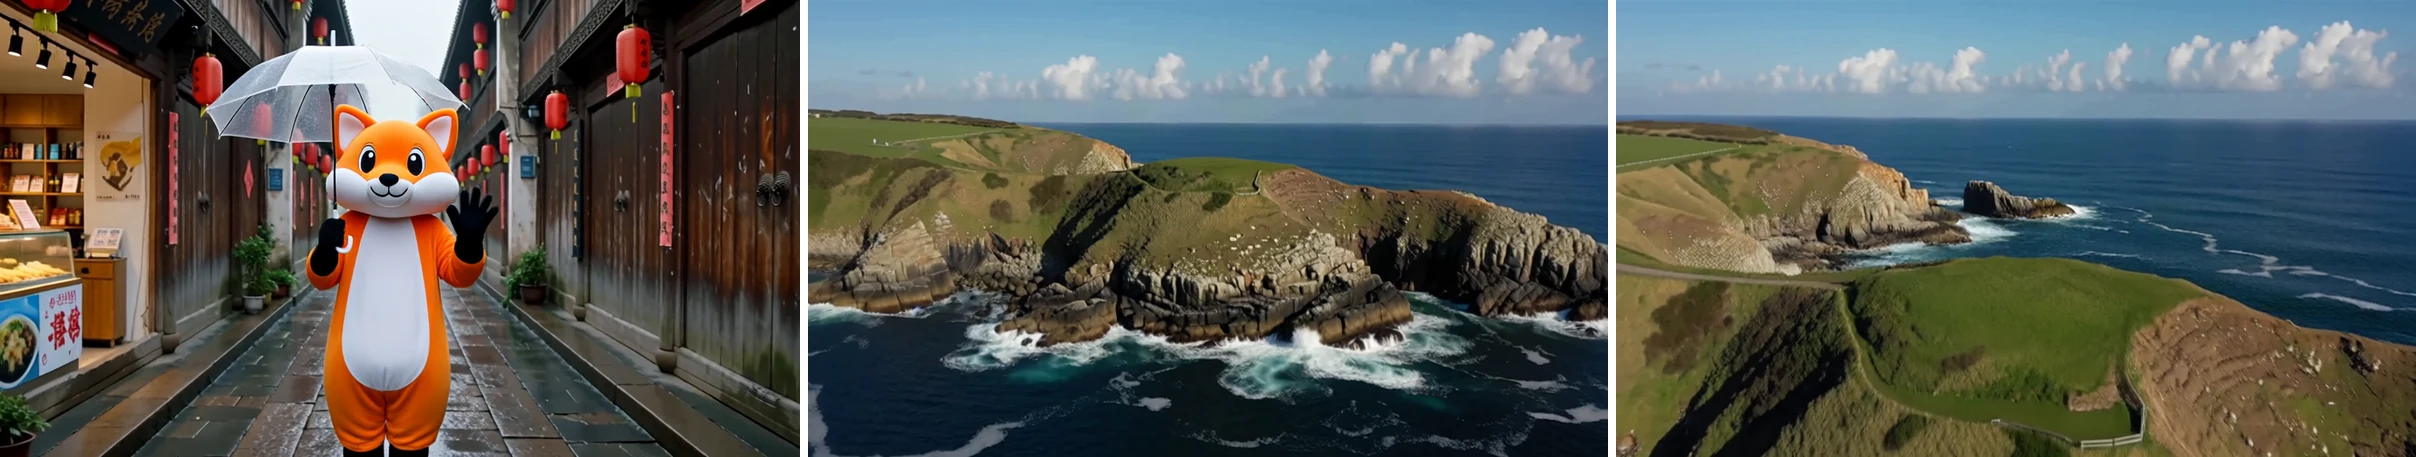
灯台を消す編集は6枚とも構図が保たれました。難しかったのは、遠くに小さく映る人物です。12 フレーム目の女性を替える編集は確かめた9枚すべてで、人物が元より大きくなりました。
この画像をそのまま pins で 12 フレーム目に固定すると、下のようになります。
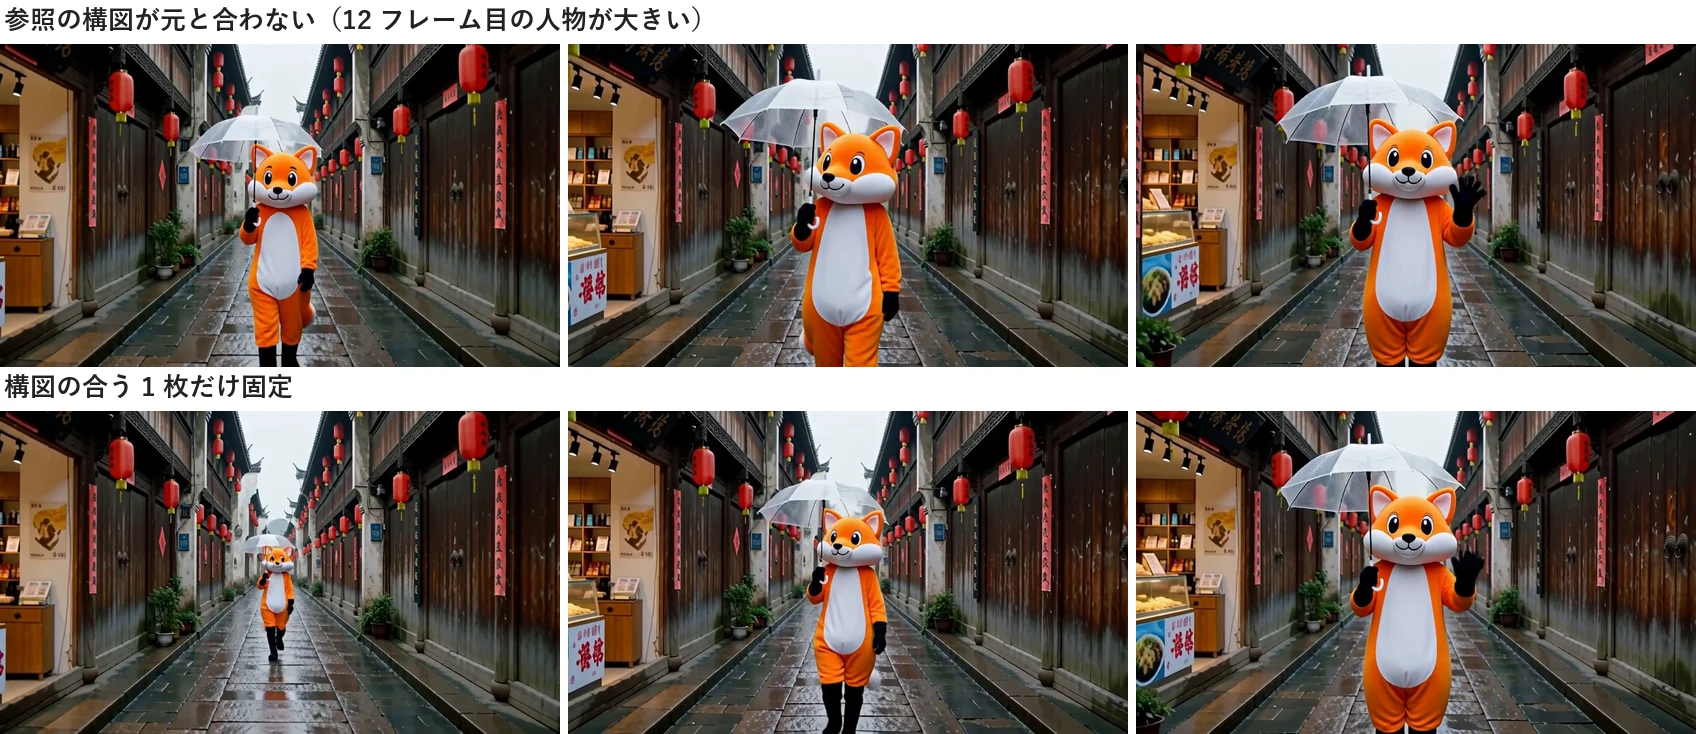
1枚目で人物が大きく映り、元の動画の遠くから歩いてくる動きが消えました。そこで、構図の合う 184 フレーム目の1枚だけを固定すると、遠くの場面も元の動画どおりになります。公式の説明でも、固定した参照はそのフレームの構図を決めるとされています。
構図が合わないコマは無理に固定しない。 これが今回いちばんの学びです。
pins は入れたほうがいい?
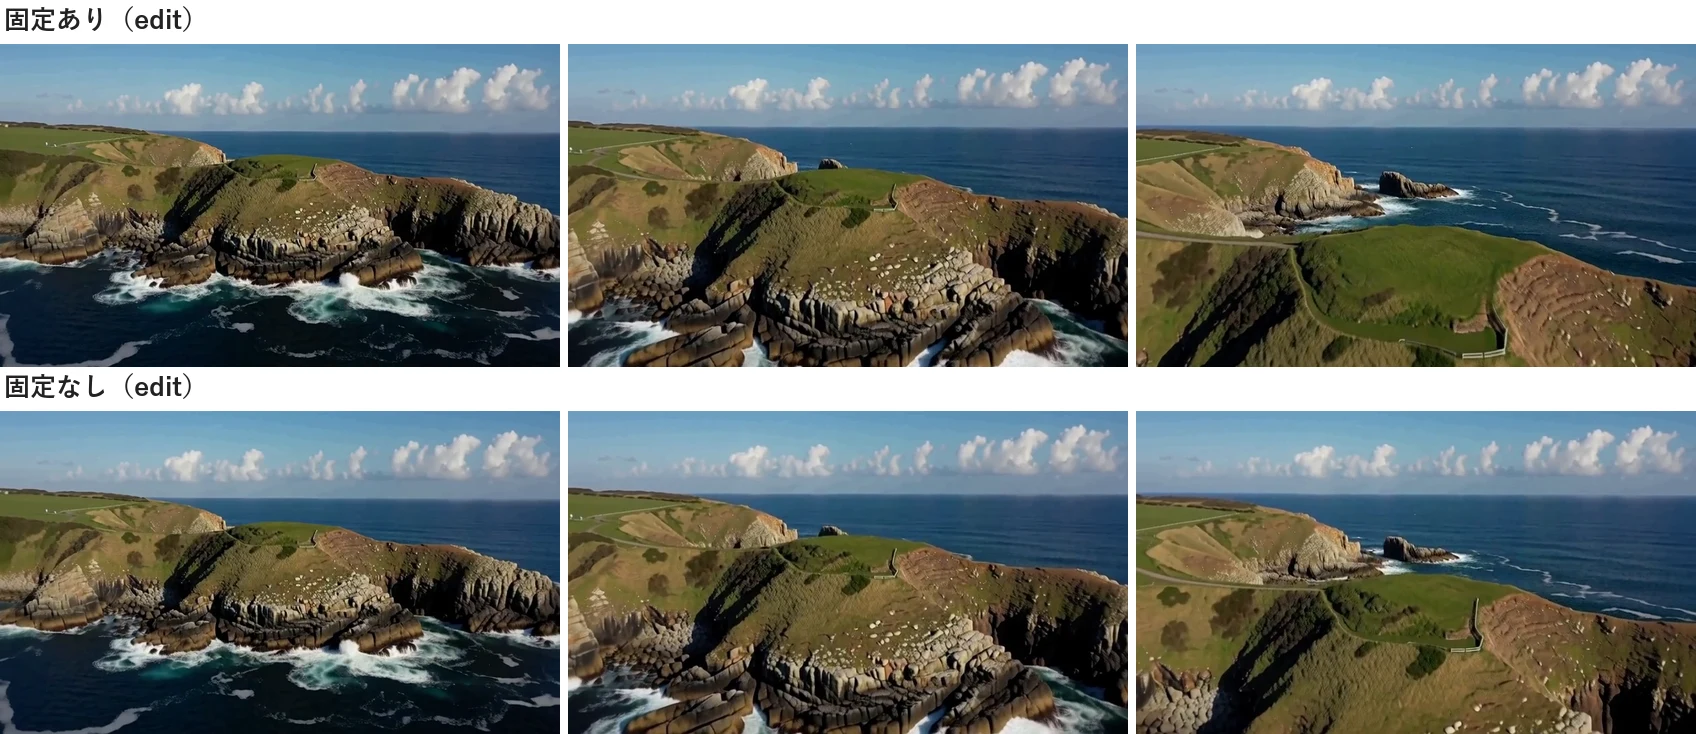
人物の swap は、固定なしでも替わりました。カメラの動きが大事な edit は、固定ありを勧めます。固定なしでは、後半のカメラ位置が元の動画から少しずれました。
時間とメモリの実測
長さと解像度を変えたとき
いずれも int8 です。1280×736 だけは各1本の値です。1280×736・124 フレームは ComfyUI を起動し直した直後の1本目しか測っていないので、モデルの読み込みを含みます。ほかの行は読み込み後の時間です。
| 解像度 | フレーム | 1ステップ | 1本 | VRAM ピーク(全体) |
|---|---|---|---|---|
| 832×480 | 124(約5.2秒) | 8.3秒 | 57秒 | 31.5GB |
| 832×480 | 226(約9.4秒) | 23.1〜24.1秒 | 152〜156秒 | 31.6GB |
| 1280×736 | 124(約5.2秒) | 37.2〜37.6秒 | 約10分(598〜612秒。起動直後の1本目で、読み込み込み) | 25.6GB |
| 1280×736 | 226(約9.4秒) | 113.9秒 | 約12.5分 | 31.3GB |
1280×736・124 フレームの約10分は、サンプラー 407〜416秒、参照と動画の条件づけ 123〜126秒、デコード約58秒などです。サンプラーの最初の1ステップに、モデルの初期化の約203〜208秒が入っています。残りの5ステップは1つ約37秒でした。
VRAM ピークは、1280×736・124 フレームだけ 832×480 より小さく出ています。832×480 の行は、前の生成のモデルが VRAM に残ったまま続けて測った値です(開始時 約24〜28GB)。1280×736・124 フレームは起動し直した直後の1本目で、開始時は約2〜6GB でした。ComfyUI は空きがあるだけ使うので、解像度が大きいほどピークが大きくなるとは限りません。
公式の表と違った点
1280×736、226 フレームの int8 が、32GB の RTX 5090 で最後まで動きました。 公式の表では、80GB でもメモリ不足とされている条件です。公式の検証は CUDA 12.8 の PyTorch で、int8 の最適化された処理が使えない状態でした。公式は CUDA 13 の環境を試しておらず、今回の cu130 では結果が変わった形です。原因の切り分けまではしていません。
| 項目 | 公式値(B200) | 今回の実測(RTX 5090) |
|---|---|---|
| 832×480、226 フレーム、1ステップ | 約14秒 | 23.1〜24.1秒 |
| 1280×736、226 フレーム、1ステップ | 64〜72秒 | 113.9秒 |
| 最初の1本(読み込み込み) | 170〜210秒 | 469〜594秒(USB の HDD) |
| ComfyUI の RAM | 47〜55GB | 48〜52GB(int8)、27〜40GB(Q4_K_M) |
量子化で見た目は変わる?
同じシードの int8 と比べました。PSNR は差の小ささを表す値で、大きいほど近い映像です。
| 比べた相手 | edit | swap |
|---|---|---|
| H3 int8+LoRA(バイパス) | 37.0〜38.9dB | 34.4〜36.7dB |
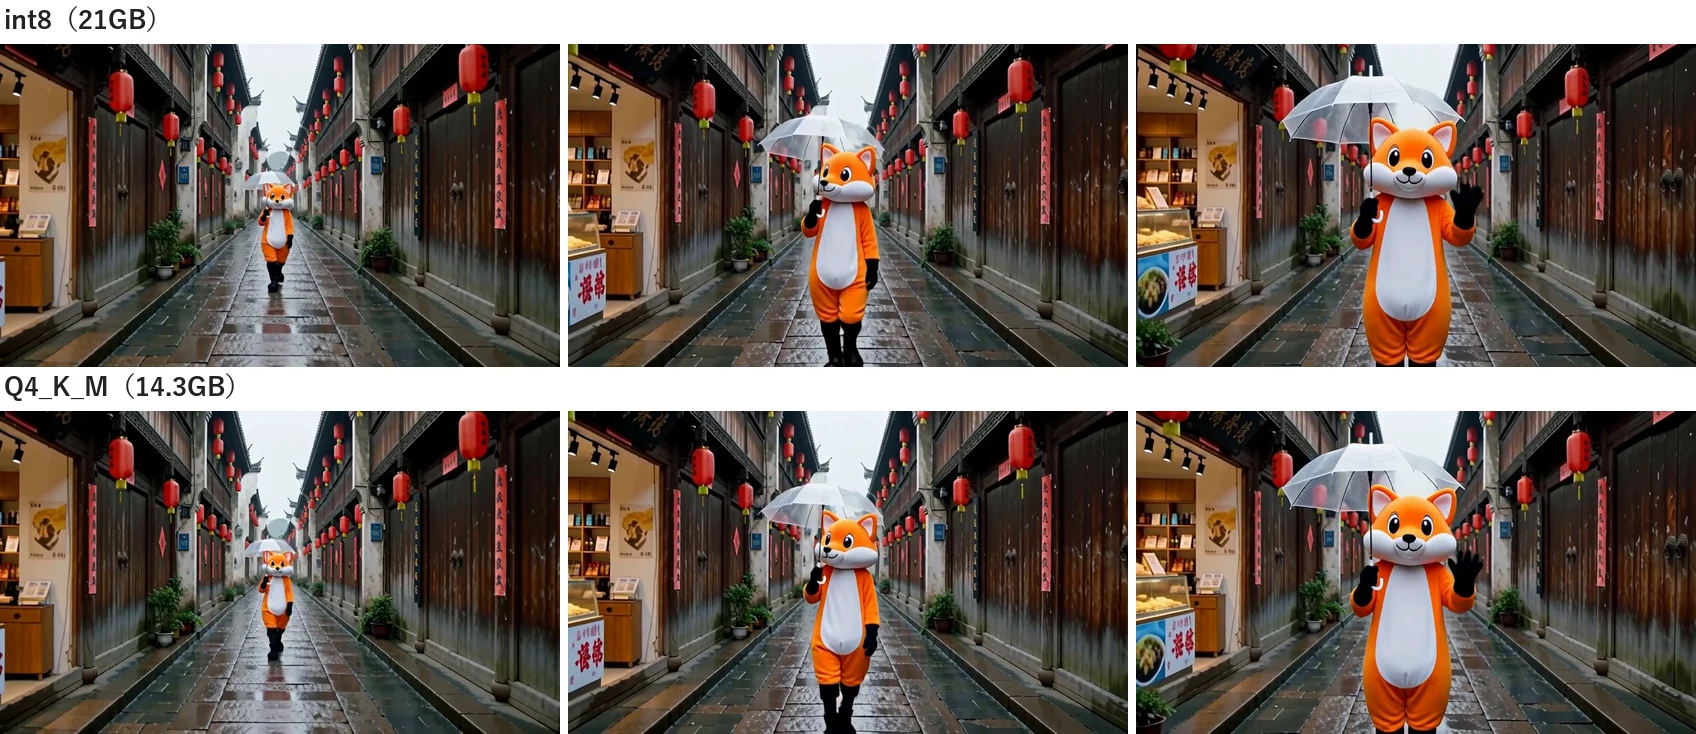
| GGUF Q4_K_M | 31.5〜32.8dB | 25.8〜30.0dB |
バイパスは見分けがつかないほど近く、鮮明さの値もほぼ同じでした。Q4_K_M は細かいところが変わりますが、並べて見ても破綻はありません(シード3つの範囲です)。
手持ちの H3 に LoRA だけ足す方法
Comfy-Org の H3 int8 を持っているなら、LoRA を足すだけで試せます。追加のダウンロードは edit と swap で各 3.8GB です。
読み込みは LoraLoaderBypassModelOnly を使います。公式は、通常の LoRA ローダーでは更新の一部が丸められて消えると説明しています。使う H3 は fl2va のファイルで、ref2va ではありません。この組み合わせは公式の説明にはなく、今回の試行では動いたという位置づけです。
エラーが出たら
3つとも実際に出したエラーです。1つ目は、私が測定スクリプトで指定を間違えて出しました。
| 表示 | 原因 | 直し方 |
|---|---|---|
give one pin per reference image or none: 1 pins, 2 refs | pins と参照画像の数が違う | 数をそろえるか、pins を空にする |
frames must be 17n+5, got 120 | frames が決まりの値でない | 124 や 226 にする |
the source has 226 frames, 243 needed | 元の動画が frames より短い | 元の動画を長くするか、frames を減らす |
RTX 5090 以外の人へ
--reserve-vram を変えて、edit の 226 フレームを各2本作りました。待機中の VRAM は約1.9GB です。
| モデル | --reserve-vram | 結果 | 1本(2本目) | VRAM ピーク(全体) |
|---|---|---|---|---|
| int8 | 16 | 2本とも成功 | 155秒 | 18.3GB |
| int8 | 20 | 2本とも成功 | 155秒 | 14.3GB |
| Q4_K_M | 20 | 2本とも成功 | 204秒 | 14.5GB |
| Q4_K_M | 24 | 2本とも成功 | 206秒 | 10.2GB |
VRAM 容量が少ない環境を想定した簡易テストです。実際の 8GB・12GB・16GB 搭載 GPU での動作を再現・保証するものではありません。 速度が落ちないのは、RTX 5090 の VRAM の帯域と 128GB の RAM があってのことかもしれません。
公式の目安は次のとおりです(公式値、B200 の空きメモリを絞って測定)。
| VRAM | 832×480 |
|---|---|
| 12GB | Q4_K_M か Q8_0 を --reserve-vram 8 で。int8 は 124 フレームのみ |
| 16GB | int8。または Q4_K_M、Q6_K を --reserve-vram 6 で |
| 24GB | int8 か Q4_K_M。Q6_K、Q8_0 は --reserve-vram 6 で |
| 32GB | int8 か Q8_0 |
GGUF を使うには ComfyUI-GGUF を入れて、Unet Loader (GGUF) に置き替えます。今回試したのは公式のテストと同じコミット 6ea2651 です。VRAM が足りないときの全般の対処はこちらの記事にまとめています。
RAM も要ります。ComfyUI だけで int8 が約48〜52GB、Q4_K_M が約27〜40GB でした。
商用利用とライセンス
重みと、結合済みの int8・GGUF は MiniMax H3 の派生物で、MiniMax H3 Community License が適用されます。ノードなどのコードは Apache-2.0 です。2026年11月5日に原文で確かめた主な条件です。
| 項目 | 条件(原文の箇所) |
|---|---|
| 使える地域 | 世界のうち、EU・英国・韓国・米国を除く地域(I.3、I.5)。生成物の表示や配布もこの地域の中に限られる(V.4) |
| 商用利用 | できる。製品やサービスの年間売上が2,000万米ドルを超えるときは、事前に書面の許可が要る(IV.1) |
| 表示 | 商用の製品やサービスの画面に「MiniMax H3」と目立つように表示する(IV.2) |
| 生成物 | MiniMax は権利を主張しない。責任は使う人が負う(VI.4) |
| AI 生成の明示 | 公開の場に出すときは、機械が作ったものだとはっきり示す(Exhibit A 12) |
| なりすまし | 同意や権限なく他人になりすます使い方は禁止(Exhibit A 13) |
| ほかのモデルの学習 | 生成物やモデルを、ほかの AI モデルの改善に使えない(V.3) |
公式の例の映像は第三者の著作物で、どちらのライセンスの対象にも含まれません。この記事に載せた映像は、すべて自分で生成したものです。
よくある質問(FAQ)
Q. Viggle Remake に必要な VRAM はどのくらいですか?
公式の目安は 832×480 で 12GB からです。RTX 5090 では、VRAM を絞った簡易テストで int8 がピーク 14.3GB、Q4_K_M が 10.2GB まで動きました。実際の GPU での動作を保証するものではありません。
Q. 1本にどのくらいかかりますか?
RTX 5090 の int8 で、832×480 の約9.4秒が約155秒、約5.2秒が約57秒でした。最初の1本は読み込みが加わり、USB の HDD では8〜10分ほどでした。
Q. 音声は作られますか?
作られません。元の動画の音声を残す仕組みで、今回も元の音声とのずれは 0 サンプルでした。
Q. 参照画像は有料のツールで作る必要がありますか?
いいえ。今回はローカルの P-H3-Image で作りました。ただし遠くの小さな人物は構図がずれたので、構図の合う1枚だけを使いました。
Q. 実在の人物の動画に使ってもいいですか?
本人の同意なしに使わないでください。ライセンスでも、同意や権限のないなりすましは禁止されています。
Q. ComfyUI v0.44.0 で動きますか?
動きました。公式のテストは 0.42.0 で、v0.44.0 ではノードのエラーは出ていません。
まとめ
- 既存の動画の動きと音声を残したまま、人物や物を差し替えられました。
- 迷ったら公式 int8。832×480 の約9.4秒が RTX 5090 で約155秒です。
- 出来を分けるのは参照画像です。構図の合わないコマは固定しないでください。
他人の映像や顔には、本人の同意なしに使わないでください。
検証メモ
- 本数:832×480 の 226 フレームは、edit、swap とも各モデルでシード3つです。5.2秒と固定なしはシード2つ、1280×736 は各1本です。比べた題材は edit、swap とも1本ずつです。
- 映像の確認:各本から等間隔に8コマを取り、目で見ました。全フレームを見たわけではありません。「15 本」には、シードやモデル、長さの違いと、swap の構図が合わない1本を含みます。
- VRAM:
nvidia-smiの GPU 全体の値です。測定中、ほかのアプリの使用分が約1.9〜9.7GB の範囲で変わりました。ComfyUI は空きがあるだけ使うので、ピークは必要量の下限ではありません。 - 時間:モデルは USB の HDD にあります。最初の1本の時間は、その前に読み込んだモデルやキャッシュで変わります。表の「1本」は、同じ構成の2本目以降でテキストエンコーダーが再度動かなかった回の値です。Q4_K_M の swap には、読み直しが入って 219〜222 秒の回もありました。
- PSNR:フレーム全体の比較で、基準は bf16+LoRA ではなく今回の int8 です。公式の表とは直接比べられません。
- 参照画像:P-H3-Image で作った中から、構図を見て選んでいます。人物を替える編集は 9 枚を確かめました。
- 公式の例:人物の映らない edit の例(風車を消す)を試し、消えることを確かめました。第三者の映像なので記事には載せていません。swap の例は実在の人物が映るので使っていません。
- 未確認のこと:bf16+LoRA、GGUF の Q6_K と Q8_0、低ランクの LoRA、
sample.py、MCP サーバー、音声のない動画、実写の映像、実際の 12〜24GB の GPU。