ComfyUI の画像づくりに必要な標準ノードは、10個で足ります。
どのモデルでも流れはほとんど同じで、モデルを読み込む → 文字を読む → 白紙を用意する → 描く → 画像に戻す → 保存するの6段です。この記事を読むと、画面に並ぶ箱(ノード)の役割がわかり、線のつなぎ方と、つなぎ間違えたときの直し方まで自分で判断できるようになります。
エラーの画面は、筆者が Illustrious XL と Anima でわざと間違えて撮りました。試した環境と条件は末尾の「検証メモ」にまとめています。
画像ができるまでの6段と、使うノード
| 段 | すること | 使うノード(画面の名前) |
|---|---|---|
| 1 | モデルを読み込む | チェックポイントを読み込む / 拡散モデルを読み込む・CLIP を読み込む・VAE を読み込む |
| (+) | LoRA で絵柄やキャラを足す | LoRA ローダーモデルのみ |
| 2 | プロンプト(文字)を読ませる | CLIP テキストエンコード(プロンプト) |
| 3 | 白紙(潜在画像)を用意する | 空の潜在画像 |
| 4 | 描く | K サンプラー |
| 5 | 画像に戻す | VAE デコード |
| 6 | 保存する | 画像を保存 |
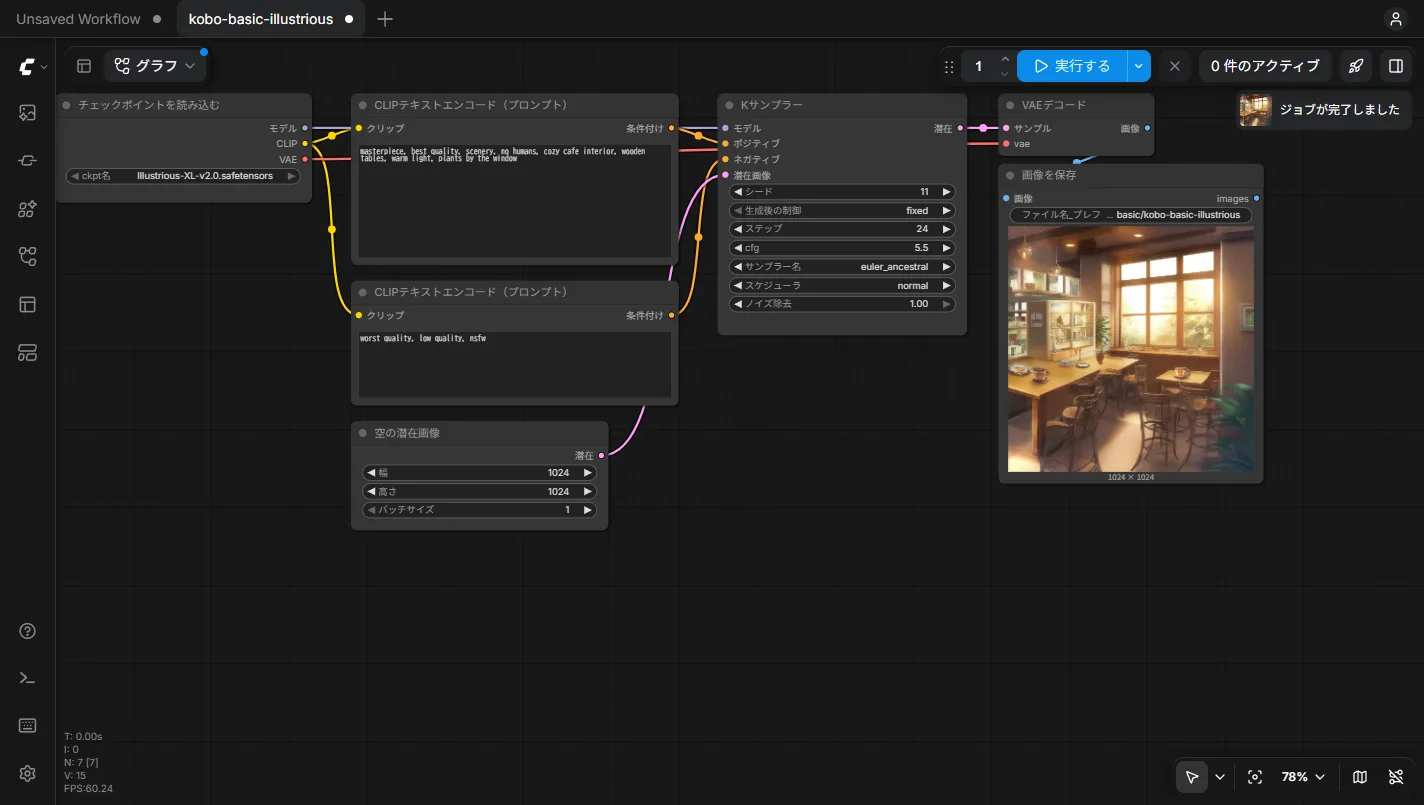
ComfyUI 公式のチュートリアルで最初に開くワークフローも、この形です。Illustrious のような1ファイルのモデルなら、7個のノードで画像ができます。
線は同じ色の口どうしをつなぐ
ノードの左の丸が「入力」、右の丸が「出力」。出力から入力へ線を引いて、データを渡します。
公式のドキュメントによると色はデータの種類ごとに決まっていて、同じ色どうしでないとつながりません。
| 色 | データの種類 | 例 |
|---|---|---|
| 紫(ラベンダー) | MODEL(拡散モデル) | チェックポイントの「モデル」→ K サンプラーの「モデル」 |
| 黄色 | CLIP(文字を読む部品) | チェックポイントの「CLIP」→ CLIP テキストエンコードの「クリップ」 |
| 赤(ローズ) | VAE | チェックポイントの「VAE」→ VAE デコードの「vae」 |
| オレンジ | CONDITIONING(読み取ったプロンプト) | CLIP テキストエンコード → K サンプラーの「ポジティブ」「ネガティブ」 |
| ピンク | LATENT(潜在画像) | 空の潜在画像 → K サンプラー → VAE デコード |
| 青 | IMAGE(ふつうの画像) | VAE デコード → 画像を保存 |
試しに「モデル」の出力を「CLIP テキストエンコード」の「クリップ」へつなごうとしたら、線が刺さりませんでした。色が違う口は、間違えてつなぐこと自体ができない作りです。
最初に覚えたい基本ノード10選
どれも ComfyUI に最初から入っている「標準のノード」です。画面で右クリック →「ノードを追加」から探すか、空いたところをダブルクリックして名前で検索すると出てきます。
チェックポイントを読み込む(Load Checkpoint)
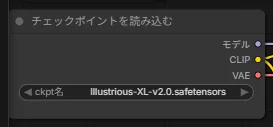
1つのファイルにまとまったモデル(チェックポイント)を読み込みます。中身は MODEL・CLIP・VAE の3つで(公式チュートリアルの説明)、ノードの右から3本の線が出ます。
- 置き場所は
models\checkpoints - Illustrious XL、SDXL、SD1.5 などで使う
- 一覧にモデルが出ないときは、まず置き場所を疑う
拡散モデルを読み込む(Load Diffusion Model)
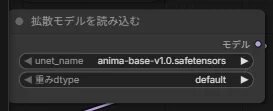
CLIP や VAE が別ファイルのモデルの、本体(拡散モデル)だけを読み込みます。出力は MODEL の1本だけ。
CLIP を読み込む(Load CLIP)
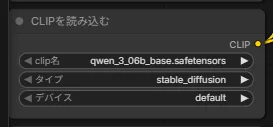
分かれたモデルで、プロンプトを読む部品(テキストエンコーダー)を読み込みます。「タイプ」は、モデルに合わせて選びます(公式の配布ページやテンプレートに書かれています)。
- ファイルの置き場所は
models\text_encoders - Anima は qwen_3_06b_base、Wan は umt5_xxl など、モデルごとに使うファイルが決まっている
VAE を読み込む(Load VAE)
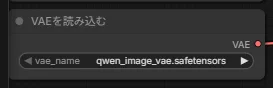
VAE(潜在画像とふつうの画像を変換する部品)を読み込みます。分かれたモデルでは、VAE もモデルに合わせて選びます。
- ファイルの置き場所は
models\vae - モデルに合わない VAE を選ぶとエラーになる(下の「よく出るエラー」で実際に試した)
CLIP テキストエンコード(プロンプト)(CLIP Text Encode)
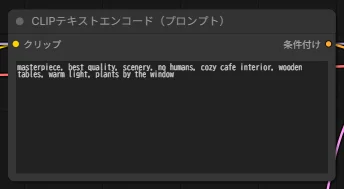
プロンプトの文字を、モデルがわかる形に変えます。描いてほしいもの(ポジティブ)と、描いてほしくないもの(ネガティブ)で、同じノードを2つ使います。
- 入力の「クリップ」に CLIP をつなぐ
- 出力(オレンジ)を K サンプラーの「ポジティブ」と「ネガティブ」に1本ずつつなぐ
空の潜在画像(Empty Latent Image)
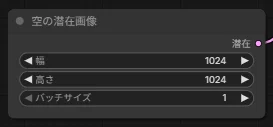
描きはじめの白紙(潜在画像)を用意するノード。画像の大きさ(幅・高さ)と、一度に作る枚数(バッチサイズ)はここで決めます。
- 大きさはモデルに合わせる。Illustrious XL や Anima は 1024×1024 前後がよく使われる(Illustrious の解像度の比較)
- Wan などの動画モデルは、動画用の別の潜在画像ノードを使う
K サンプラー(KSampler)
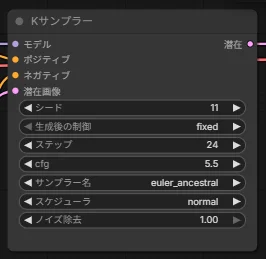
実際に絵を描くノードで、白紙のノイズをプロンプトに合わせて少しずつ消していきます。設定は5つあります(説明は公式のドキュメントを短くまとめたもの)。
- シード:ノイズの元になる数。同じなら同じ絵になる。「生成後の制御」を fixed にすると変わらない
- ステップ:ノイズを消す回数。多いほど細かいが時間がかかる
- cfg:プロンプトにどれだけ従うか。上げすぎると崩れやすい
- サンプラー名・スケジューラ:ノイズの消し方。モデルごとにおすすめがある
- ノイズ除去:1.00 なら白紙から描く。画像を元に描き直すときは下げる
VAE デコード(VAE Decode)
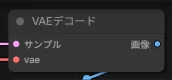
K サンプラーが描いた潜在画像を、ふつうの画像に戻します。VAE の入力には、モデルに合った VAE をつなぎます。
- 線の色がピンク(潜在画像)から青(画像)に変わるところ
画像を保存(Save Image)
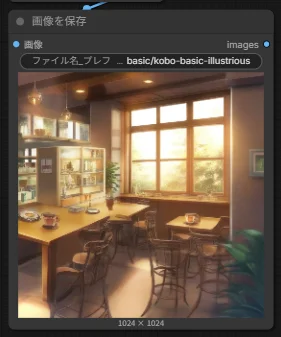
できた画像を表示して、ComfyUI の output フォルダに保存します。保存しなくていいときは「画像プレビュー」に差し替えてください。
- 「ファイル名プレフィックス」で、保存するファイル名の頭を決められる
- 保存した PNG には、作ったときのワークフローが入っている。ComfyUI の画面にドラッグすると、同じワークフローが開く
LoRA ローダーモデルのみ(LoraLoaderModelOnly)
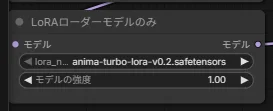
LoRA(絵柄やキャラを足す追加ファイル)をモデルにかけるノードです。モデルの線の途中にはさむだけで使えます。CLIP にもかける「LoRA を読み込む」は公式のチュートリアルで紹介されています。
- ファイルの置き場所は
models\loras - くわしい使い方と強さの決め方は ComfyUI で LoRA を使う方法
モデルが変わっても、変わるのは左側だけ
下は Anima の最小ワークフローです。Illustrious と比べると、左側の「読み込む」ノードが4つに増えました。本体・CLIP・VAE が別々のファイルで配られているからです(公式の Turbo LoRA もはさんでいます)。
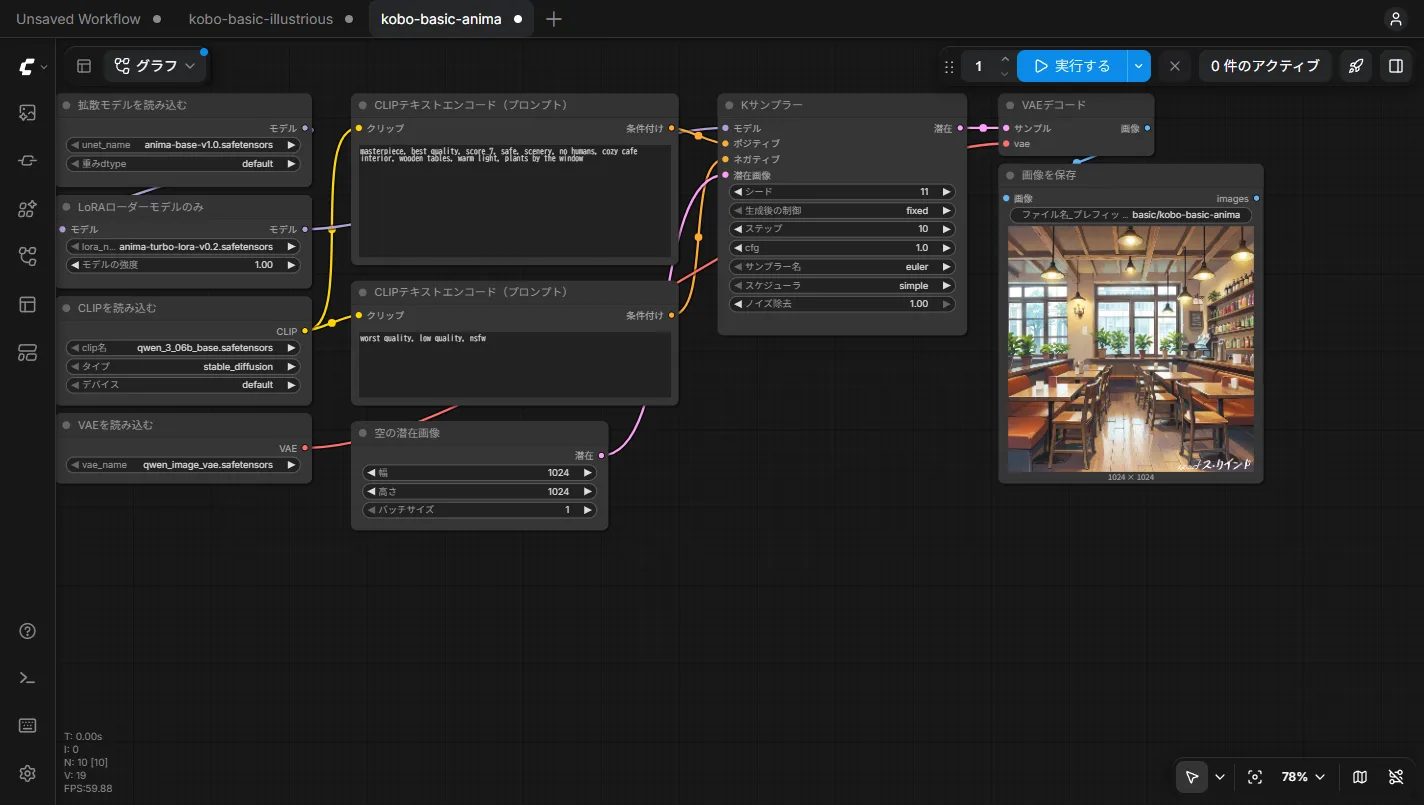
| Illustrious XL(1ファイル) | Anima(分かれたファイル) | |
|---|---|---|
| モデルを読むノード | チェックポイントを読み込む(1つ) | 拡散モデル・CLIP・VAE を読み込む(3つ) |
| K サンプラーの設定(この記事の例) | 24ステップ・CFG 5.5・euler_ancestral・normal(動作を確かめるための設定。おすすめの設定は Illustrious XL の使い方) | 10ステップ・CFG 1・euler・simple(Turbo LoRA 使用) |
| あとは同じ | 空の潜在画像・CLIP テキストエンコード・VAE デコード・画像を保存 | 同じ |
新しいモデルを使うときに変わるのは、ほとんどが「読み込む」部分と K サンプラーの設定です。真ん中から右の流れは同じなので、一度覚えればほかのモデルにも使えます。
動画の Wan でも、潜在画像や保存のノードが動画用になり、「モデルサンプリング」などが少し増えるだけで、流れは変わりませんでした。
- Illustrious XL の最小ワークフロー(kobo-basic-illustrious.json)ComfyUI の画面にドラッグすると開きます
- Anima の最小ワークフロー(kobo-basic-anima.json)Anima-Base と公式の Turbo LoRA を使います
筆者がわざと起こした3つのエラー
つなぎ間違いで止まったとき、どの表示が出るのかを先に知っておくと慌てません。ComfyUI 0.43.0 で出た表示をそのまま載せます。
「必須入力がありません」:線のつなぎ忘れ
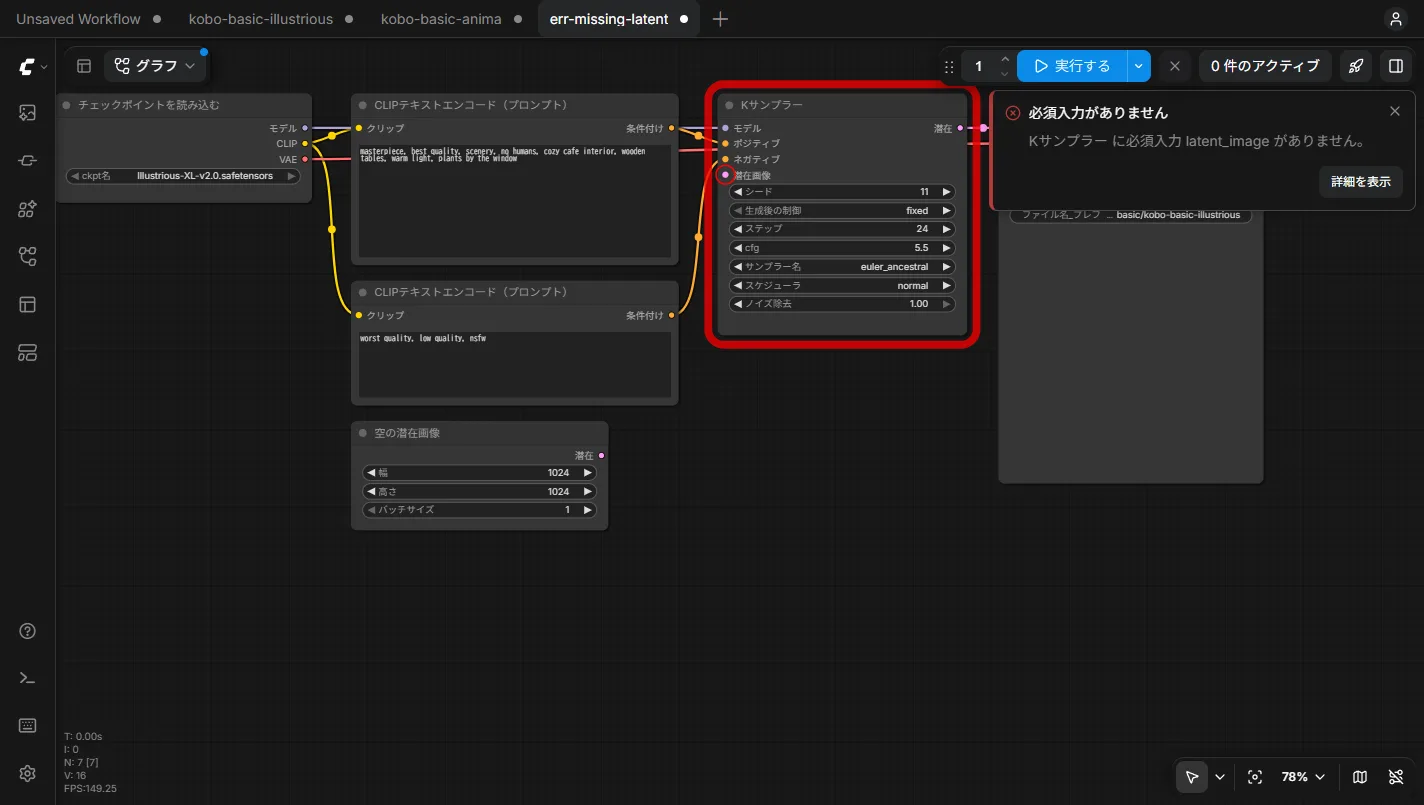
K サンプラーの「潜在画像」の線を外して実行すると、「K サンプラー に必須入力 latent_image がありません」と出て、つなぎ忘れたノードが赤い枠で示されました。
赤い枠のノードを見て、色の合う線をつなげば直ります。
「〇〇が不足しています」:モデルのファイルが見つからない
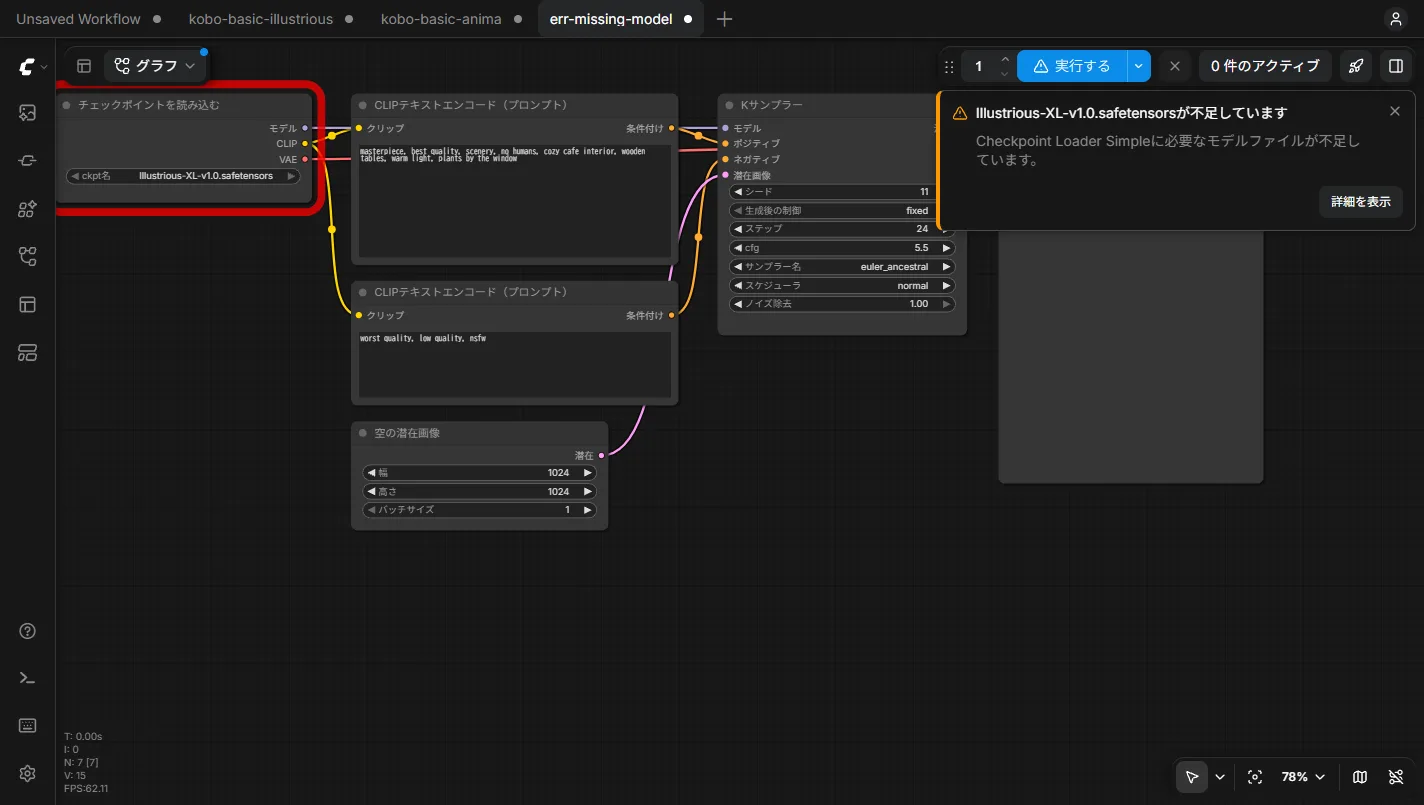
人からもらったワークフローに自分の PC にないモデルの名前が入っていると、「Illustrious-XL-v1.0.safetensors が不足しています」のように出ました。モデルを正しいフォルダに置くか、ノードのファイル名を手元のものに選び直してください。
「VAE デコード の実行に失敗しました」:モデルと VAE が合っていない
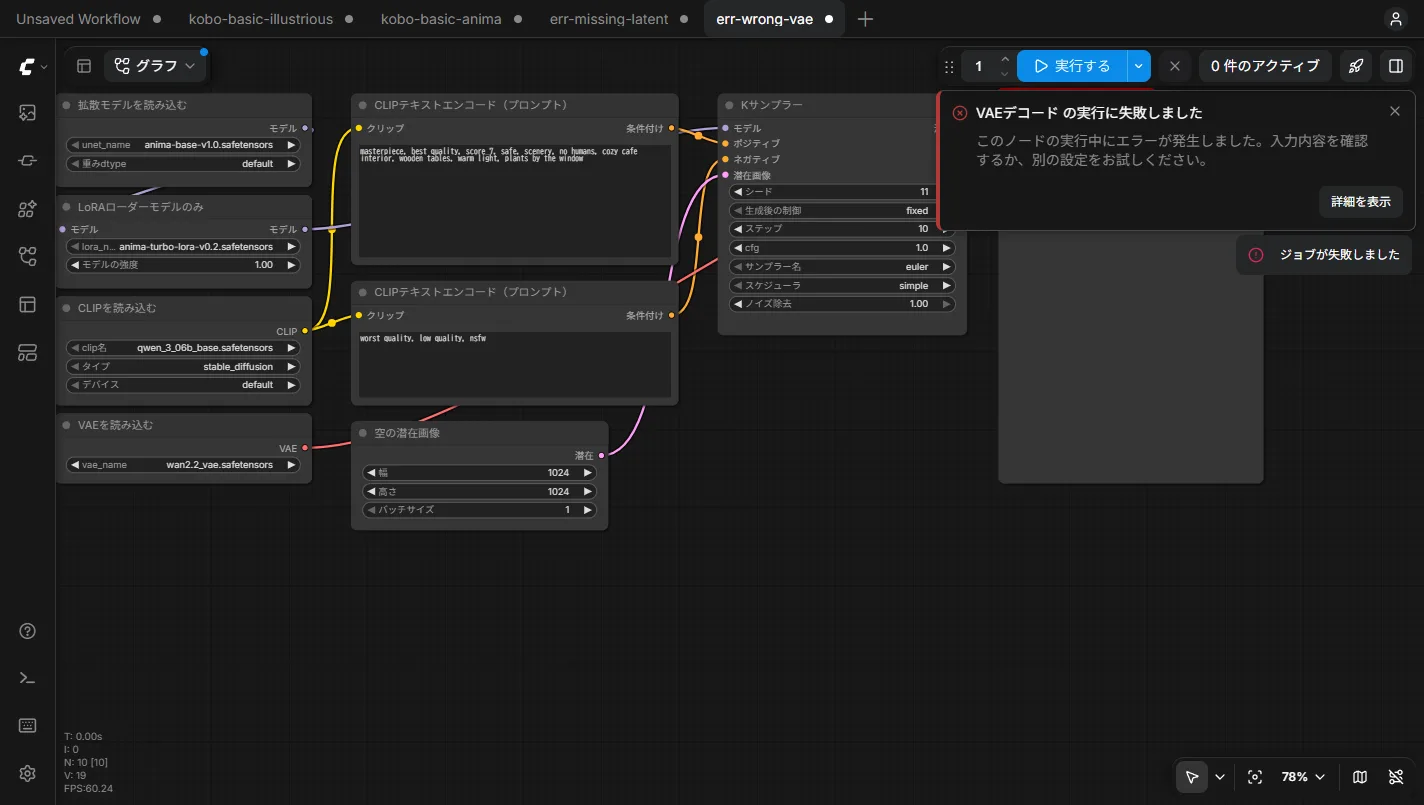
Anima の VAE を、わざと Wan 2.2 用に変えて実行しました。絵を描くところまでは進むのに、最後の VAE デコードで止まります。
「詳細を表示」には「48 チャンネルのはずが 16 チャンネルだった」という意味の英語。途中まで動くぶん、原因が VAE だと気づきにくいエラーでした。VAE はモデルに合ったもの(Anima なら qwen_image_vae)に戻します。
ほかのエラーの探し方は、ComfyUI で Anima が動かないときの原因と直し方にまとめています。
慣れてきたら、次に試すこと
- 画像を元に描き直す:「画像を読み込む」と「VAE エンコード」で画像を潜在画像に変え、K サンプラーの「ノイズ除去」を下げる
- 保存せずに確かめる:「画像を保存」の代わりに「画像プレビュー」を使う
- カスタムノード:標準のノードにない機能は、ほかの人が作ったノードを足して使える。入れ方は カスタムノードの入れ方、よく使われる KJNodes の全260ノードは KJNodes 完全ガイド から探せる
よくある質問(FAQ)
Q. ComfyUI でまず覚えるノードはどれですか?
チェックポイントを読み込む、CLIP テキストエンコード、空の潜在画像、K サンプラー、VAE デコード、画像を保存の6つです。この6つで、Illustrious XL のような1ファイルのモデルの画像が作れます。
Q. 「チェックポイントを読み込む」と「拡散モデルを読み込む」のちがいは?
チェックポイントは MODEL・CLIP・VAE が1つのファイルにまとまったもので、1つのノードで3つとも読み込めます。拡散モデルは本体だけのファイルで、CLIP と VAE は別のノードで読み込みます。Anima や Wan は拡散モデルの形です。
Q. ノードがつながりません
線の色が違う口どうしはつながりません。紫はモデル、黄色は CLIP、赤は VAE、ピンクは潜在画像、青は画像です。同じ色の口を探してつないでください。
Q. 「必須入力がありません」と出ます
ノードの入力に線がつながっていません。赤い枠で示されたノードを見て、空いている入力に同じ色の線をつないでください。
Q. VAE デコードでエラーになります
モデルに合わない VAE を選んでいないか確かめてください。筆者の試験では、Anima に Wan 2.2 の VAE を選ぶと VAE デコードで止まりました。VAE はモデルの配布ページやテンプレートにあるものを選びます。
まとめ
- 画像づくりは「モデルを読む → 文字を読む → 白紙を用意 → 描く → 画像に戻す → 保存」の6段。基本のノードは10個
- 線は同じ色の口どうしをつなぐ。モデルの形で変わるのは読み込む部分だけ
- エラーは、つなぎ忘れ・モデルのファイルがない・モデルと VAE の組み合わせ違いが多い
検証メモ
- 試した環境:2026年10月28日。Windows 11 / GeForce RTX 5090(VRAM 32GB)/ ComfyUI 0.43.0 ポータブル版(試験用、カスタムノードは止めて試した)。モデルは公式の Illustrious XL v2.0 と Anima-Base v1.0(+公式の Turbo LoRA)。画面の日本語は ComfyUI 0.43.0 の表示のままです。
- エラーの範囲:載せたのはこの版で実際に出た表示です。表示の文言は版で変わる可能性があります。
- K サンプラーの設定:表の設定は動作を確かめるための例です。おすすめの設定はモデルごとの記事を見てください。