この記事について(広告・アフィリエイトリンクはありません)
紹介しているソフトとモデルは、すべて無料で入手できるものです。
RefMod は、MiniMax H3 の参照を VAE で潜在に変換し、.safetensors に保存したものです。MiniMax-H3-Prompt-Rewriter-ComfyUI には、これを読むノードがあります。参照(R2V)の基本はMiniMax H3 の使い方とコツで説明しています。
人物や声を「ファイル1つ」で持ち運べるのが利点で、今回の画像1枚では生成は速くなりませんでした。自分の絵から RefMod を作り、生成への効果と時間を測った結果です。
H3 の基本は導入記事を見てください。
速さより持ち運びのためのもの(今回のテスト条件で)
| 条件(960×544、5秒、20 ステップ) | 本数 | 全体(中央値) | 参照のトークン |
|---|---|---|---|
| 参照なし | 5 | 81.1秒 | 0 |
| 普通の画像を参照 | 5 | 89.7秒 | 529 |
| RefMod(strength 1.0) | 4 | 90.2秒 | 576 |
| RefMod(strength 0.5) | 5 | 90.8秒 | 576 |
| RefMod(strength 0.2) | 5 | 90.7秒 | 576 |
- 参照を入れると、1本あたり約9秒増えました。
- 今回の画像1枚では、RefMod にしても普通の画像より速くなりません。変換はどちらも一瞬だからです。利点は時間より、持ち運びやすさです。
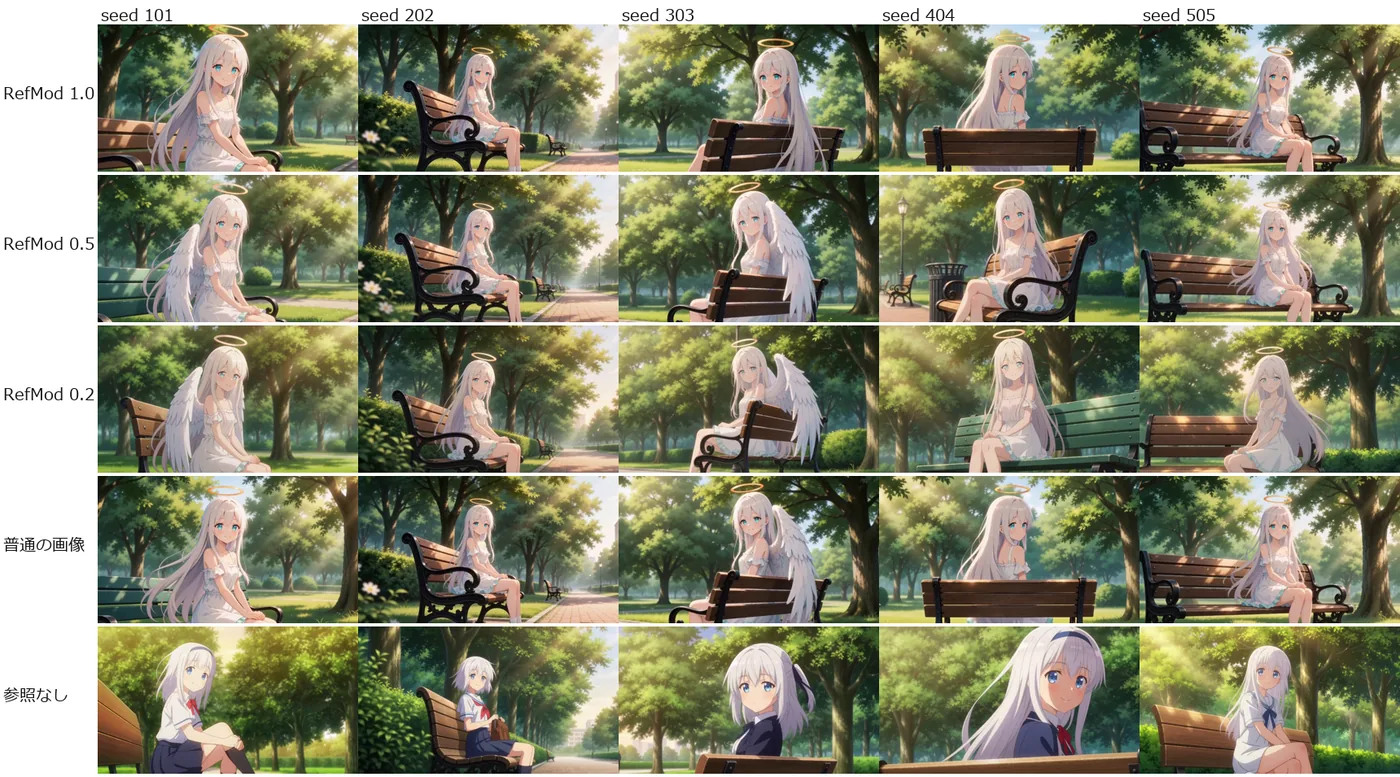
- 見た目は、普通の画像の参照とよく似ていました。参照なしとは服も髪飾りも別物です。
strength を 0.2 まで下げても、白い服と輪はほとんど残りました。最初の1本は、読み込みを含めて約5分(298.6秒)かかります。
試した環境
| 項目 | 内容 |
|---|---|
| GPU | RTX 5090(32GB)、ドライバー 621.01 |
| CPU / RAM | Ryzen 9 9950X3D / 128GB |
| OS | Windows 11 |
| ComfyUI | ポータブル版+master 17ff1dcc(v0.43.0-26) |
| ノード | Prompt Rewriter v0.32.2 cedd084。入れたカスタムノードはこれだけ |
| モデル | H3 ref2va pruned int8、qwen3vl nvfp4、映像 VAE int8、音声 VAE fp32 |
| サンプラー | res_multistep、simple、20 ステップ(公式の作例と同じ) |
| シード | 101、202、303、404、505 |
| 参照 | Anima で作った自分の天使の子の画像を 768×768 にしたもの |
ノードとモデル、自分の RefMod を置く
ノードは custom_nodes に入れます。カスタムノードの入れ方はこちらにまとめています。H3 向けのほかのノードはH3 専用カスタムノード8選にあります。
cd ComfyUI/custom_nodes
git clone https://github.com/pytraveler/MiniMax-H3-Prompt-Rewriter-ComfyUI| ファイル | 置き場所 |
|---|---|
| minimax_h3_ref2va_pruned_int8_convrot.safetensors | models\diffusion_models |
| qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors | models\text_encoders |
| minimax_h3_video_vae_int8_convrot.safetensors | models\vae |
| minimax_h3_audio_vae_fp32.safetensors | models\vae |
| 自分の RefMod | models\refmods |
下の JSON を読み込みます。プロンプトの <Picture 1> が参照の画像を指します。
- minimax_h3_refmod_workflow.jsonComfyUI にドラッグして読み込みます(960×544、5 秒、20 ステップ)。RefMod は自分で用意して models/refmods に置き、「refmod」で選び直してください。Writer は bypass で止めています
画面から実行して、成功を確かめました(96.8秒)。最初の1本の 298.6秒とは別の実行で、この時間の中身は記録していません。
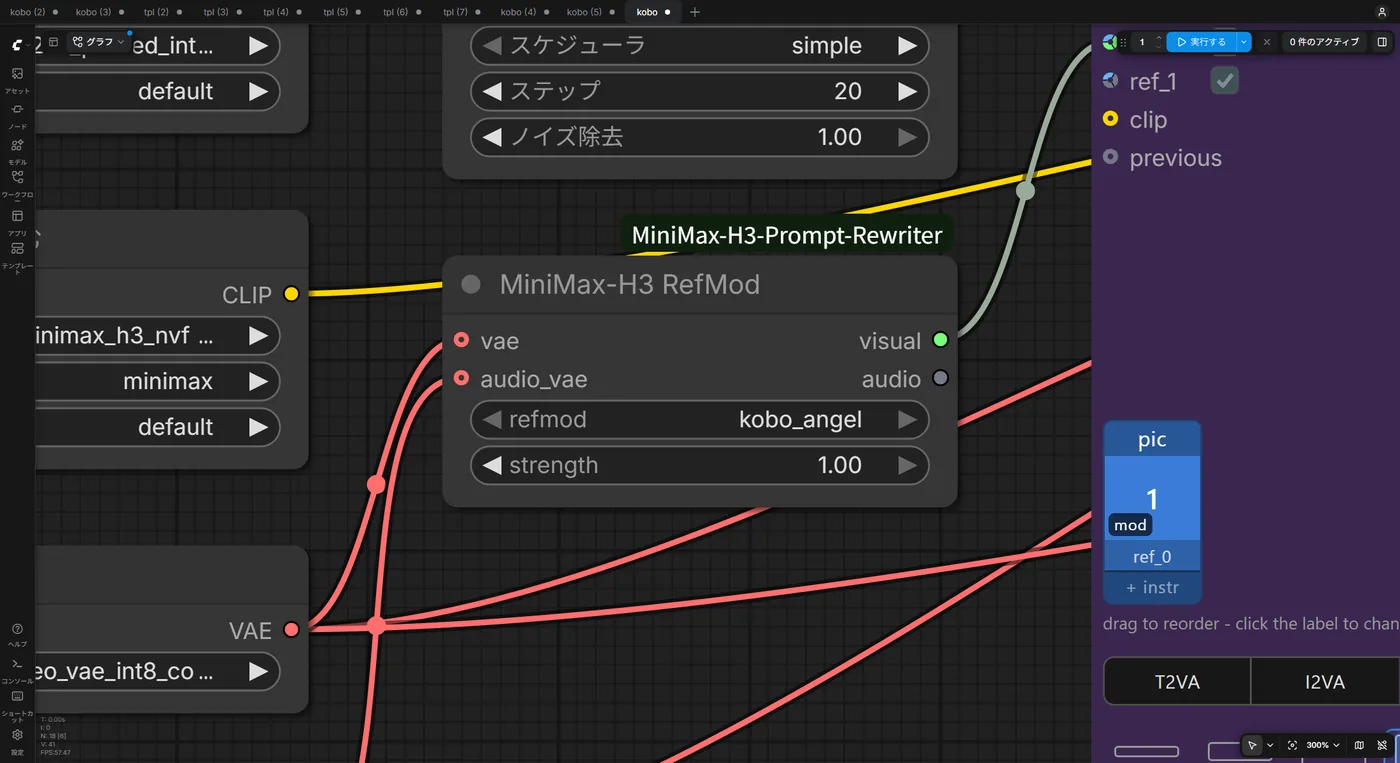
つなぎ方はこの順です。公式の作例「8 – RefMods to video」も同じです。
- MiniMax-H3 RefMod で、ファイルと strength を選ぶ
visualを Universal Writer のref_0へ- Writer の
referencesを Reference Encode へ - Reference Encode の出力をサンプラーへ
RefMod は自分で作れる
公式の説明では、作成は別のパック(ComfyUI-MiniMaxH3Mod、ComfyUI-Fantastic-MiniMaxH3-PromptBuilder)の担当です。今回はそれらを入れず、ノードのソースの形式に合わせて自分で作りました。
- 画像を H3 の映像 VAE で「VAE Encode」し、「Save Latent」で保存します。
- ComfyUI の Python で、次を実行します(ファイル名は自分のものに変えます)。
from safetensors.torch import load_file, save_file
import json
t = load_file("output/refmod_src/angel_00001_.latent")
meta = {"kind": "image", "subject_name": "angel"}
save_file({"latent": t["latent_tensor"].float()},
          "models/refmods/my_angel.safetensors",
          metadata={"refmod_meta": json.dumps(meta)})
最後に、ComfyUI で R キーを押すと、一覧に出ます。
768×768 の画像で、ファイルは約222KB、トークンは576でした。動画や声の形は、今回は作っていません。
strength は「弱める」より「ぼかす」
公式の説明では、strength を下げると、潜在を強くぼかしたものと混ぜます。色や全体の形が残り、細部が抜けるそうです。かかる時間は変わらないとも書かれていて、今回も同じでした。
上の画像を見ると、0.5 と 0.2 でも白い服と輪はおおむね残りました。今回のシードでは、むしろ翼が目立つ画像もあります。顔つきや服の細部は、1.0 のほうが参照に近く見えます。
「参照を半分だけ効かせる」というより、色や形だけを借りる設定です(今回の見え方から)。
普通の画像とどう違う?
普通の画像を参照にしても、シードごとの構図まで RefMod の 1.0 とよく似ていました。どちらも元は同じ絵なので、当然の結果です。
| 比べるところ | 普通の画像 | RefMod |
|---|---|---|
| 元の絵が必要か | 必要 | 不要(ファイルだけ) |
| 参照の変換 | 毎回、または前回の結果を再利用 | 保存した潜在を使う |
| 変換を含む処理(今回) | 約1.3秒 | 約1.1〜1.35秒 |
| 解像度 | 出力に合わせて変更 | 保存した大きさのまま |
動画や何枚もの写真の参照では、変換を省く意味が大きくなる可能性があります。今回は画像1枚しか試していません。
参照が大きいと、毎ステップの負担も増えます。公式の説明の例では、10枚の写真の RefMod が 18,240 トークン。読み込むと、ノードの表示でトークンの数を確かめられます。
Writer に書かせると、依頼していない要素が増えた
Universal Writer は、参照の画像を見て、H3 向けのプロンプトを書くノードです。短い文から試しました。
| 項目 | 結果 |
|---|---|
| 入力 | 「ベンチに座り、カメラの方を向いて笑う」という英文 |
| モデル | Qwen2.5-Omni-3B(説明)、Qwen3.5-4B(執筆) |
| 初回 | 166.7秒(モデルの取得約6GB を含む) |
| 2回目以降 | 約8.3秒 |
| VRAM ピーク | 約7.1GB(開始時から約5.2GB 増加) |
輪や翼を説明に入れ、カットや音の説明まで作りました。一方で、依頼していない要素も増えます。今回はピアノの音楽が加わり、動画は後ろ姿の全身から始まりました。手書きとの比較は1本ずつです。
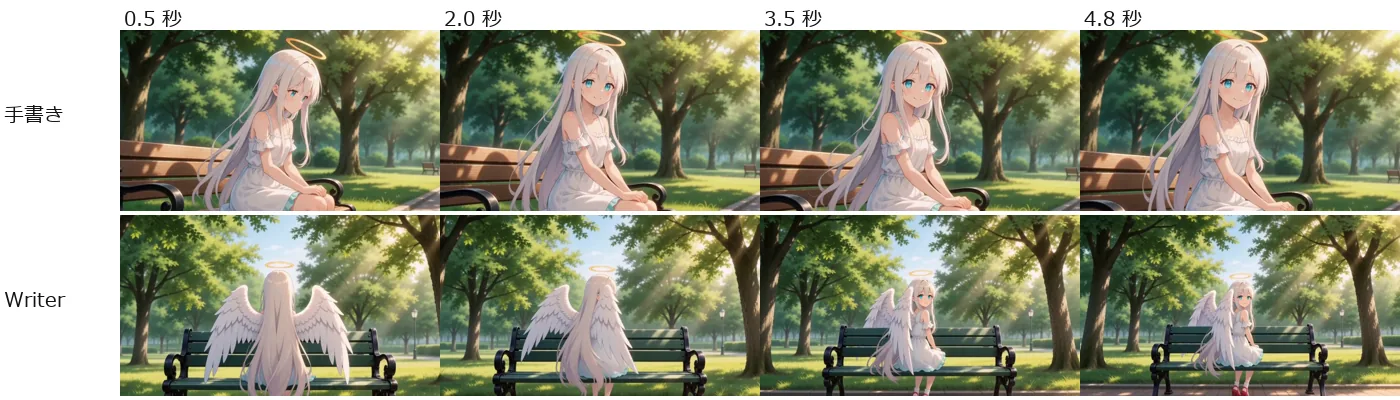
モデルは初回に自動で models\LLM に入り、実行用の llama.cpp もノードの作業フォルダーに用意されたようです。ネットワークの制限がある環境では注意してください。
JSON の Writer は bypass をオンにしています。手書きのプロンプトをそのまま使う設定です。Writer を使うときはオフにします。
RTX 5090 以外の人へ
--reserve-vram は、OS などのために VRAM を残しておく設定です。RefMod 1.0 で各2本試しました。
--reserve-vram | 結果 | 全体(2本目) | VRAM ピーク(開始時からの増加) |
|---|---|---|---|
| 指定なし | 成功 | 約90秒 | 30.9GB |
| 20(計算上の残り 約12.1GB) | 成功 | 89.4秒 | 14.1GB(約12.5GB) |
| 24(計算上の残り 約8.0GB) | 成功 | 89.3秒 | 10.0GB(約8.4GB) |
開始時からの増加(約12.5GB、約8.4GB)は、総 VRAM の 32,580MB から指定分を引いた残りより少し多くなりました。実際の 12GB・8GB の GPU では足りない可能性があります。今回はどの指定でも失敗していません。どこまで減らすと失敗するかは測っていません(未確認)。
VRAM 容量が少ない環境を想定した簡易テストです。実際の 8GB・12GB 搭載 GPU での動作を再現・保証するものではありません。 RAM は ComfyUI だけで約44GiB 使いました。RAM が少ない PC では、こちらが先に壁になります。 VRAM 不足の対処はこちらにまとめています。
ライセンスと権利は?
- ノード:MIT です。
- RefMod の形式:ComfyUI-MiniMaxH3Mod(MIT)のものと README に書かれています。
- MiniMax H3:MiniMax H3 Community License です。EU・英国・韓国・米国は対象外、年商2,000万ドル超は別途の許諾が必要です。
共有の RefMod は、元の人物、キャラクター、声の権利が別です。誰の何から作られたかが分からないものは、使わないほうが安全です。形式が .safetensors でも、権利の問題は解決しません。
法的な助言ではありません。
よくある質問(FAQ)
Q. RefMod を使うと生成は速くなりますか?
今回の画像1枚では速くなりませんでした。参照なしより約9秒増え、普通の画像の参照とほぼ同じです。
Q. strength を下げると速くなりますか?
なりません。今回は 1.0、0.5、0.2 のどれも約90秒でした。
Q. 自作できますか?
できます。今回は上のスクリプトで作りました。形式は版によって変わる可能性があるので、エラーになったら作成用のパックを試してください。
Q. 音声の RefMod も試しましたか?
試していません。今回は audio_vae はつないでいますが、音声の参照はありません。
Q. Writer は必須ですか?
必須ではありません。参照の番号を付ける役割で Universal Writer を通しますが、bypass なら文章は書かず、追加のモデルも読み込みませんでした。
まとめ
- RefMod は、参照をファイル1つで持ち運ぶためのものです。
- 今回の画像1枚では、普通の画像の参照と見た目も時間もほぼ同じでした。
- 共有のファイルを使うときは、権利を確かめてください。
検証メモ
- 本数:各条件5シードです。RefMod 1.0 の最初の1本は読み込みを含むので、中央値から除きました。同じ条件の再実行1本(90.1秒)も除いています。
- プロンプト:参照ありは
The character from <Picture 1> sits on a park bench...、参照なしはA white-haired anime girl sits on a park bench...です。比較のため、参照なしだけ人物の説明を変えました。参照なしとの約9秒の差には、参照の有無のほか、このプロンプトの差も混ざっています。分けて測り直してはいません。 - 画像の見比べ:2.5秒の位置の1フレームを、私が目で見ました。全編の目視や数値の類似度は測っていません。
- 普通の画像のトークン:同じ絵でも、出力に合わせた大きさになるので 529 でした。
--reserve-vram:1本目は 96.3秒と 96.7秒です。- 全体の内訳:RefMod 1.0 の2本目(89.8秒)は、サンプリング 85.6秒、映像デコード 2.6秒、保存 1.4秒などです。最初の298.6秒は、サンプリング 273.9秒(モデルの読み込みを含む)、テキストのエンコード 15.8秒、映像デコード 2.9秒、モデルのノード 2.3秒、保存 1.5秒で、残りの約2秒は内訳未確認です。
- 音声:出力に入っていますが、聞き比べはしていません。
- 未確認のこと:動画と声の RefMod、作成用のパック、共有の RefMod、実際の 8GB・12GB GPU、Turbo LoRA との組み合わせ。