この記事について(広告・アフィリエイトリンクはありません)
使ったソフトとモデルは、すべて無料で入手できます。試した環境の一覧は検証の記録にあります。
エラーは出ないのに毎回遅いときは、まず ComfyUI のログで「Requested to load」が何回出ているかを見てください。 プロンプトを変えただけで毎回出ているなら、モデルを読み込み直しています。1回目だけなら正常です。
所要時間は5分ほど、難しさは初心者向けです。
先に結論(今回のテスト条件で)
| 2回目以降に変えたもの | Requested to load | 1枚の時間(Krea2 Turbo) |
|---|---|---|
| 1回目(参考) | 3つとも出る | 10.3秒 |
| プロンプトだけ | 出ない | 5.4秒 |
| weight_dtype(モデルの読み込み方) | 拡散モデルだけ出る | 6.4〜8.0秒 |
起動オプション --cache-none を付けた(Anima) | 毎回3つとも出る | 8.1秒(付けないと 6.5秒) |
RTX 5090(32GB)・メインメモリ 128GB では、プロンプトを変えるたびに読み込み直す現象は、Anima でも Krea2 Turbo でも起きませんでした。報告は 12〜16GB の GPU や、メインメモリが 32〜64GB の PC からが中心です。
「Requested to load」とは?
ComfyUI がモデルを GPU で使えるように用意するときに、ログに出る1行です。後ろにモデルの種類が付きます。Krea2 なら、テキストエンコーダー(Krea2TEModel_)、拡散モデル(Krea2)、VAE(WanVAE)の3つです。
ログは、ComfyUI を起動した黒い画面か、画面の左下にある「>_」のボタンで開くパネルで見られます。
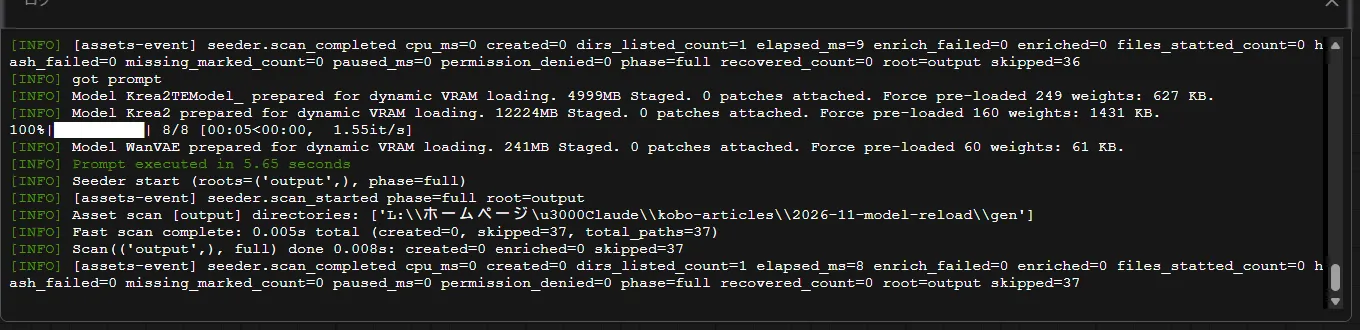
上は2回目の実行のログです。「prepared for dynamic VRAM loading」は毎回出ますが、これは読み込み直しではありません。今回の試験では、この行が出ていても時間は短いままでした。数えるのは「Requested to load」のほうです。
RTX 5090 で試すとどうなる?
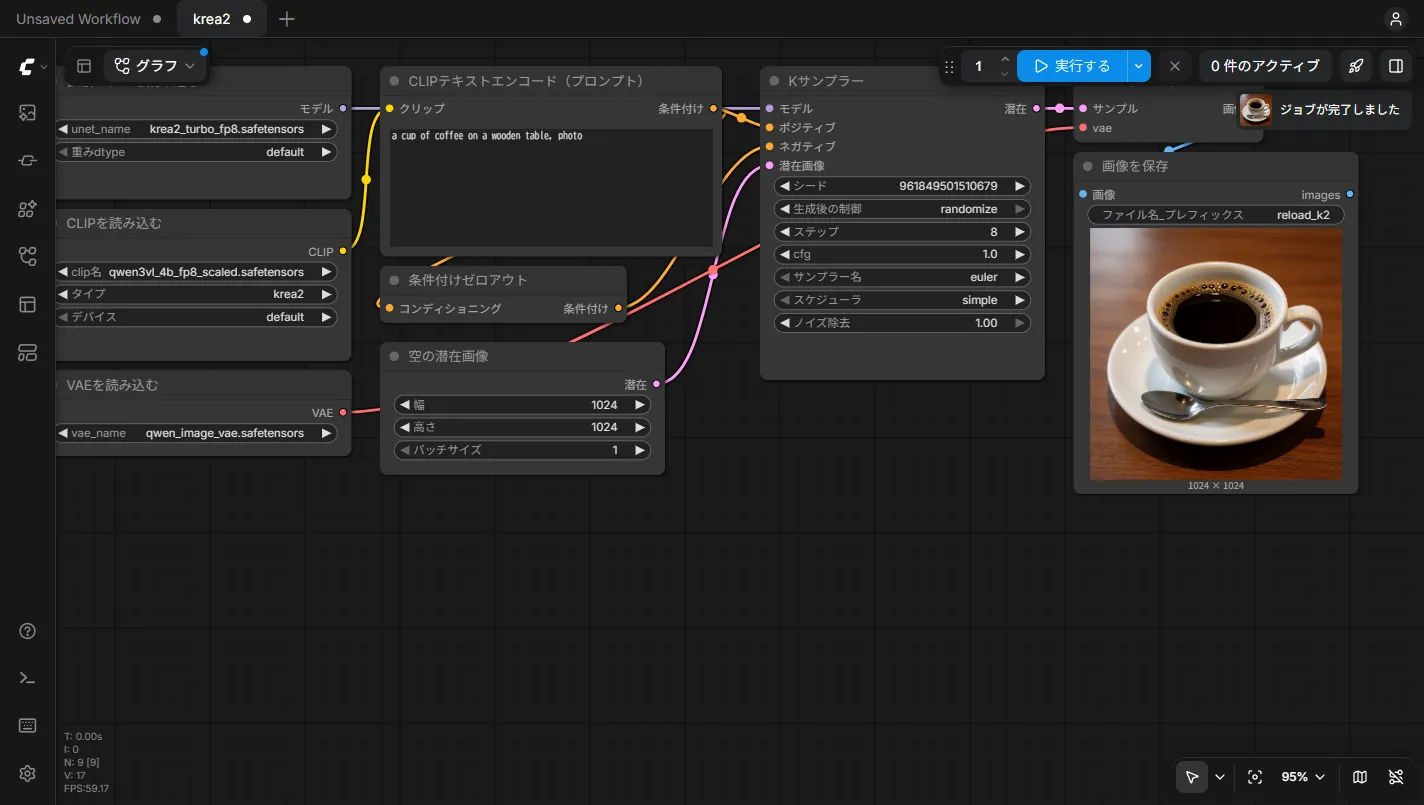
同じモデルでプロンプトだけを変えて3回、続けて weight_dtype を変えて1回、元に戻して1回、の計5回を、起動オプションを変えて試しました。
| 起動オプション | 1回目 | プロンプト2 | プロンプト3 | dtype を変える | 元に戻す |
|---|---|---|---|---|---|
| なし | 10.29秒 | 5.35秒 | 5.39秒 | 6.42秒 | 7.96秒 |
--reserve-vram 20 | 10.23秒 | 5.61秒 | 5.64秒 | 6.47秒 | 7.98秒 |
--disable-dynamic-vram | 14.97秒 | 5.28秒 | 5.29秒 | 8.31秒 | 10.51秒 |
Krea2 Turbo(fp8)、1024×1024、8ステップ。「Requested to load」は、どの条件でも1回目に3つ、dtype を変えた回と戻した回に拡散モデルの1つだけ出ました。プロンプトだけを変えた回は0です。
Anima(約4GB)でも同じ傾向でした。1回目 10.5秒、プロンプトだけ変えた回 6.5秒で、読み込み直しは dtype を変えたときだけです。
–cache-none は読み込み直しを増やす
「キャッシュ」の起動オプションで直そうとする人がいますが、--cache-* はノードの実行結果のキャッシュで、モデルを載せたままにする設定ではありません。ComfyUI のヘルプでも、--cache-none は「毎回すべてのノードを実行する代わりに、RAM と VRAM の使用を減らす」と説明されています。
実際に --cache-none を付けると、プロンプトを変えなくても毎回3つのモデルで「Requested to load」が出て、1枚 6.5秒が 8.1秒になりました(Anima)。遅さに悩んでいるなら、外したほうが速くなります。
ノードの実行結果のキャッシュの動きはこちらの記事で確かめています。
どんな報告がある?
公式 GitHub のIssue #14618(2026年6月)では、Krea2 でプロンプトを変えるたびにディスクから読み込み直す、と報告されています。コメントは120件を超えていて、修正の PR #15027 が7月に入ったあとも、0.29〜0.30 で続いているという声と、直ったという声の両方があります。2026年11月7日時点で、この Issue は open です。
Issue #14276 は、RTX 5070 Ti(16GB)で、ワークフローや dtype を切り替えたあとから毎回読み込み直すようになり、再起動するまで戻らない、という報告です。タイトルには、モデルをシンボリックリンクで置いている場合とあります。こちらも open です。
コメントを見る限り、メインメモリに余裕がないときに、載せておいたモデルが追い出されて、ディスクから読み直しになる場合が多いようです。これはコメントからの筆者の読み取りで、公式の診断ではありません。
自分の PC で切り分ける手順
- 起動オプションを見る:ComfyUI を起動する .bat をメモ帳で開き、
--cache-noneや--cache-ramなどが入っていないか見ます。入っていたら外して起動し直します。 - プロンプトだけ変えて3回実行する:ログの「Requested to load」の数を回ごとに数えます。1回目だけ出るなら正常です。
- 毎回出るならメモリを見る:タスクマネージャーの「パフォーマンス」でメモリを見ます。ほぼ使い切っているなら、ほかのアプリを閉じるか、小さいモデル(fp8 など)に替えます。
- ComfyUI を更新する:読み込みの仕組みは版ごとに直されています。更新の方法はこちら。
- それでも続くなら試しに切り替える:
--disable-dynamic-vramを付けて動きが変わるかを見ます。これは切り分けのためで、公式の直し方ではありません。ComfyUI は「このオプションは近く削除する」と警告を出します。
--disable-dynamic-vram を付けると、ログに「loaded completely」か「loaded partially」が出ます。「loaded partially」は、モデルが VRAM に入りきらず、一部をメインメモリに置いたという意味です。
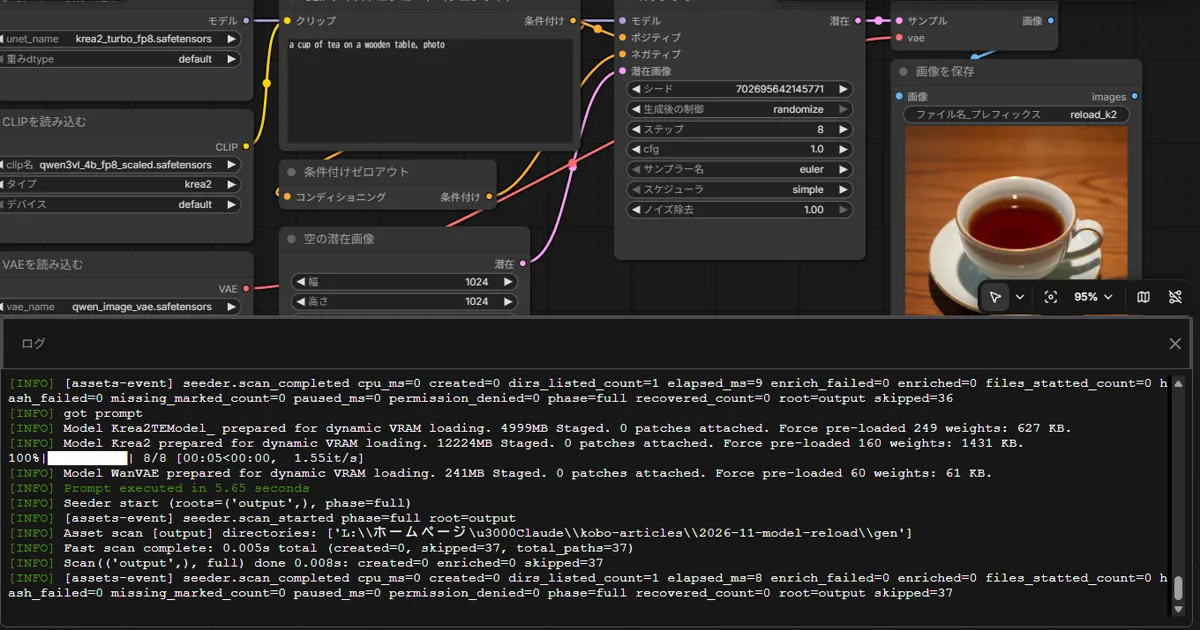
- Krea2 Turbo のワークフロー(JSON)ComfyUI にドラッグして読み込みます。カスタムノードは不要です
使ったモデル
| ファイル | 大きさ | 置き場所 |
|---|---|---|
| krea2_turbo_fp8.safetensors | 12.9GB | models\diffusion_models |
| qwen3vl_4b_fp8_scaled.safetensors | 5.2GB | models\text_encoders |
| qwen_image_vae.safetensors | 254MB | models\vae |
RTX 5090 以外の人へ
今回は再現しませんでしたが、報告の多くは 12〜16GB の GPU です。--reserve-vram 20(12GB 程度を想定)の簡易テストでも、プロンプトだけ変えた回の読み込み直しは出ませんでした。--reserve-vram は容量そのものを制限する機能ではなく、メインメモリの少なさも再現できないので、実際の 12GB・16GB の GPU や 32GB の PC での動作を再現・保証するものではありません。
よくある質問(FAQ)
Q. ComfyUI で毎回モデルを読み込み直して遅いのはなぜ?
ログに「Requested to load」が毎回出ているなら読み込み直しています。起動オプションの –cache-none、メインメモリの不足、古い版の不具合が考えられます。RTX 5090・128GB の環境では、プロンプトだけ変えたときの読み込み直しは起きませんでした。
Q. –cache-none を付けるとモデルが載ったままになる?
なりません。–cache-none はノードの実行結果を覚えない設定で、今回の試験では毎回すべてのモデルを読み込み直し、遅くなりました。
Q. 「prepared for dynamic VRAM loading」が毎回出るのは読み込み直し?
今回の試験では、この行が毎回出ても時間は短いままで、読み込み直しではありませんでした。数えるのは「Requested to load」のほうです。
まとめ
エラーのない遅さは、ログの「Requested to load」の回数で切り分けられます。1回目と、モデルや dtype を替えたときに出るのは正常です。
プロンプトだけ変えて毎回出るなら、–cache-none とメモリの余裕を確かめる。
検証メモ
- 方法:起動オプションごとに ComfyUI を起動し直し、API から5回続けて実行しました。回ごとに増えたログの行から「Requested to load」を数え、時間は ComfyUI の実行開始から完了までです。
- dtype の切り替え:Krea2 は default と fp8_e4m3fn_fast、Anima は default と fp8_e4m3fn です。
- Anima の条件:1024×1024、30ステップ、CFG 4、er_sde。
--reserve-vram 24でも結果は変わりませんでした。 - モデルの置き場所:ComfyUI の外のフォルダーを extra_model_paths.yaml で読ませています。シンボリックリンクは使っていません。
- 未確認のこと:12・16GB の GPU、メインメモリ 32・64GB の PC、LoRA を付け替えたとき、カスタムノードを含むワークフロー、0.44 以降の版。