この記事について(広告・アフィリエイトリンクはありません)
使ったモデルとソフトは、すべて無料で入手できます。試した環境の一覧は検証の記録にあります。
Qwen Image 2.1 の公式テンプレートで refine_prompt(プロンプト拡張)をオンにすると、画像を作る前に、別のモデルがプロンプトを長く書き直します。遅くなるのはこの書き直しの分です。 thinking_mode もオンにするなら、max_length を公式の 16256 まで上げてください。足りないと、書き直しが空になり、入力と関係ない画像が出ます。
所要時間は10分ほど、難しさは初心者向けです。
先に結論(今回のテスト条件で)
| 設定 | 短いプロンプト | 長いプロンプト(テンプレートの例文) |
|---|---|---|
| refine_prompt オフ(既定) | 2.0秒 | 4.1秒 |
| オン・thinking_mode オフ | 11.1秒(拡張用モデルの読み込みを含む) | 6.3秒 |
| オン・thinking_mode オン・max_length 4096 | 10.0秒 | 15.4秒 |
| オン・thinking_mode オン・max_length 16256 | 13.2秒 | 21.5秒 |
Qwen Image 2.1 Turbo(int8_convrot)、1024×1024、ComfyUI 0.44.0、RTX 5090。書き直しは1秒に約127トークンで、1回あたり259〜2188トークンでした。
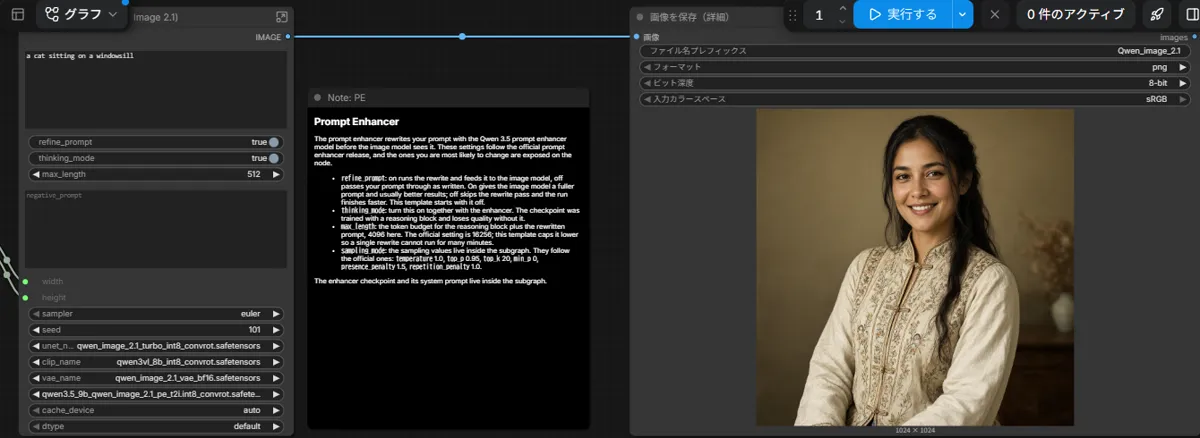
max_length を 512 に下げたときは、書き直しが空になり、「窓辺の猫」と頼んだのに女性の写真が出ました。
プロンプト拡張とは?
公式ドキュメントによると、Qwen Image 2.1 の文字から画像・画像編集のテンプレートには、任意で使えるプロンプト拡張が入っています。専用のテキストエンコーダー(Qwen 3.5 9B の拡張用モデル)が、短い頼みごとを長く詳しいプロンプトに書き直してから、画像を作ります。
設定は、テンプレートの「Qwen Image 2.1」のまとめノード(サブグラフ)に出ています。
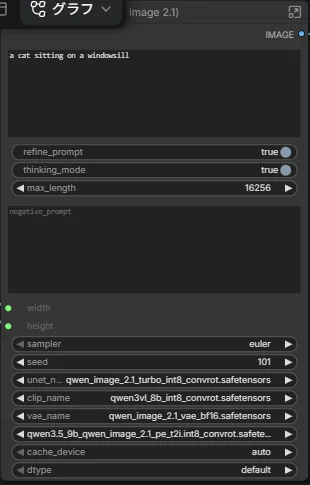
| 設定 | 意味 | テンプレートの既定 |
|---|---|---|
| refine_prompt | オンで書き直したプロンプトを使う。オフなら入力したまま | オフ |
| thinking_mode | 書き直す前に考える部分(推論)を出す。公式は refine_prompt と一緒にオンを案内 | オフ |
| max_length | 考える部分と書き直しの合計の上限(トークン数)。最大 32768 | 4096 |
公式ドキュメントは、拡張用モデルは推論の部分つきで学習されていて、なしでは質が落ちるので、thinking_mode は max_length を上げてから refine_prompt と一緒にオンにする、と案内しています。拡張用モデルの配布ページの設定は、文字から画像で 16256、画像編集で 24000 です。
なぜ空のプロンプトになる?
公式ドキュメントでは、推論の部分が max_length を使い切ると、推論が閉じないまま終わり、書き直しが空の文字列になると説明されています。画像のモデルは空のプロンプトで作るので、文字から画像では頼んだ内容が消え、画像編集では入力に近い画像が返ってきます。エラーは出ません。
テンプレートが 4096 で出荷されているのは、1回の書き直しに何分もかからないようにするため、とされています。
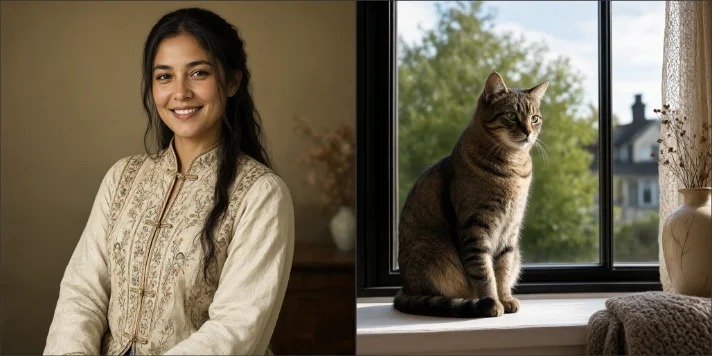
今回の試験では、max_length 4096 でも推論と書き直しは 2188 トークン以内に収まり、空にはなりませんでした。空になる様子を確かめるために 512 まで下げたところ、書き直しは0文字で、画像は頼んだ内容と関係ないものになりました。1024 では書き直しが出ています。
長いプロンプトや複雑な画面を頼むほど、推論が長くなります。4096 で空になるかどうかはプロンプト次第なので、thinking_mode を使うなら 16256 にしておくのが確実です。
書き直しの中身を見る
公式ドキュメントによると、サブグラフの中に「Preview Any」ノードがあり、画像のモデルに実際に渡るプロンプトが表示されます。まとめノードの右上のボタンでサブグラフの中に入れます。ここが空なら、書き直しが空になっています。
短いプロンプト「a cat sitting on a windowsill」は、1300〜2900文字ほどの英文に書き直されました。窓の位置、猫の毛色、光の向きなどが細かく足されています。
- Qwen Image 2.1 Turbo のワークフロー(プロンプト拡張オン・max_length 16256、JSON)公式テンプレートの設定を変えたものです。ComfyUI 0.44.0 にドラッグして読み込みます。カスタムノードは不要です
使ったモデル
| ファイル | 大きさ | 置き場所 |
|---|---|---|
| qwen_image_2.1_turbo_int8_convrot.safetensors | 6.8GB | models\diffusion_models |
| qwen3vl_8b_int8_convrot.safetensors | 8.7GB | models\text_encoders |
| qwen3.5_9b_qwen_image_2.1_pe_t2i.int8_convrot.safetensors(拡張用) | 8.8GB | models\text_encoders |
| qwen_image_2.1_vae_bf16.safetensors | 0.6GB | models\vae |
拡張用モデルは、refine_prompt をオンにしたときだけ使われます。オフで使うなら、ダウンロードしなくても動きます(公式ドキュメントより)。画像編集では、拡張用モデルが pe_i2i の別ファイルになります。
RTX 5090 以外の人へ
書き直しの時間は、拡張用モデル(8.8GB)を動かす速さで決まります。VRAM が少ない GPU では、画像のモデルと拡張用モデルを入れ替えながら動かすので、さらに時間がかかる可能性があります。フォーラムでは、別の環境で書き直しに47秒かかり、画像を作るほうより長かったという声もあります。
--reserve-vram による簡易テストはしていません。遅さが気になる場合は、まず refine_prompt をオフにして、どれだけ速くなるかを比べてください。
よくある質問(FAQ)
Q. Qwen Image 2.1 のプロンプト拡張で遅くなるのはなぜ?
画像を作る前に、9B の拡張用モデルがプロンプトを長く書き直すためです。RTX 5090 では、オフで 2.0秒のところ、オンで 10〜21秒になりました。速さを取るなら refine_prompt をオフにします(テンプレートの既定)。
Q. refine_prompt をオンにしたら、関係ない画像が出たのはなぜ?
thinking_mode がオンで max_length が足りないと、推論の部分が上限を使い切って、書き直しが空になります。画像のモデルは空のプロンプトで作るので、頼んだ内容が消えます。max_length を 16256 に上げてください。
Q. thinking_mode はオンにしたほうがいい?
公式ドキュメントは、拡張用モデルは推論の部分つきで学習されていて、なしでは質が落ちるので、refine_prompt と一緒にオンにするよう案内しています。そのときは max_length を先に上げます。
まとめ
プロンプト拡張で遅くなるのは、画像を作る部分ではなく、書き直しの分です。
使うなら、refine_prompt と thinking_mode をオンにして、max_length を 16256 に。速さを取るならオフのまま。
検証メモ
- 方法:公式テンプレート「Qwen Image 2.1 Turbo」(文字から画像)の refine_prompt・thinking_mode・max_length だけを変え、シード 101 で API から実行しました。時間は ComfyUI の実行開始から完了まで、書き直しの文字数は Preview Any の出力です。
- 時間の見方:「オン・thinking_mode オフ」の短いプロンプトの回は、拡張用モデルを初めて読んだ時間を含みます。max_length 4096 の短いプロンプトの回は2度測り、10.0秒と 9.95秒でした。
- 空になる再現:max_length 512 で書き直しが空(0文字)になりました。1024 では 2175文字の書き直しが出ました。4096 では、今回の2つのプロンプトとも空になりませんでした。
- 未確認のこと:画像編集のテンプレート、VRAM の少ない GPU での時間、llama.cpp などの別の方法で書き直す場合。