この記事について(広告・アフィリエイトリンクはありません)
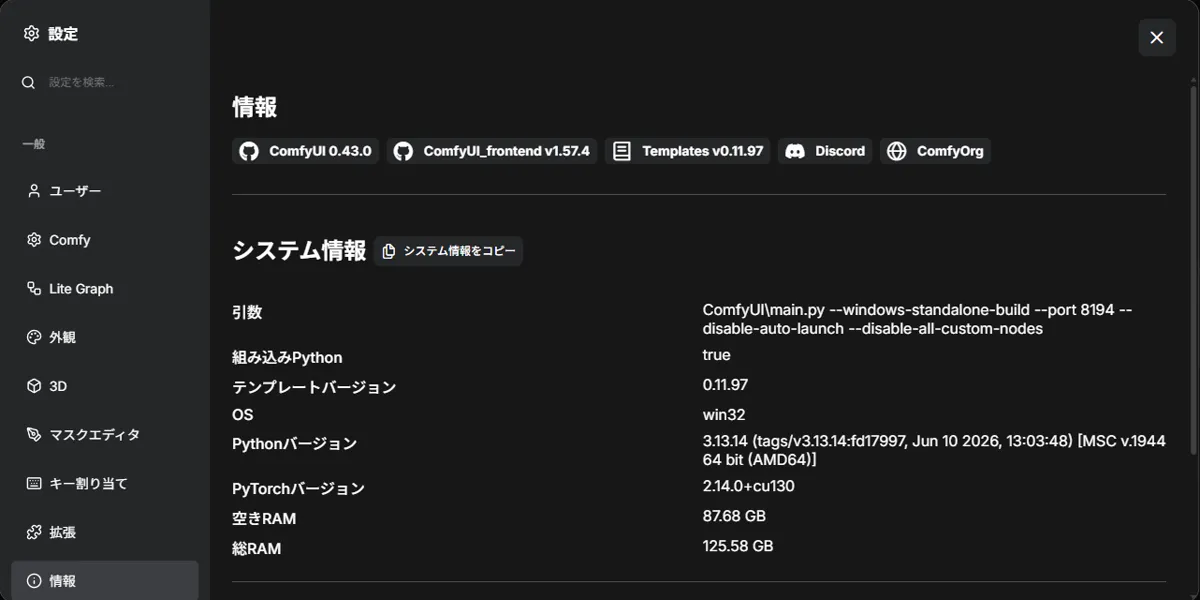
使ったモデルとソフトは、すべて無料で入手できます。試した環境の一覧は検証の記録にあります。
Qwen Image 2.1 で「CUDA error: invalid argument」が出て止まったら、まずエラーの出たノードと、自分の環境の組み合わせ(PyTorch の版、attention の種類、VRAM)を書き留めてください。 「invalid argument」は、プロンプトや設定の入力が悪いという意味とは限りません。
筆者の RTX 5090 では、報告と同じ公式のテキストエンコーダーで24回試して、一度もエラーは出ませんでした。この記事では、試した条件と、自分の環境で切り分ける手順をまとめます。所要時間は15分ほどです。
先に結論(今回のテスト条件で)
| 条件 | 結果 |
|---|---|
| ComfyUI 0.43.0 と 0.44.0 | どちらも12回中12回成功 |
| テキストエンコーダー w4a8(5.9GB)と int8_convrot(8.7GB) | どちらも成功 |
--reserve-vram 20(12GB 程度を想定) | 成功 |
報告にあった、PyTorch 2.15、SageAttention、ControlNet(union)入りのワークフローは試していません。どれかが関係している可能性は残ります。
どんな報告?
公式 GitHub の Issue #17574(2026年11月6日)では、Qwen Image 2.1 のワークフローを実行すると、テキストエンコーダーを準備した直後に「CUDA error: invalid argument」で止まると報告されています。2026年11月7日時点で、コメントはなく、原因はわかっていません。
| 項目 | 報告者の環境 |
|---|---|
| GPU | RTX 4070 Ti(12GB)、メインメモリ 32GB |
| PyTorch | 2.15.0+cu134 |
| attention | SageAttention |
| ワークフロー | qwen_image_21_union_cn.json(ControlNet 入り) |
| テキストエンコーダー | ログでは約8.9GB を準備(大きさから int8_convrot の可能性) |
エラーには、ドライバーの記録として「Allocation not found」「cuMemcpyDtoDAsync_v2」という行が付いています。GPU のメモリの中でデータを写すときに、写す先か元が見つからなかった、と読めます。
エラーの読み方
ComfyUI のエラーは長いですが、見るところは3つです。
- どのノードで止まったか:画面で赤く囲まれるノードと、エラーのウィンドウの見出しに出ます。今回の報告ではテキストエンコードのノードです。
- 最初の1行:「CUDA error: invalid argument」のような、何が起きたかの要約です。
- トレースバックの最後のほう:どのファイル・どの処理で止まったかが出ます。報告では、テキストエンコーダーの量子化された重みを複製する処理(comfy_kitchen 経由)でした。画像を作る本体(KSampler)ではありません。
CUDA のエラーは、実際に問題が起きた場所より後で報告されることがあります。ログの最初の行だけを見て原因を決めつけないようにします。
RTX 5090 で試すとどうなる?
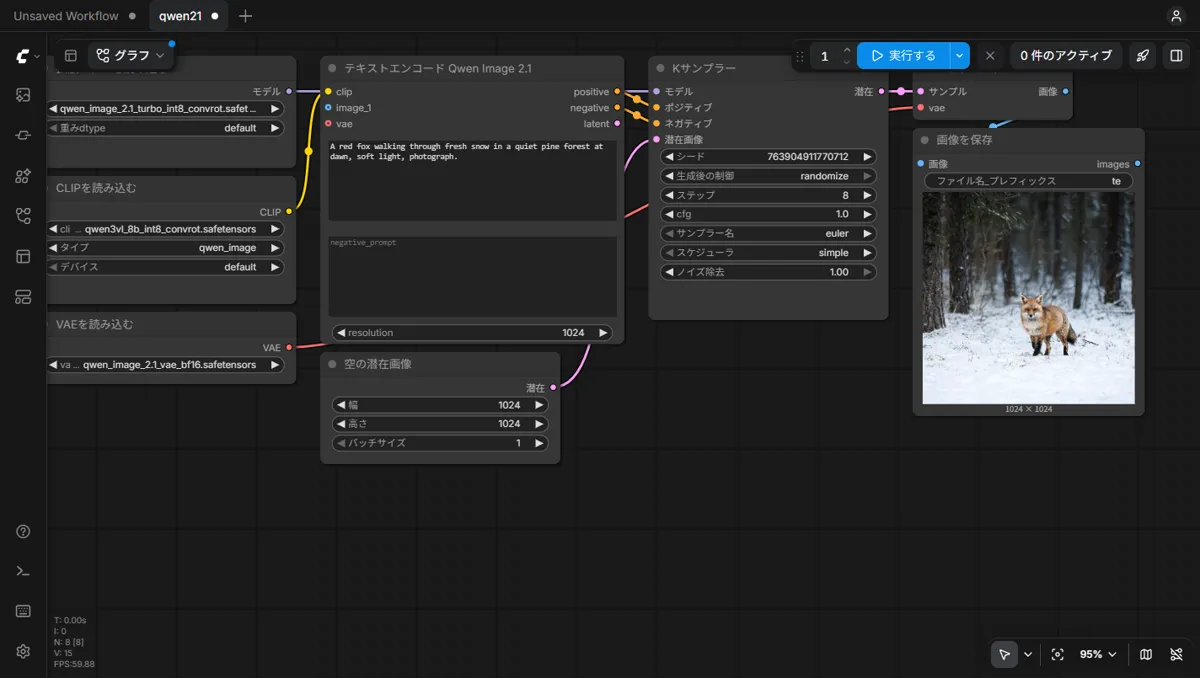
Qwen Image 2.1 Turbo(int8_convrot)の公式の組み合わせで、テキストエンコーダーを2種類、起動オプションを2種類、ComfyUI の版を2つ変えて、プロンプトを変えながら3回ずつ、計24回実行しました。
| 版 | 起動オプション | テキストエンコーダー | 1回目 | 2・3回目 |
|---|---|---|---|---|
| 0.43.0 | なし | w4a8 | 成功(168秒、初めての読み込み) | 成功(1.9秒) |
| 0.43.0 | なし | int8_convrot | 成功(3.8秒) | 成功(1.7秒) |
| 0.43.0 | --reserve-vram 20 | w4a8 | 成功(7.1秒) | 成功(2.0秒) |
| 0.43.0 | --reserve-vram 20 | int8_convrot | 成功(3.7秒) | 成功(1.9秒) |
| 0.44.0 | なし | w4a8 | 成功(7.6秒) | 成功(1.9秒) |
| 0.44.0 | なし | int8_convrot | 成功(3.6秒) | 成功(1.7秒) |
| 0.44.0 | --reserve-vram 20 | w4a8 | 成功(6.9秒) | 成功(1.9秒) |
| 0.44.0 | --reserve-vram 20 | int8_convrot | 成功(3.8秒) | 成功(1.9秒) |
1024×1024、8ステップ、CFG 1。時間は ComfyUI の実行開始から完了まで。0.43.0 の最初の1回だけは、モデルをディスクから初めて読んだため 168秒かかりました。
起動時のログの「cudaMallocAsync」「async weight offloading with 2 streams」は、報告者と筆者で同じでした。違うのは PyTorch の版(筆者は 2.14.0+cu130)と attention(筆者は標準の pytorch attention)です。
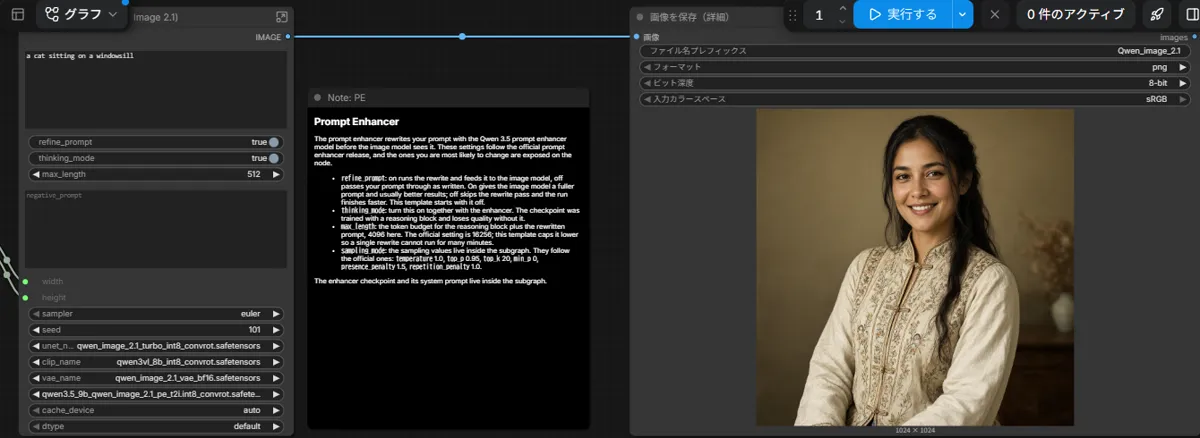
- Qwen Image 2.1 Turbo のワークフロー(JSON)ComfyUI にドラッグして読み込みます。カスタムノードは不要です
自分の PC で切り分ける手順
- 環境を書き留める:起動したときのログの最初の数十行(VRAM、PyTorch の版、attention の行)を保存します。設定の「情報」でも確かめられます。
- 単純なワークフローで試す:上の JSON か公式のテンプレートなど、ControlNet もカスタムノードもないワークフローで動くかを見ます。
- attention を標準に戻す:起動オプションの
--use-sage-attentionを外して試します。 - テキストエンコーダーを替える:int8_convrot で止まるなら w4a8、その逆も試します。
- 1つずつ戻す:動いたら、外したものを1つずつ戻して、どこで止まるかを見ます。
- 報告する:直らないときは、書き留めた環境と、どこで止まったかを添えて、公式 GitHub の Issue に書き込みます。
使ったモデル
| ファイル | 大きさ | 置き場所 |
|---|---|---|
| qwen_image_2.1_turbo_int8_convrot.safetensors | 6.8GB | models\diffusion_models |
| qwen3vl_8b_int8_convrot.safetensors | 8.7GB | models\text_encoders |
| qwen3vl_8b_w4a8.safetensors | 5.9GB | models\text_encoders |
| qwen_image_2.1_vae_bf16.safetensors | 0.6GB | models\vae |
Qwen Image 2.1 の基本の使い方と量子化の違いはこちらの記事で試しています。
RTX 5090 以外の人へ
報告は 12GB の GPU です。--reserve-vram 20(12GB 程度を想定)の簡易テストではエラーは出ませんでした。--reserve-vram は容量そのものを制限する機能ではなく、メインメモリの少なさも再現できないので、実際の 12GB・16GB の GPU での動作を再現・保証するものではありません。
よくある質問(FAQ)
Q. ComfyUI の「CUDA error: invalid argument」とは?
GPU に渡した値が正しくないという、CUDA のエラーです。プロンプトや画像の入力が悪いという意味とは限らず、モデルの載せ方やライブラリの組み合わせで起きることもあります。どのノードで止まったかと、環境を書き留めて切り分けます。
Q. Qwen Image 2.1 の Text Encode で止まるときは?
ControlNet や SageAttention を外した単純なワークフローで試し、テキストエンコーダーの種類も替えてみます。RTX 5090 では、公式の組み合わせで24回試してエラーは出ませんでした。
Q. エラーが出たら何を記録すればいい?
止まったノード、エラーの最初の行とトレースバックの最後のほう、起動ログの VRAM・PyTorch・attention の行です。公式 GitHub に報告するときも、これがあると原因を探しやすくなります。
まとめ
「invalid argument」は入力の間違いとは限りません。止まったノードと環境を書き留め、単純なワークフローから1つずつ条件を戻すと、どこが原因かを絞り込めます。
検証メモ
- 方法:条件ごとに ComfyUI を起動し直し、API からプロンプトを変えて3回ずつ実行し、成否と時間を記録しました。
- 報告との違い:PyTorch 2.15.0+cu134、SageAttention、ControlNet(union)入りのワークフロー、メインメモリ 32GB は試していません。
- 報告のテキストエンコーダー:ログの「8916MB Staged」から int8_convrot と推測しました。報告に、ファイル名は書かれていません。
- 未確認のこと:12GB の実機、PyTorch 2.15、SageAttention、ControlNet を使うワークフロー、0.44.1 以降。