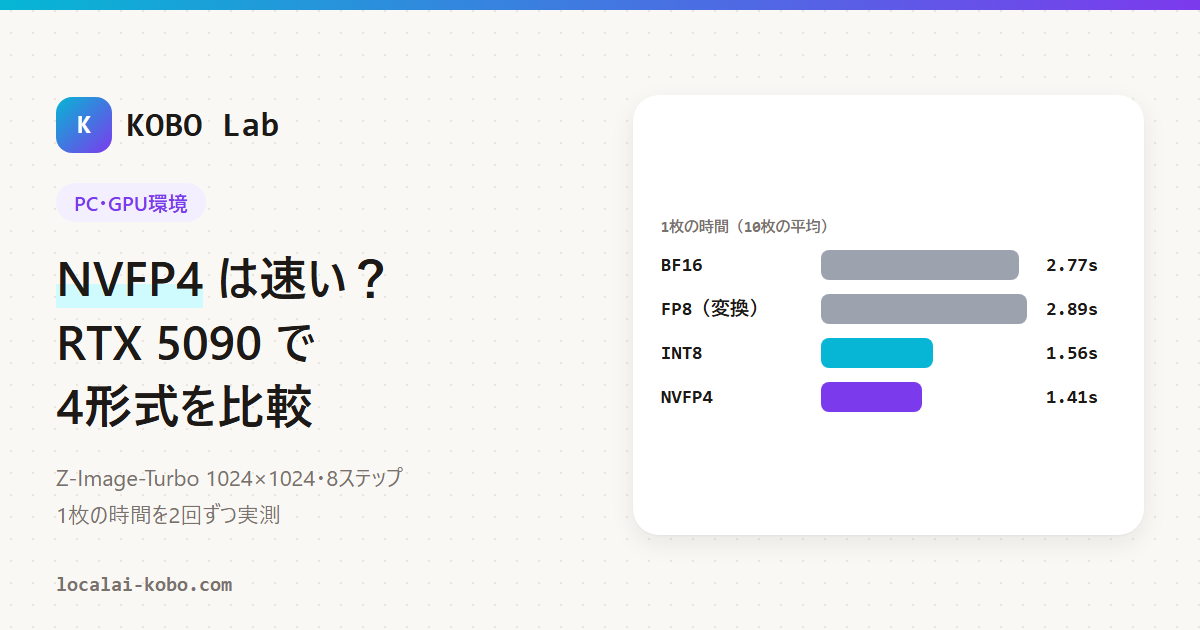
RTX 50 シリーズ(Blackwell 世代)を買うと、「NVFP4 なら速い」という話を目にします。NVFP4 は、NVIDIA の新しい GPU が計算できる4ビットの数値の形式で、モデルを小さくしながら速く動かすためのものです。ComfyUI も対応しています。
では実際にどれくらい違うのか。この記事では、公式に NVFP4 版が配られている画像生成モデル Z-Image-Turbo を使い、RTX 5090 で NVFP4・INT8・FP8・BF16 を同じ条件で比べました。時間・VRAM・画像の違いを、すべて実測で載せます。確かめられなかった点は末尾の「検証メモ」に書きました。
試した環境
| GPU | NVIDIA GeForce RTX 5090(32GB) |
| CPU / メモリ | AMD Ryzen 9 9950X3D / 128GB |
| OS | Windows 11 |
| ComfyUI | v0.43.0(ポータブル版、カスタムノードなし) |
| PyTorch | 2.14.0+cu130(ポータブル版に同梱) |
| comfy-kitchen | 0.2.40(NVFP4 などの計算を担う部品。ComfyUI に同梱) |
| 確認した日 | 2026年10月30日 |
ComfyUI を起動したときのログに「Native ops: … nvfp4 …」と出ていて、NVFP4 の計算を GPU で直接行える状態でした。
NVFP4・INT8・FP8・BF16 は何が違う?
モデルの中身は大量の数値(重み)です。その数値を何ビットで持つかで、ファイルの大きさと計算の速さが変わります。ビット数が少ないほど小さく速くなりますが、元の数値からずれるので、絵が少し変わることがあります。
| 形式 | ざっくり言うと | 今回使ったファイル(大きさ) |
|---|---|---|
| BF16 | 16ビット。元の精度に近い基準 | z_image_turbo_bf16.safetensors(11.46GiB) |
| FP8(変換) | 8ビット。BF16 のファイルを読み込むときに ComfyUI が変換 | 上と同じファイル。「拡散モデルを読み込む」の「重みdtype」を fp8_e4m3fn に |
| INT8 | 8ビットの整数。公式に配布 | z_image_turbo_int8_convrot.safetensors(5.78GiB) |
| NVFP4 | 4ビット。Blackwell 世代の GPU で速く計算できる。公式に配布 | z_image_turbo_nvfp4.safetensors(4.20GiB) |
Comfy-Org の Z-Image-Turbo の配布ページには、BF16・INT8・NVFP4 の3つがあり、FP8 のファイルはありませんでした(2026年10月30日時点)。そのため FP8 は、ComfyUI の読み込み時の変換で比べています。公式の FP8 ファイルとは別物です。
比べた条件
ComfyUI に入っている公式テンプレート「Z-Image-Turbo」と同じ設定にしました。
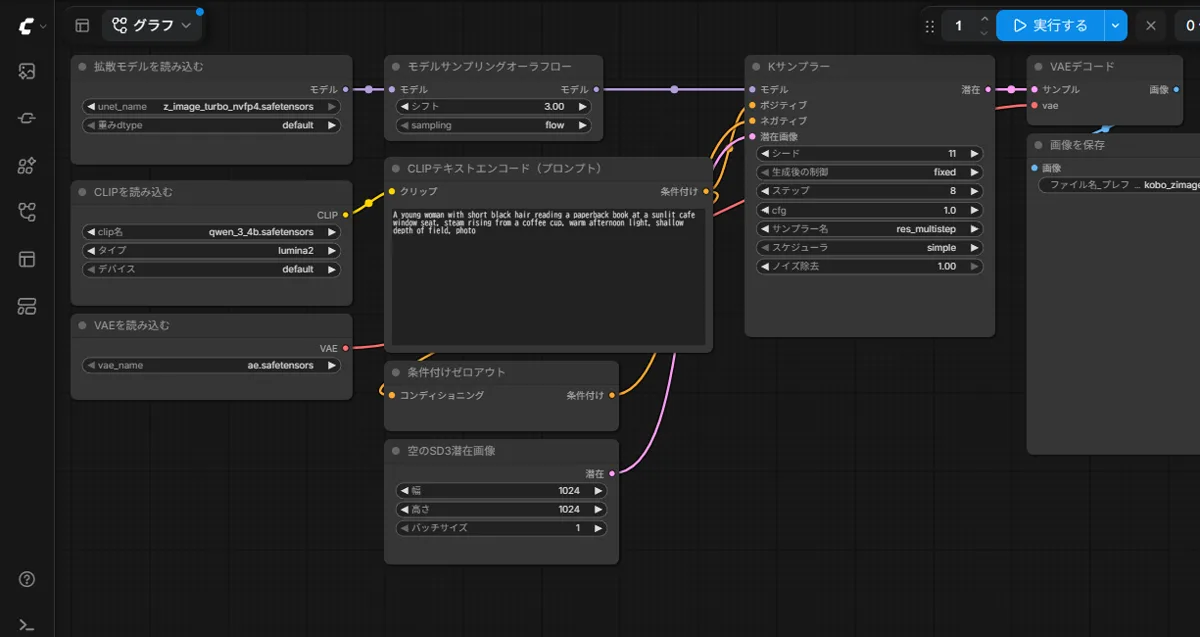
- 解像度 1024×1024、8ステップ、CFG 1、サンプラー res_multistep、スケジューラー simple、シフト 3(ModelSamplingAuraFlow)
- テキストエンコーダーは qwen_3_4b.safetensors(
models\text_encoders、タイプ lumina2)、VAE は ae.safetensors(models\vae)。拡散モデルはmodels\diffusion_modelsに置く - プロンプト2つ(カフェの写真風・雪山のアニメ風)×シード5つ(11〜55)=1形式10枚
- 各形式で、まずモデルを外した状態から1枚作り(初回)、そのあと10枚を作って時間を記録。これを5条件(表は4形式。fp8_e4m3fn_fast は表では省略)で2回ずつ繰り返した
- 時間は ComfyUI の記録(実行開始〜終了。サンプリング・VAE・保存を含む)、速さ(it/s)は ComfyUI のログのサンプリングの値
- VRAM は nvidia-smi で0.15秒ごとに測り、モデルを外した直後からの増え方(最大値)を MiB ÷ 1024 の GiB で示した
結果1:速さ
| 形式 | サンプリング(it/s) | 1枚の時間(平均) | 初回(読み込み込み)1回目/2回目 |
|---|---|---|---|
| BF16 | 3.28 | 2.77秒 | 9.4秒/6.5秒 |
| FP8(変換) | 3.14 | 2.89秒 | 6.8秒/6.6秒 |
| INT8 | 6.55 | 1.56秒 | 6.1秒/4.4秒 |
| NVFP4 | 7.66 | 1.41秒 | 5.3秒/4.2秒 |
1枚の時間とサンプリングの速さは、2回とも10枚の平均でほぼ同じ値でした(ばらつきは ±0.1 it/s 以内)。NVFP4 はサンプリングが BF16 の約2.3倍、1枚の時間では約2倍速でした。公式ブログの「FP8 や BF16 の約2倍」とおおむね合います。1枚の時間には VAE(画像に戻す処理)や保存も入るので、サンプリングほどは差が開きません。
FP8 の変換は、今回は BF16 より少し遅くなりました。重みは8ビットで持っても、計算のときに16ビットに戻しているためと考えられます(推測)。「速い FP8」として用意されている fp8_e4m3fn_fast も試しましたが、時間も画像も fp8_e4m3fn と同じでした。
結果2:VRAM
| 形式 | 増えた VRAM(最大、1回目/2回目) | ComfyUI が用意した拡散モデルの大きさ(ログ) |
|---|---|---|
| BF16 | 21.7GiB/21.8GiB | 11738MB |
| FP8(変換) | 16.0GiB/16.0GiB | 5869MB |
| INT8 | 16.0GiB/16.1GiB | 5888MB |
| NVFP4 | 14.6GiB/14.5GiB | 4299MB |
VRAM の増え方には、拡散モデルのほかにテキストエンコーダー(qwen_3_4b、約7GiB)や VAE、計算の途中のデータも入っています。そのため、ファイルの大きさの差ほどは開きません。BF16 から NVFP4 で約7GiB 減りました。
結果3:画像の違い
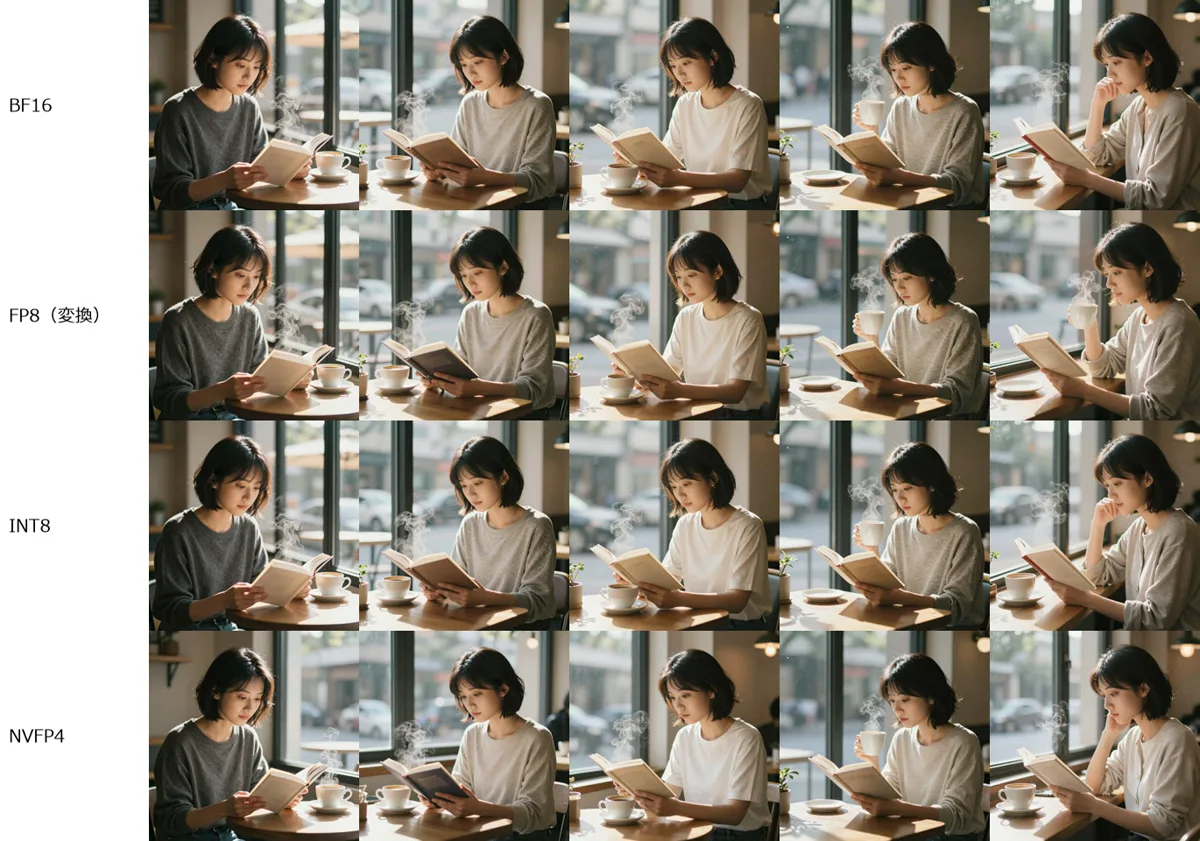
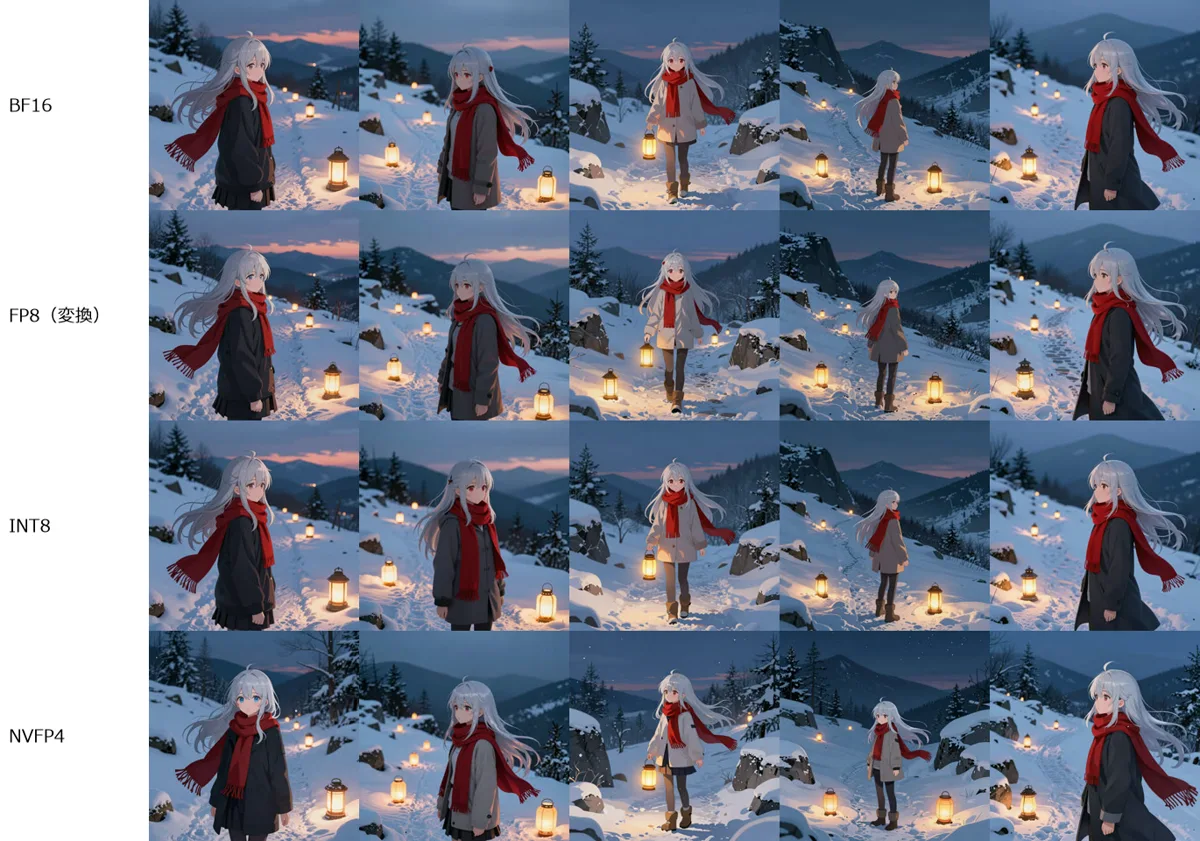
どの形式も、プロンプトの内容(人物・小物・背景)はそろっていて、崩れた画像はありませんでした。違いは主に構図や細部です。
- INT8:BF16 とほとんど同じ絵。本の角度や湯気の形が少し違う程度
- FP8(変換):構図は同じで、顔の向きや小物の位置が少し変わる
- NVFP4:構図は近いが、人物の位置や背景の木・明かりの配置が変わることが多い
BF16 の画像との似ている度合いを、画像処理でよく使う SSIM(1.0 で完全に同じ)で測ると、10枚の平均は INT8 0.93、FP8 0.80、NVFP4 0.69 でした。SSIM が低いのは「BF16 と違う絵」という意味で、「画質が悪い」という意味ではありません。どれがきれいかは好みの問題も大きいので、上の画像で見比べてください。
RTX 5090 以外の GPU ではどうなる?
NVFP4 で速くなるのは、Blackwell 世代(RTX 50 シリーズなど)だけです。公式ブログによると、それ以外の GPU でも NVFP4 のファイルは動きますが、速くはならず、PyTorch が cu130 でない場合はサンプリングが FP8 より最大2倍遅くなることもある、とされています。RTX 40 シリーズ以前の人は、まず INT8 か BF16 を選んでください(RTX 40 以前で INT8 が速くなるかは試していません)。
VRAM が少ない環境を想定して、RTX 5090 で --reserve-vram 20(20GB を ComfyUI 以外のために空けておく設定)にした簡易テストもしました。4形式とも生成でき、1枚の時間は BF16 2.8秒・FP8 2.9秒・INT8 1.5秒・NVFP4 1.4秒と、制限なしとほぼ同じでした。VRAM の増え方は最大約12.6GiB(NVFP4)でした。
GPU ごとの目安は、ComfyUI に必要な PC スペックとVRAM が足りないときの対処法にまとめています。
NVFP4 を使う手順
- z_image_turbo_nvfp4.safetensors を
models\diffusion_modelsに置く(テキストエンコーダーと VAE は BF16 版と共通) - 下のワークフローを ComfyUI の画面にドラッグ&ドロップする(または、公式テンプレート「Z-Image-Turbo」の「拡散モデルを読み込む」でファイルを NVFP4 版に替える)
- ComfyUI の起動ログに
pytorch version: 2.x.x+cu130と出ているかを確かめる。cu130 でなければ NVFP4 は速くならない - 実行する
- kobo-zimage-turbo-nvfp4.jsonZ-Image-Turbo の NVFP4 版。ファイル名を替えれば BF16・INT8 でも使える
Z-Image-Turbo のライセンスは Apache-2.0(Hugging Face のモデルページの表示)で、生成した画像の商用利用も含めて比較的自由に使えます。使う前にモデルページの表示を確認してください。
よくある質問(FAQ)
Q. NVFP4 は本当に速いですか?
RTX 5090 と Z-Image-Turbo(1024×1024・8ステップ)では、1枚が BF16 の約2.8秒から約1.4秒になり、約2倍速でした。サンプリングだけなら約2.3倍です。
Q. NVFP4 は RTX 40 シリーズでも使えますか?
ファイル自体は読み込めますが、速くなるのは Blackwell 世代(RTX 50 シリーズなど)だけです。公式ブログでは、それ以外では FP8 より遅くなることもあると説明されています。今回は RTX 5090 以外では試していません。
Q. NVFP4 にすると画質は落ちますか?
今回の20枚では崩れた画像はなく、構図や細部が BF16 から少し変わる程度でした。BF16 に近い絵がほしいなら、公式の INT8 版のほうが近い結果でした。
Q. FP8 にすると速くなりますか?
BF16 のファイルを ComfyUI で FP8 に変換して読み込む方法では、VRAM は約6GiB 減りましたが、速さは BF16 とほぼ同じ(少し遅い)でした。
Q. NVFP4 を使うのに必要なものは?
Blackwell 世代の GPU、CUDA 13.0 版の PyTorch(cu130)、NVFP4 で配布されたモデルです。今回は ComfyUI v0.43.0 のポータブル版(PyTorch 2.14.0+cu130、comfy-kitchen 0.2.40 同梱)で、追加の導入は不要でした。
まとめ
RTX 5090 で Z-Image-Turbo を比べたところ、NVFP4 は BF16 の約2倍の速さで、VRAM も約7GiB 少なく済みました。画像は BF16 から少し変わりますが、破綻はありませんでした。BF16 に近い絵を保ちつつ速くしたいなら INT8 もよい選択です。RTX 50 シリーズを持っているなら、公式の NVFP4 版が配られているモデルではまず試す価値があります。
検証メモ
- 初回の時間:ファイルを読み込む時間を含みます。今回はダウンロード直後でファイルがパソコンのメモリに残っていた可能性があり、HDD から初めて読むときはもっとかかるはずです。
- ファイルの大きさ:1024³ で割った GiB で示しました。
- 未確認のこと:RTX 40 シリーズ以前での INT8・NVFP4、HDD から初めて読むときの初回の時間、公式の FP8 ファイル(配布なし)。