この記事について(広告・アフィリエイトリンクはありません)
紹介しているソフトとモデルは、すべて無料で入手できるものです。
H3 の 768p の動画を 2K に描き直す Open-H3-Regenerate-2K は、NVIDIA の研究チーム(NVlabs)が公開した LoRA と手順です。MiniMax の非公開の H3-Regenerate-2K API を、オープンな形で置き換える狙いで作られました。
ComfyUI 用のコミュニティノードで動かし、時間と絵の変わり方を RTX 5090 で測りました。
先に結論(今回のテスト条件で)
| 手元の 768p → 2560×1440(5秒) | 時間(読み込み後) | 入力との近さ(PSNR) |
|---|---|---|
| Regenerate(ノード既定の Sol-Attn) | 約133秒 | 20.68〜20.86dB |
| Regenerate(Sol-Attn を強めた設定) | 86秒 | 20.88dB |
| Regenerate(Sol-Attn なし) | 401秒 | 20.73dB |
| コア2K経路 + Sol-Attn | 約129秒 | 23.41dB |
| コア2K経路(Sol-Attn なし) | 約404秒 | 23.49dB |
| Tessera | 464秒 | 29.42dB |
- 速さは Sol-Attn で決まります。 2K の1ステップが約124秒から17〜28秒になりました。
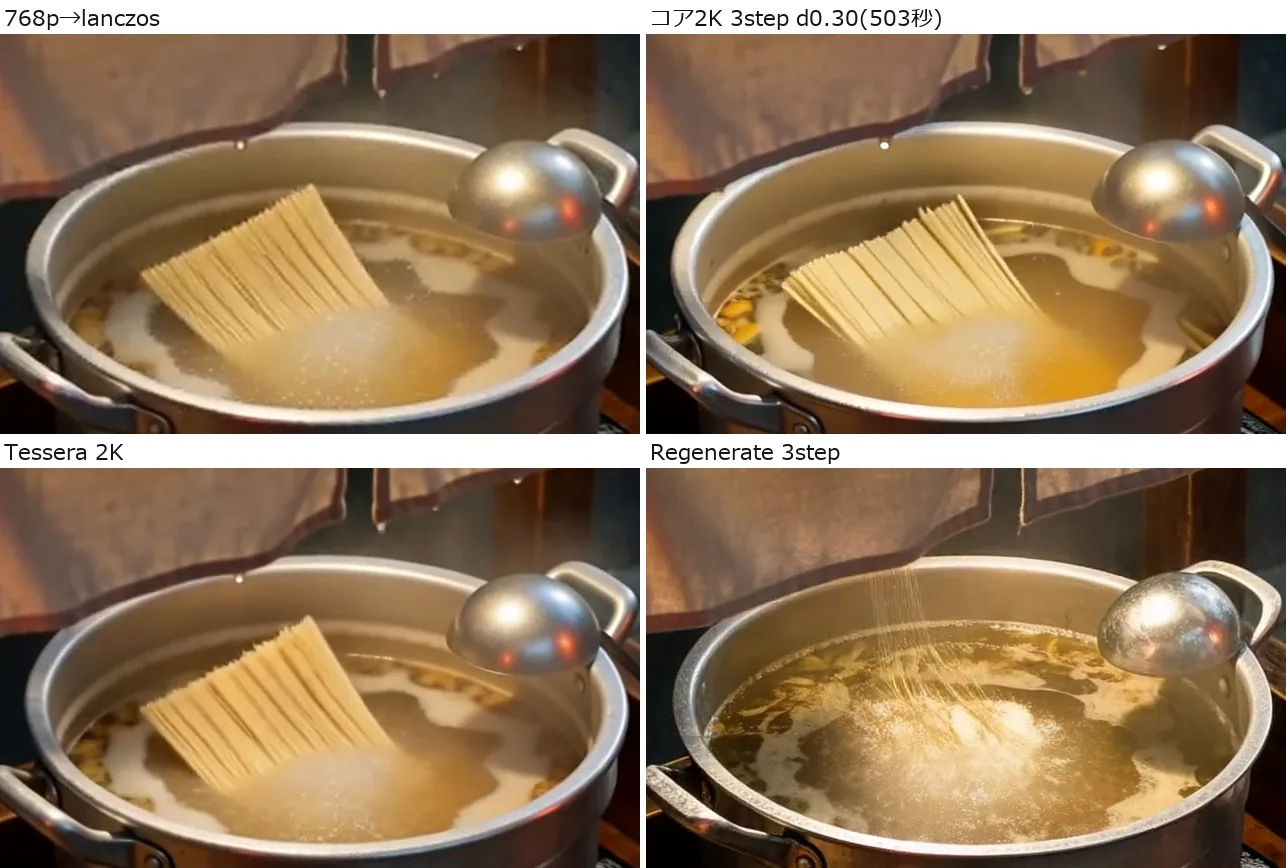
- 絵は大きく描き直されます。 麺の形はシードごとに別物になりました。細部の量は3つの中で一番多く出ましたが、元の絵を守りたいなら Tessera のほうが向きます。
- 迷ったら、まず下の配布 JSON をそのまま使ってください。絵が変わりすぎるときは、
Sigmasノードのstart_sigmaを 0.7 に下げると形を保てました。
3840×2176 は、2回とも拡大ステップは成功しましたが、その後のサンプリングで失敗しました(最初のステップで ComfyUI ごと落ちました)。15秒の下書きは 1 ステップ約1.5時間かかり、実用になりませんでした。
試した環境
| 項目 | 内容 |
|---|---|
| GPU | RTX 5090(32GB)、ドライバー 621.01 |
| CPU / RAM | Ryzen 9 9950X3D / 128GB |
| OS | Windows 11 |
| ComfyUI | ポータブル版+master 17ff1dcc(v0.43.0-26) |
| ノード | ComfyUI-Open-H3-Regenerate 9b686c5(2026-10-28、Apache-2.0) |
| 入力 | H3 FL2VA + Turbo 8step で作った 1344×768・124フレーム(ラーメン屋台と顔) |
| 設定 | シグマ 0.909375→0.857→0.667→0、euler、CFG 1、音声は無音で固定して最後に元の音を付ける |
必要なファイル
ベースと VAE はH3 の導入記事のものです。追加は次のとおりです。
| ファイル | サイズ | 置き場所 |
|---|---|---|
| open_h3_regenerate_2k_lora.safetensors | 12.5GB | models\loras |
| sharp_curve_branches.safetensors | 1.24GB | models\loras |
| fast_h3_vae_noncausal_24l.safetensors | 6.47GB | models\vae |
| minimax_h3_latent_upscaler_3d_conv_v1_bf16.safetensors | 691MB | models\latent_upscale_models |
| minimax_h3_fl2va_pruned_int8_convrot.safetensors | 21GB | models\diffusion_models |
| minimax_h3_ref2va_pruned_int8_convrot.safetensors | 21GB | models\diffusion_models(数KBの表を読むだけですが必要) |
高速 VAE は、すでにSol-H3-VAEの sol_h3_vae.safetensors を持っていれば同じファイルです。sha256 が一致しました。
ノードの README は LBH のアップスケーラー用カスタムノードも求めていますが、配布 JSON は ComfyUI コアの MiniMax H3 Latent Upscale With Model を使うので不要です。その代わり、4K で2回に分けて拡大するノードの機能は通っていません。
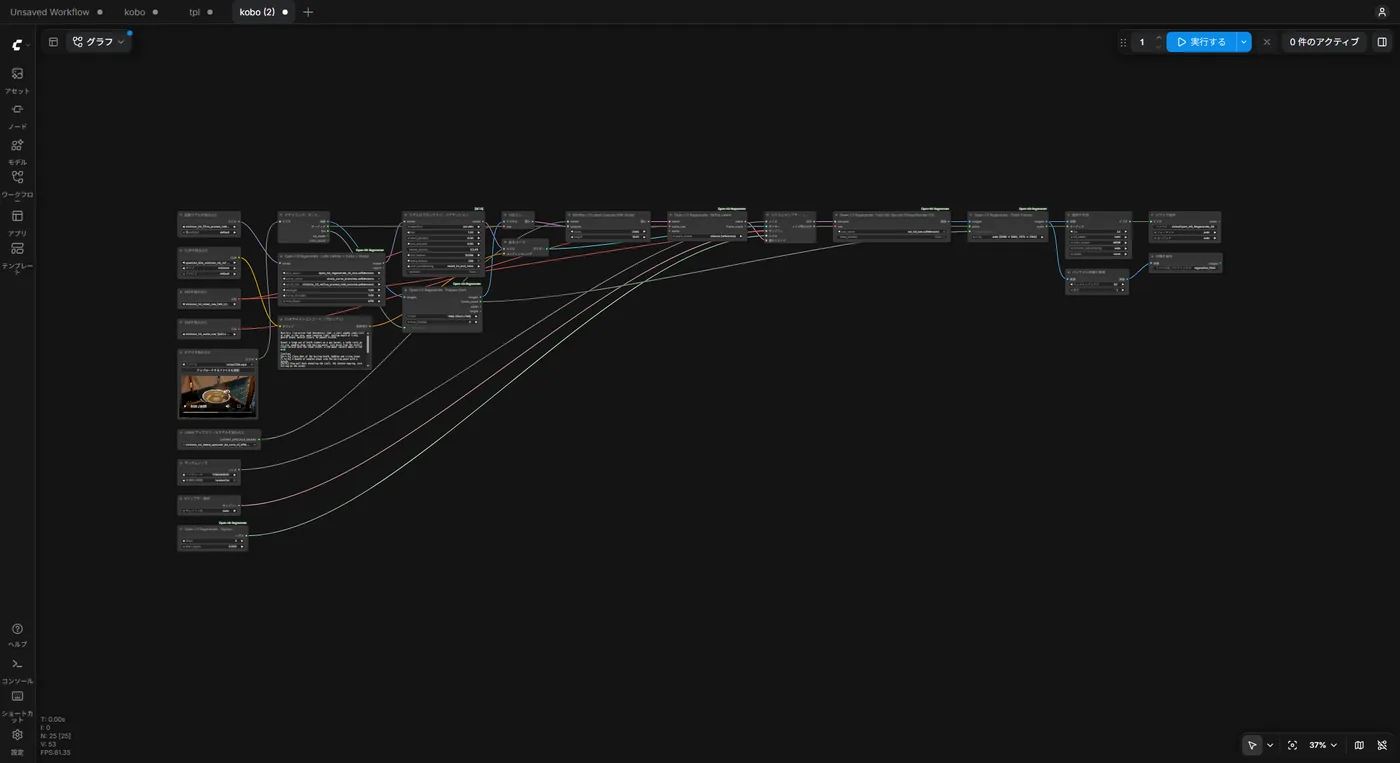
- open_h3_regenerate_2k_workflow.jsonComfyUI にドラッグして読み込みます(768p→2K、3ステップ、Sol-Attn、高速 VAE。必要なカスタムノードは ComfyUI-Open-H3-Regenerate だけ)
画面から実行して、成功を確かめました(751秒、モデル読み込み込み)。下の表の設定はノード同梱の JSON に合わせています。
時間の実測
| 条件 | 全体 | サンプリング | デコード | ステップ単価 |
|---|---|---|---|---|
| 起動直後(モデル読み込み込み) | 495〜981秒 | – | 104〜128秒 | – |
| ノード既定(τ1.2、5シード中央値) | 133秒 | 89秒 | 19秒 | 約28秒 |
| 強め(τ1.75、終わりまで sparse) | 86秒 | 57秒 | 20秒 | 約17秒 |
| Sol-Attn なし | 401秒 | 372秒 | 20秒 | 約124秒 |
| 標準 VAE でデコード(強め) | 109秒 | 57秒 | 41秒 | 約17秒 |
| 1920×1088(強め) | 66秒 | 28秒 | 15秒 | 約8秒 |
| 顔(ノード既定、5シード中央値) | 131秒 | 87秒 | 19秒 | 約28秒 |
全体とサンプリング+デコードの差は、エンコード約13秒、保存約6秒、テキスト約3秒、拡大約1.5秒などです(強めと Sol-Attn なしはエンコード済みの実行で、差は約9秒)。
Sol-Attn は、ComfyUI 標準の Block Sparse Attention ノードです。H3 の計算のうち影響の小さい部分を省きます。Regenerate 専用の機能ではないので、コア2K経路に足しても効きました。768p の生成から通しで503秒だったものが、242秒になりました。
公式の値は単一の B200 で22.45秒(Sol-Engine、高速 VAE)、ノード作者の値は RTX PRO 5000 Blackwell 72GB で約3分です。
絵はどれくらい変わる?
Regenerate は、拡大した latent にノイズを強く乗せ直します(σ0.909)。名前のとおり、下書きを描き直す処理です。公式も「細部を描き直す」と説明しています。
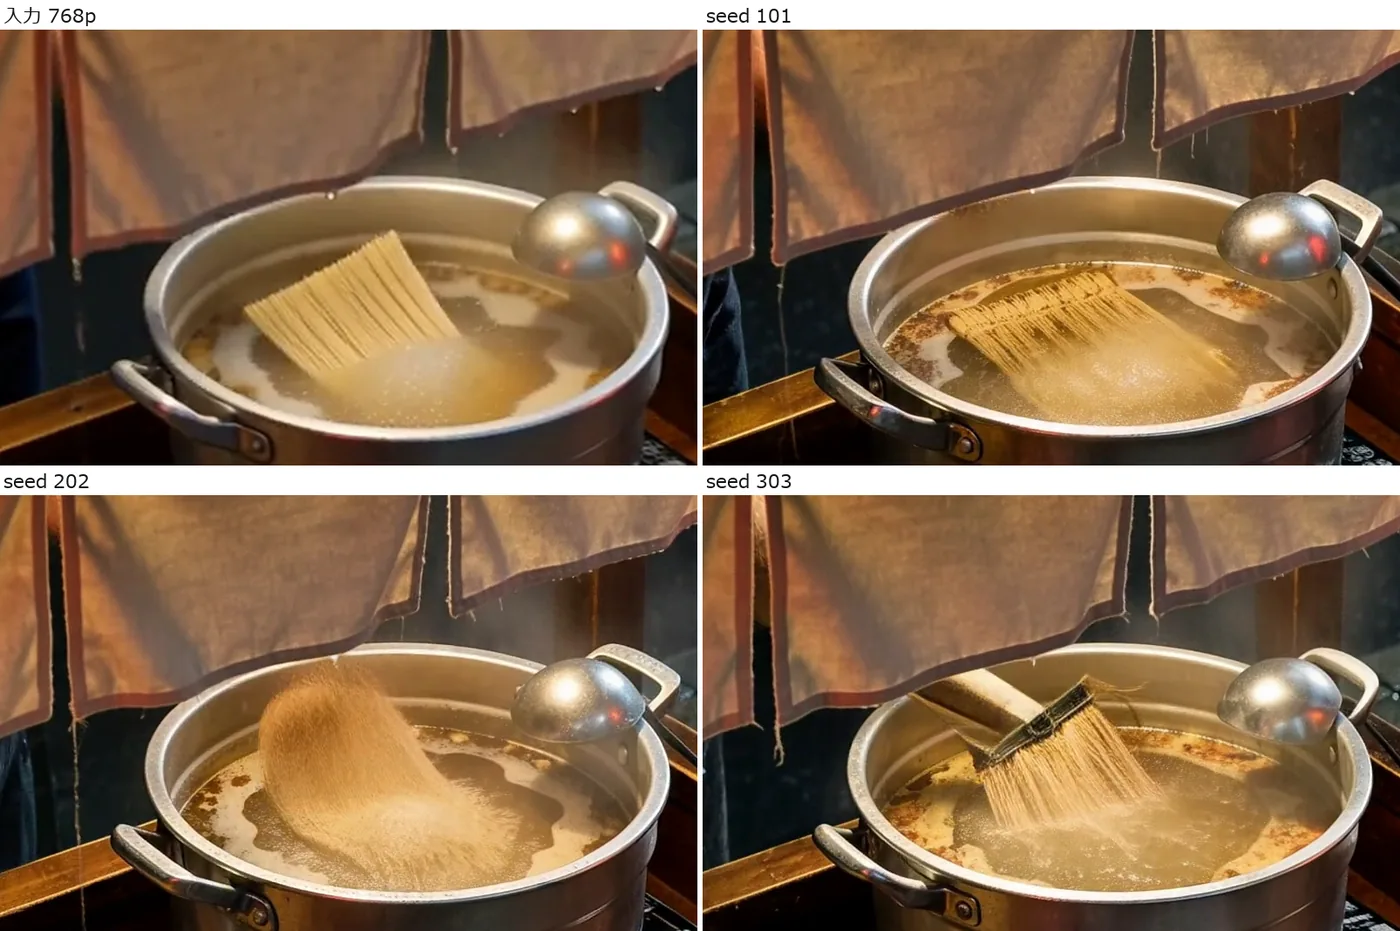
同じ入力でシードを変えると、麺は束になったり、ほうきのような形になったりしました。5シードとも形が違います。のれんや鍋の位置は保たれます。
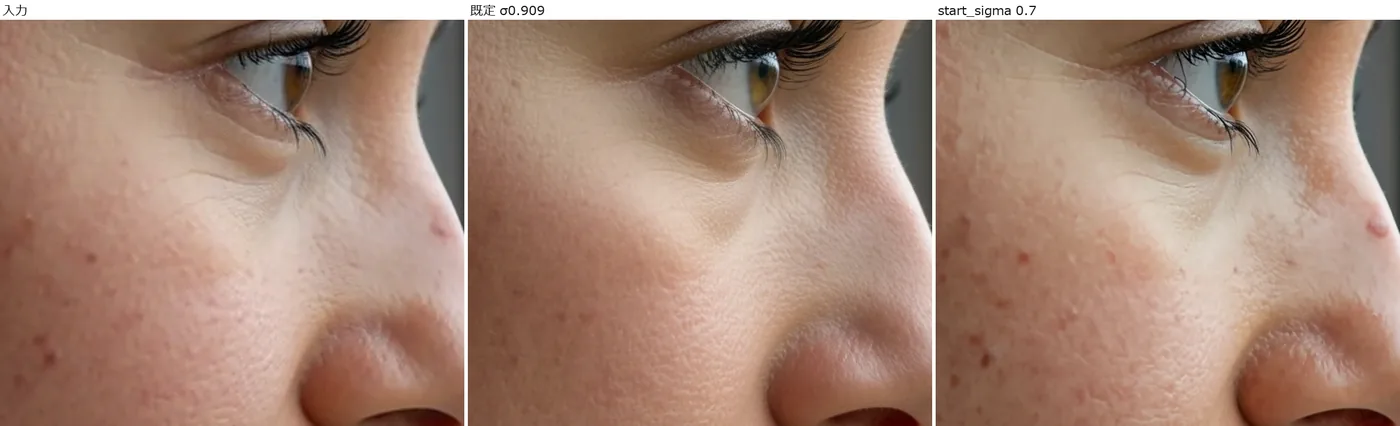
顔でも、位置や表情は同じですが、ほくろやシミの一部が消えて、肌がなめらかになりました。本人らしさを残したい映像では、確かめてから使ってください。
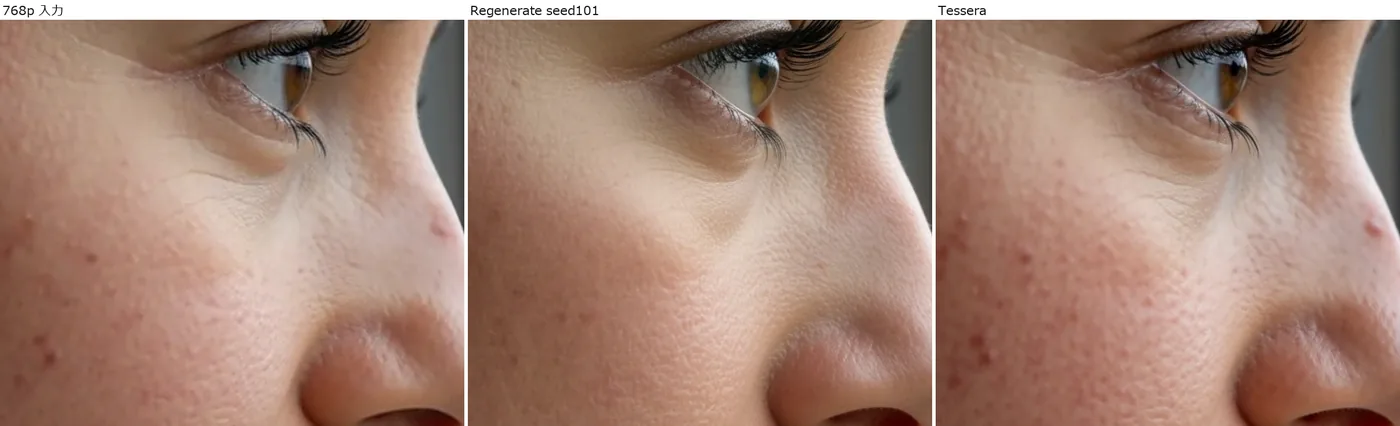
| 比較(中央値など) | Regenerate | コア2K | Tessera |
|---|---|---|---|
| ラーメン、入力との PSNR | 20.80dB | 23.49dB | 29.42dB |
| 顔、入力との PSNR | 27.89dB | – | 33.33dB |
| ラーメン、細部の量(ラプラシアン) | 157〜182 | 66 | 37 |
PSNR が低いことは、低画質という意味ではありません。入力からどれだけ変わったかの目安です。
絵を変えたくないときは start_sigma を下げる
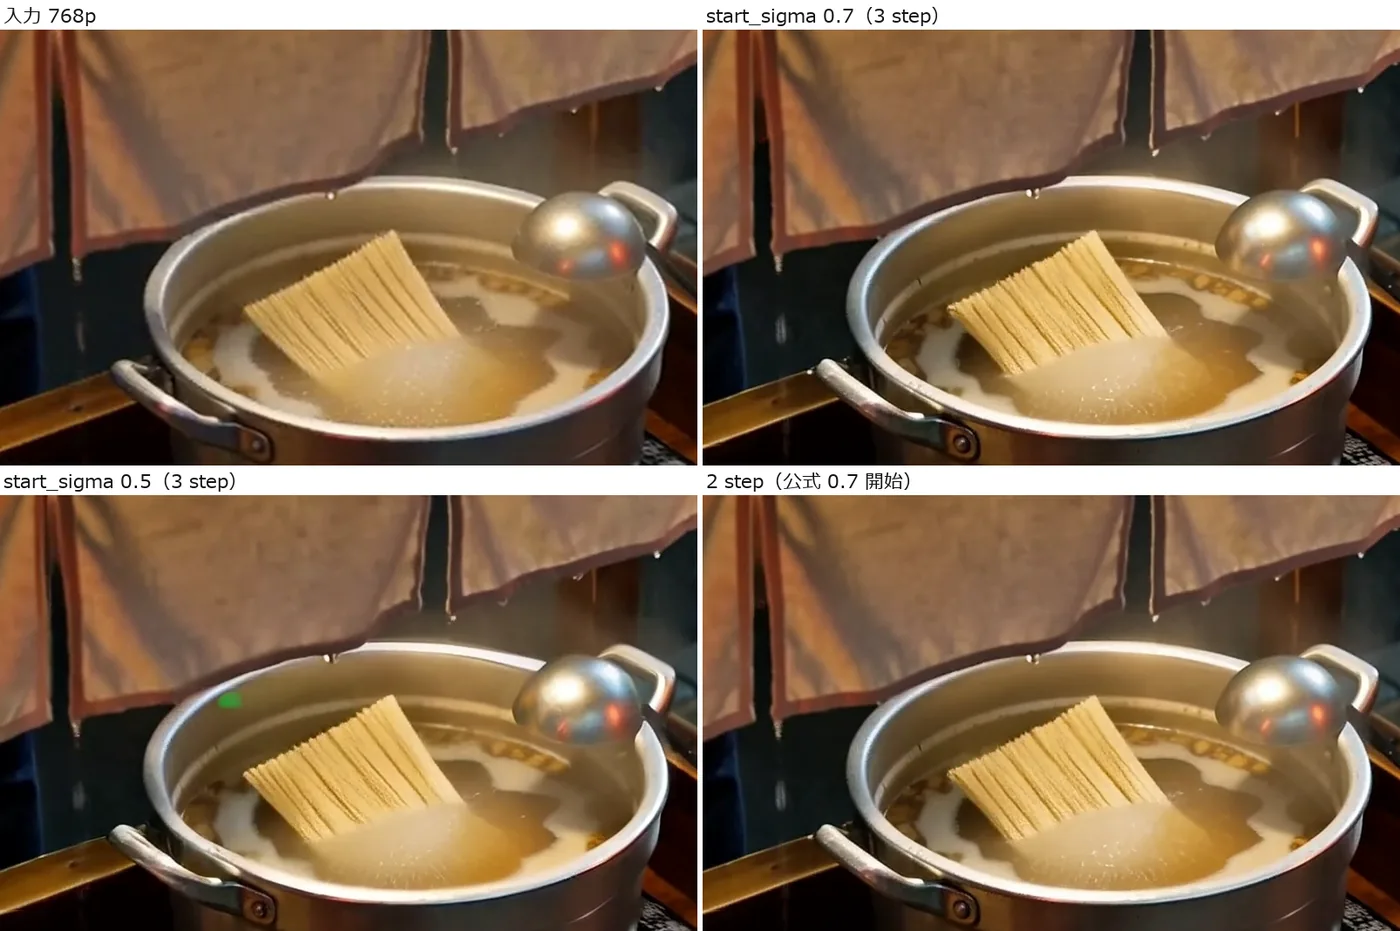
Open-H3 Regenerate · Sigmas ノードの start_sigma は、乗せ直すノイズの強さです。0 のままだと公式の 0.909 になります。下げて試しました(同じシード、ラーメン)。
| 設定 | サンプリング | 入力との PSNR | 細部の量 |
|---|---|---|---|
| 既定(σ0.909、3ステップ) | 89秒 | 20.76dB | 168 |
start_sigma 0.7、3ステップ | 439秒(起動直後の1回) | 23.92dB | 93 |
start_sigma 0.5、3ステップ | 378秒 | 24.88dB | 73 |
| 公式の2ステップ(0.7、0.494) | 154秒 | 24.24dB | 86 |
PSNR と細部の量はラーメンの値です。既定のサンプリングは5シードの中央値で、0.7 の値はモデルの読み込みを含みます(顔の読み込み後は182秒)。
0.7 で麺の形が入力に近く保たれ、顔のほくろも残りました。 細部は既定より減りますが、コア2K経路より多く出ています。
気をつける点が2つあります。
- 低いシグマは遅くなります。 読み込み後の値では、既定89秒、0.7(顔)182秒、0.5 378秒と、下げるほどサンプリングが長くなりました。Sol-Attn の
end_percent0.9 を過ぎた区間で sparse が切れて通常の計算になるためだと思いますが、確かめてはいません。 - 0.5 の1本では、鍋のふちに緑の点が出ました(上の画像)。1本だけの確認なので、原因は分かりません。
ここまでの 0.7・0.5・2ステップは各1本ずつの結果です。
Kijai 版の LoRA は使える?
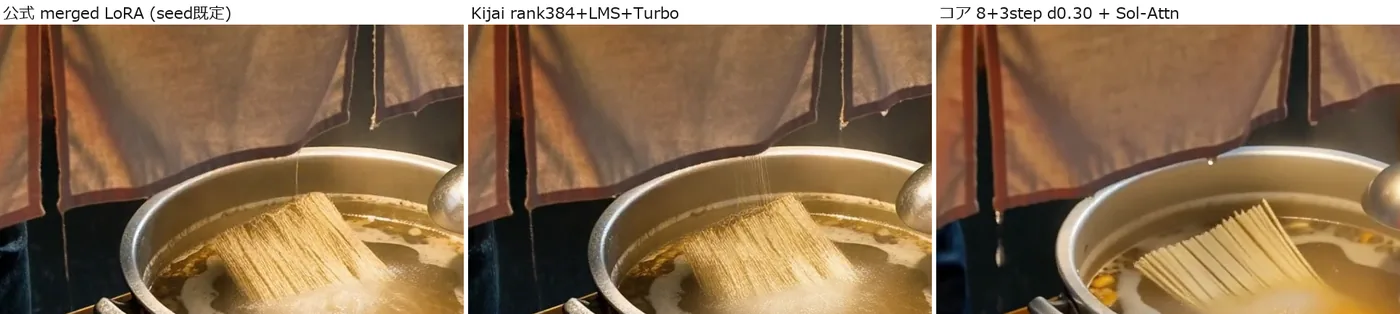
Kijai さんのrank 384 版(5.87GB)は、refiner の部分だけを変換したものです。公式の説明どおり LMS と Turbo v1.2 を普通の LoRA として重ねて試しました。
全体は236秒でした(モデルの入れ替えを含む1回)。入力との PSNR は21.0dB で、同じシードの公式の合成 LoRA と近い絵になりました。ただし Sharp の曲線の枝(sharp_curve_branches)は入っていないので、公式と同じものではありません。ファイルが小さく、カスタムノードなしで動く点は便利です。
うまくいかなかったこと
- 3840×2176:2回試して、2回とも拡大ステップは成功しましたが、その後のサンプリングの最初のステップで ComfyUI のプロセスごと落ちました(
Fatal Python error: Aborted、comfy_kitchen の int8 処理の中)。直前の VRAM は 32GB 近くでした。私は1回で 4K へ拡大しました。ノードの2回に分ける経路や、ほかの設定は試していません。 - 15秒の下書き→2K:VRAM 32GB から溢れ、1ステップ約1.5時間になりました。3ステップ中2ステップ終わった3時間5分の時点で打ち切りました。公式は 5〜15秒対応としていますが、32GB の環境で今回の設定では無理でした。
- 音声:処理中は無音で固定し、最後に元の音を付けます。出力の音は入力とほぼ同じでした(相関0.999)。音を作り直したいなら別の工程が要ります。
RTX 5090 以外の人へ
--reserve-vram は、OS などのために VRAM を残しておく設定です。
--reserve-vram | 結果 | 全体(読み込み込み) | サンプリング | デコード | VRAM |
|---|---|---|---|---|---|
| 20(12GB を想定) | 成功 | 397秒 | 160秒 | 118秒 | ピーク 24.2GB(開始時からの増加 約22.9GB) |
| 24(8GB を想定) | 成功 | 610秒 | 162秒 | 119秒 | ピーク 24.2GB(開始時からの増加 約22.9GB) |
全体とサンプリング+デコードの差は、20 が約119秒(テキスト約81秒、エンコード約16秒など)、24 が約329秒(LoRA の読み込み約270秒、テキスト約23秒、エンコード約16秒など)です。
サンプリングは VRAM を減らしても動きましたが、高速 VAE のデコードでどちらも約24GB まで上がりました。--reserve-vram の値より多く使っています。ノードの作者も「5秒の 2K で約21GB」と説明しているので、24GB 未満の GPU では標準 VAE に切り替えるのが安全そうです。実際の小さい GPU で試したわけではありません。
VRAM 容量が少ない環境を想定した簡易テストです。実際の 8GB・12GB 搭載 GPU での動作を再現・保証するものではありません。 VRAM 不足の対処はこちらにまとめています。
ライセンスと商用利用
原文を確かめた範囲です(2026年11月3日時点)。
- LoRA・高速 VAE・base_model:MiniMax H3 Community Licenseに従います。適用範囲は EU・英国・韓国・米国を除く地域です。
- 合成に使われた部品:カードに「一括のライセンスではない」と明記があります。アップスケーラー、LightX2V Turbo、LMS Sharp はそれぞれの条件に従います。
- ComfyUI ノード:Apache-2.0 です。NVIDIA のコードの一部(高速 VAE のデコーダー)を同梱しています。
再配布には H3 ライセンスの条件が及びます。この記事ではモデルを再配布せず、公式の場所へリンクしています。
よくある質問(FAQ)
Q. Open-H3-Regenerate-2K は NVIDIA 公式の ComfyUI ノードですか?
いいえ。LoRA と推論コードは NVlabs の公開で、ComfyUI ノードは rdh9616 さんなど個人の作品です。
Q. 元の動画はそのまま残りますか?
大きく描き直されます。今回は麺の形がシードごとに別物になり、顔のほくろも一部消えました。元の絵を守りたいなら Tessera が向きます。
Q. VRAM はどのくらい必要ですか?
RTX 5090 で31GB 台まで使いましたが、空きを使い切った値です。--reserve-vram の簡易テストでも、高速 VAE のデコードで約24GB まで上がりました。実際の 8GB・12GB GPU での動作は確かめていません。
Q. Sol-Attn を切っても動きますか?
動きますが、約3倍の時間がかかりました(ノード既定133秒に対して401秒)。
Q. MiniMax H3 以外の動画にも使えますか?
ノードの README は、LTX や Wan の 384〜576p の下書きにも使えると説明しています。私は H3 の動画でしか試していません。
まとめ
- 2K が約2分と速く、細部もよく出ます。
- 絵はかなり変わるので、完成した映像の高解像度化より「下書きを仕上げる」使い方に向きます。
- Sol-Attn の効果が大きく、コアの 2K 経路にも流用できます。
検証メモ
- 設定の違い:表の「強め」は私が最初に試した τ1.75・全区間 sparse です。ノード同梱の JSON は τ1.2・
end_percent0.9・dense_blocks0,1,49 で、こちらを「ノード既定」と呼んでいます。ノードの JSON は映像 VAE に fp16 を使いますが、私は int8 です。 - 時間のばらつき:5シードの「全体」は 114〜133秒です。最初の1本はエンコードがキャッシュされて短くなりました。
- 全体の内訳:ノード既定の133秒(シード202)は、サンプリング88.8秒、デコード19.4秒、エンコード12.6秒、保存5.9秒、テキスト2.5秒、拡大1.5秒などです。強めの86秒は、サンプリング57.2秒、デコード20.0秒、保存5.8秒、テキスト2.8秒などで、エンコードは前の実行のキャッシュです。ノード既定と強めの差には、このエンコードの約13秒も含まれます。
- コア2K経路の内訳:Sol-Attn なしの503秒は、1段目98.8秒、拡大1.5秒、再サンプリング387秒、Sol int8 デコード7.2秒、そのほか約9秒です。Sol-Attn ありの242秒は、1段目113秒、拡大1.5秒、再サンプリング88秒、デコード21.7秒、そのほか約18秒です。Sol-Attn は再サンプリングだけに掛けています。1段目とデコードが長くなった理由は未確認です。
--reserve-vramの差:24 だけ LoRA の読み込みが約270秒かかった理由(20 は約3秒)と、20 だけテキストが約81秒かかった理由は未確認です。- PSNR の測り方:入力を lanczos で同じサイズにした絵と、12フレームおきに比べた平均です。コア2K経路の 23.49dB は Sol-Attn なし、23.41dB は Sol-Attn ありの実行です。
- 未確認のこと:
start_sigmaの複数シードでの傾向、動画を再生したときのちらつき、音の聞き比べ、ノードの LBH 拡大、実際の 8GB・12GB GPU、Video to H3 Prompt ノード。 - 公開日:Hugging Face の Open-H3-Regenerate-2K は 2026年10月26日、単体 LoRA は 11月2日に作成されています。