この記事について(広告・アフィリエイトリンクはありません)
紹介しているソフトとモデルは、すべて無料で入手できるものです。
Pika H3 Flex は H3 を6ステップで動かせる LoRA でした。Pika-H3-Flex-Turbo-LoRA は、それにステップ数を減らす別の LoRA を重ね、1ファイルにしたものです。2026年10月29日に Hugging Face で公開されました。ステップとは、絵を少しずつ描き進める回数です。
公式の Flex 6ステップと同じプロンプト・シードで、2・4・8ステップを RTX 5090 で測りました。選ぶなら4ステップで、78秒が54秒に縮みました。
迷ったら4ステップ(今回のテスト条件で)
| 条件(1344×768・5秒・124フレーム) | 全体(読み込み後) | サンプリング | 「できました」の聞き取り |
|---|---|---|---|
| 公式 Flex、6ステップ(比較の基準) | 78秒 | 71秒 | 5本中5本 |
| Turbo 2ステップ(Ref2VA) | 32〜47秒 | 25秒 | 5本中4本 |
| Turbo 4ステップ(FL2VA) | 54秒 | 47秒 | 5本中5本 |
| Turbo 8ステップ HD(FL2VA) | 102秒 | 94秒 | 5本中5本 |
- 迷ったら 4ステップです。公式 Flex より約31%短くなり、今回の中央フレームの絵は崩れませんでした。
- 2ステップは下書き用です。シードごとの構図の確認に向きます。(Ref2VA の使い方はMiniMax H3 の使い方とコツ)
- 8ステップは公式 Flex より遅くなります。細部を詰めたいときの選択肢です。
1ステップの時間は、どれも約12秒で同じでした。速さの差は、ステップ数の差です。
試した環境
| 項目 | 内容 |
|---|---|
| GPU | RTX 5090(32GB)、ドライバー 621.01 |
| CPU / RAM | Ryzen 9 9950X3D / 128GB |
| OS | Windows 11 |
| ComfyUI | ポータブル版+master 17ff1dcc(v0.43.0-26)。カスタムノードなし |
| ベース | H3 fl2va pruned int8(2ステップだけ ref2va pruned int8)、qwen3vl nvfp4、映像 VAE int8、音声 VAE fp32 |
| プロンプト | Pika 記事と同じ陶芸家の場面。最後に「できました。」と話す |
| シード | 20261102〜20261106 の5本 |
入れ方は LoRA を1つ足すだけ
ComfyUI で H3 が動く状態で、LoRA を1つ足すだけです。
| ファイル | サイズ | 用途 |
|---|---|---|
| pika_h3_flex_turbo_4step_fl2va.safetensors | 3.9GB | まずはこれ |
| pika_h3_flex_turbo_8step_hd_fl2va.safetensors | 3.9GB | 細部を詰めたいとき |
| pika_h3_flex_turbo_2step_draft_ref2va.safetensors | 3.9GB | 下書き。Ref2VA 用 |
どれも models\loras に置きます。ノードの設定は次のとおりです。
| 項目 | 値 |
|---|---|
| LoRA ローダー | 強さ 1.0 |
MiniMax H3 Sigma Shift | 映像 6.0(Ref2VA は 12.0)、音声 3.0 |
| スケジューラー | simple。ステップ数はファイルに合わせる |
| サンプラー | euler(カードでは euler / lcm / res_multistep) |
| CFG | 1(BasicGuider を使うので設定なし) |
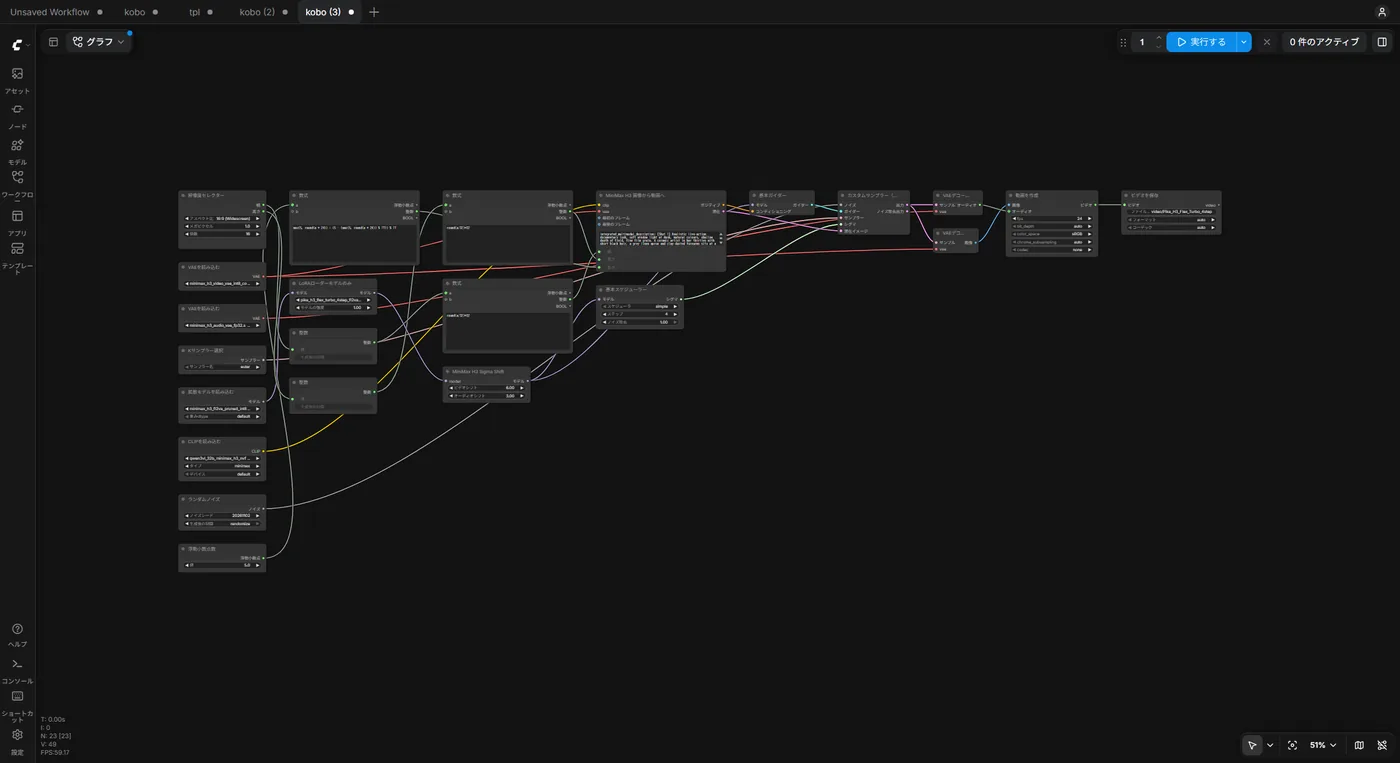
- pika_h3_flex_turbo_4step_workflow.jsonComfyUI にドラッグして読み込みます(FL2VA + 4ステップの Turbo LoRA、1344×768、5秒。カスタムノードは不要です)
画面から実行して、成功を確かめました。ログで 197.42秒です。直前の実行とベースのモデルが違うので、FL2VA を USB の HDD から読み直しています。サンプラーの1ステップ目(Model Initializing を含む)が約150秒、残り3ステップが約40秒、デコードと保存などが約8秒です(細かい内訳は記録していません)。
4ステップの54秒のうち、47秒はサンプリング
全体は、サンプリング、デコード、保存を合わせた時間です。プロンプトと LoRA が同じ2本目以降の値で、1本目はモデルの読み込みで長くなります。
| 条件 | 1本目 | 2本目以降 | サンプリング | 映像デコード |
|---|---|---|---|---|
| 公式 Flex 6ステップ | 152秒 | 77〜79秒 | 71秒 | 4.7秒 |
| Turbo 2ステップ | 401秒 | 47、32、34、34秒 | 25秒 | 4.8秒 |
| Turbo 4ステップ | 77秒 | 54秒 | 47秒 | 4.7秒 |
| Turbo 8ステップ | 135秒 | 101〜102秒 | 94秒 | 4.7秒 |
2ステップのサンプリング25秒は、全体が32〜34秒だった回の値です。47秒かかった2本目は 39.36秒でした。
Turbo 4ステップの2本目以降の54秒は、サンプリング 47.1秒、映像デコード 4.7秒、保存 2.0秒、その他 約0.2秒です。1本目の77秒は、ベースのモデルを読み込んだあとの実行です(サンプリング 69.9秒、映像デコード 4.7秒、保存 2.1秒)。上の197秒のようなモデルの読み直しは入っていません。サンプリングが2本目より約23秒長い理由は確かめていません。
2ステップの1本目が長いのは、ベースが FL2VA から Ref2VA に変わり、HDD から読み直したためです。
ベースを切り替えずに済むので、普段は 4ステップと 8ステップを同じ FL2VA で使うのが楽です。
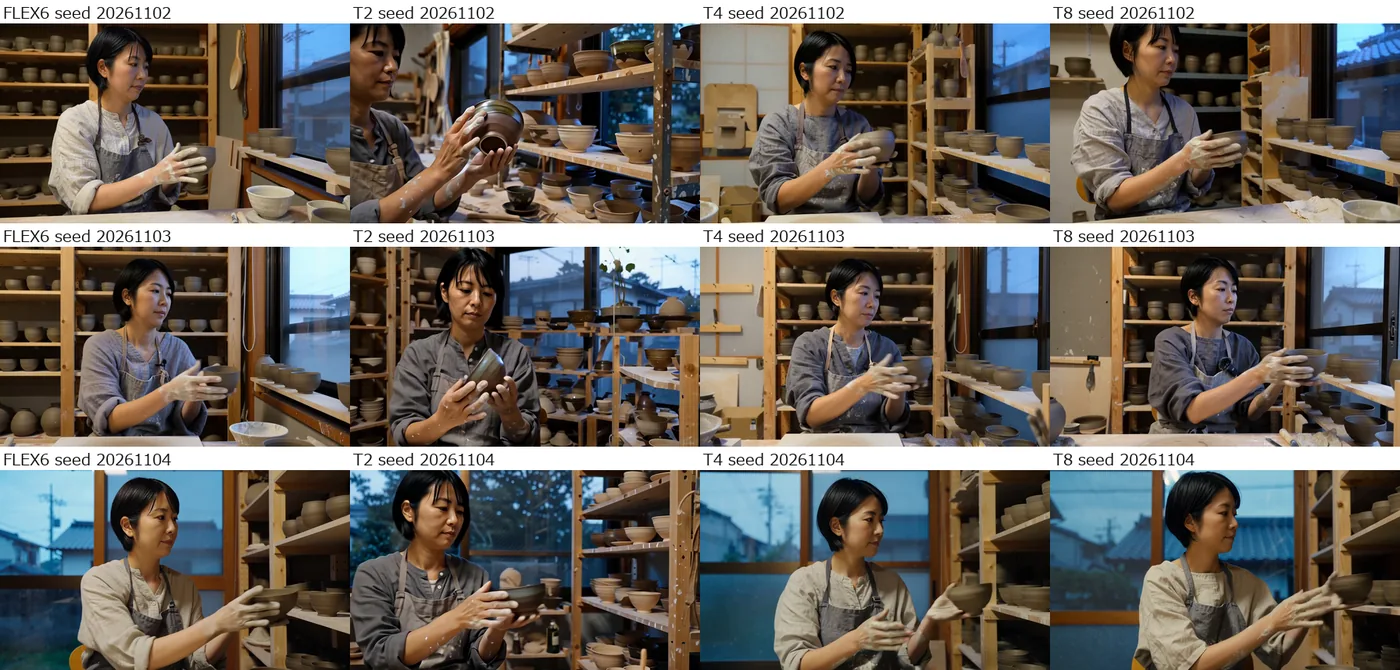
絵は公式に近く、聞き取りで外れたのは2ステップの1本
中央フレームを3シードで見比べました(上の画像)。
- 4ステップと8ステップ:同じシードの公式 Flex と、人物や棚の配置がよく似ています。8ステップのほうが細部が少し多い印象です。これは1フレームの目視です。
- 2ステップ:ベースが Ref2VA で、構図が大きく変わります。今回は崩れた絵はありませんでしたが、カードは「ときどきシーンが崩れる下書き用」としています。
音声は、話している「できました」を Whisper(base、CPU)で文字起こしして確かめました。4ステップと8ステップ、公式 Flex は5本すべてで読み取れた一方、2ステップは1本だけ「プレイパクラン出来ました」と余計な語が入りました。カードにも「6ステップ未満で音声が劣化し、2ステップが最も弱い」とあります。
文字起こしで分かるのは言葉の聞き取りだけで、音質は耳で確かめていません。
RTX 5090 以外の人へ
--reserve-vram は、OS などのために VRAM を残しておく設定です。4ステップで試しました。
--reserve-vram | 結果 | 2本目の全体 | VRAM ピーク |
|---|---|---|---|
| 指定なし | 5本とも成功 | 54秒 | 29.7〜30.3GB |
| 20(計算上の残り 約12.1GB) | 2本とも成功 | 57秒 | 14.2〜14.4GB |
| 24(計算上の残り 約8.0GB) | 2本とも成功 | 57秒 | 10.2〜10.5GB |
VRAM 容量が少ない環境を想定した簡易テストです。実際の 8GB・12GB 搭載 GPU での動作を再現・保証するものではありません。 VRAM のピークには、計測時に他のアプリが使っていた分も含みます。この範囲では、時間はほとんど変わりませんでした。VRAM 不足の対処はこちらにまとめています。
商用で使うときの条件は?
原文を確かめた範囲です(2026年11月4日時点)。
- LoRA:カードに「MiniMax H3 Community License の Model Derivative(Section III.2)」と書かれています。適用範囲は EU・英国・韓国・米国を除く地域で、年商2,000万ドルを超える事業者は別途の許諾が必要です。
- 元の部品:Pika / Mellis, Inc. の Flex、LightX2V の Turbo、pDMD の2ステップ(Apache 2.0)の組み合わせで、カードに名前の表示があります。
- 再配布:H3 ライセンスの条件が及びます。この記事ではモデルを再配布せず、公式の場所へリンクしています。
よくある質問(FAQ)
Q. Pika-H3-Flex-Turbo-LoRA は公式の Flex より速いですか?
4ステップは速いです。同じ環境で公式 Flex 6ステップの78秒に対して54秒でした。8ステップは102秒で、公式より遅くなりました。
Q. 何ステップがおすすめですか?
最初は4ステップです。2ステップは下書き、8ステップは細部を詰めたいときに使います。
Q. カスタムノードは必要ですか?
不要です。ComfyUI 標準の LoRA ローダーと MiniMax H3 Sigma Shift で動きました。
Q. 音声は使えますか?
「できました」の文字起こしは、4ステップと8ステップで5本中5本、2ステップで5本中4本読み取れました。音質は耳で確かめていません。
Q. VRAM はどのくらい必要ですか?
RTX 5090 では空きを使い切って約30GB まで使いました。--reserve-vram 24 の簡易テストではピーク約10.5GB で成功しましたが、実際の 8GB GPU での動作は確かめていません。
Q. 軽い Lite 版はありますか?
rank 32 で約0.31GB の版がカードにあります。私は試していません。
まとめ
- 4ステップの Turbo が、速さと崩れにくさのバランスが良い結果でした(今回の条件で)。
- 1ステップの時間は同じなので、短縮はステップ数の分だけです。
- 2ステップは構図を探す下書きとして使えます。
検証メモ
- 公式 Flex の値:同じプロンプトで前回の Pika 記事は86.9秒(v0.43.2)でした。今回は master で78秒です。比較は今回の値どうしで行いました。
- 2ステップの条件:カードに従い Ref2VA と
MiniMaxH3ReferenceToVideo(参照なし)で動かしました。ほかの3条件とベースが違うので、絵の比較は厳密には同じ条件ではありません。 - シグマ:Turbo は
BasicScheduler(simple)+ Sigma Shift、公式 Flex はテンプレートのシグマ表です。 - カードの値:H200 で4ステップ40秒、2ステップ約25秒、8ステップ70秒(848×480)は作者の値で、私は測っていません。
- 未確認のこと:動画を再生したときの動きの比較、音質、Singularity との組み合わせ、Lite 版、Ref2VA の 4・8ステップ、実際の 8GB・12GB GPU。