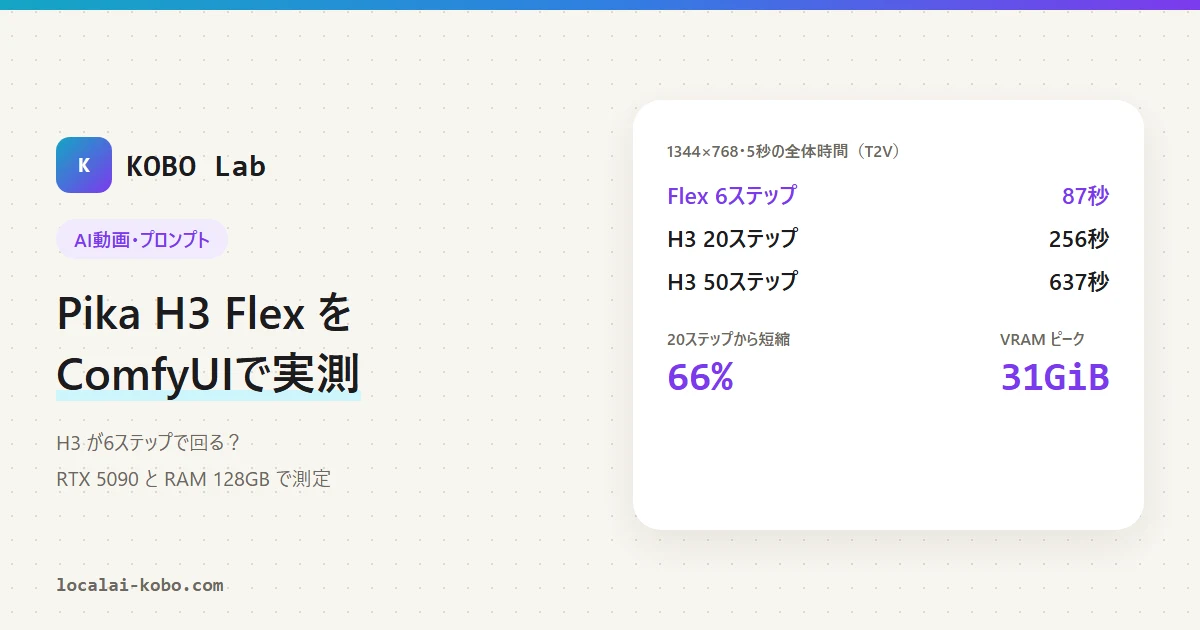
MiniMax H3 は、文章や画像から音声つきの動画を作れる大きな動画生成モデルです。ふつうは 20〜50 ステップ(計算の回数)かかります。Pika H3 Flex は、これを 6ステップ で作れるようにした Pika の公式 LoRA(元のモデルに足して使う学習ファイル)です。
この記事では ComfyUI の公式テンプレートを設定を変えずに使い、RTX 5090(VRAM 32GB)で 44 本の動画を作って、時間・VRAM・画質・音声を測りました。
Pika H3 Flex でできること
ComfyUI のテンプレートは3種類あります。どれも MiniMax H3 の本体に LoRA を1つ足すだけで、カスタムノード(追加プログラム)は要りません。迷ったら、まずテキストから動画を試してください。
| テンプレートと要求バージョン(Comfy 公式) | 入力 | 向いていること |
|---|---|---|
video_pika_h3_flex_t2v0.43.2 以上 | 文章だけ | 最初の1本、声や効果音も文章で指定 |
video_pika_h3_flex_ref2va0.30.0 以上 | 文章+参照画像 | 同じ人物・衣装で別の場面を作る |
video_pika_h3_flex_fl2va0.30.0 以上 | 文章+最初と最後のコマ | 始まりと終わりの絵を決めてつなぐ |
テキストから動画(T2V)
文章だけで、陶芸家が器を棚に置いて「できました。」と言う場面を作りました。
参照から動画(Ref2VA)の使い方
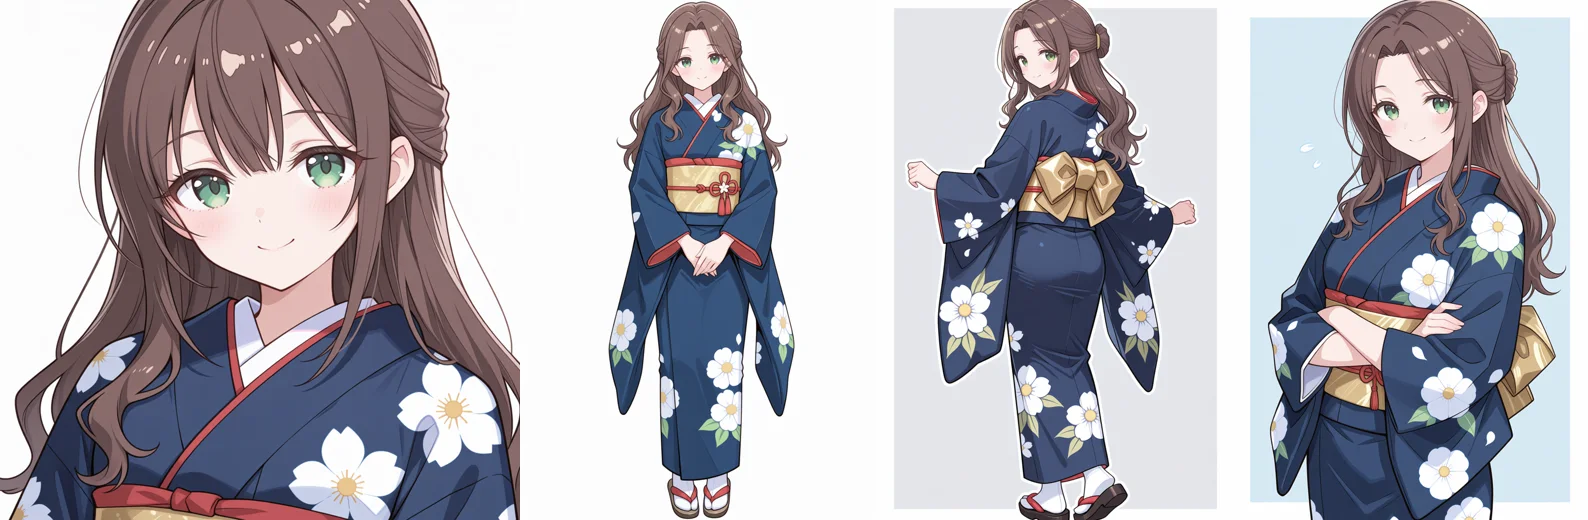
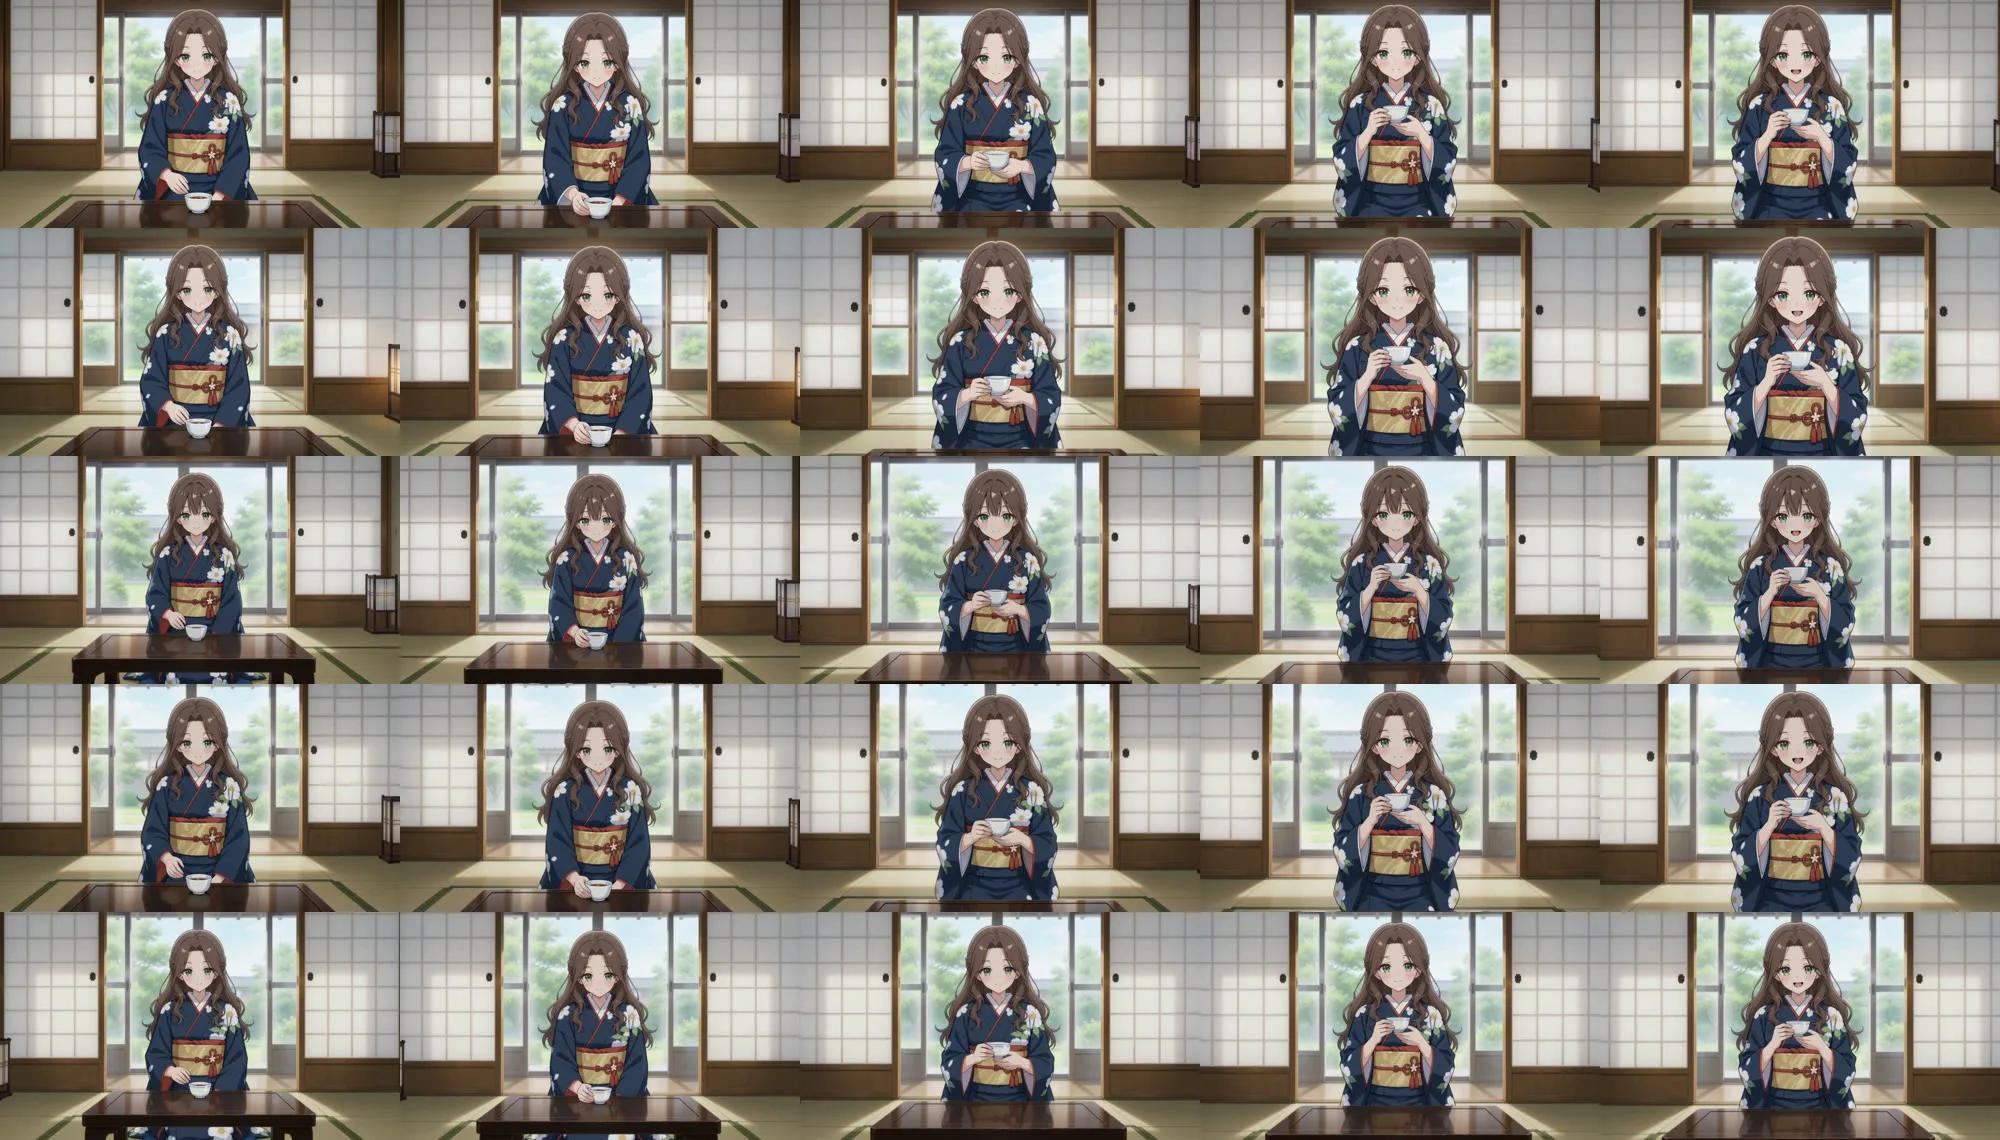
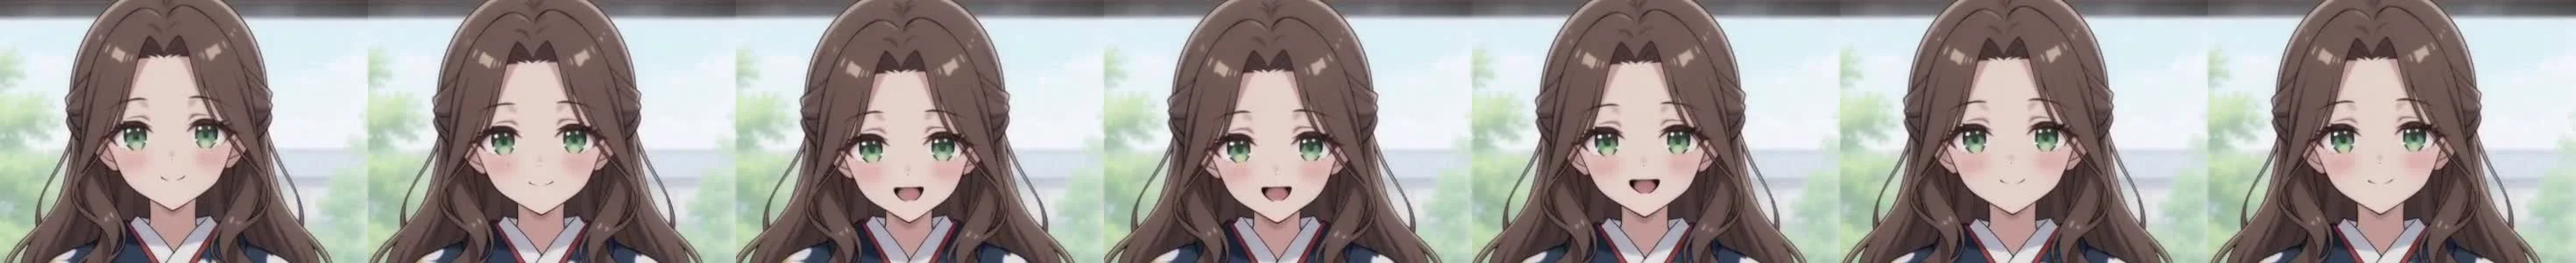
「H3 Ref2VA」は、参照画像の人物や衣装を保ったまま、文章で書いた場面を作る使い方です。今回は自作キャラの神楽坂すずの画像を4枚(顔、全身の正面、後ろ姿、腰から上)入れました。
使い方は次の3手順です。
- テンプレートの
LoadImageに参照画像を読み込みます。3枚目以降はMiniMaxH3ReferenceToVideoのref_image_2以降につなぎます。 - プロンプトで、画像を
<Picture 1>、人物を<Subject 1>のように呼びます。 subject_definitions、summary、retention_analysis、detailed_description、overall_soundscape、non_diegetic_musicの順に書きます(Comfy 公式の説明)。
シードを5つ変えても、顔、茶色の長い髪、緑の目、紺の着物、白い花、金の帯は保たれました。帯の飾りなど細部は変わる場合があります(失敗の表を参照)。部屋の様子はシードごとに変わります。
最初と最後のコマから動画(FL2VA)
Ref2VA の動画から取った2枚のコマを、最初と最後に指定しました。テンプレートは最初のコマのサイズに合わせて動画を作るので、1344×768 で作りたいときは同じサイズの画像を入れます。
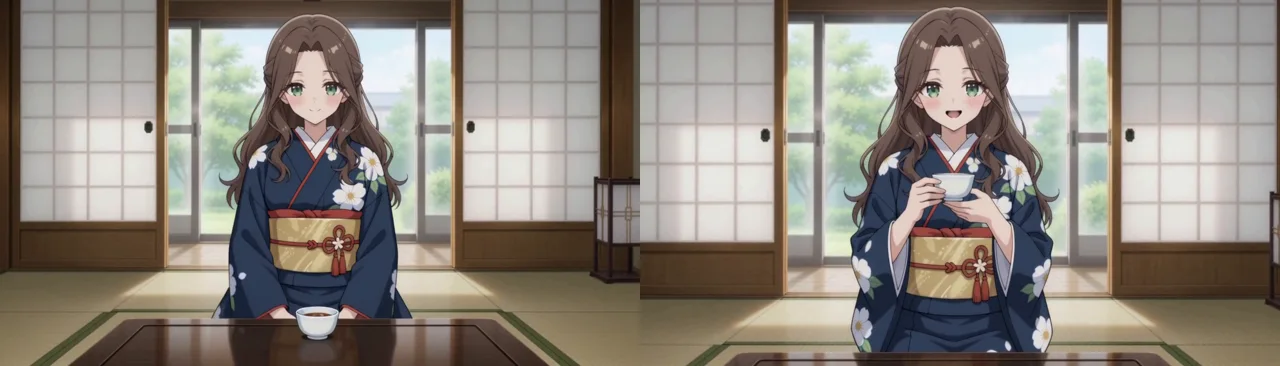
生成した動画の最初と最後のコマは、入れた画像とよく一致しました(PSNR 約40dB、2シード)。
必要なファイルと置き場所
ファイルはすべて Comfy-Org の Hugging Face にあります。下の組み合わせが、テンプレートの指定と今回使った構成です。本体はフル版(bf16)ではなく、軽い int8 の pruned 版です。H3 本体の導入は導入編にまとめています。
| ファイル(クリックで配布ページ)と置き場所 | サイズ | 使う場面 |
|---|---|---|
| minimax_h3_fl2va_pruned_int8_convrot.safetensors 置き場所:ComfyUI/models/diffusion_models | 20.97GB | T2V・FL2VA |
| minimax_h3_ref2va_pruned_int8_convrot.safetensors 置き場所:ComfyUI/models/diffusion_models | 20.97GB | Ref2VA |
| pika_h3_flex_fl2va_v1_bf16.safetensors 置き場所:ComfyUI/models/loras | 1.96GB | T2V・FL2VA |
| pika_h3_flex_ref2va_v1_bf16.safetensors 置き場所:ComfyUI/models/loras | 1.96GB | Ref2VA |
| qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors 置き場所:ComfyUI/models/text_encoders | 15.69GB | 共通 |
| minimax_h3_video_vae_int8_convrot.safetensors 置き場所:ComfyUI/models/vae | 2.81GB | 共通 |
| minimax_h3_audio_vae_fp32.safetensors 置き場所:ComfyUI/models/vae | 0.61GB | 共通 |
テキストから動画だけなら一式で約42GB、3種類とも使うなら約65GB です。モデルの置き方は ComfyUI の入れ方、更新は ComfyUI のアップデート方法 を見てください。
ワークフローの設定とダウンロード
テンプレートを開くと、最初から次の設定になっています。今回は3種類とも、数値を変えずに使いました。
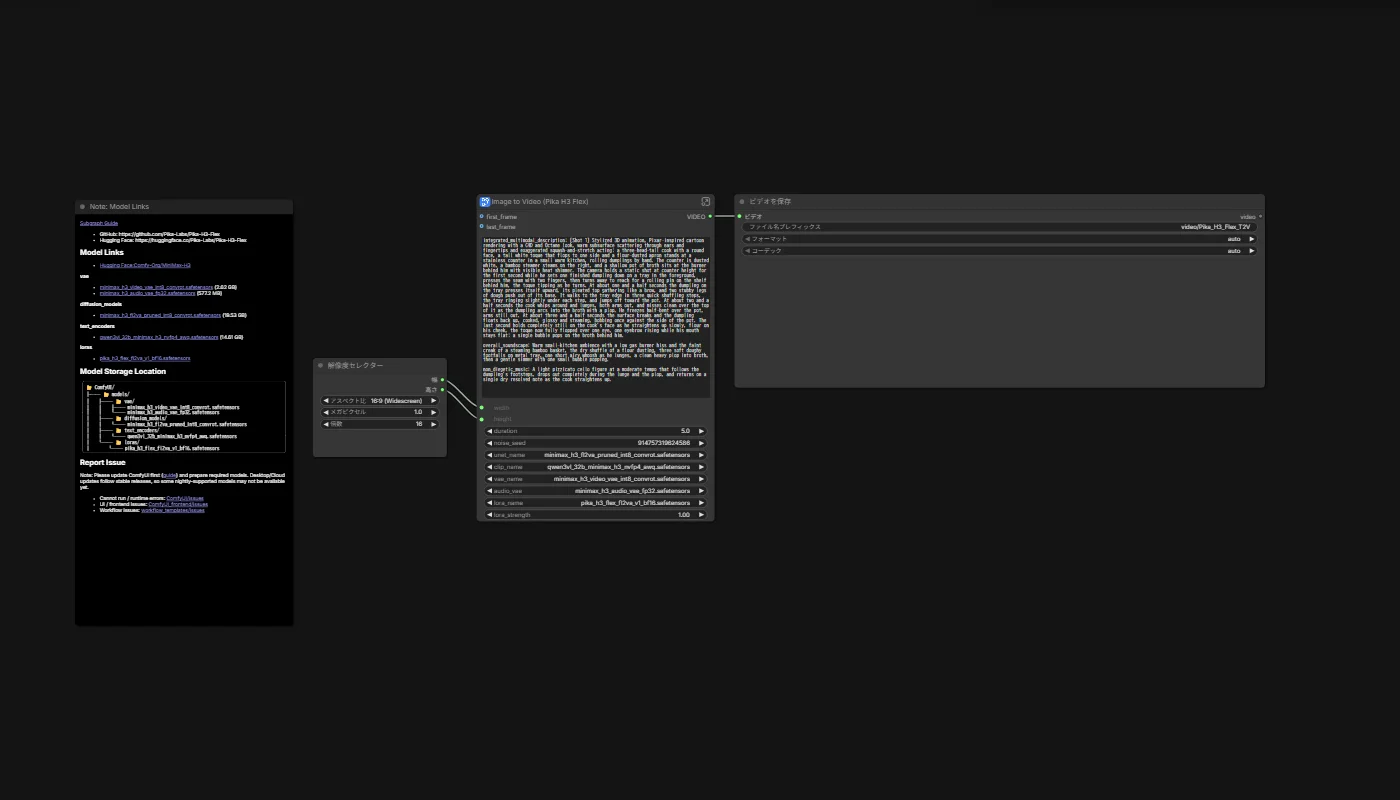
| 項目 | 既定値 | 意味 |
|---|---|---|
| 解像度 | T2V・Ref2VA は 1344×768。FL2VA は最初のコマに合わせる | 16:9・0.98MP の指定から決まる |
| 長さ | 5秒(124フレーム、24fps) | 「17の倍数+5」に切り上げ。実際は約5.17秒 |
| ステップ | 6 | 下のシグマの数で決まる |
| シグマ | ManualSigmas:1.0, 0.972973, 0.923077, 0.8, 0.571429, 0.333333, 0.0 | 各ステップのノイズの量 |
| サンプラー | lcm | 少ないステップ向けの計算方法 |
| CFG | 1.0(BasicGuider) | ネガティブプロンプトは使わない |
| LoRA の強度 | 1.0(LoraLoaderModelOnly) | モデルにだけ LoRA をかける |
- Pika H3 Flex テキストから動画(.json)ComfyUI 0.43.2 以上
- Pika H3 Flex 参照から動画(.json)ComfyUI 0.30.0 以上
- Pika H3 Flex 最初と最後のコマから動画(.json)ComfyUI 0.30.0 以上
3つとも ComfyUI の公式テンプレートと同じものです。画面にドラッグすると読み込めます。テンプレートのシードは毎回変わる設定(randomize)です。
RTX 5090 での生成時間(実測)
時間は、ComfyUI に送ってから動画が保存されるまでの全体です。サンプリングは、そのうちの絵を作る計算の時間です。「1行=1回の生成」で書きます。下の表はすべて 1344×768・5秒で、「計算」はサンプリングの時間です。
| 条件と所見 | 全体(秒) | 計算(秒) | VRAM(GiB) |
|---|---|---|---|
| T2V 陶芸家が器を棚へ シード 20261102・6ステップ 2回目。最初の1回と映像が完全に一致 | 86.9 | 76.0 | 30.4 |
| T2V 同上 シード 20261103・6ステップ シードだけ変更 | 104.2 | 76.2 | 30.5 |
| T2V(H3・LoRA なし) 同上 シード 20261102・20ステップ 20ステップ。頭が枠の上で切れた | 259.5 | 250.2 | 30.4 |
| T2V(H3・LoRA なし) 同上 シード 20261102・50ステップ 50ステップ。1回だけ | 636.9 | 626.8 | 30.3 |
| Ref2VA すずがカップを持つ(参照4枚) シード 20261102・6ステップ 2回目。最初の1回と映像が完全に一致 | 114.2 | 106.6 | 30.8 |
| Ref2VA 同上 シード 20261103・6ステップ 人物・衣装を維持 | 116.1 | 108.3 | 30.9 |
| FL2VA 同じ場面の始点と終点をつなぐ シード 20261102・6ステップ 2回目。最初の1回と映像が完全に一致 | 96.7 | 89.3 | 30.5 |
| FL2VA 同上 シード 20261103・6ステップ シードだけ変更 | 112.8 | 105.6 | 30.6 |
同じプロンプト・同じシードで2回作ると、T2V・Ref2VA・FL2VA のどれも、映像のハッシュ(中身の指紋)まで同じになりました。
公式の説明には「5秒の 1344×768 が1枚のカードで約1分」とあります。今回の約87秒は、それより長い結果です。ただ、公式はカードの名前も、どこからどこまでの時間かも書いていないので、単純には比べられません。
解像度と長さを変えたとき(T2V)
| 解像度・長さ | 全体(秒) | 計算(秒) | VRAM(GiB) | RAM(GiB) |
|---|---|---|---|---|
| 864×480 5秒(124コマ) | 22.1 | 18.0 | 30.4 | 43.9 |
| 864×480 15秒(362コマ) | 111.8 | 100.5 | 30.4 | 44.8 |
| 1344×768 5秒(124コマ) | 82.9 | 74.7 | 30.8 | 44.6 |
| 1344×768 10秒(243コマ) | 263.5 | 249.0 | 30.5 | 46.1 |
| 1344×768 15秒(362コマ) | 547.2 | 525.9 | 30.9 | 47.5 |
各条件2回ずつ作り、シードを変えた2回目の値を載せました(768p・5秒は別の回の値)。5秒の 768p は 480p の約3.8倍かかります。長さを3倍の15秒にすると、768p では約6.6倍かかりました。
待ち時間が伸びる場面
- モデルの切り替え:T2V と Ref2VA を行き来すると、切り替え後の最初の1本は 342〜444秒かかりました。ログの
Model Initializing(モデルの準備)だけで約3.5〜5.5分でした。 - プロンプトの変更:4回中3回は 83〜90秒でほぼ増えません。ただ1回だけ、準備に約80秒かかり 157秒になりました。原因はわかっていません。
- 再起動直後の1本目:T2V の最初の1本は 144秒でした。Windows がファイルを覚えている状態の値です。2026年10月31日に別のコミットで測ったときは、読み込みに時間がかかり 768p・5秒で 529秒でした。
LoRA なしの H3 と比べた結果(時間と画質)
同じプロンプト、同じ解像度と長さで、LoRA を外した H3 と比べました。設定は公式 H3 テンプレートの Turbo オフと同じ res_multistep・simple です。シードは5つ変えました。
| 条件(本数) | 全体の中央値(秒) | 計算の中央値(秒) | Flex の短縮率(全体) |
|---|---|---|---|
| Pika H3 Flex・6ステップ(5本) | 86.9 | 76.03 | — |
| H3・20ステップ(5本) | 255.8 | 248.11 | 66% |
| H3・50ステップ(1本) | 636.9 | 626.82 | 86% |
1ステップの時間はどれも約12.5秒でした。短くなった分は、ほぼステップ数の差です。
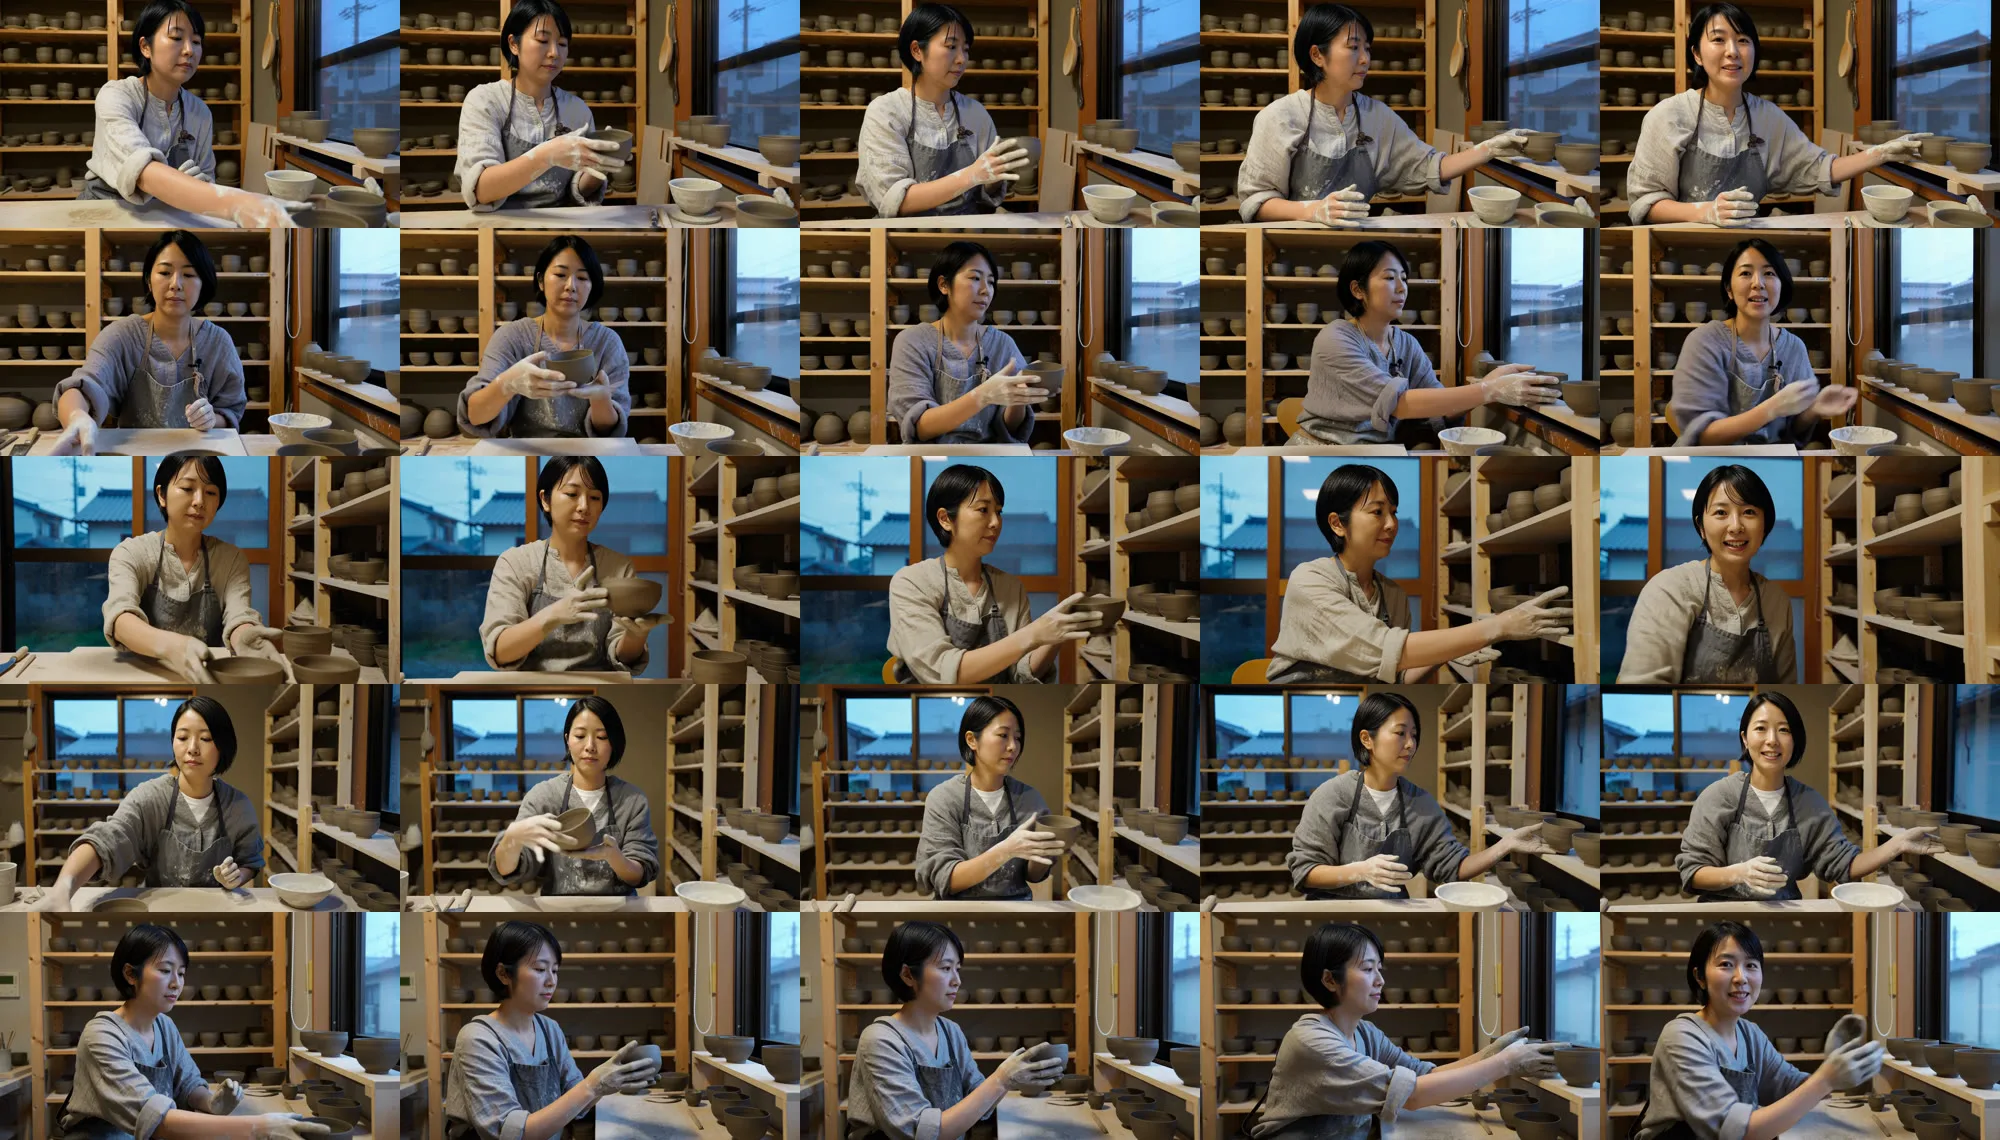
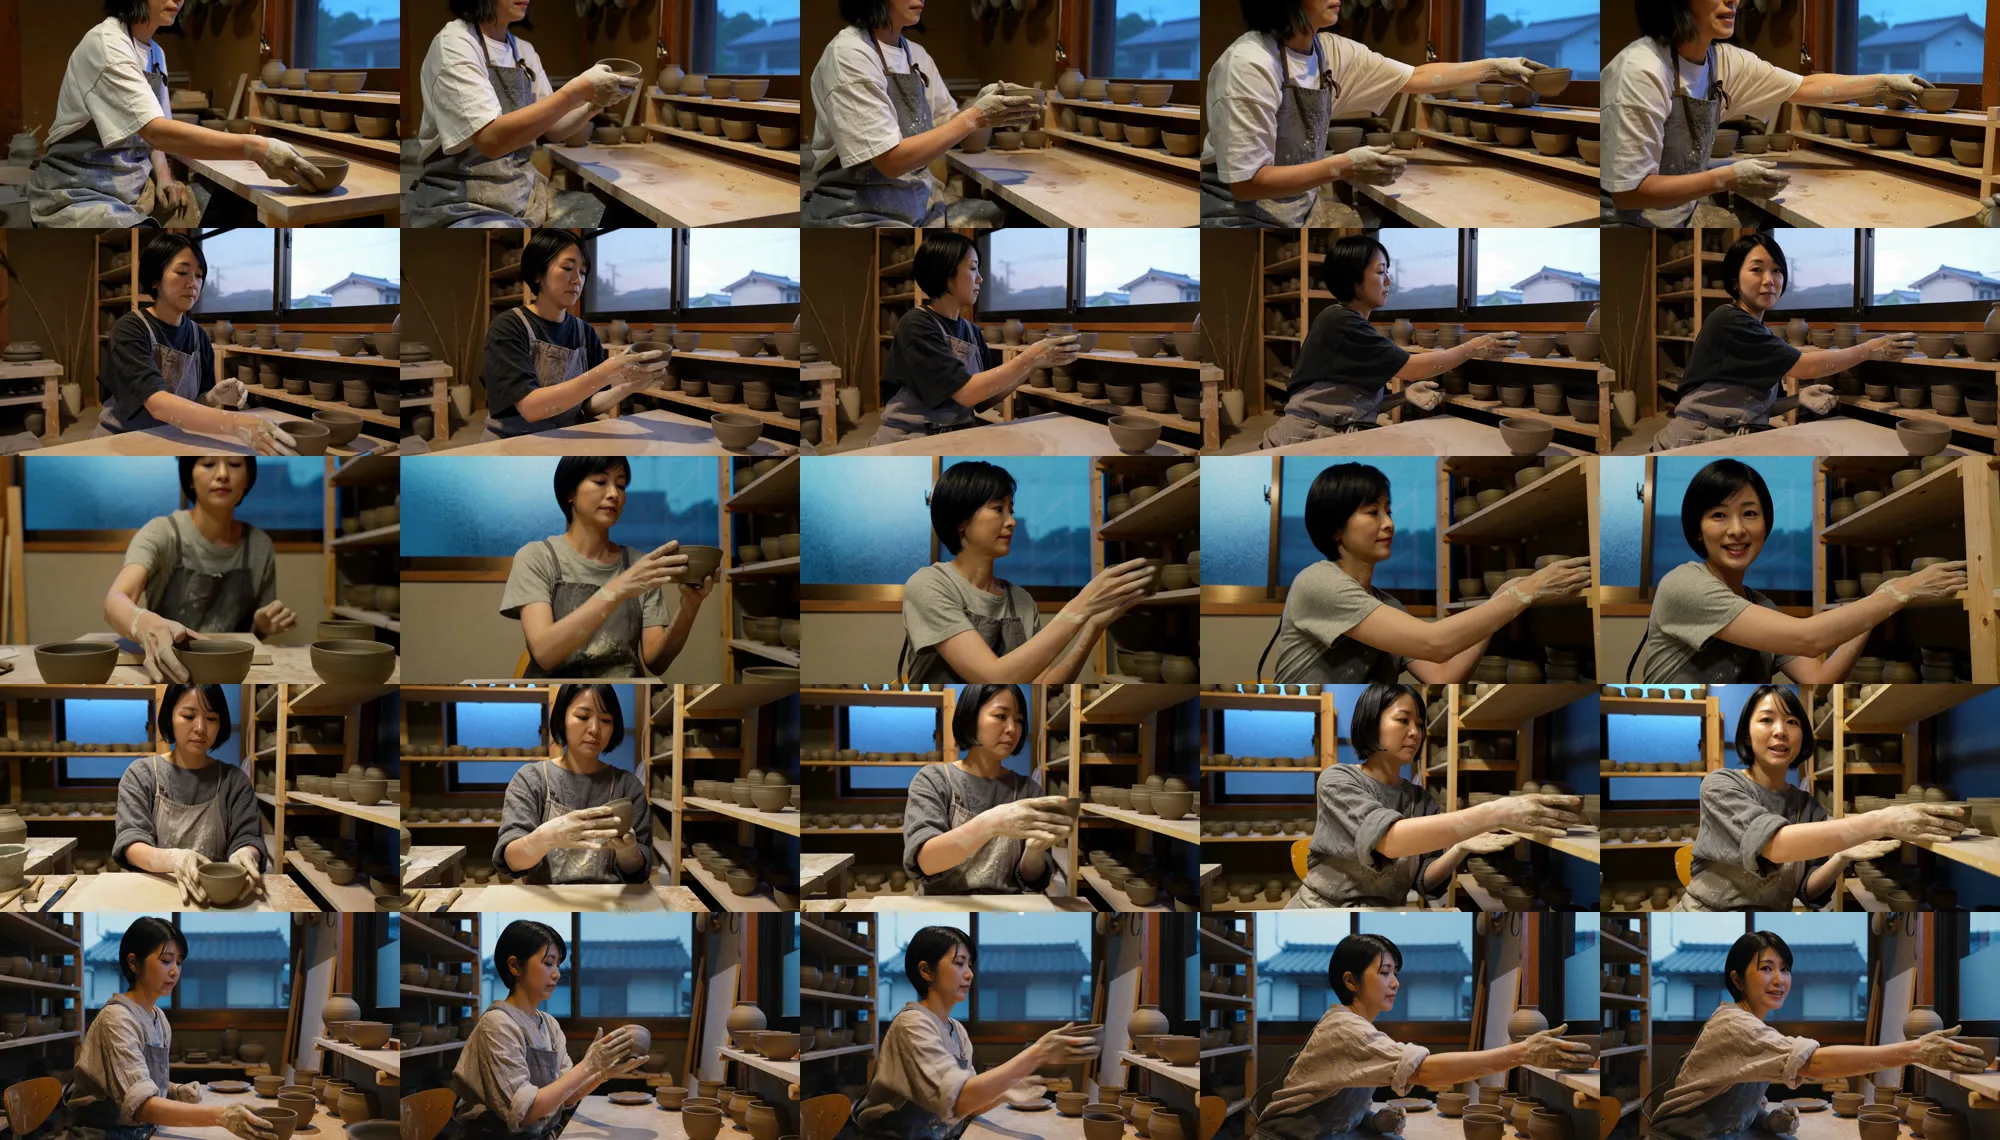
見比べた結果は次のとおりです(筆者の見立て。1つのプロンプトの5本ずつです)。
- ディテール:棚の器や服の質感に、はっきりした差は見つかりませんでした。
- 構図:Flex は5本とも顔が枠に収まりました。20ステップは5本中1本で全編、もう1本で冒頭に頭が切れました。
- 同じシードでも別の動画:LoRA のあるなしで、服や部屋は変わります。Flex は「同じ動画の高速版」ではありません。
- 手:Flex は粘土のついた手が白い手袋のように見える場面がありました。20ステップの手のほうが自然に見える本もあります。
音声と口の動き
音声はローカルでも一緒に作られます。出力はステレオの音声つき動画で、声も効果音も文章で指定します。
台詞は Whisper(文字起こしソフト)で確かめました。Flex の T2V は5本すべて「できました」、Ref2VA は5本すべて「いただきます」と起こせました。LoRA なしの 20ステップは5本中4本が一致し、1本は「いただきました」でした。
口の動きも1本で見ました。Ref2VA の動画では、声が約4.0〜4.75秒、口が開いているコマが約4.0〜4.5秒で、大きなずれはありません。
うまくいかなかったところ
全 44 本のうち、エラーや VRAM 不足で止まった生成はありません。
止まったのは生成の前です。Ref2VA の最初の投入は、計測用のスクリプトで足したノードの番号が SaveVideo と重なり、prompt_no_outputs で4回とも実行前に拒否されました。番号を直して流し直しています。
ここからは、見た目で崩れた点です。
| 条件 | 指示 | 結果 |
|---|---|---|
| T2V(5本) | ゆっくり寄って、顔と手の近くで止まる | 寄りは小さく、指示の近さまで寄ったものは0本 |
| T2V(5本) | 右へゆっくりパン | 動いたが幅は小さい |
| T2V(5本) | 器を棚に置いて手を離す | 1本は置かずに持ったまま終わった。手が止まらず器の上にかぶる場面もある |
| Ref2VA(5本) | 帯の前は赤い紐の蝶結び | 5本とも白い花と赤い房の飾りに変わった |
| Ref2VA(5本) | ゆっくり寄って右へパン | どちらも小さい。枠の変化は少ない |
| FL2VA(2本) | 声の指示なし | 最後のコマが口を開けた絵なので、声はないのに口が開いた |
Comfy 公式も、カメラの振れ幅は目安で、細かい接触の指定は当てにならないと書いています。今回の結果もこの説明に近いものでした。カップを両手で持つ動きは Ref2VA の5本とも破綻せず、1本を拡大しても指は崩れていませんでした。
VRAM と RAM はどれくらい使う?
| 項目 | 今回の値 | メモ |
|---|---|---|
| VRAM のピーク | 30.3〜30.9GiB(32GB 中) | GPU 全体の値。開始前のアイドルが約2.2GiB |
| ComfyUI の RAM | 42〜47.5GiB | 768p・15秒がいちばん多い |
| PC 全体の RAM の空き | いちばん少ないときで約25GiB | 128GB の PC。ほかのアプリも動かした状態 |
ComfyUI は必要なぶんだけ VRAM に載せる仕組みで動きます。入りきらないぶんは RAM に置きます。ほかのアプリと分け合うときは VRAM 不足の対処法 も見てください。
RTX 5090 以外の人へ(VRAM が少ない環境を想定した簡易テスト)
公式は最低 VRAM の数字を出していません。そこで --reserve-vram(VRAM の一部を使わずに残す設定)を変えて試しました。
| 想定 | 480p・5秒(秒) | 768p・5秒(秒) | VRAM のピーク(GiB) | RAM(GiB) |
|---|---|---|---|---|
| そのまま | 22.1 | 82.9 | 30.4〜30.8 | 43.9〜44.6 |
16GB 相当(--reserve-vram 16) | 21.5 | 82.8 | 18.2〜18.4 | 42.1〜43.1 |
12GB 相当(--reserve-vram 20) | 22.2 | 83.2 | 14.4〜14.5 | 42.8〜43.1 |
シードを変えた2回目の値です。この範囲では時間がほとんど変わりませんでした。そのかわり RAM は 40GiB 以上使います。RAM は 64GB 以上が安心です(筆者の見立て)。測っていない GPU の時間は、ここからは言えません。
商用利用と再配布の条件
Pika H3 Flex の LICENSE は MiniMax H3 Community License で、MiniMax H3 本体の LICENSE と一字一句同じでした(2026年11月2日に比べました)。NOTICE には、LoRA は Mellis, Inc. の著作物で、MiniMax H3 の派生物として同じライセンスで配布するとあります。原文で確かめた主な条件は次のとおりです。
| 項目 | 条件(原文の箇所) |
|---|---|
| 使える地域 | 世界のうち、EU・英国・韓国・米国を除く地域(I.3、I.5)。生成した動画の表示や配布も、この地域の中に限られます(V.4) |
| 商用利用 | できます。ただし、商用の製品・サービスの年間売上が2,000万米ドルを超えるときは、事前に MiniMax の書面の許可が要ります(IV.1) |
| 表示 | モデルを使う商用の製品・サービスの画面に「MiniMax H3」と目立つように表示します(IV.2) |
| 生成物 | MiniMax は生成物の権利を主張しません。責任は使う人が負います(VI.4) |
| AI 生成の明示 | 公開の場に出すときは、機械が作ったものだとはっきり示します(Exhibit A 12) |
| LoRA の再配布 | 対象地域の中でできます。LICENSE の写しと NOTICE を付け、変更したファイルには変更した旨を書きます(III) |
| ほかのモデルの学習 | 生成物やモデルを、ほかの AI モデルの改善に使えません(V.3) |
| 生成機能の提供 | 第三者に生成させるサービスでは、利用規約で縛り、違反を防ぐ安全策と報告窓口を用意します(V.2、V.5) |
ここに書いたのは要点で、法的な助言ではありません。全文は LICENSE の原文 を読んでください。判断できなかった点は、末尾の検証メモに書きました。
今回使ったプロンプト
T2V
integrated_multimodal_description: [Shot 1] Realistic live-action documentary look, soft window light at dusk, natural colours, shallow depth of field, fine film grain. A ceramic artist in her thirties with short black hair, a grey linen apron and clay-dusted forearms sits at a wooden workbench in a small pottery workshop, shelves of unglazed tea bowls behind her. The camera begins as a medium shot and slowly dollies in with small amplitude, coming to rest at about two seconds on a close medium shot of her hands and face. At about one second she reaches out with her right hand and picks up a small tea bowl from the bench, her fingers wrapping around its rim and her left palm supporting it from below. She turns the bowl a quarter turn with her fingertips and looks at the glaze. At about three seconds the camera pans slowly to the right, following the bowl as she sets it down gently on a wooden shelf, the base touching the wood with a soft knock, then comes to rest. In the last second she looks up toward the lens, smiles slightly and says in Japanese: "できました。" The last beat holds still.

overall_soundscape: Quiet workshop ambience with a faint evening breeze at the window, the dry scrape of ceramic against wood as the bowl is lifted, a soft wooden knock when it is set on the shelf, and her calm low voice saying the short line close to the microphone.

non_diegetic_music: None.
Ref2VA
subject_definitions:
<Subject 1> is the woman in <Picture 1>, <Picture 2>, <Picture 3> and <Picture 4>, an adult woman drawn in clean 2D anime style. Reference role: identity and costume anchor. Features to follow exactly: long wavy brown hair, green eyes, a navy blue kimono with large white flower prints and green leaves, a gold obi with a red cord tied in a bow at the front, a large gold bow at the back. Do not carry over the plain studio backgrounds of the pictures.
<Subject 2> is a small tatami room invented for this shot: pale tatami floor, paper sliding doors with soft daylight, a low dark wooden table with a white ceramic teacup on it.

summary:
[reference generation] A five-second single continuous shot in 2D anime style: the woman of the pictures kneels at a low table in a tatami room, picks up a white teacup with both hands, lifts it, and says a short line while the camera slowly pushes in and then pans right.

retention_analysis:
<Subject 1> (appears in [Shot 1]): fully_preserved - face, long wavy brown hair, green eyes, navy kimono with white flower prints, gold obi with red cord.
<Picture 1> to <Picture 4> backgrounds: weak_reference only - discarded entirely.
No audio reference is used in this generation.

detailed_description:
Clean 2D anime cel shading with soft daylight, consistent line work, and no changes to the costume pattern; a single unbroken shot with no cuts.

[Shot 1] Medium shot: <Subject 1> kneels behind the low table, facing the camera, hands resting on her lap, the white teacup on the table in front of her. The camera slowly pushes in with small amplitude and comes to rest at about two seconds on a close medium shot. At about one second she reaches forward with her right hand, her fingers closing around the teacup, her left hand coming up to support it from below, and she lifts it to chest height, both hands in contact with the cup. At about three seconds the camera pans slowly to the right with small amplitude and stops, keeping her in frame. In the last second she looks into the lens with a gentle smile and says in Japanese: "いただきます。" Her lips move only while she speaks. The last beat holds still.

overall_soundscape:
Quiet room tone, a faint outdoor breeze behind the paper doors, the soft clink of the cup leaving the wooden table, the rustle of kimono sleeves, and her soft clear voice saying the short line.

non_diegetic_music:
None.
つまずきやすいところ
- テンプレートが出てこない:テキストから動画は ComfyUI 0.43.2 以上が必要です。更新手順 で上げてください。
- 同じシードで押すと一瞬で終わる:入力が同じだと ComfyUI は計算を使い回します。時間を測るときはシードを変えます。
- FL2VA の解像度が思ったものと違う:最初のコマの画像サイズで決まります。
- 3種類を交互に使うと遅い:Ref2VA と T2V 系で本体が違うので、切り替えるたびに数分かかります。まとめて作るのがおすすめです。
よくある質問(FAQ)
Q. Pika H3 Flex は無料で使えますか?
LoRA と本体は Hugging Face で無料で配られていて、ComfyUI で動かせます。商用には売上や地域などの条件があります。1080p 以上は Pika のホスト版(API)の機能です。
Q. H3 が本当に6ステップで動きますか?
はい。公式テンプレートのまま、1344×768・5秒が約87秒でした(5シードの中央値)。LoRA なしの 20ステップより 66% 短くなりました。
Q. 画質は落ちますか?
今回の1プロンプト・5シードずつの比較では、はっきりした低下は見つかりませんでした(筆者の見立て)。プロンプトが変われば結果も変わる可能性があります。
Q. 必要な VRAM はどれくらいですか?
公式の最低値はありません。RTX 5090 ではピーク約31GiB でした。--reserve-vram 20 の簡易テストではピーク約14.5GiB で同じ速さでしたが、実際の 12GB・16GB 搭載 GPU での動作を保証するものではありません。
Q. RAM は何GB あればいいですか?
ComfyUI だけで 42〜47.5GiB 使いました。ほかのアプリも動かすなら 64GB 以上が安心です(筆者の見立て)。
Q. 音声は出せますか?
はい。ローカルでもステレオ音声つきで作れます。声と効果音は文章で指定します。音声をパートごとに分ける機能はホスト版だけです。
Q. H3 Ref2VA で同じキャラは保てますか?
今回は参照4枚・5シードのすべてで、顔・髪・着物の柄が保たれました。帯の小さな飾りのように、細かい部分は変わることがあります。
Q. Turbo LoRA と一緒に使えますか?
使いません。Comfy 公式は、重ねると出力が壊れると説明しています。
Q. 商用で使えますか?
EU・英国・韓国・米国を除く地域で、売上や表示の条件を守れば使えます。年間売上が2,000万米ドルを超える製品・サービスは事前の許可が必要です。
まとめ
Pika H3 Flex は、公式テンプレートのままで H3 を6ステップにします。RTX 5090 の 1344×768・5秒では約87秒で、LoRA なしの 20ステップより 66% 短くなりました。画質のはっきりした低下は見つからず、Ref2VA では人物と衣装も保たれました(今回のテスト条件で)。カメラや接触の細かい指定は外れることがあるので、そこは数本作って選ぶのが現実的です。
検証メモ
結果を読むときの条件と、判断できなかった点です。
試した環境
| 項目 | 内容 |
|---|---|
| GPU / CPU / メモリ | RTX 5090(VRAM 32GB、ドライバ 621.01)/ Ryzen 9 9950X3D / RAM 128GB |
| OS | Windows 11 |
| ComfyUI | v0.43.2(コミット 423cbd20、2026-10-30)のポータブル版、カスタムノードなし、Python 3.13.14、PyTorch 2.14.0+cu130 |
| H3 の構成 | pruned int8(minimax_h3_fl2va / ref2va_pruned_int8_convrot)、テキストエンコーダー nvfp4、映像 VAE int8、音声 VAE fp32 |
| モデルの置き場所 | USB 接続の外付けディスク。読み込みの時間はディスクで変わります |
| 測った日 | 2026年11月2日。計測中は別の ComfyUI のモデルを外し、アイドルの VRAM は約2.2GiB |
- 時間は ComfyUI に送ってから保存までです。DiT(動画を作る本体)の計算だけを指す秒数とは別のものです。
- 1344×768・5秒の T2V の2つの数字は、測定回が違います。どちらも陶芸家のプロンプト、公式テンプレートのまま6ステップ・CFG 1 です。主表の86.9秒は、5シードの中央値にあたる回です(シード 20261102、2026年11月2日 07:49、同じプロンプト・シードの2回目、計算 76.03秒)。長さ別の表の82.9秒は別の回です(シード 20261103、08:45、計算 74.7秒)。同じシード 20261103 でも、07:48 の回は104.2秒でした。
- プロンプトは T2V 1種、Ref2VA 1種、FL2VA 1種です。LoRA なしとの比較は1プロンプト・5シード(50ステップは1本)で、ほかのプロンプトに広げて言えるものではありません。
- 画質は目視です。参考に、3コマのラプラシアン分散(エッジの量の目安)の中央値は Flex 77、20ステップ 57、50ステップ 79 でした。場面が違うので順位の根拠にはしていません。
- 音声は Whisper と波形で確かめました。耳で聞いた音質の評価はしていません。Whisper の小さいモデル(base)なので、1本の不一致はソフトの聞き間違いの可能性があります。
- FL2VA の2コマは同じ動画から取ったので、つなぎやすい条件です。かけ離れた2枚は試していません。
- 試していないこと:参照の動画・音声、参照5枚以上、int8 以外の本体、ほかの GPU。
- ライセンスで判断できなかった点:サイトに載せた動画を対象外の地域から見られる場合の扱い(V.4)、画面のない成果物の販売に IV.2 の表示がどう及ぶか。条文からは断定できません。
- 「1000/750/500…」のようなシグマの表記を見かけることがありますが、公式テンプレートの値は本文の表のとおりです。