KJNodes の「モデル・LoRA・メモリ・高速化」39 個を試すと、KJNodes だけで動いたのは17個でした。LoRA の抽出と軽量化、VRAM の確認、精度を選んだ読み込みは、そのまま動きました。高速化のノードは別の部品が必要で、今回の環境では動いていません。
ComfyUI-KJNodes(KJNodes)は、ComfyUI の公式の登録所でいちばんダウンロードされているカスタムノードで、入れると 260 個のノードが増えます。この記事はシリーズの⑤回目。ノードごとに、動かした(または置いた)ときの画面を載せました。
エラーはメッセージをそのまま、実行していないものは理由を書いています。環境と試し方は末尾の「検証メモ」へ。
KJNodes シリーズの一覧
全260ノードを、やりたいこと・ノード名から探すには KJNodes 完全ガイド(総合索引)へ。
| 回 | 分類 | 記事 |
|---|---|---|
| ① | 画像 | KJNodesの使い方① |
| ② | マスク | KJNodesの使い方② |
| ③ | テキスト・数値・その他・ループ | KJNodesの使い方③ |
| ④ | ラテント・ノイズ・サンプリング・座標 | KJNodesの使い方④ |
| ⑤ | モデル・LoRA・メモリ・高速化 | この記事 |
| ⑥ | 動画モデル用 | KJNodesの使い方⑥ |
| ⑦ | 音声・非推奨 | KJNodesの使い方⑦ |
ノード名は、画面に出る英語の名前(または中身の名前)で書いています。ノードライブラリで名前を入れると見つかります。スクリーンショットの「プレビュー任意」は、数値や文字を表示するための ComfyUI の標準のノードです。
モデルを読み込む
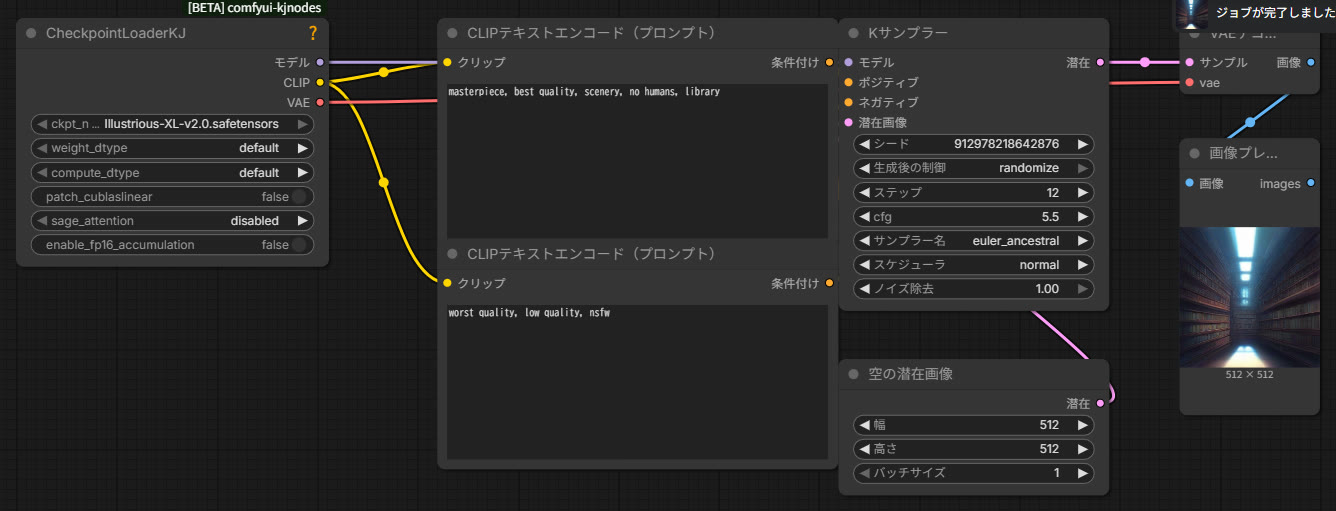
CheckpointLoaderKJ
チェックポイント(1ファイルのモデル)を、計算の精度や SageAttention などの設定つきで読み込みます(実験的なノード)。
試したこと:Illustrious XL v2.0 を初期設定で読み込み、512×512 の画像を作れました。
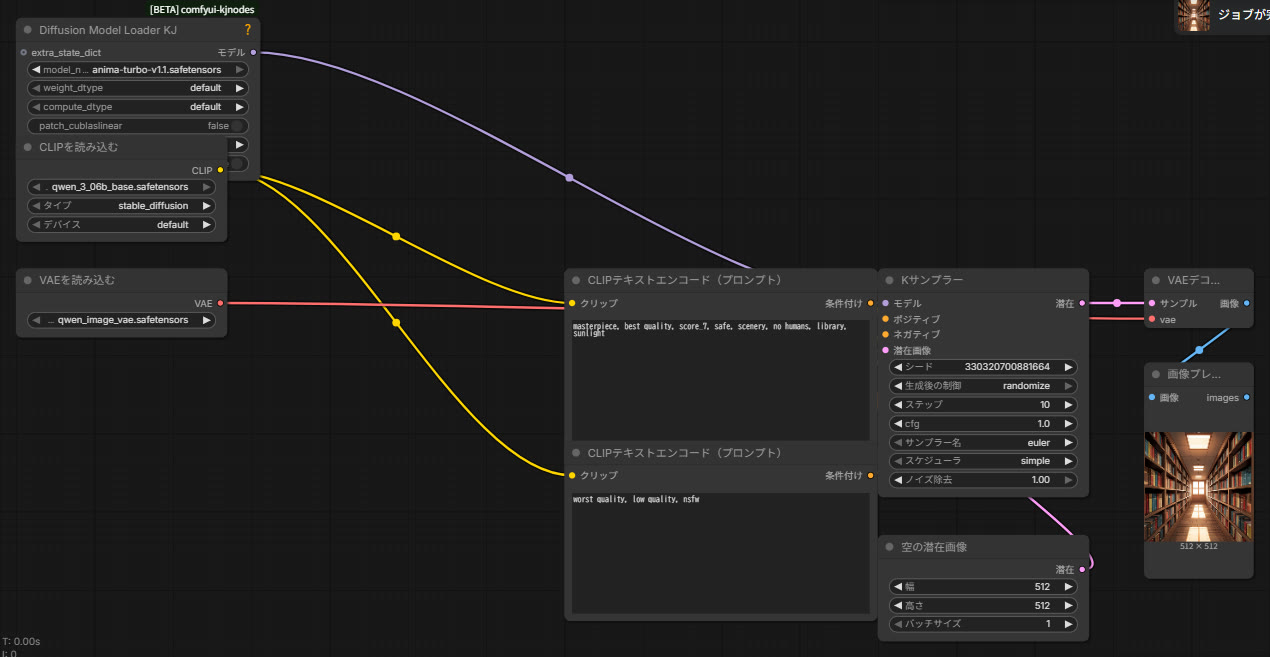
DiffusionModelLoaderKJ
拡散モデル(本体だけのファイル)を、精度や SageAttention などの設定つきで読み込みます(実験的なノード)。
試したこと:Anima Turbo v1.1 を読み込み、10ステップ・CFG 1 で画像を作れました。
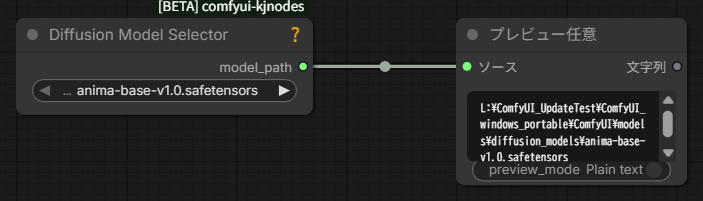
DiffusionModelSelector
拡散モデルのファイルの場所を、文字列で返します(実験的なノード)。
試したこと:anima-base-v1.0 を選び、ファイルの場所の文字列が出ました。
GGUFLoaderKJ
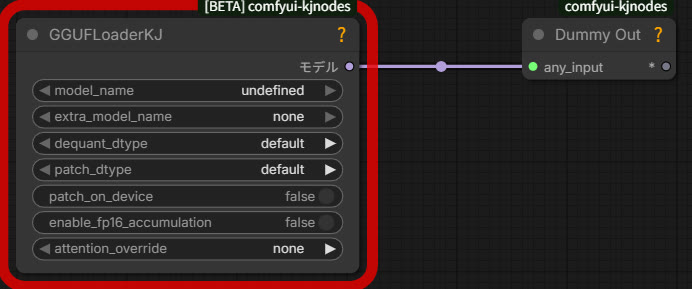
GGUF 形式(軽くしたモデルの形式)のモデルを、細かい設定つきで読み込みます。作者の説明では、ComfyUI-GGUF という別のカスタムノードが必要です。
試したこと:試験用の環境には GGUF のモデルがなく、ファイルを選べないため「model_name がない」というエラーで止まりました。ComfyUI-GGUF も入れていません(このシリーズは KJNodes 以外のカスタムノードを使わないため)。
LoRA
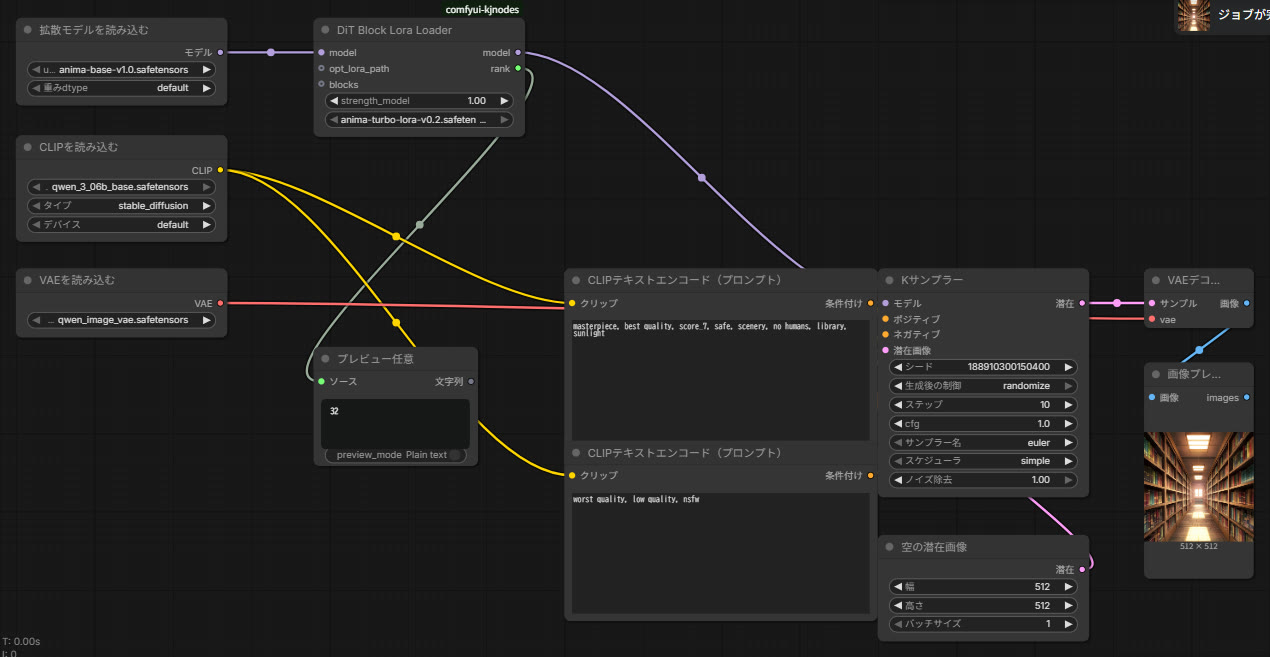
DiTBlockLoraLoader
DiT 系のモデル(Anima・Flux・Wan など)に、LoRA をかけます。blocks をつなぐと、ブロックごとに強さを変えられます。
試したこと:Anima-Base に公式の Turbo LoRA をかけ、10ステップ・CFG 1 で画像を作れました。LoRA のランク(32)も出力されました。
LoraExtractKJ
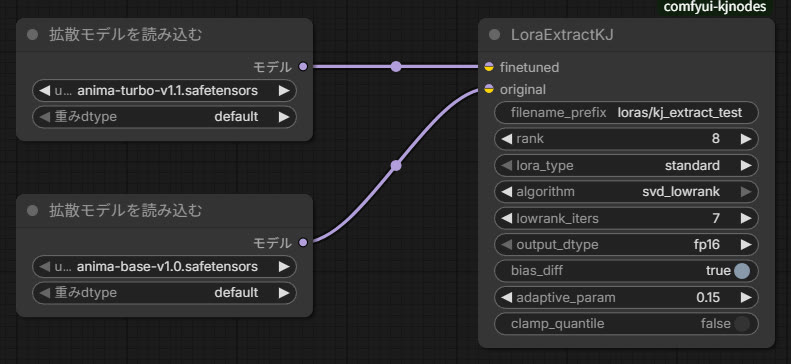
2つのモデルの差から、LoRA を取り出します。
試したこと:Anima Turbo v1.1(finetuned)と Anima-Base v1.0(original)の差から、ランク 8 の LoRA(約38MB)を取り出せました。
LoraReduceRankKJ
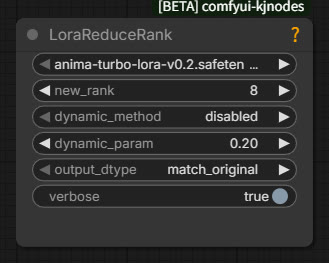
LoRA のランク(中身の大きさ)を小さくして、ファイルを軽くします(実験的なノード)。作者の説明では、kohya の sd-scripts の方法をもとにしています。
試したこと:Anima Turbo LoRA(ランク 32・約149MB)を、ランク 8(約37MB)にしました。
メモリ(VRAM)
VRAM_Debug
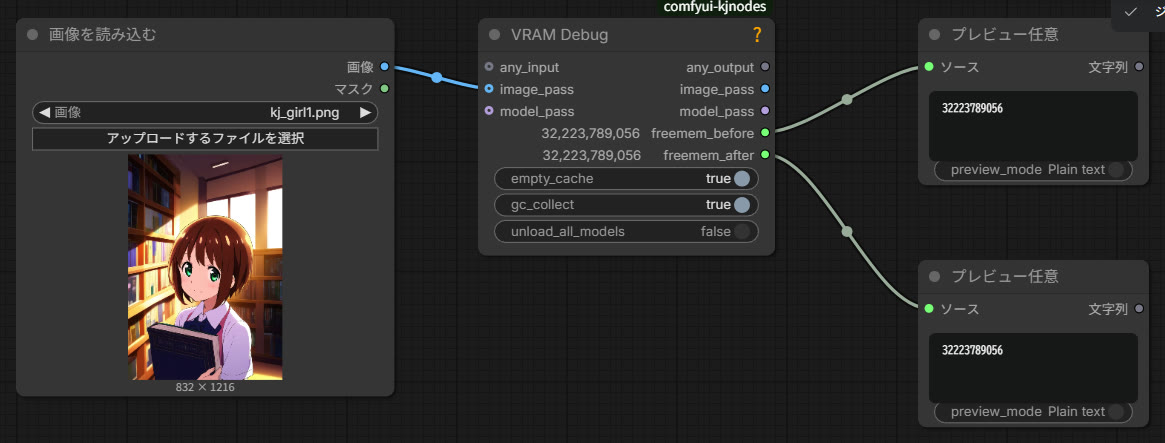
メモリの片付け(キャッシュを空にする、使っていない値を消す、モデルを外す)をして、前後の空き VRAM を表示します。
試したこと:空き VRAM は前後とも約 32.2GB(32,223,789,056 バイト)でした。
ModelMemoryUsageFactorOverride
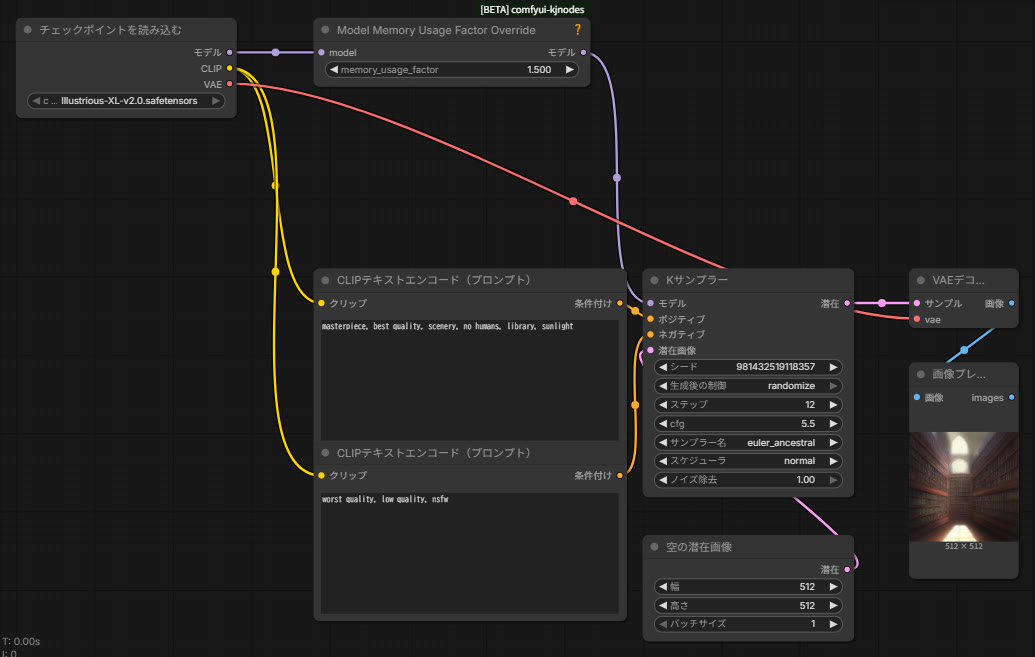
生成のときに見積もるメモリの量の倍率を変えます(実験的なノード)。
試したこと:倍率 1.5 にして、ふつうに画像を作れることを確かめました。
ModelMemoryUseReportPatch
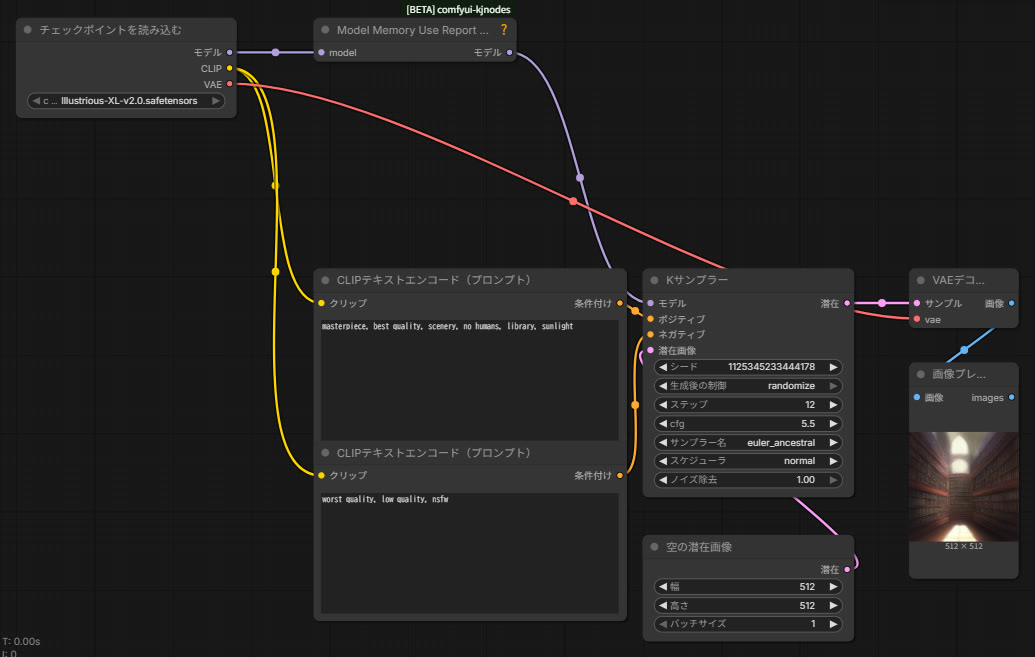
生成のあとに、メモリの使用量を表示するようにします(実験的なノード)。
試したこと:モデルにかけて画像を作れることを確かめました。表示は ComfyUI の黒い画面に出ます。
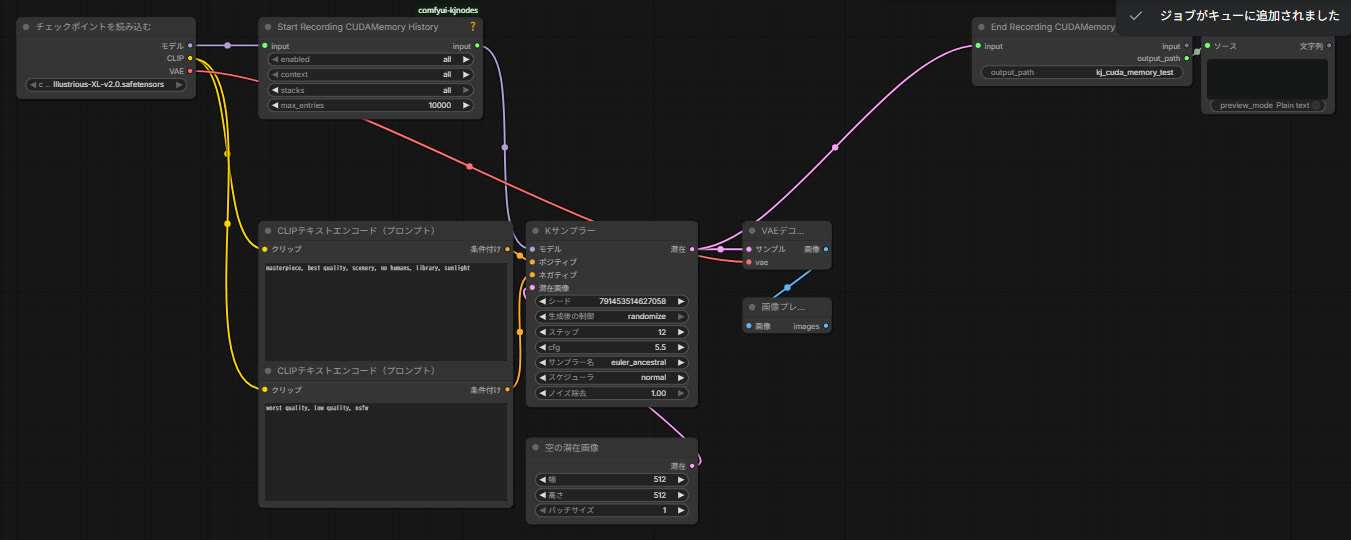
StartRecordCUDAMemoryHistory
CUDA のメモリの使い方の記録を始めます。EndRecordCUDAMemoryHistory と組にして使います。
試したこと:実行すると「cudaMallocAsync does not yet support recordHistory」というエラーになりました。ComfyUI が使っているメモリの確保のしかた(cudaMallocAsync)では、記録ができないようです。
EndRecordCUDAMemoryHistory
記録を止めて、ファイルに保存します。
試したこと:上と同じ組み方で、同じエラーになりました。
VisualizeCUDAMemoryHistory
保存した記録をグラフにします。作者の説明では、ブラウザで開きます。
試したこと:記録ができなかったうえ、実行すると筆者の PC でブラウザが開く可能性があるため、実行していません。
高速化(torch.compile)
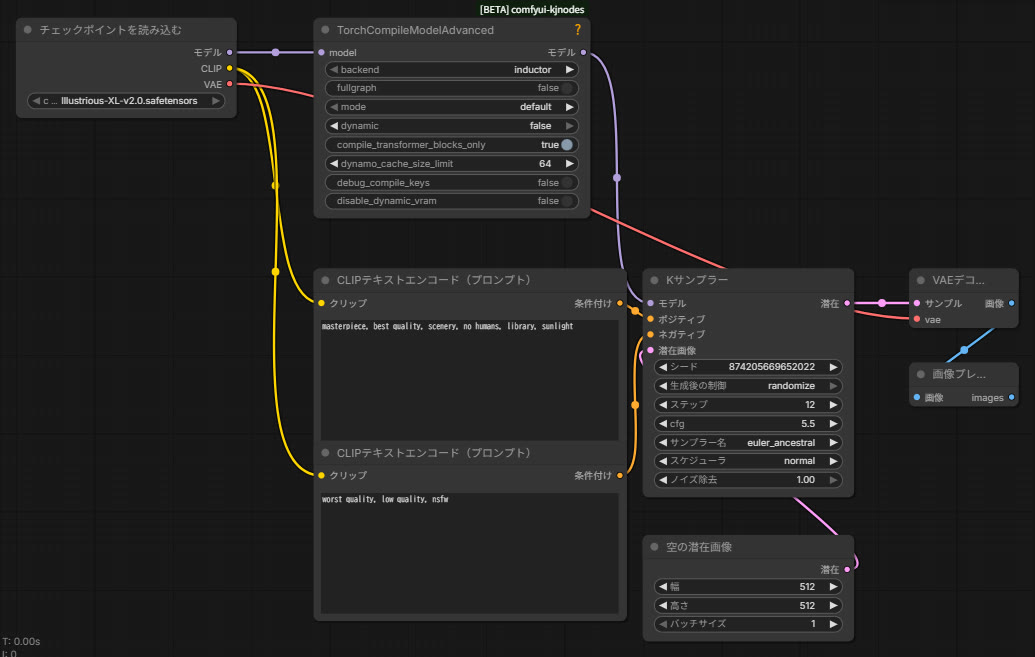
TorchCompileModelAdvanced
torch.compile でモデルを速くします(実験的なノード)。
試したこと:「Cannot find a working triton installation」というエラーになりました。torch.compile には triton という部品が必要で、試験用の環境には入っていません。
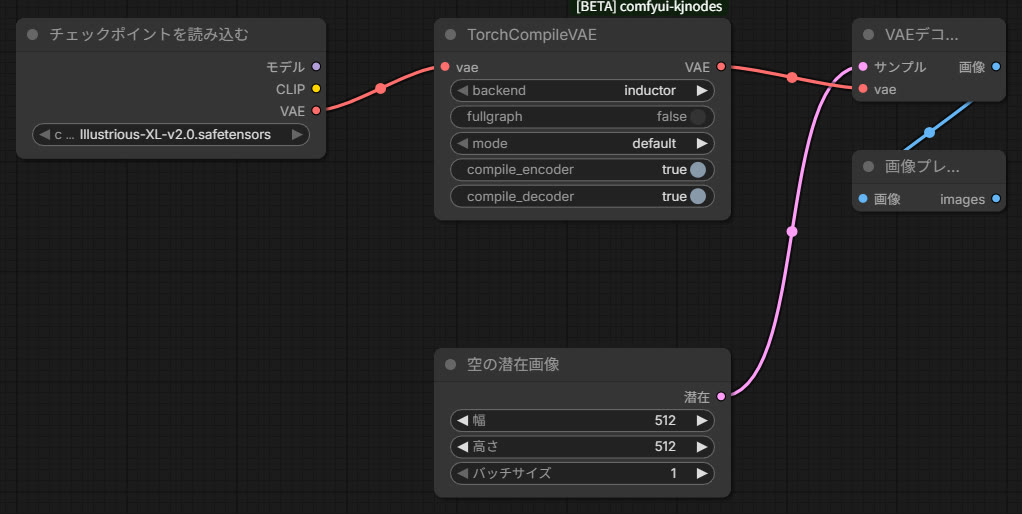
TorchCompileVAE
torch.compile で VAE を速くします。
試したこと:上と同じく、triton がないためエラーになりました。
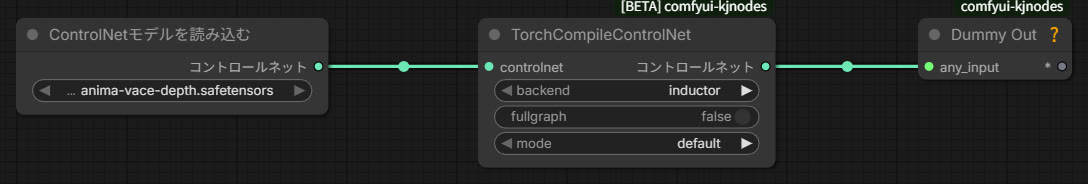
TorchCompileControlNet
torch.compile で ControlNet を速くします。
試したこと:手元にあった Anima 用の ControlNet のファイルは、標準の読み込みで「有効な ControlNet ではない」と出て、ここまで進めませんでした。
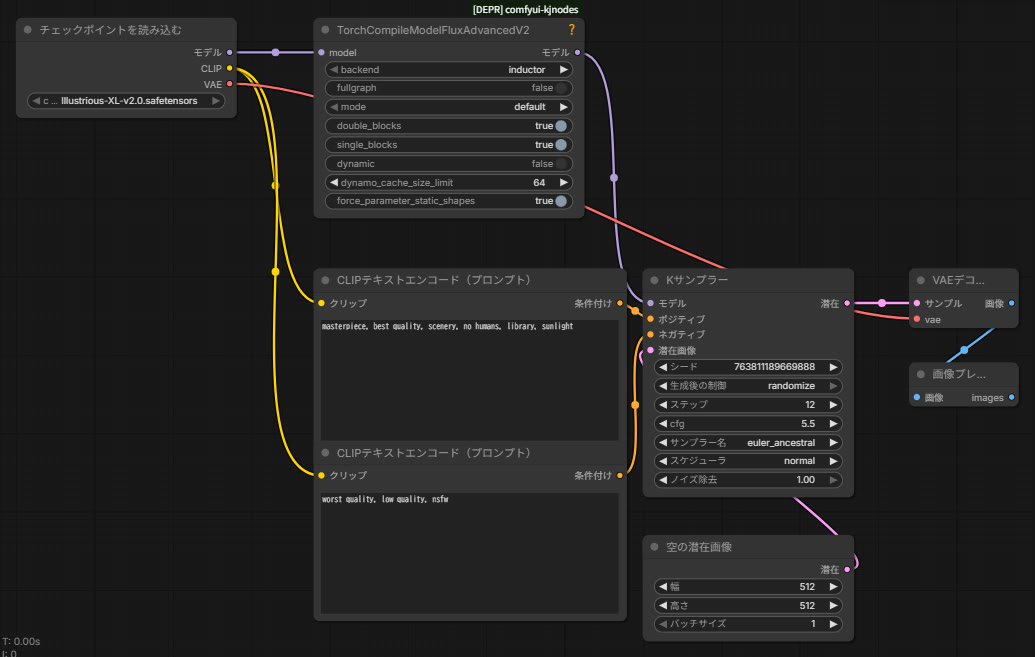
TorchCompileModelFluxAdvancedV2
Flux 用の torch.compile です。画面には [DEPR] と出る古い版で、作者は TorchCompileModelAdvanced を使うよう案内しています。
試したこと:SDXL のモデルにかけて「Failed to compile model」になりました。
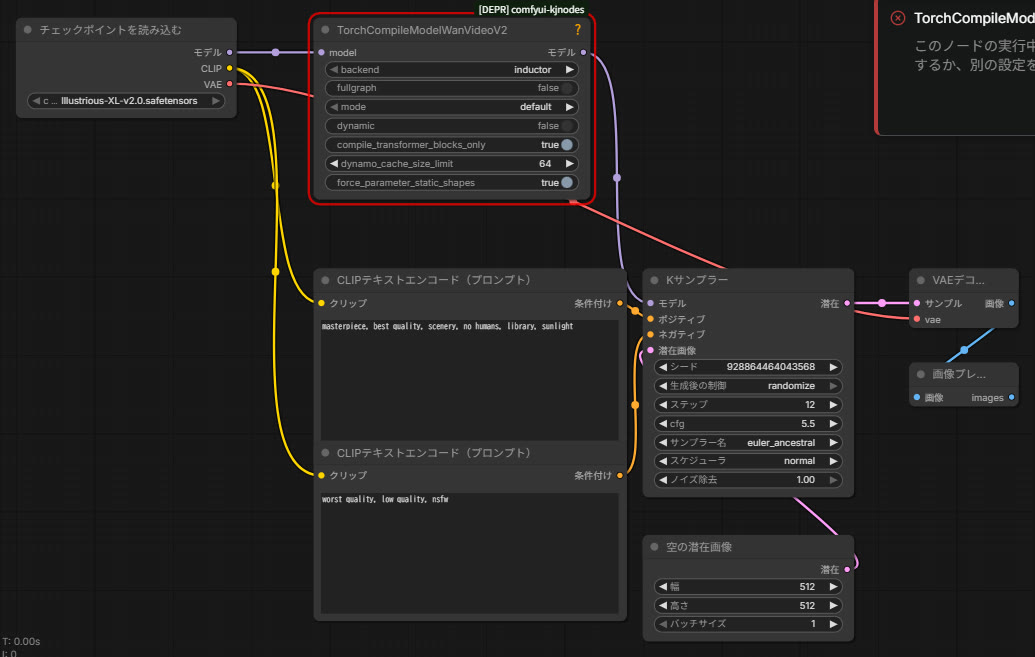
TorchCompileModelWanVideoV2
Wan 用の torch.compile です。これも古い版です。
試したこと:SDXL のモデルにかけて「Failed to compile model」になりました。
VAE
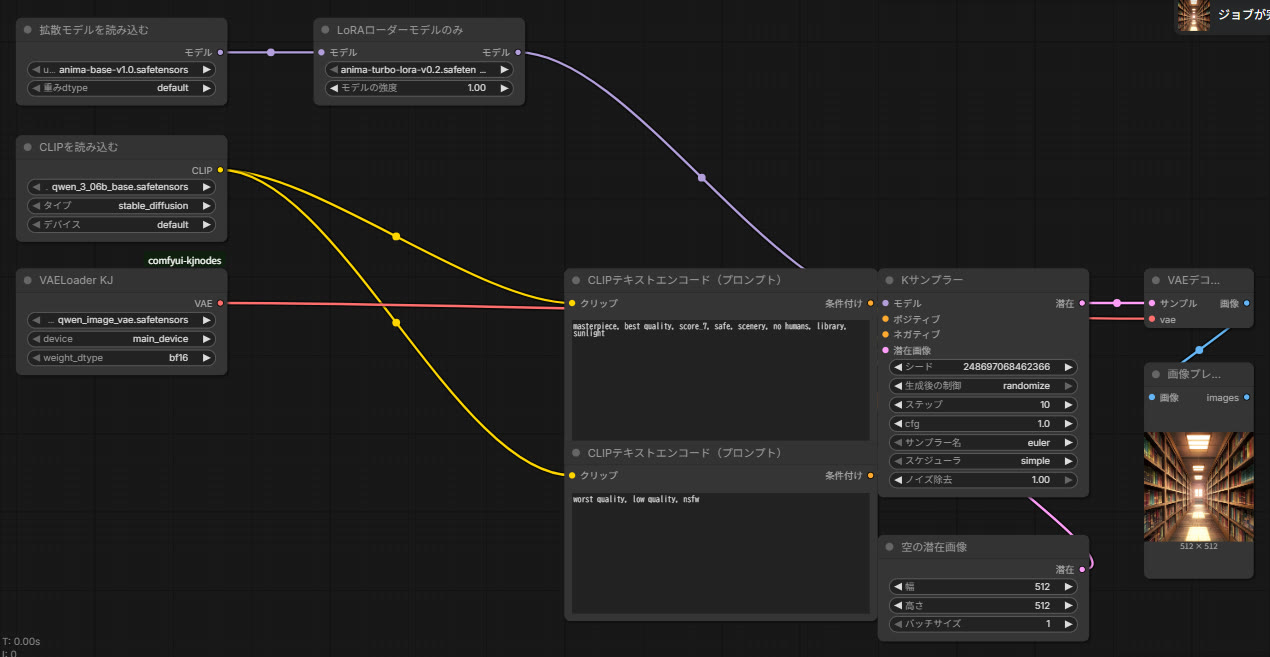
VAELoaderKJ
VAE を、読み込む場所(GPU か CPU)と精度を選んで読み込みます。
試したこと:qwen_image_vae を bf16 で読み込み、Anima の画像を作れました。
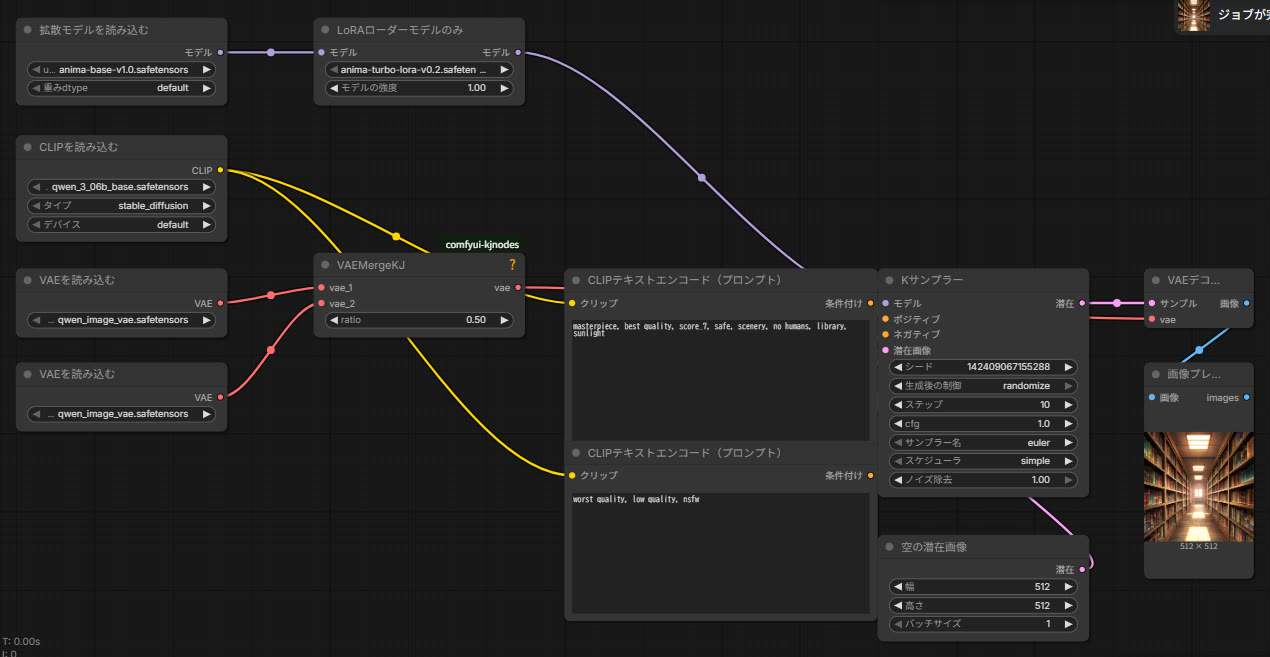
VAEMergeKJ
2つの VAE の中身を、割合を決めて混ぜます。作者の説明では、同じ作りの VAE どうしでないと混ぜられません。
試したこと:同じ qwen_image_vae を2つ読み込んで 0.5 で混ぜ、そのまま画像を作れました(同じものどうしなので、結果は変わらない組み方です)。
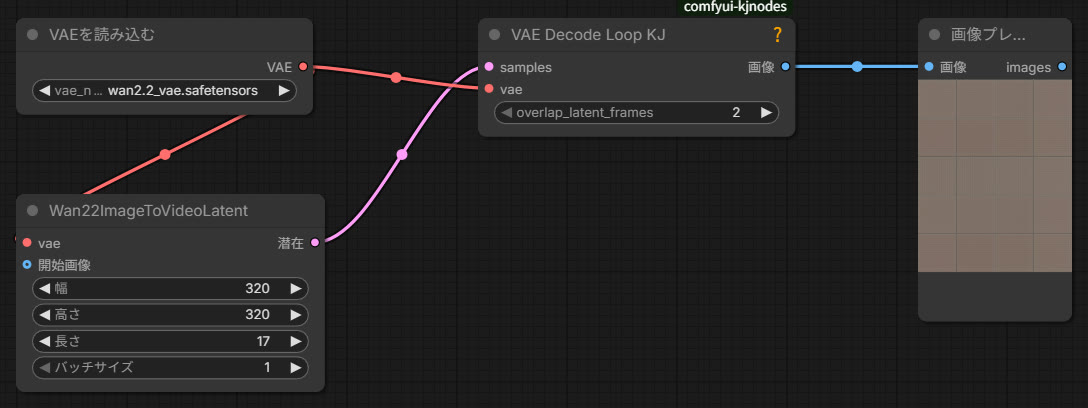
VAEDecodeLoopKJ
動画の潜在画像を、ループ(最初と最後がつながる動画)の継ぎ目が目立たないように VAE で戻します。
試したこと:最初は Anima の画像の潜在画像で試し、エラーになりました。Wan 2.2 の VAE と、標準の Wan22ImageToVideoLatent で作った動画の潜在画像(17フレーム)にすると、動きました。
モデルを保存する・ControlNet
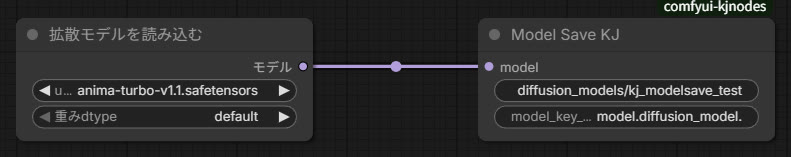
ModelSaveKJ
モデルをファイルに保存します。保存するときのキーの前につける名前も決められます。
試したこと:Anima Turbo v1.1 を保存し、output\diffusion_models に約 4.2GB のファイルができました(確認後に消しました)。
SetShakkerLabsUnionControlNetType
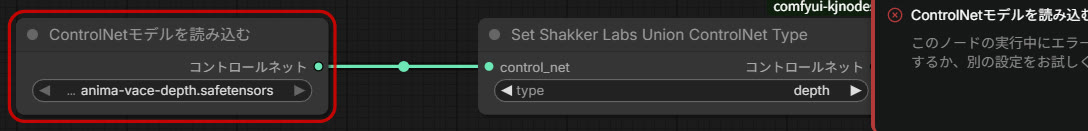
Shakker Labs の Union ControlNet で使う種類(canny・depth など)を決めます。
試したこと:手元に対応する ControlNet がなく、ほかの ControlNet ファイルでは読み込みの時点で止まりました。
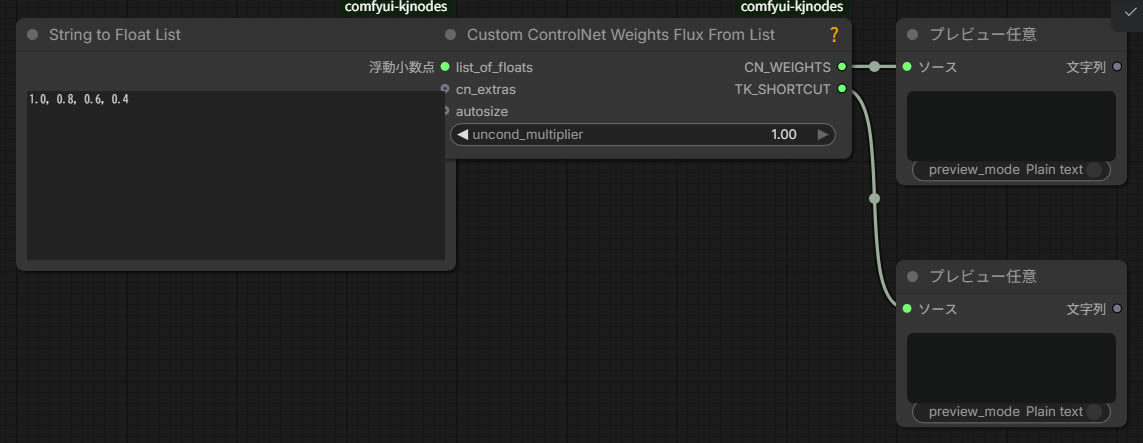
CustomControlNetWeightsFluxFromList
数値のリストから、ControlNet の強さの並びを作ります。作者の説明では、Advanced-ControlNet 用です。
試したこと:「No module named ‘ComfyUI-Advanced-ControlNet’」と出ました。別のカスタムノード(Advanced-ControlNet)が必要です。
モデルにかける実験的な設定
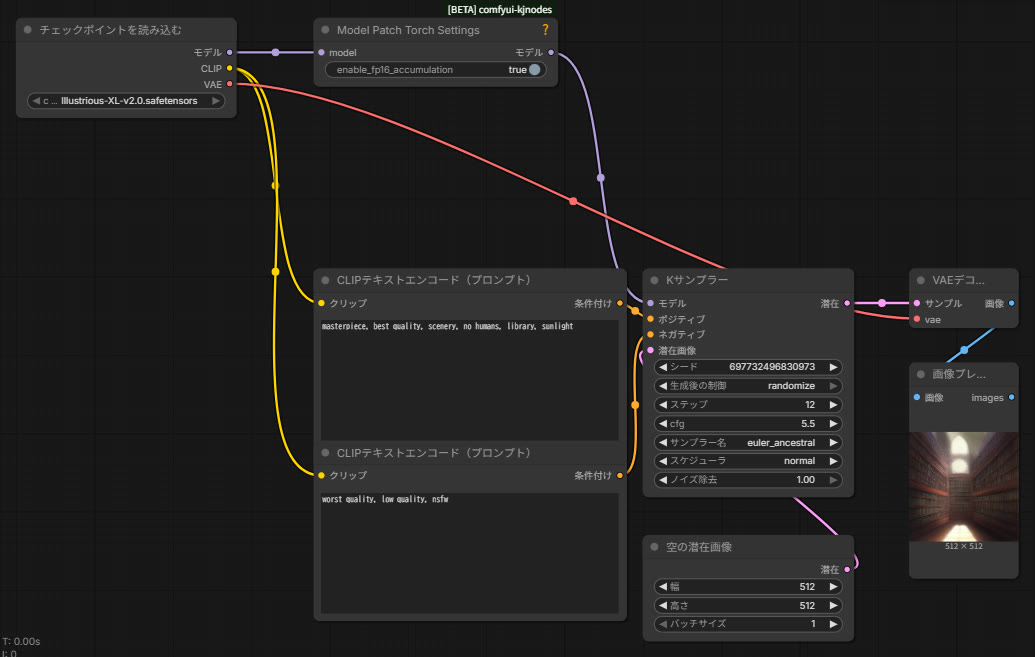
ModelPatchTorchSettings
生成の前後で、PyTorch の設定(fp16 の足し算の精度など)を変えます(実験的なノード)。
試したこと:enable_fp16_accumulation をオンにして、画像を作れました。
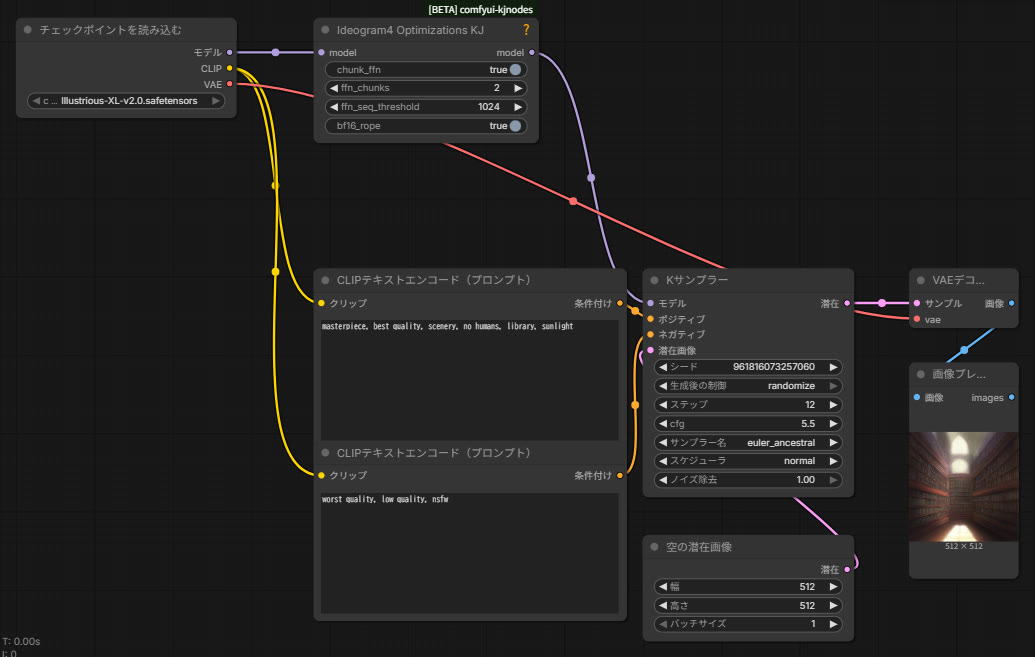
Ideogram4OptimizationsKJ
Ideogram 4 のモデルの VRAM を減らす設定です(実験的なノード)。作者は、出力が変わることがあると注意しています。
試したこと:SDXL のモデルにかけても、エラーなく画像を作れました。Ideogram 4 のモデルではないので、効果は確かめていません。
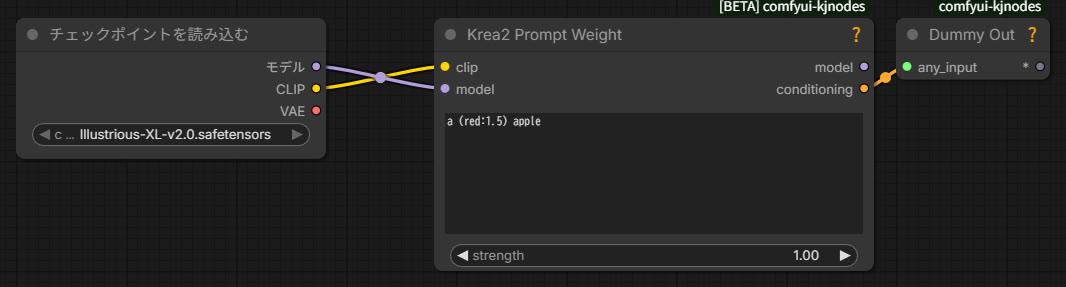
Krea2PromptWeight
Krea2 のモデルで、プロンプトの単語ごとに強さを変えます(実験的なノード)。「(word:1.5)」のように書きます。
試したこと:SDXL の CLIP とモデルをつないで、エラーなく実行できました。Krea2 のモデルではないので、効果は確かめていません。
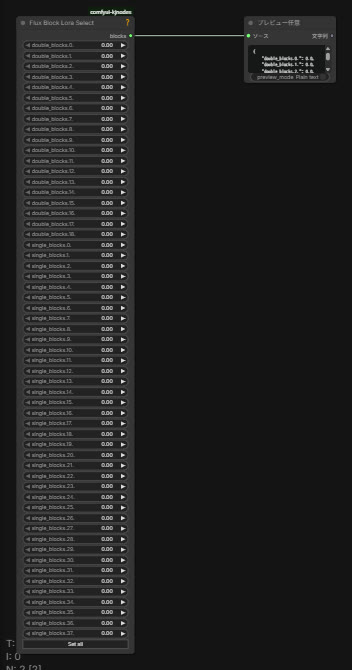
FluxBlockLoraSelect
Flux の LoRA を、ブロックごとの強さで選びます。0 にしたブロックは外れます。つなぎ先は DiTBlockLoraLoader の blocks。
試したこと:初期値のまま実行し、ブロックごとの値が出ました。
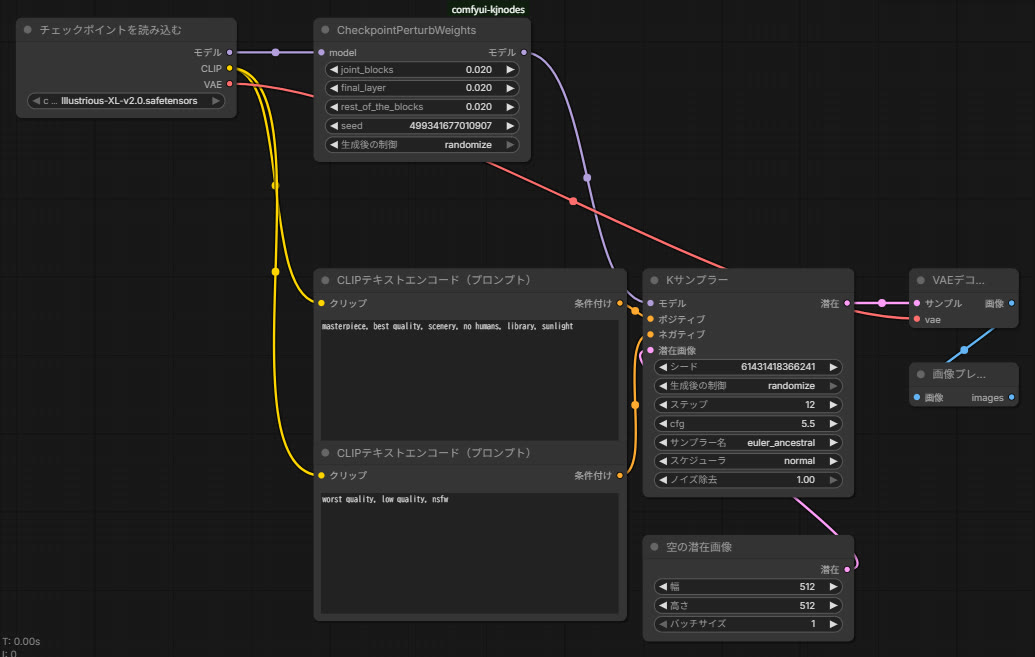
CheckpointPerturbWeights
モデルの重みに、少しだけばらつきを足します。
試したこと:SDXL のモデルにかけると「’NoneType’ object is not callable」のエラーになりました。joint_blocks などの名前から、SD3 や Flux のような作りのモデル用と考えられます。
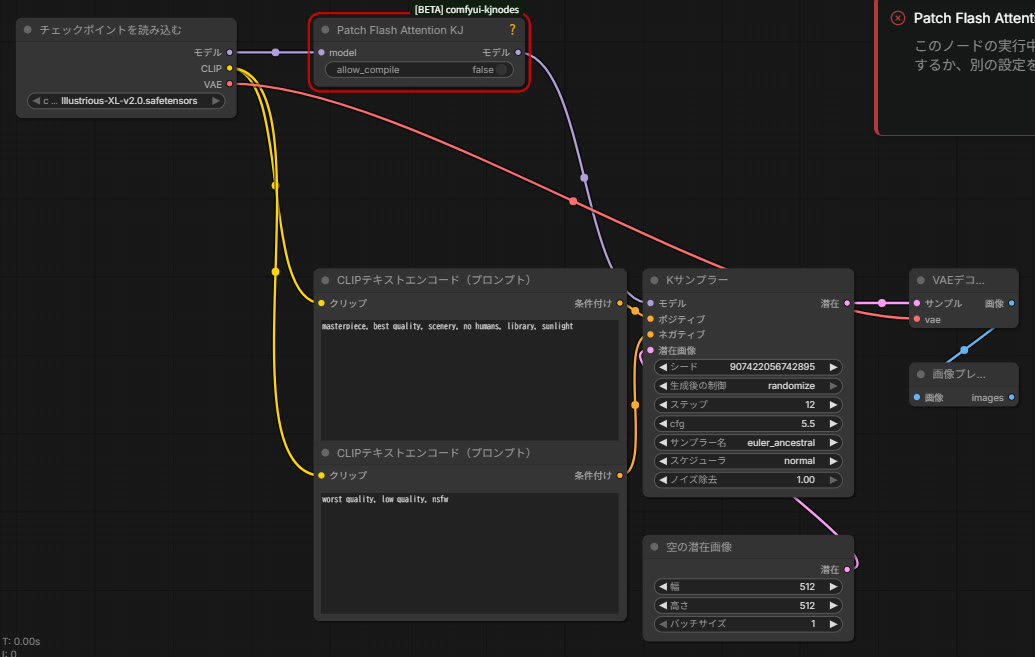
PatchFlashAttentionKJ
注意(attention)の計算を FlashAttention にします(実験的なノード)。
試したこと:「Flash attention not found」と出ました。flash_attn という部品が必要です。
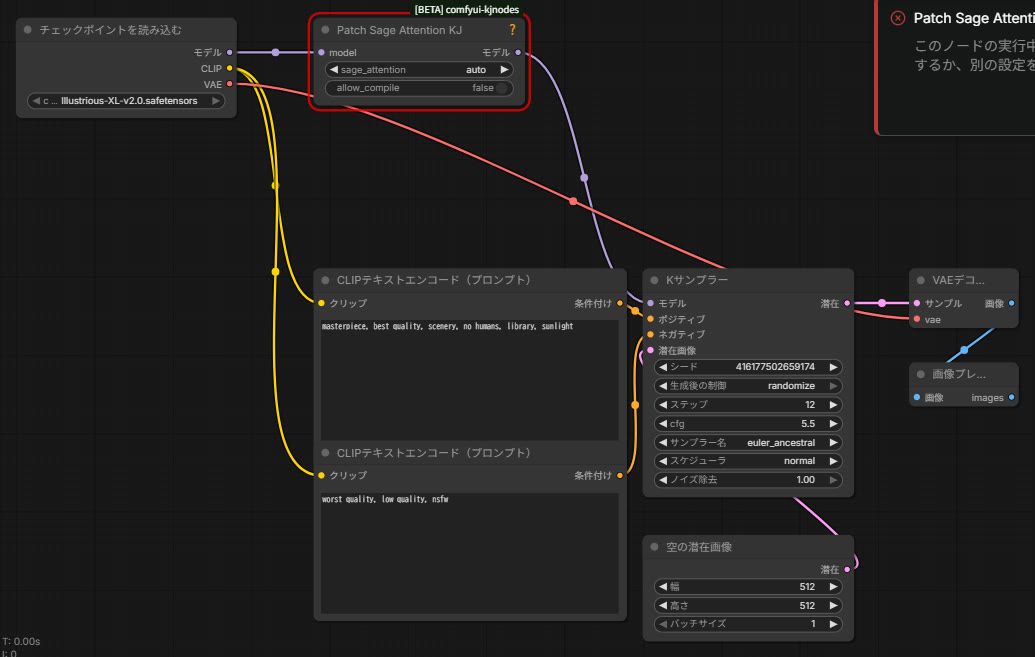
PathchSageAttentionKJ
注意の計算を SageAttention にします(実験的なノード。ノード名のつづりは原文のまま)。
試したこと:「No module named ‘sageattention’」と出ました。sageattention という部品が必要です。
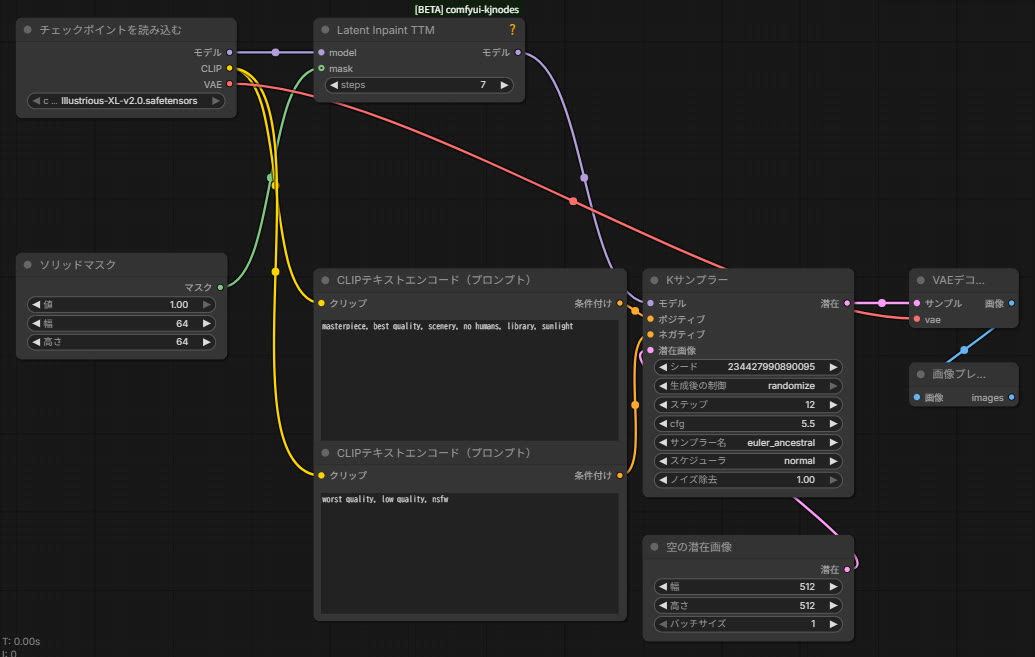
LatentInpaintTTM
TTM(Time-to-Move)という方法で、範囲を描き直します(実験的なノード)。
試したこと:SDXL の画像で、マスクなし・ありの2通りを試し、どちらもエラーになりました。動画モデル用の方法と考えられます。
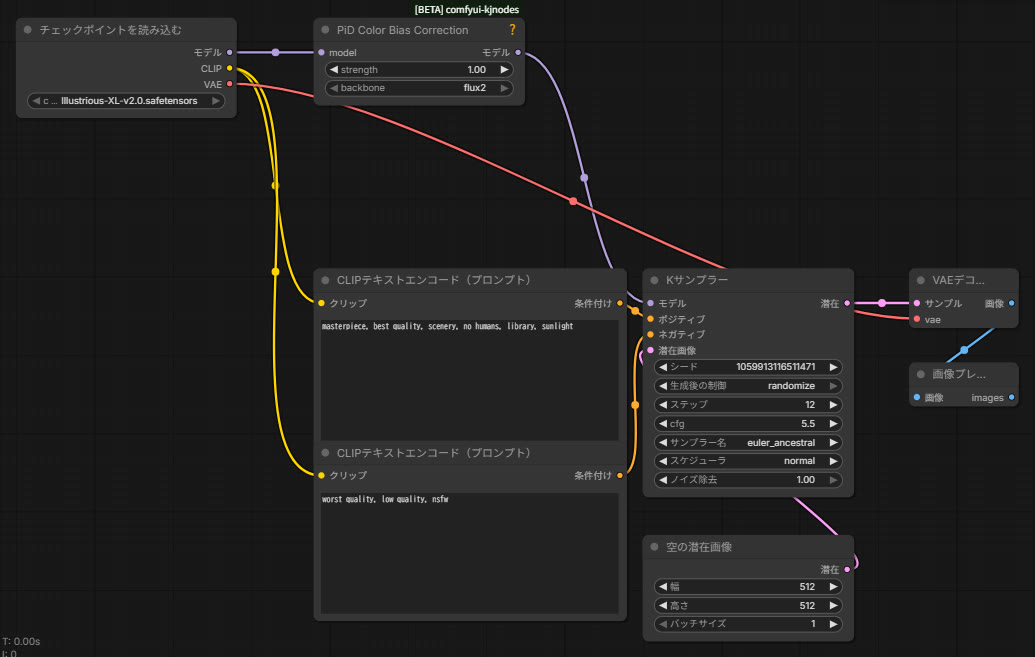
PiDColorBiasCorrection
PiD の4ステップのデコーダーで起きる色のずれを直します(実験的なノード)。flux2 用です。
試したこと:SDXL のモデルにかけて、テンソルの大きさが合わないエラーになりました。
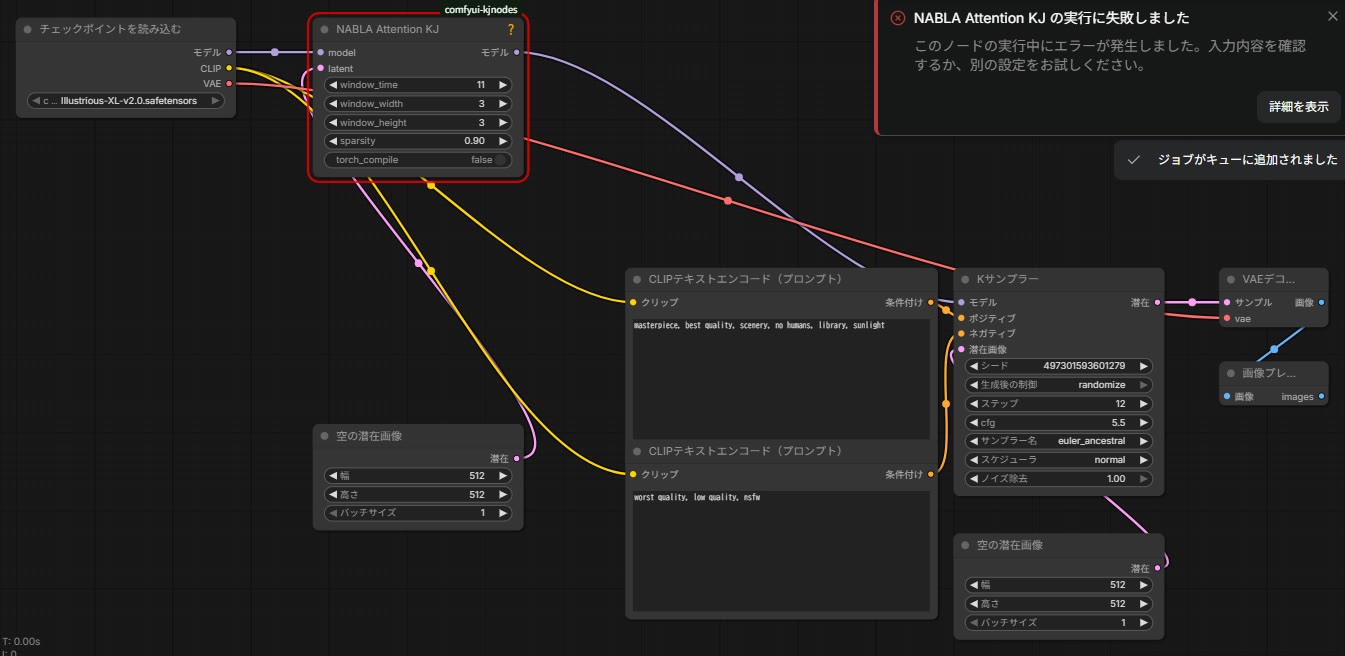
NABLA_AttentionKJ
動画モデル用の NABLA という注意の方法にします。作者の説明では、今は Kandinsky5 でだけ動きます。
試したこと:SDXL のモデルにかけて「not enough values to unpack」のエラーになりました。
専用のモデルや機器が必要なもの(今回は実行していません)
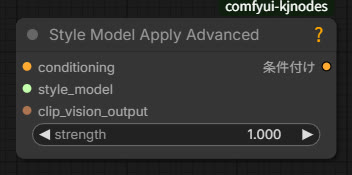
StyleModelApplyAdvanced
スタイルモデル(画像から雰囲気を移すモデル)を、強さを決めてかけます。
試したこと:手元にスタイルモデルがないため、実行していません。
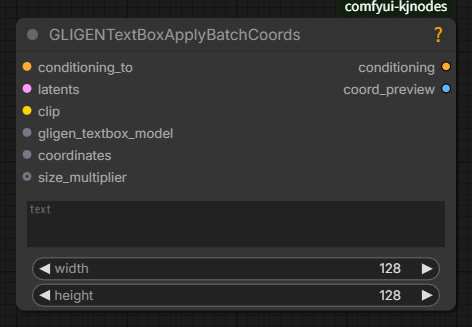
GLIGENTextBoxApplyBatchCoords
GLIGEN の文字の箱の位置を、フレームごとに動かします。作者の説明では、AnimateDiff-Evolved と組み合わせて使います。
試したこと:手元に GLIGEN のモデルがないため、実行していません。
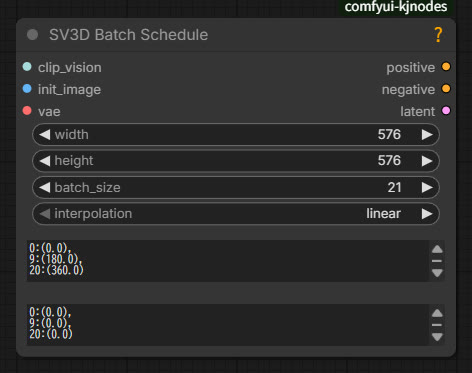
SV3D_BatchSchedule
SV3D(物を回りこんで見た動画を作るモデル)の、角度の予定を決めます。
試したこと:手元に SV3D のモデルがないため、実行していません。
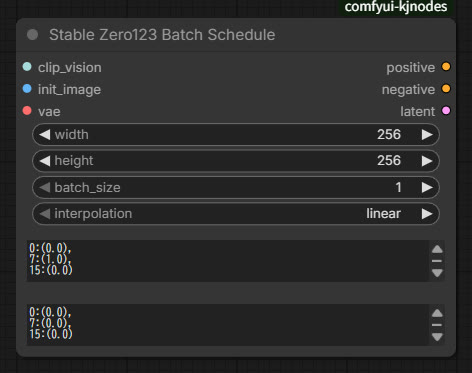
StableZero123_BatchSchedule
Stable Zero123(別の角度からの見た目を作るモデル)の、角度の予定を決めます。
試したこと:手元に Stable Zero123 のモデルがないため、実行していません。
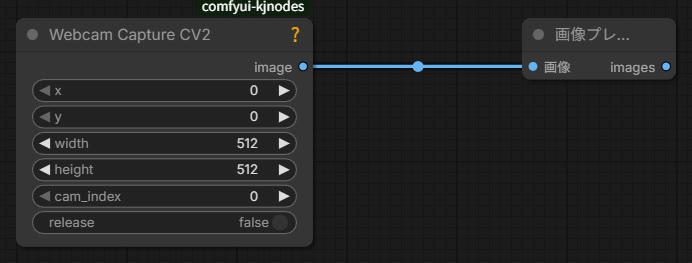
WebcamCaptureCV2
Web カメラの映像を1コマ取り込みます。
試したこと:実行すると筆者の PC のカメラが使われるため、実行していません。
エラー16個の止まり方は4通り
KJNodes を入れただけで動いたのは、39 個中 17 個。このパートは、ほかの部品やモデルが必要なノードが多く、エラーは次の4通りに分かれました。
| 止まった状況 | 個数 | ノード |
|---|---|---|
| 部品が入っていない(torch.compile は triton、FlashAttention は flash_attn、SageAttention は sageattention。試験用の環境には入れていない) | 4 | TorchCompileModelAdvanced、TorchCompileVAE、PatchFlashAttentionKJ、PathchSageAttentionKJ |
| ComfyUI の標準のメモリの確保のしかた(cudaMallocAsync)では記録できない | 2 | StartRecordCUDAMemoryHistory、EndRecordCUDAMemoryHistory |
| 別のカスタムノードや、手元にないモデルが必要 | 4 | GGUFLoaderKJ、TorchCompileControlNet、SetShakkerLabsUnionControlNetType、CustomControlNetWeightsFluxFromList |
| 対象外か、対象外と見られるモデルで試した | 6 | TorchCompileModelFluxAdvancedV2、TorchCompileModelWanVideoV2、CheckpointPerturbWeights、LatentInpaintTTM、PiDColorBiasCorrection、NABLA_AttentionKJ |
- LoraExtractKJ と LoraReduceRankKJ で作った LoRA のファイルは、ComfyUI の output\loras に保存された。実行は約13秒と約4.5秒
- Ideogram4OptimizationsKJ・Krea2PromptWeight は、ほかのモデルにかけてもエラーにはならなかったが、効果は対応するモデルでないと確かめられない
よくある質問(FAQ)
Q. KJNodes で LoRA を軽くするには?
LoraReduceRankKJ を使います。new_rank で小さいランクを決めると、ファイルが小さくなります。筆者の環境では、ランク 32(約149MB)の LoRA をランク 8(約37MB)にできました。
Q. KJNodes で2つのモデルの差から LoRA を作るには?
LoraExtractKJ を使います。finetuned_model に調整したモデル、original_model に元のモデルをつなぎ、rank を決めて実行します。
Q. KJNodes で空き VRAM を確かめるには?
VRAM_Debug を使います。キャッシュを空にするなどの片付けをして、前後の空き VRAM が出ます。筆者の環境では、前後とも約 32.2GB でした。
Q. TorchCompileModelAdvanced で「Cannot find a working triton installation」と出ます
torch.compile に必要な triton が入っていません。筆者の試験用の環境でも同じエラーになりました(入れて試してはいません)。
Q. PathchSageAttentionKJ で「No module named ‘sageattention’」と出ます
sageattention という部品が必要です。筆者の試験用の環境にも入っておらず、同じエラーになりました(入れて試してはいません)。
まとめ
- KJNodes の「モデル・LoRA・メモリ・高速化」に関わる 39 個のうち、動いたのは 17 個。LoRA の抽出・ランクの縮小、VRAM の確認、精度を選んだ読み込みは、KJNodes だけで動いた
- 高速化(torch.compile・SageAttention・FlashAttention)は、別の部品が必要で、今回の環境では動かなかった
- 特定のモデル(Flux・Wan・Kandinsky5 など)用のノードは、そのモデルでないと効果やエラーの有無が変わる
検証メモ
- 「動いた」の範囲:KJNodes と ComfyUI に最初から入っているノードの組み合わせで、ComfyUI が最後まで実行できたという意味です。効果まで確かめたとは限りません。
- 「SDXL のモデル」:ノードの説明にある「SDXL のモデル」は、試験で読み込んだ Illustrious XL v2.0(SDXL 系)のことです。
- 時間:LoRA の約13秒・約4.5秒は、実行を始めてから終わるまでの1回の記録です。
- ダウンロード数:「いちばん」は、2026年10月27日に公式の登録所で確かめた順位です(4,696,142 ダウンロード)。
参考にした資料
- ComfyUI-KJNodes(GitHub・作者のリポジトリ)
- 各ノードの説明は、ComfyUI の画面に表示される作者の説明(ノードの DESCRIPTION)をもとにしました