この記事について(広告・アフィリエイトリンクはありません)
LoRA もモデルも、すべて無料で入手できます。試した環境の一覧は検証の記録にあります。今回は作者の例の1場面だけを試した短報です。
Minimax-H3-VBVR は、MiniMax H3 の画像から動画で、物が増えたり、めり込んだりするのを減らすための LoRA です(142MB)。作者の例の「リンゴを1つずつ袋に入れる」場面で比べると、LoRA ありのほうが1つずつ順に入れる動きになりました。
LoRA なしでも、リンゴが増えるような大きな破綻は出ませんでしたが、2つ目と3つ目の扱いがあいまいになりました。生成時間は LoRA の有無でほとんど変わりません。所要時間は15分ほど、難しさは中級です。
先に結論(今回のテスト条件で)
| 条件 | 時間 | リンゴの扱い |
|---|---|---|
| LoRA なし | 433.7秒(モデルの読み込みを含む) | 1.5秒の時点で台の上が1個に減り、2個がほぼ同時に動いた |
| LoRA 0.6 | 100.5秒 | 1つずつ手に取って袋へ。最後は台が空、増えたリンゴなし |
| LoRA 1.0 | 101.1秒 | 1つずつ手に取って袋へ。最後は台が空、増えたリンゴなし |
MiniMax H3 fl2va int8、テキストエンコーダーは NVFP4 版、1056×608・約4.5秒(107フレーム)、20ステップ(res_multistep)、シード42。入力の画像とプロンプトは、作者の検証用の1番(果物屋でリンゴ3つを袋に入れる)です。LoRA なしの回は最初の回で、モデルの読み込みを含みます。
Minimax-H3-VBVR とは?
LiconStudio/Minimax-H3-VBVR は、VBVR という動画の推論用のデータを H3 向けに作り直して学習した、画像から動画(I2V)用の LoRA です。作者は、物の一貫性と人の動きの筋道がよくなり、物が増える・めり込むことが減ると説明しています。2026年10月23日に公開されました。
Hugging Face には、LoRA なし(original)と LoRA あり(VBVR)を並べた検証用の動画が6本あります。強さやステップ数のおすすめは書かれていません。
導入
H3-Licon-VBVR-I2V.safetensors(142MB)を models/loras に入れ、H3 の画像から動画のワークフローで、UNETLoader のあとに LoraLoaderModelOnly をつなぎます。コンソールに「lora key not loaded」の警告は出ませんでした。
リンゴを袋に入れる場面で比べる
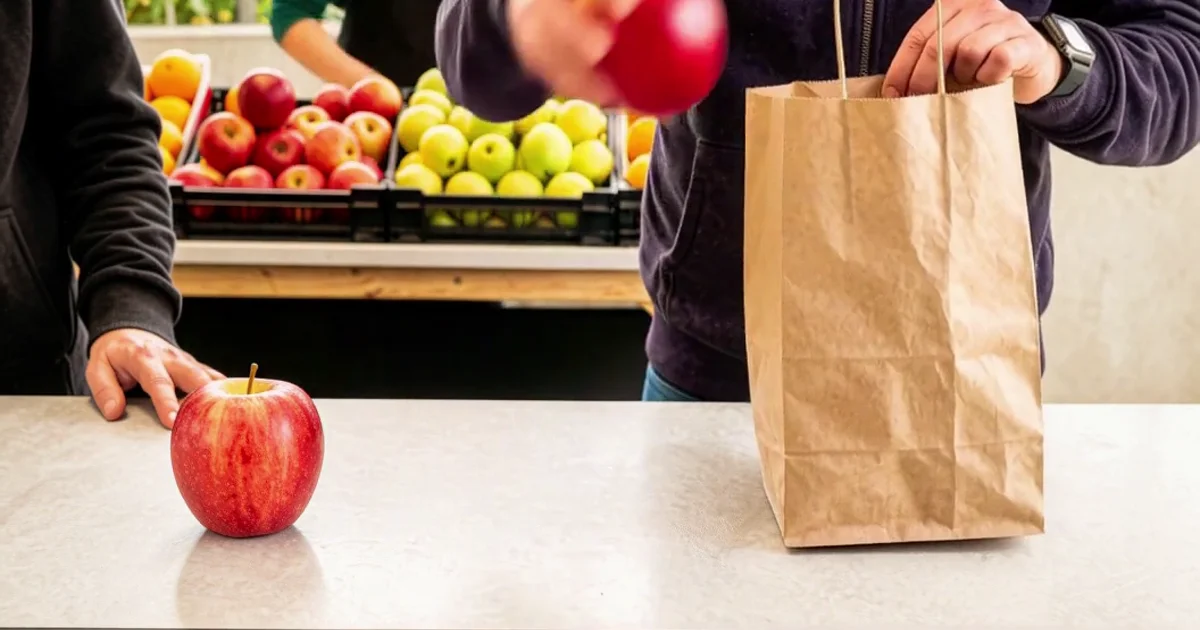
プロンプトは、客が袋を開け、台の上のリンゴ3つを1つずつ入れ、最後は台が空で袋に3つ、という内容です(作者の検証用のもの)。
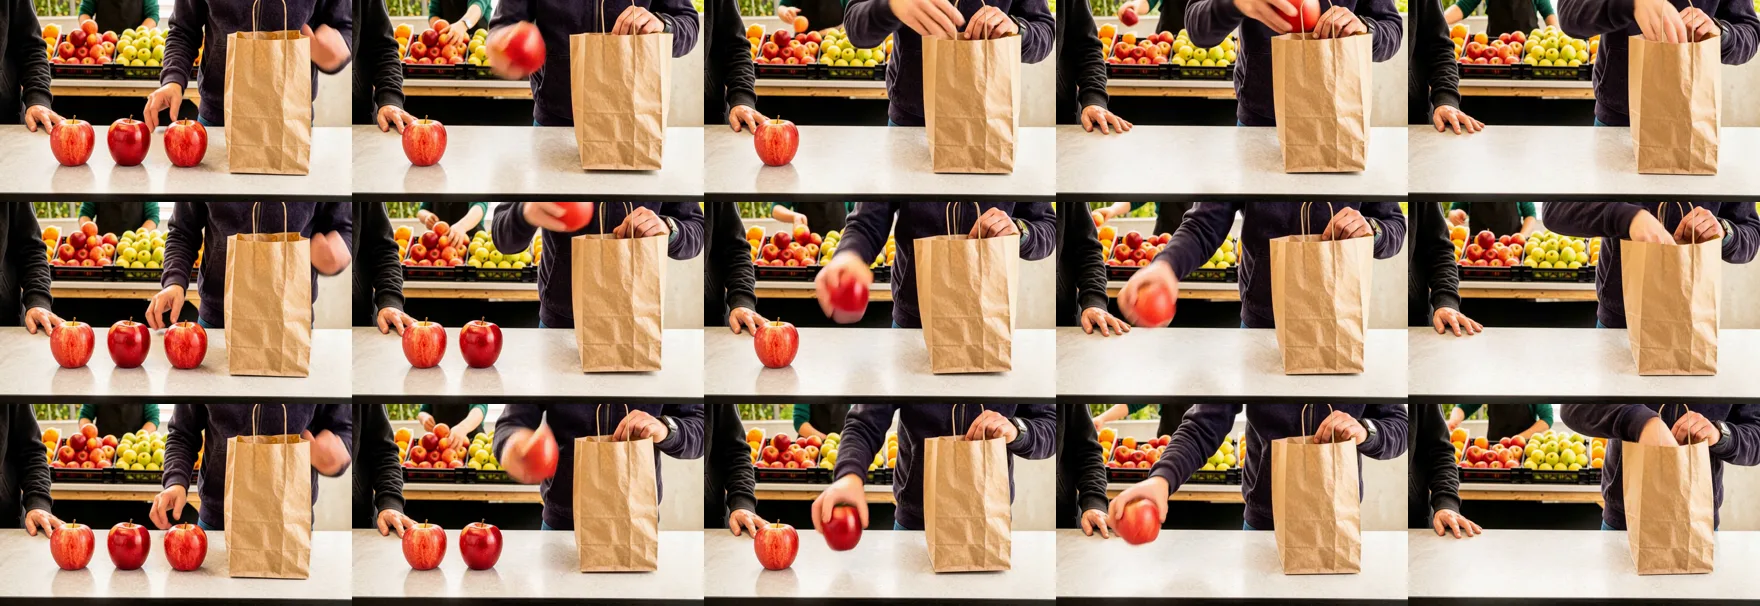
LoRA ありは、0.6 でも 1.0 でも、台の上のリンゴが 3→2→1→0 と1つずつ減り、手に1つ持って袋に入れる流れになりました。LoRA なしは、1.5秒の時点で台の上が1つになり、2つがほぼ同時に動いていました。どの条件でも、リンゴが増える・袋をすり抜けるといった目立つ破綻はありませんでした。
1場面・1シードだけの結果なので、効果の大きさは言い切れません。それでも「順番どおりに1つずつ」という指示への従い方には、はっきり差が出ました。
商用で使える?
Hugging Face の表示は Apache-2.0 ですが、元になる MiniMax H3 は MiniMax H3 Community License(EU・英国・韓国・米国は対象外、年商2,000万ドルを超える商用は MiniMax の書面の許可が必要)です。派生した LoRA にどちらの条件がかかるかは表示だけでは判断できないため、商用で使う場合は両方の条件を確かめてください。くわしくはH3 の導入編で説明しています。
よくある質問(FAQ)
Q. Minimax-H3-VBVR とは?
MiniMax H3 の画像から動画で、物が増える・めり込むのを減らすための LoRA です。ふつうの LoRA ローダーで使えます。
Q. 効果はある?
作者の例の1場面では、LoRA ありのほうがリンゴを1つずつ順に袋へ入れる動きになりました。1場面だけの結果です。
Q. 遅くなる?
LoRA の有無で生成時間はほとんど変わりませんでした(1056×608・約4.5秒で約100秒)。
まとめ
Minimax-H3-VBVR は、142MB を足すだけで、物の扱いの順番が整う方向に効きました。物を数えたり、つかんで置いたりする場面で試す価値があります。
物を扱う場面の I2V に、強さ 0.6〜1.0 で足す。
検証メモ
- ワークフロー:ComfyUI 標準のノードの H3 画像から動画(Freefield の H3 Photo to Video と同じ組み方)に、LoraLoaderModelOnly を足しました。
- 時間:ComfyUI の execution_start から execution_success まで。LoRA なしはモデルの読み込みを含むため、LoRA の有無での速さの比較にはなりません(LoRA あり2回は同じくらい)。
- 試していないこと:ほかの5つの検証用の場面、複数のシード、複数人がすれ違う場面、文字から動画、Turbo LoRA などとの組み合わせ。