この記事について(広告・アフィリエイトリンクはありません)
ノードもモデルも、すべて無料で入手できます。試した環境の一覧は検証の記録にあります。
HyperFlow H3 Flash は、MiniMax H3 を剪定・圧縮して GGUF にした、少ないステップで動く版です。RTX 5090 で、1344×768・5秒の音声つき動画が、6ステップで約1分47秒、GPU のメモリは最大約21GB でした。
ふつうの H3(int8、20ステップ)は同じ条件で約5分51秒、メモリはほぼいっぱい(約30GB)でした。一方で、1ステップあたりは H3 より遅く(15秒と12.5秒)、速さはステップ数が少ないことから来ています。所要時間は30分ほど(モデル 8.4GB のダウンロードを除く)、難しさは中級です。
先に結論(今回のテスト条件で)
| 方法 | サンプリング | 全体の時間 | GPU のメモリ(最大) |
|---|---|---|---|
| HyperFlow Q4_K_M・4ステップ | 60秒 | 2分8秒 | 約21.2GB |
| HyperFlow Q4_K_M・6ステップ(既定) | 90秒 | 1分47秒 | 約21.2GB |
| HyperFlow Q4_K_M・8ステップ | 120秒 | 2分15秒 | 約21.2GB |
| ふつうの H3(fl2va int8)・20ステップ | 249秒 | 5分51秒(モデルの読み込みを含む) | 約30.2GB |
作者のテンプレート(t2v)のまま、1344×768、124フレーム(約5秒)、シード42、テキストエンコーダーは NVFP4 版、映像の VAE は fp16。ふつうの H3 は、本体だけ fl2va int8 に替え、res_multistep・20ステップにしました。全体の時間は、テキストエンコーダーの読み直しや VAE のデコードで回ごとにばらつき、4ステップの回が6ステップより長くなっています。
HyperFlow H3 Flash とは?
VideoRebirthAI/hyperflow-h3-flash は、H3 の動画モデル(fl2va と ref2va)を剪定・低ランク化して、4〜8ステップで動くように学習した版です。以前の HyperFlow は LoRA でしたが、今回はモデルそのものを GGUF(Q3_K_M〜Q8_0)で配っています。fl2va の Q4_K_M は 8.4GB です。
ComfyUI では、専用のノード ComfyUI-HyperFlow-Flash(GPL-3.0)の「HyperFlow GGUF Loader」と「HyperFlow Sigmas」を使います。文字から動画(t2v)、画像から動画(i2v)、最初と最後の画像(flf2v)、参照(ref2v)の4つのテンプレートが付いています。
導入
cd ComfyUI\custom_nodes
git clone https://github.com/city96/ComfyUI-GGUF
git clone https://github.com/Video-Rebirth/ComfyUI-HyperFlow-Flash
..\..\python_embeded\python.exe -m pip install -r ComfyUI-HyperFlow-Flash\requirements.txt
ComfyUI 0.43.0 以降と ComfyUI-GGUF が必要です。今回の ComfyUI 0.44.0 では、gguf のパッケージがすでに入っていて、追加の導入は要りませんでした。
models/diffusion_models:minimax_h3_fl2va_hyperflow_flash_14b-Q4_K_M.gguf(8.4GB)models/text_encoders:qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors(H3 と共通)models/vae:minimax_h3_video_vae_fp16 と minimax_h3_audio_vae_fp32(H3 と共通)
テンプレートは、ComfyUI の「ワークフロー → テンプレートを参照 → ComfyUI-HyperFlow-Flash」に出ます。作者は、メインメモリが16〜32GB の PC では起動に --fast-disk を付けるよう勧めています(今回は 128GB のため付けていません)。
4ステップ・6ステップ・8ステップと、ふつうの H3
テンプレートのプロンプト(夕方の石畳の街角でギターを弾くストリートミュージシャン。カメラは引きから寄りへ。路面電車のベルの音)で比べました。
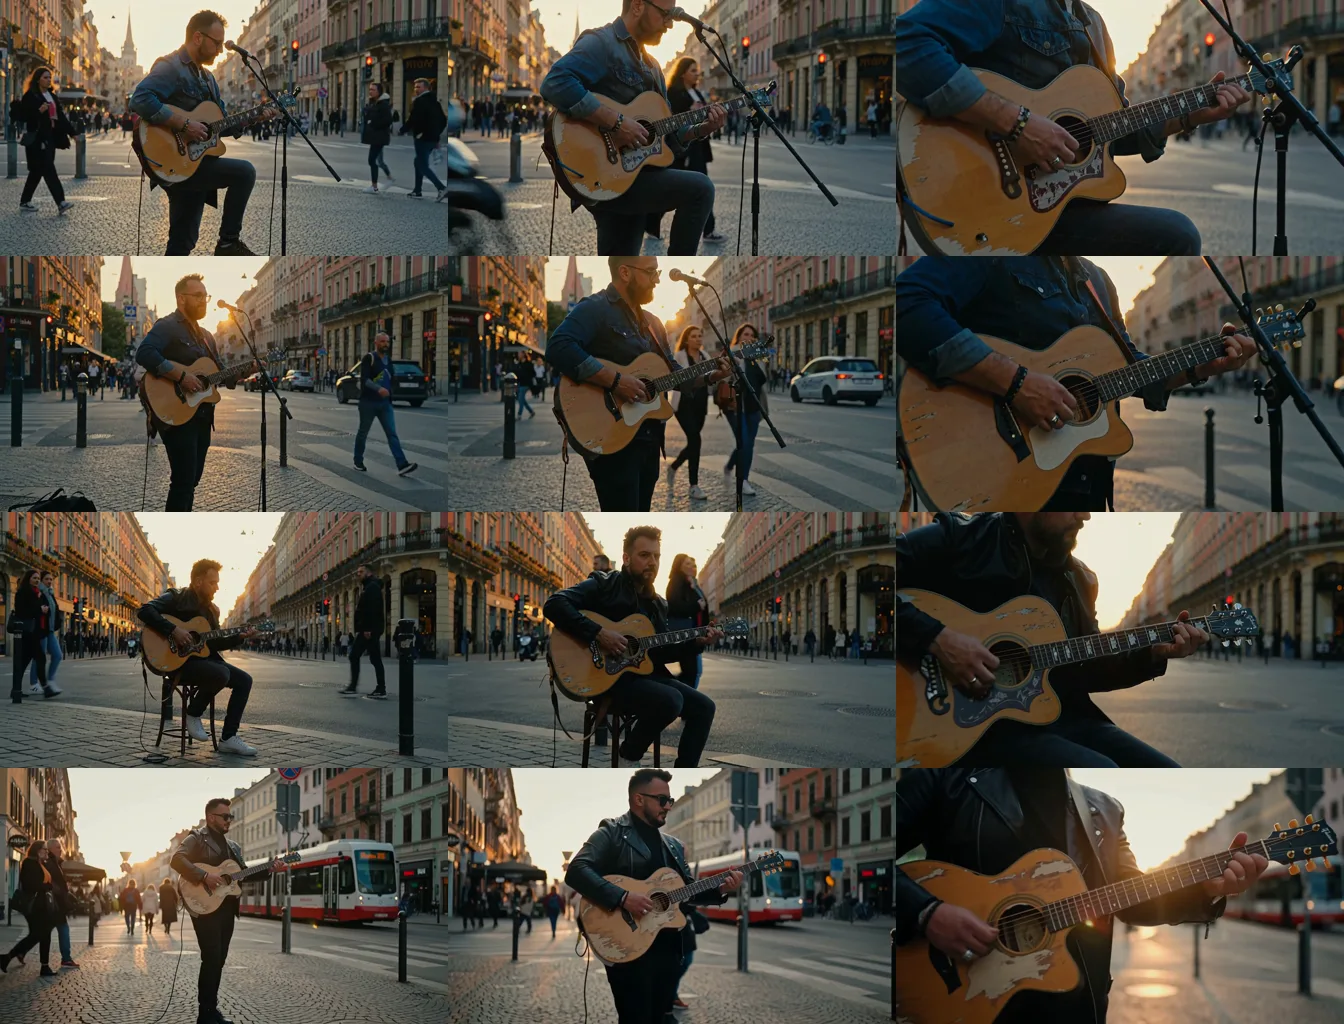
どのステップ数でも、カメラが手元へ寄る動き、ギターや指の形は崩れませんでした。4ステップでも見た目の破綻はなく、6・8ステップとの差は人物や服の違い(シードは同じでも構図が変わる)くらいです。ふつうの H3 は、プロンプトの路面電車が画面に入り、背景の作り込みが少し細かくなりました。
速さの内訳を見ると、HyperFlow は1ステップ約15秒で、ふつうの H3(約12.5秒)より遅めでした。GGUF を読みながら計算するぶんの手間があるためと思われます。速さは、20ステップを6ステップに減らせることから来ています。
商用で使える?
ノードのコードは GPL-3.0 です。モデルの重みは MiniMax H3 の派生物で、MiniMax H3 Community License に従います(EU・英国・韓国・米国では MiniMax の許可が必要、年商2,000万ドルを超える商用の製品・サービスは事前の書面の許可が必要)。くわしくはH3 の導入編で説明しています。
よくある質問(FAQ)
Q. HyperFlow H3 Flash とは?
MiniMax H3 を剪定・圧縮して GGUF にした、4〜8ステップで動く版です。fl2va の Q4_K_M は 8.4GB で、専用のノード ComfyUI-HyperFlow-Flash で使います。
Q. どれくらい速い?
RTX 5090 で、1344×768・5秒の動画が6ステップで約1分47秒でした。ふつうの H3(int8、20ステップ)は約5分51秒でした。
Q. VRAM はどれくらい使う?
Q4_K_M で最大約21GB でした。ふつうの H3 は約30GB でほぼいっぱいでした。
まとめ
HyperFlow H3 Flash は、H3 の動画を3分の1ほどの時間と、10GB ほど少ないメモリで作れました。1ステップは遅めですが、6ステップで十分な画質が出るので、全体では大きく速くなります。
Q4_K_M と NVFP4 のテキストエンコーダーで、6ステップから。
検証メモ
- 時間:ComfyUI の execution_start から execution_success まで。表の HyperFlow の行は、モデルを読み込んだあとの回です(最初の回は読み込み込みで3分40秒)。サンプリングは進捗表示の値です。
- メモリ:nvidia-smi で0.5秒ごとに見た、GPU 全体の使用量の最大値です(画面表示のぶんを含みます)。
- 比べ方の注意:ふつうの H3 は、Sol-Attn などの高速化なしの20ステップです。TaoMate や Pika Flex など、ほかの少数ステップの方法とは同じ条件で比べていません。
- 試していないこと:Q8_0 や Q3_K_M、i2v・flf2v・ref2v、15秒(362フレーム)の長さ、–fast-disk、VRAM 24GB 以下のカード。