この記事について(広告・アフィリエイトリンクはありません)
使ったモデルとソフトは、すべて無料で入手できます。試した環境の一覧は検証の記録にあります。
Qwen-Image-2.1 Uncensored Omni を ComfyUI で使うなら、RTX 5090 では INT8 ConvRot か NVFP4 が速くておすすめです。 作者の推奨設定(35ステップ・CFG 5)で、1枚が FP8 の 16.2秒に対して、INT8 ConvRot は 11.8秒、NVFP4 は 10.3秒でした。
どれもカスタムノードなしの「拡散モデルを読み込む」で読めます。ライセンスは非商用のみです。所要時間は20分ほど、難しさは初心者向けです。
先に結論(今回のテスト条件で)
| ファイル | 大きさ | 1枚の時間 | 生成後の VRAM 使用量(全体) |
|---|---|---|---|
| 公式ベース bf16(参考、Omni ではない) | 14.2GB | 24.9秒 | 22.7GB |
| Omni FP8 | 7.1GB | 16.2秒 | 16.0GB |
| Omni INT8 ConvRot | 7.3GB | 11.8秒 | 16.2GB |
| Omni NVFP4 | 4.2GB | 10.3秒 | 13.4GB |
1024×1024、35ステップ、CFG 5、er_sde・simple、ComfyUI 0.44.0。時間は各6枚の平均で、どれもほとんどばらつきませんでした。
Uncensored Omni とは?
Chatr Labs が公開している、Qwen-Image-2.1 の派生モデルです。作者は、自分たちの rank-128 の LoRA(Omni アダプター)を Qwen-Image-2.1 に強さ 1.0 でまとめ、量子化したもの、と説明しています。1つのモデルで、文字から画像と、言葉での画像編集の両方に使えるとされています。
名前のとおり、成人向けの内容も出せるように学習したものです。この記事では成人向けの画像は作っていません。
配布されているのは拡散モデル(トランスフォーマー)だけで、テキストエンコーダーと VAE は公式の Qwen-Image-2.1 のものを使います。作者のページには、学習のステップ数(ファイル名の step90000)は書かれていますが、学習枚数は書かれていません。
どのファイルを選ぶ?
作者の表ではファイルが13種類あり、ComfyUI でカスタムノードなしに使えるのは、名前の最後が -comfy.safetensors の3つです。
| ファイル | 大きさ | ComfyUI での読み方 |
|---|---|---|
| qwen-image-2.1-step90000-FP8-comfy.safetensors | 7.1GB | 拡散モデルを読み込む |
| qwen-image-2.1-step90000-INT8-ConvRot-comfy.safetensors | 7.3GB | 拡散モデルを読み込む |
| qwen-image-2.1-step90000-NVFP4-comfy.safetensors | 4.2GB | 拡散モデルを読み込む |
| GGUF(BF16・Q8_0〜Q4_0 の6種) | 3.9〜13.3GB | カスタムノード(ComfyUI-GGUF)が要る |
| フォルダーに入ったもの(FP8-torchao など) | — | diffusers 用。ComfyUI では読めない |
作者の説明では、ComfyUI 用(265 個の重み、MLP が1つにまとまった形)と diffusers 用(297 個、MLP が2つに分かれた形)は互換がなく、取り違えると読み込みに失敗します。この記事では、カスタムノードが要る GGUF は試していません。
作者の推奨設定
| 設定 | 値 |
|---|---|
| ステップ数 | 35 |
| CFG | 5.0(文字から画像・編集とも) |
| サンプラー・スケジューラ | er_sde・simple |
| ネガティブプロンプト | 半角の空白1つ |
| 解像度 | 768×1152 か 1024×1024 |
作者によると、ネガティブプロンプトを空にすると CFG が効かなくなるので、指定がなくても空白を1つ入れます。数ステップで作れるように蒸留したものではないので、ステップ数は減らせません。
ComfyUI での使い方
公式の Qwen-Image-2.1 のワークフローで、「拡散モデルを読み込む」のファイルを差し替え、KSampler を上の推奨設定にします。
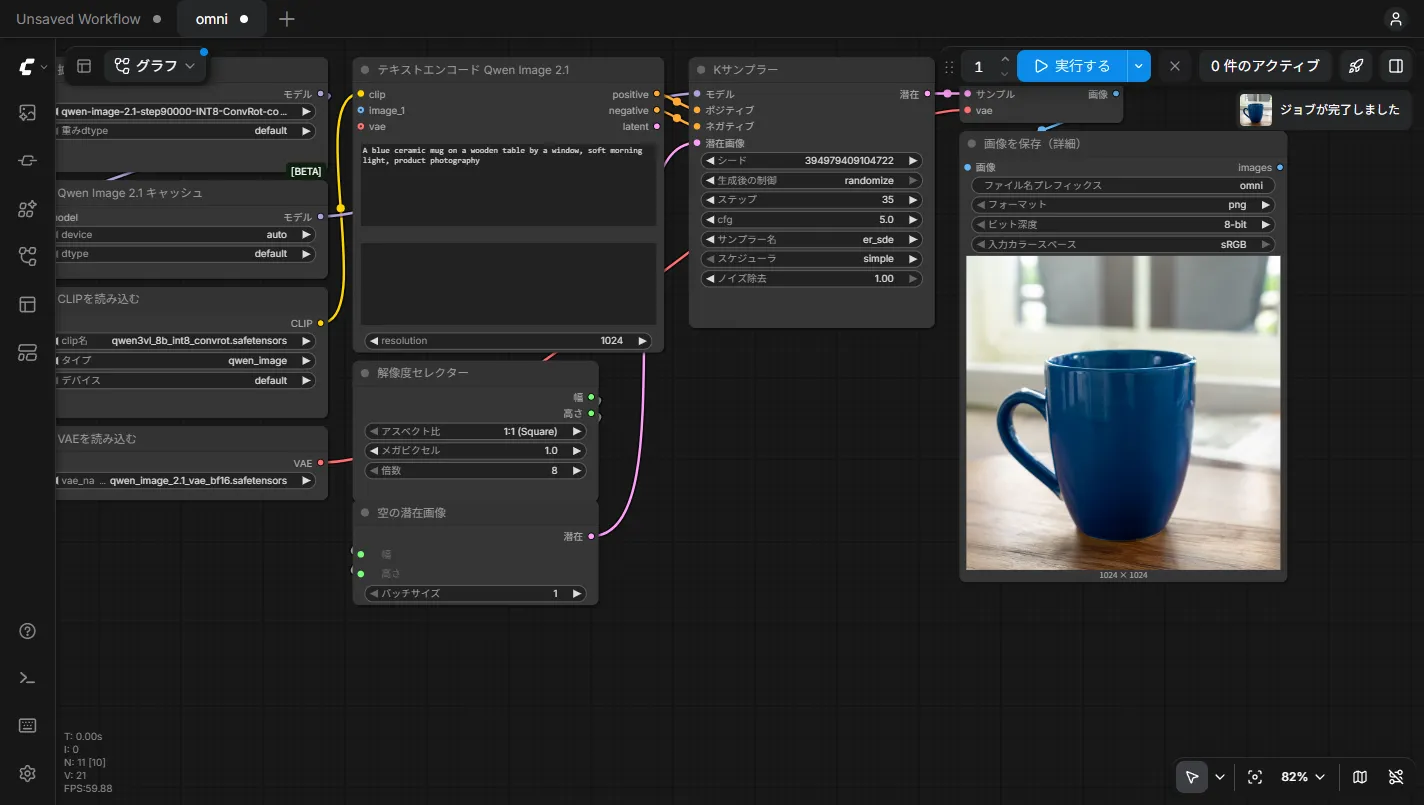
- Qwen-Image-2.1 Uncensored Omni(INT8 ConvRot)のワークフロー(JSON)公式テンプレートのサブグラフを展開し、推奨設定にしたものです。カスタムノードは不要です
RTX 5090 で試すとどうなる?
マグカップ、漁師の写真、文字入りのポスターの3つのプロンプトを、シード 42 と 7 で作りました。比較のために、公式のベース(bf16)も同じ設定で作っています。
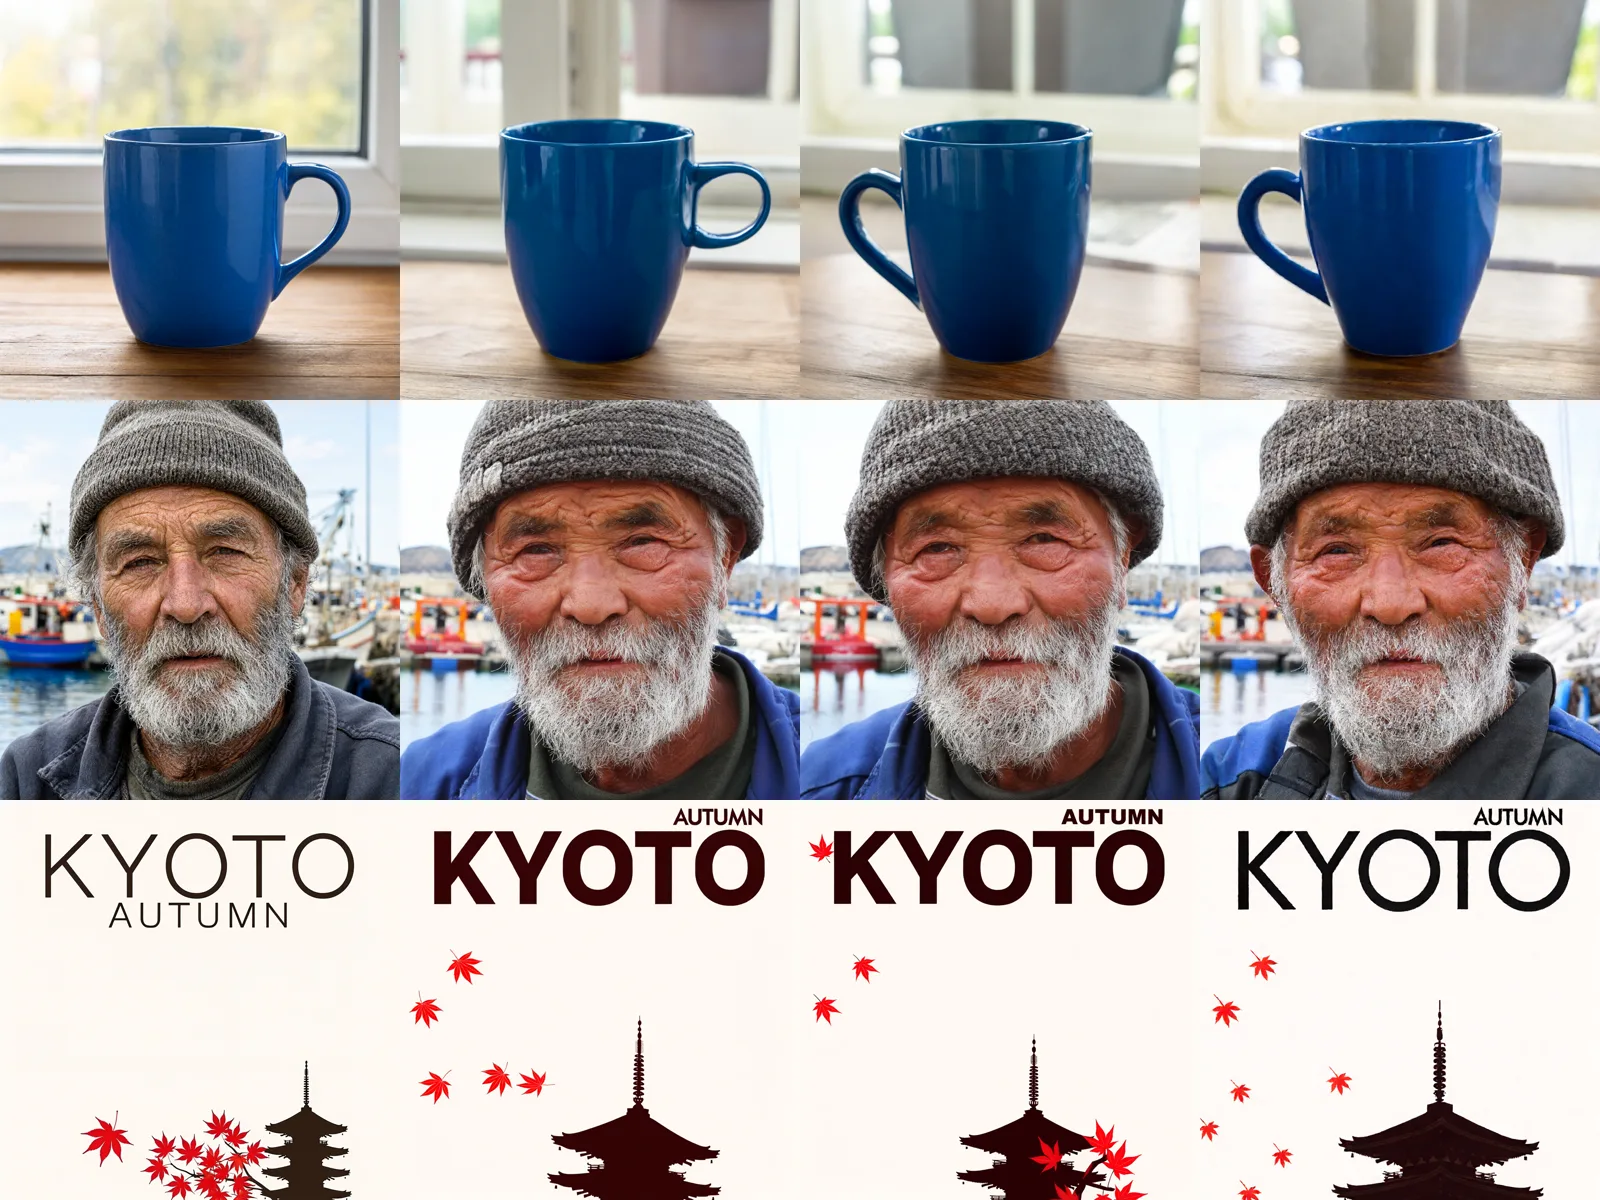
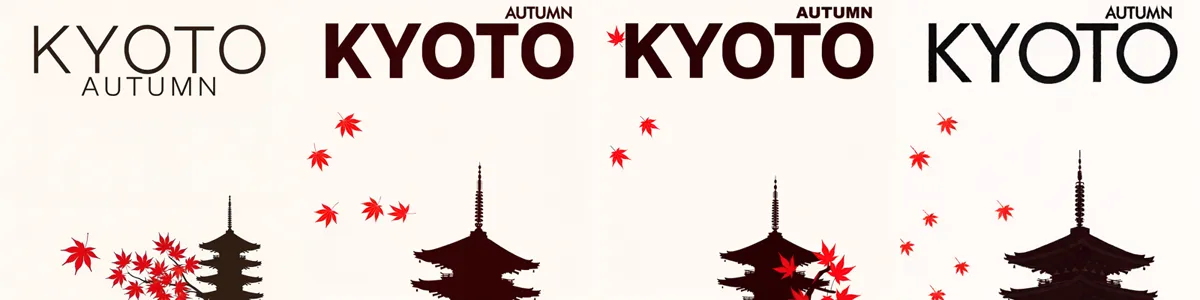
Omni の3つは、構図や人物の顔立ちがよく似ていました。漁師の写真は FP8 と INT8 ConvRot でほとんど見分けがつきません。マグカップは持ち手の向きが FP8 だけ右になり、NVFP4 はポスターの文字の書体や細部が少し変わりました。
公式ベースと比べると、Omni は同じシードでも別の絵になりました。漁師の写真では、Omni のほうが顔が大きく写り、肌の赤みと彫りが強く出ています。ポスターでは、ベースは「KYOTO AUTUMN」と2行を正しく描きましたが、Omni の3つは「AUTUMN」が右上に小さく置かれました。
どれくらい速くなる?
同じ35ステップで、公式ベース bf16 の 24.9秒に対して、FP8 は約1.5倍、INT8 ConvRot は約2.1倍、NVFP4 は約2.4倍速くなりました。RTX 5090 は FP8・INT8・NVFP4 の計算に対応しているので、量子化した分だけ計算そのものが速くなります。
NVFP4 と FP8・INT8 の速さの違いは、Z-Image-Turbo での比較でも確かめています。
使ったモデル
| ファイル | 大きさ | 置き場所 |
|---|---|---|
| Omni の3ファイル(上の表) | 4.2〜7.3GB | models\diffusion_models |
| qwen3vl_8b_int8_convrot.safetensors | 8.7GB | models\text_encoders |
| qwen_image_2.1_vae_bf16.safetensors | 0.6GB | models\vae |
| qwen_image_2.1_bf16.safetensors(比較用) | 14.2GB | models\diffusion_models |
商用で使える?
使えません。ライセンスは Qwen RESEARCH LICENSE AGREEMENT(2026年9月20日版)で、研究と評価の目的(非商用)に限って使えます。商用で使うには、Qwen の提供元に別に許諾を受ける必要があります。
RTX 5090 以外の人へ
NVFP4 の計算に対応しているのは RTX 50 シリーズ(Blackwell)です。それより前の GPU では NVFP4 の速さは出ない可能性が高いので、INT8 ConvRot か FP8 を選びます。VRAM が 16GB 以下なら、ファイルが小さい NVFP4(4.2GB)や INT8 ConvRot のほうが収まりやすくなります。
--reserve-vram での簡易テストはしていません。表の VRAM の値は、生成のあとに ComfyUI 全体で使われていた量で、テキストエンコーダーなどを含みます。
よくある質問(FAQ)
Q. Qwen-Image-2.1 Uncensored Omni はどのファイルを選べばいい?
ComfyUI でカスタムノードなしに使うなら、名前が -comfy.safetensors の3つ(FP8・INT8 ConvRot・NVFP4)です。RTX 5090 では NVFP4 が 10.3秒、INT8 ConvRot が 11.8秒、FP8 が 16.2秒でした。
Q. ネガティブプロンプトは空でいい?
作者によると、空にすると CFG が効かなくなります。指定がなくても半角の空白を1つ入れます。
Q. Uncensored Omni は商用で使える?
使えません。ライセンスは Qwen RESEARCH LICENSE AGREEMENT で、研究と評価の目的(非商用)に限られます。
まとめ
Uncensored Omni は、ComfyUI 用の3つのファイルなら、カスタムノードなしで公式のワークフローに差し替えるだけで使えます。
RTX 50 シリーズなら NVFP4、迷ったら INT8 ConvRot。設定は35ステップ・CFG 5・ネガティブに空白1つ。
検証メモ
- 方法:公式テンプレート(Qwen Image 2.1 文字から画像)のサブグラフを展開し、拡散モデルと KSampler の設定だけを変えて API から実行しました。モデルごとに1枚ならしてから、3つのプロンプト×シード2つを作っています。時間は ComfyUI の実行開始から完了までです。
- ファイルの確認:3つとも、配布元の SHA-256 と一致することを確かめました。
- 比べなかったもの:Omni の bf16(GGUF・diffusers 用のみ)、GGUF、LoRA 版(step32000)、画像編集。速さの比較の基準は、Omni ではなく公式ベースの bf16 です。
- 未確認のこと:VRAM の少ない GPU、RTX 40 シリーズ以前での NVFP4、作者のいう学習枚数(約100万枚という発表文の主張)。