この記事について(広告・アフィリエイトリンクはありません)
紹介しているモデルは無料で入手できます。ライセンスの地域の条件は後述します。この記事の画像は AI で生成したものです。
P-H3-Image は、PrunaAI が MiniMax H3 をもとに作った画像モデルです。2912×2912 の 8MP を8ステップで作り、最大8枚の画像を使った編集もできるとされています。
ComfyUI の標準ノードだけで動きました。RTX 5090 で 8MP が約11秒です。w4a8 版の VRAM ピークは約20.8GB で、公式の「21GB」とほぼ同じでした。6ステップで速くする方法はP-H3-Image の Turbo LoRA の記事で試しています。
まず試すなら w4a8(今回のテスト条件で)
| 構成(2912×2912、8 ステップ) | アップサンプラー | 1枚(2枚目以降の中央値) | VRAM ピーク |
|---|---|---|---|
| w4a8 | なし | 11.0秒 | 20.8GB |
| int8 | なし | 11.2秒(2枚目の1回) | 29.5GB |
| LoRA + H3 FL2VA pruned int8 | なし | 13.8秒(2枚目の1回) | 30.5GB |
| w4a8 | bf16 | 11.4秒 | 約31GB |
int8 と LoRA の行は、アップサンプラーなしで別に作った各2枚の値です。アップサンプラー bf16 ありで15枚ずつ作ったときは、int8 が 11.2秒・約31GB、LoRA が 13.5秒・約31GB でした。
- まず試すなら w4a8 です。今回は int8 との時間の差がほとんどなく、VRAM は約9GB 少なく済みました。
- 短いプロンプトではアップサンプラーを入れたほうが安定しました。使わない場合は5枚中1枚で画像の上下に白い帯が出ました。
- 最初の1枚は、モデルの読み込みで2〜6分かかりました(モデルは USB の HDD)。
看板の「ラーメン」は、見た範囲ではどの条件でも読めました。小さいメニューの文字は崩れます。
ComfyUI は v0.44.0 以降が必要で、配布ページの「nightly が必要」より先に、v0.44.0 のタグに対応が入っていました。
試した環境
| 項目 | 内容 |
|---|---|
| GPU | RTX 5090(32GB) |
| CPU / RAM | Ryzen 9 9950X3D / 128GB |
| OS | Windows 11 |
| ComfyUI | v0.44.0 2c75dc1b(別のフォルダーに用意)。カスタムノードなし |
| PyTorch | 2.14.0+cu130 |
| サンプラー | euler、公式の8ステップのシグマ、CFG なし |
| シード | 101、202、303、404、505 |
| 検証日 | 2026年11月4日 |
ComfyUI を v0.44.0 以降にして、ファイルを置くだけ
- ComfyUI を v0.44.0 以降にします。更新の方法はこちらにまとめています。
- 下のファイルを置きます。カスタムノードは要りません。
| ファイル | サイズ | 置き場所 |
|---|---|---|
| p-h3-image_w4a8.safetensors | 13.4GB | models\diffusion_models |
| p-h3-image_text_encoder_w4a8.safetensors | 3.6GB | models\text_encoders |
| p-h3-image_vae_int8_convrot.safetensors | 3.1GB | models\vae |
| p-h3-image_prompt_upsampler_bf16.safetensors | 19.3GB | models\text_encoders |
アップサンプラーは、短い依頼を詳しいプロンプトに書き直すモデルです。容量を抑えるなら w4a8 版(6.7GB)もあります。
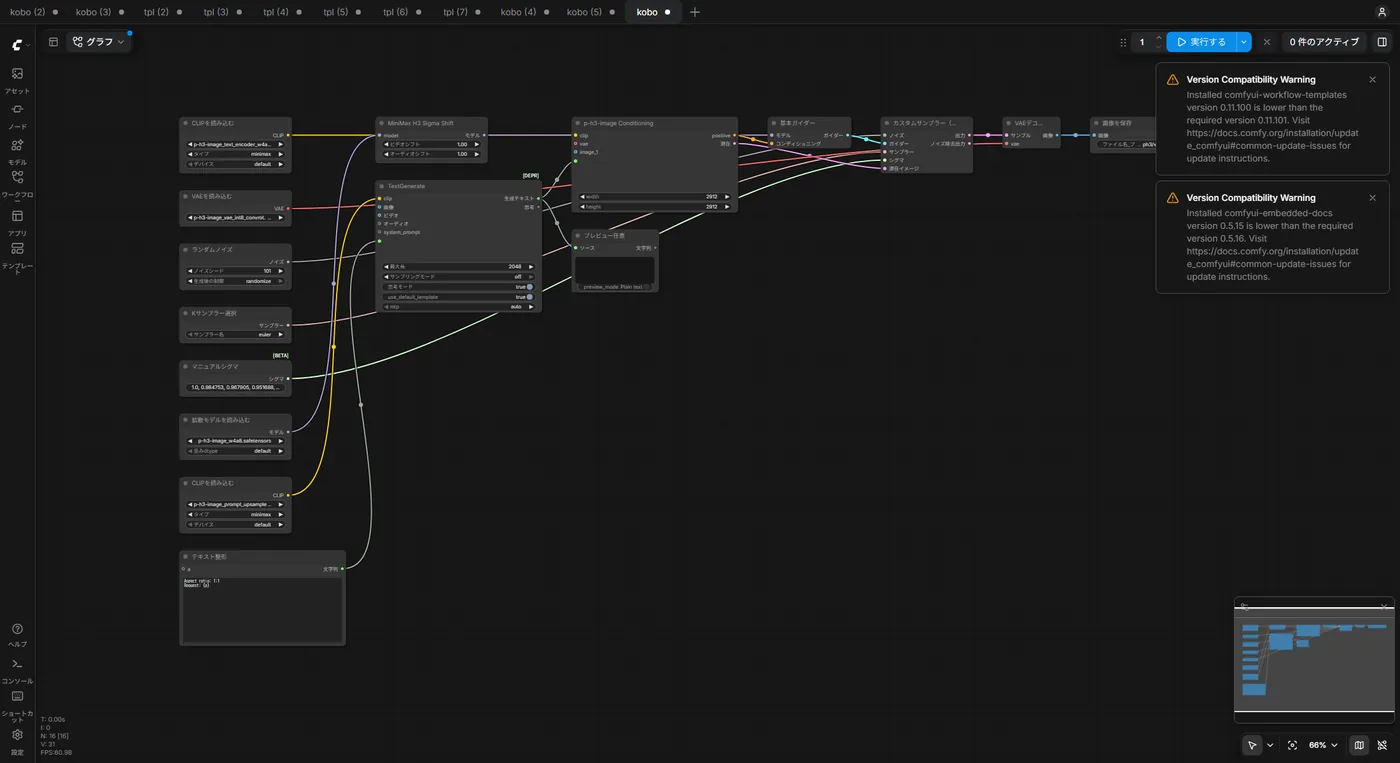
下の JSON は、公式のワークフローの構成を上のファイルに合わせたものです。
- p_h3_image_t2i_workflow.jsonComfyUI にドラッグして読み込みます(8MP、8 ステップ。w4a8 + bf16 のアップサンプラー。カスタムノードなし)
- p_h3_image_edit_workflow.jsonComfyUI にドラッグして読み込みます(8MP、8 ステップ。w4a8 + bf16 のアップサンプラー。カスタムノードなし)
どちらも画面から実行して、成功を確かめました。編集のほうは、画像を2枚選び直してください。公式のワークフローは配布ページの workflows にあります。
古い ComfyUI でテンプレートを開くとどうなる?
v0.43.0 で公式のテンプレート(p-h3-image_text_to_image.json)を開くと、PH3ImageConditioning のノードだけが赤くなりました。 テンプレートが使うノードを v0.43.0 のノード一覧と照らし合わせると、足りないのはこの1つだけです。
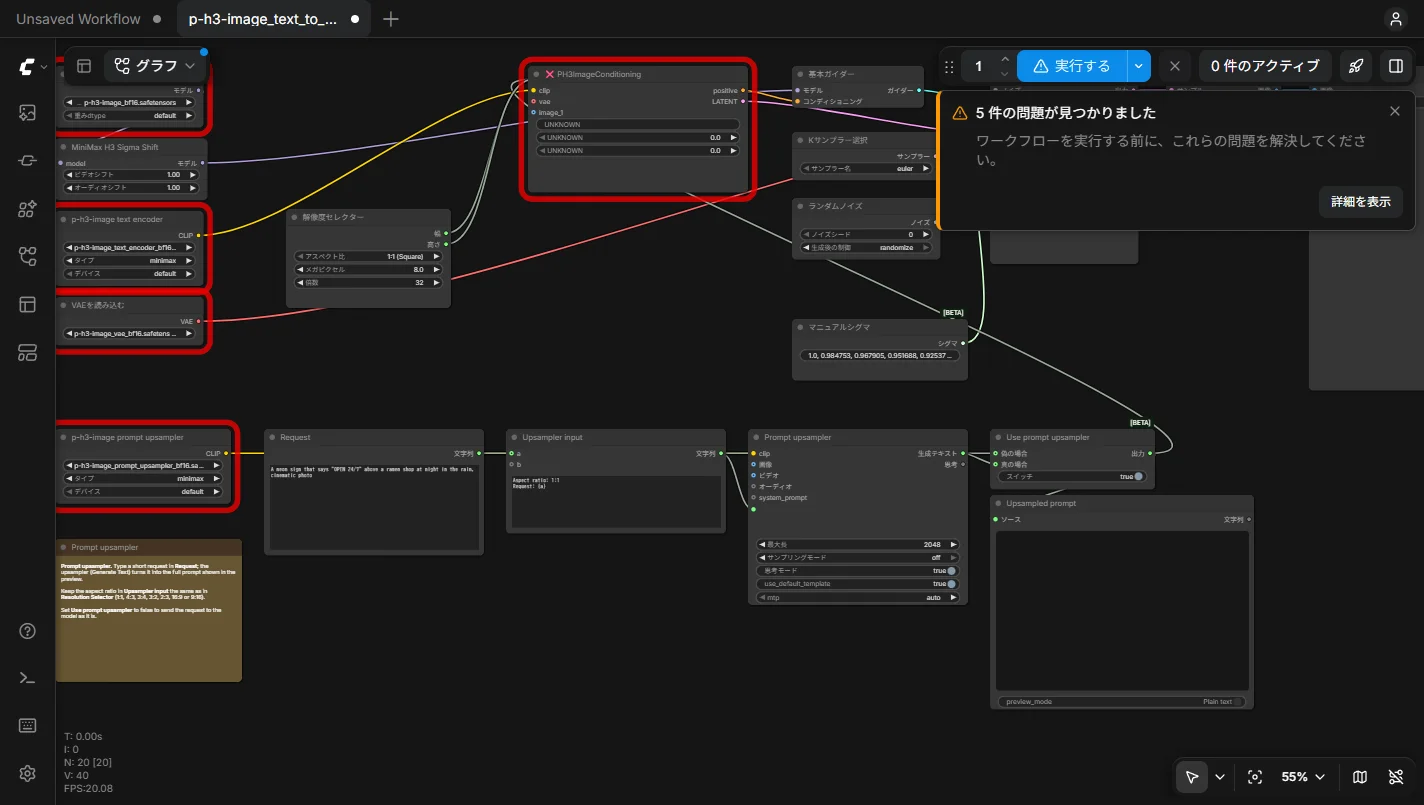
「5件の問題」のうち残りの4件は、モデルファイルを置いていない環境で開いたためです。赤い×が付くノードが PH3ImageConditioning なら、ComfyUI を v0.44.0 以降に更新すれば直ります。更新の手順はComfyUI のアップデート方法にあります。
配布ページによると、Desktop 版と Comfy Cloud は安定版の更新に合わせて対応します。Desktop 版は試していません。
どのページからダウンロードする?
ComfyUI で使うのは PrunaAI/P-H3-Image-Comfy です。名前の似た PrunaAI/P-H3-Image は diffusers 用で、ファイルは全部で約99.8GB あります。間違えて落とさないよう注意してください。
| セット | 本体 | テキストエンコーダー | VAE | 合計 |
|---|---|---|---|---|
| w4a8(迷ったらこれ) | 13.4GB | 3.6GB | 3.1GB(int8) | 約20.1GB |
| int8 | 21.2GB | 5.1GB | 3.1GB(int8) | 約29.5GB |
| bf16 | 40.5GB | 9.1GB | 5.6GB | 約55.2GB |
Hugging Face の表示から計算した大きさ(1GB=10億バイト)。
プロンプトアップサンプラーは別のファイルで、上の合計には入っていません。w4a8 版は 6.7GB、int8 版は 9.7GB、bf16 版は 19.3GB です。
時間は w4a8 と int8 でほぼ同じ、VRAM は w4a8 が少ない
この表の時間と VRAM は、どれもアップサンプラーなしの値です。w4a8 は3つのプロンプトを5シードずつの計15枚、int8 と LoRA は各2枚の2枚目です。
| 構成 | 1枚の時間 | 1ステップ | 2枚目以降の VRAM ピーク |
|---|---|---|---|
| w4a8(なし) | 11.0秒 | 1.05秒 | 20.8GB |
| int8(なし) | 11.2秒 | 1.05秒 | 29.5GB |
| LoRA + H3 FL2VA pruned int8(なし) | 13.8秒 | 1.33秒 | 30.5GB |
| bf16 | 未測定 | 未測定 | 公式値 56GB |
「1ステップ」は、ログの進捗の時刻から出した間隔です(8ステップ目−1ステップ目)÷7。「1枚の時間」にはサンプラーの起動、デコード約1.8秒、保存約0.7秒なども入るので、1枚の時間を8で割っても同じ値にはなりません(11.0÷8=1.38 など)。
- w4a8 と int8:時間はほぼ同じで、絵の傾向も似ています。シードが同じでも細部や配置は変わります。
- LoRA:H3 本体をすでに持っている人向けです。2GB の追加で済みます。アップサンプラーなしでは 11.0秒→13.8秒、bf16 ありでは 11.4秒→13.5秒で、約2〜3秒遅くなりました。
- bf16:55GB あり、公式のピークは 56GB なので、32GB の GPU では試していません。
int8 の時間は w4a8 と差がありませんでした。今回の条件では int8 を選ぶ理由が時間からは見つかりません。 品質は、公式の説明では int8 のほうが bf16 に近いとされています。私は bf16 と比べていません。
アップサンプラーは入れたほうがいい?
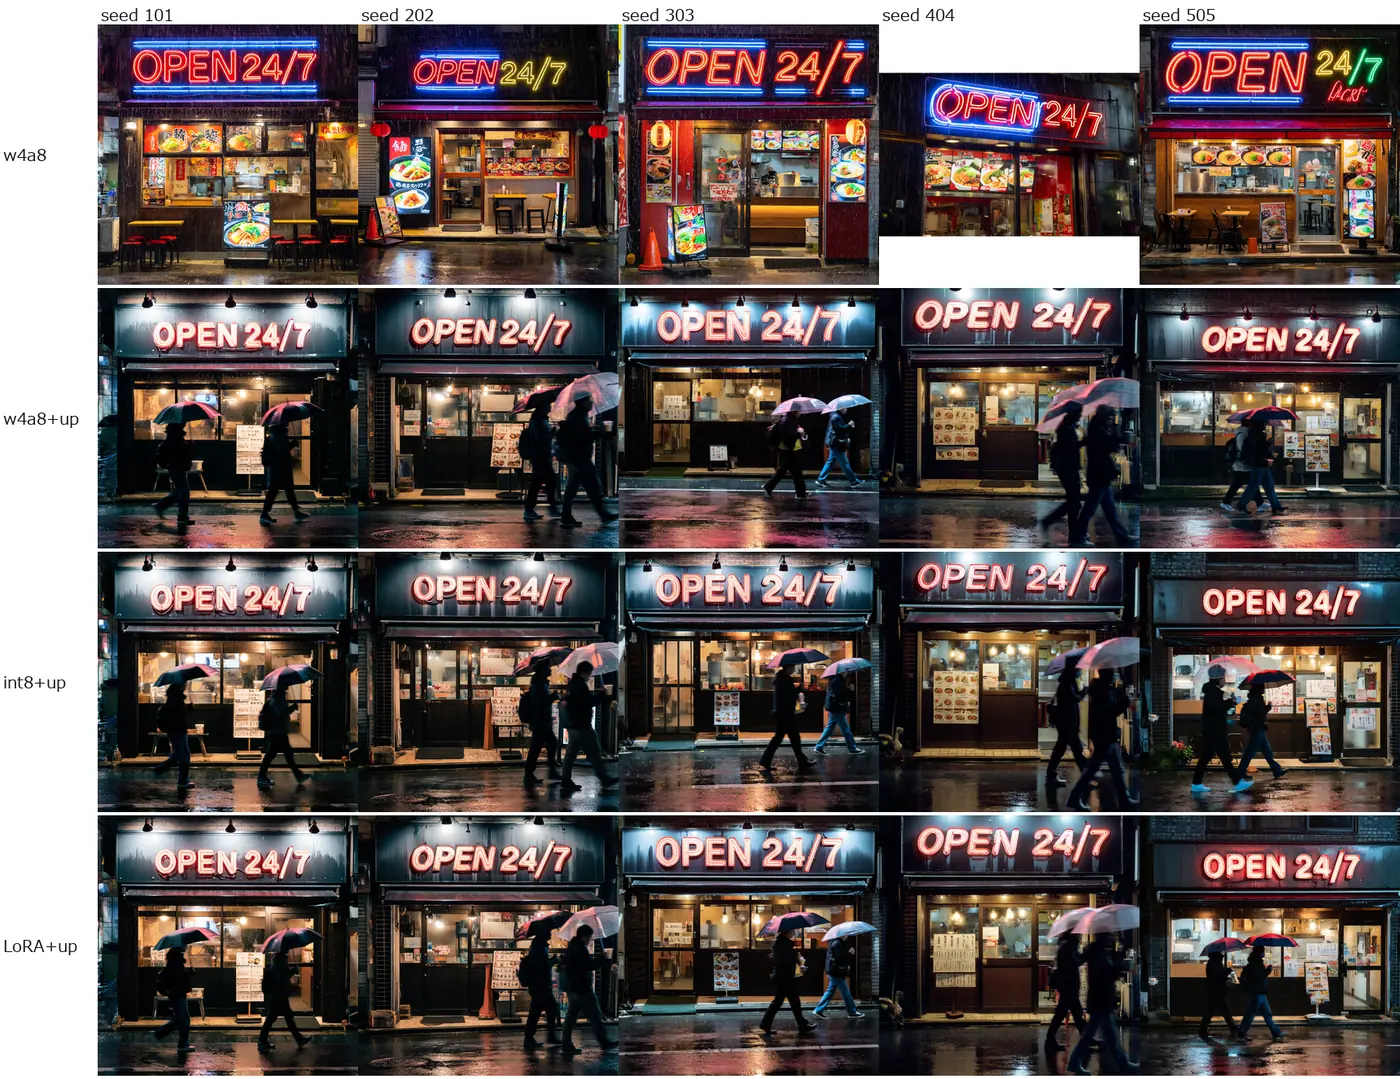
短い依頼文を同じシードで比べました。
| 比べるところ | なし | あり(bf16) |
|---|---|---|
| 構図の安定 | シードでばらつく。ネオンの1枚は上下に白い帯 | よくそろう |
| 依頼文にない文字 | ネオンの1枚に余計な文字 | 今回の15枚では目立たず |
| 色 | 鮮やか。情報が多い | 落ち着いた写真風 |
| 依頼の解釈 | 文字どおり | 書き足しが増える |
「あり」は、シードを変えても似た絵が続きました。ネオンの条件では、私の依頼になかった傘の2人が全シードに入っています。安定する代わりに、モデルが解釈を足します。 細かく決めたいときは、生成された文章を読んで手で直すのが確実です。
文章を作る時間は、メモリーにあれば数秒
| 条件 | 時間 |
|---|---|
| bf16、モデルがメモリーにある | 約3秒 |
| w4a8、モデルがメモリーにある | 約5〜8秒 |
| HDD からの最初の読み込みを含む | 90〜200秒 |
w4a8 の値は回数が少なく、前後の読み込みの影響も受けています。同じ依頼なら結果が再利用されるので、シードだけ変えるときは時間がかかりません。
アップサンプラーを VRAM に残すと、ピークは約31GB になります。 公式の「21GB」は、画像モデル一式の値です。VRAM が少ない環境では、次の節のように自動で外されます。
8MP でどこまで写る?
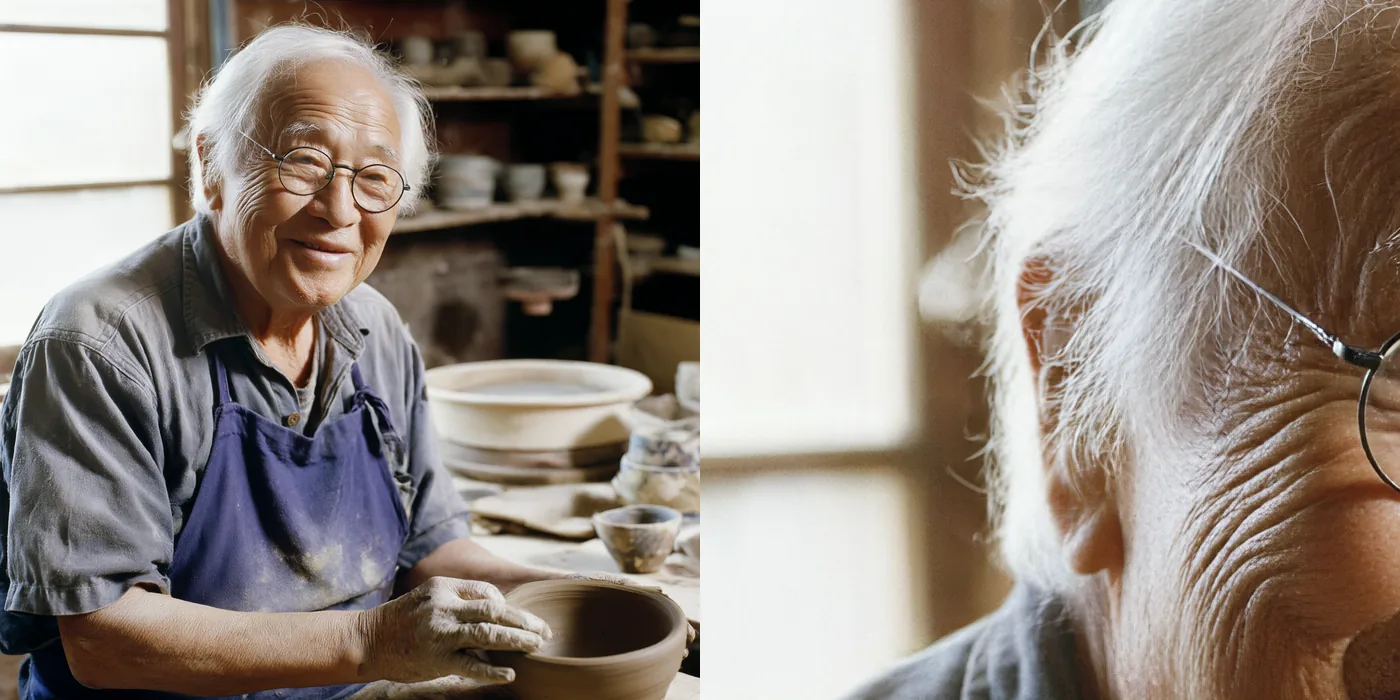
左が全体、右が同じ画像の等倍の切り抜き。顔のしわや眼鏡はしっかり出ています。手や陶器の細かい部分は崩れることがあり、手の破綻は公式の説明にも書かれています。
4MP(2048×2048)にすると、1枚 5.1秒 でした。
短くて大きい日本語なら読める
"ラーメン" の看板を、4条件5シードの計20枚で作りました。
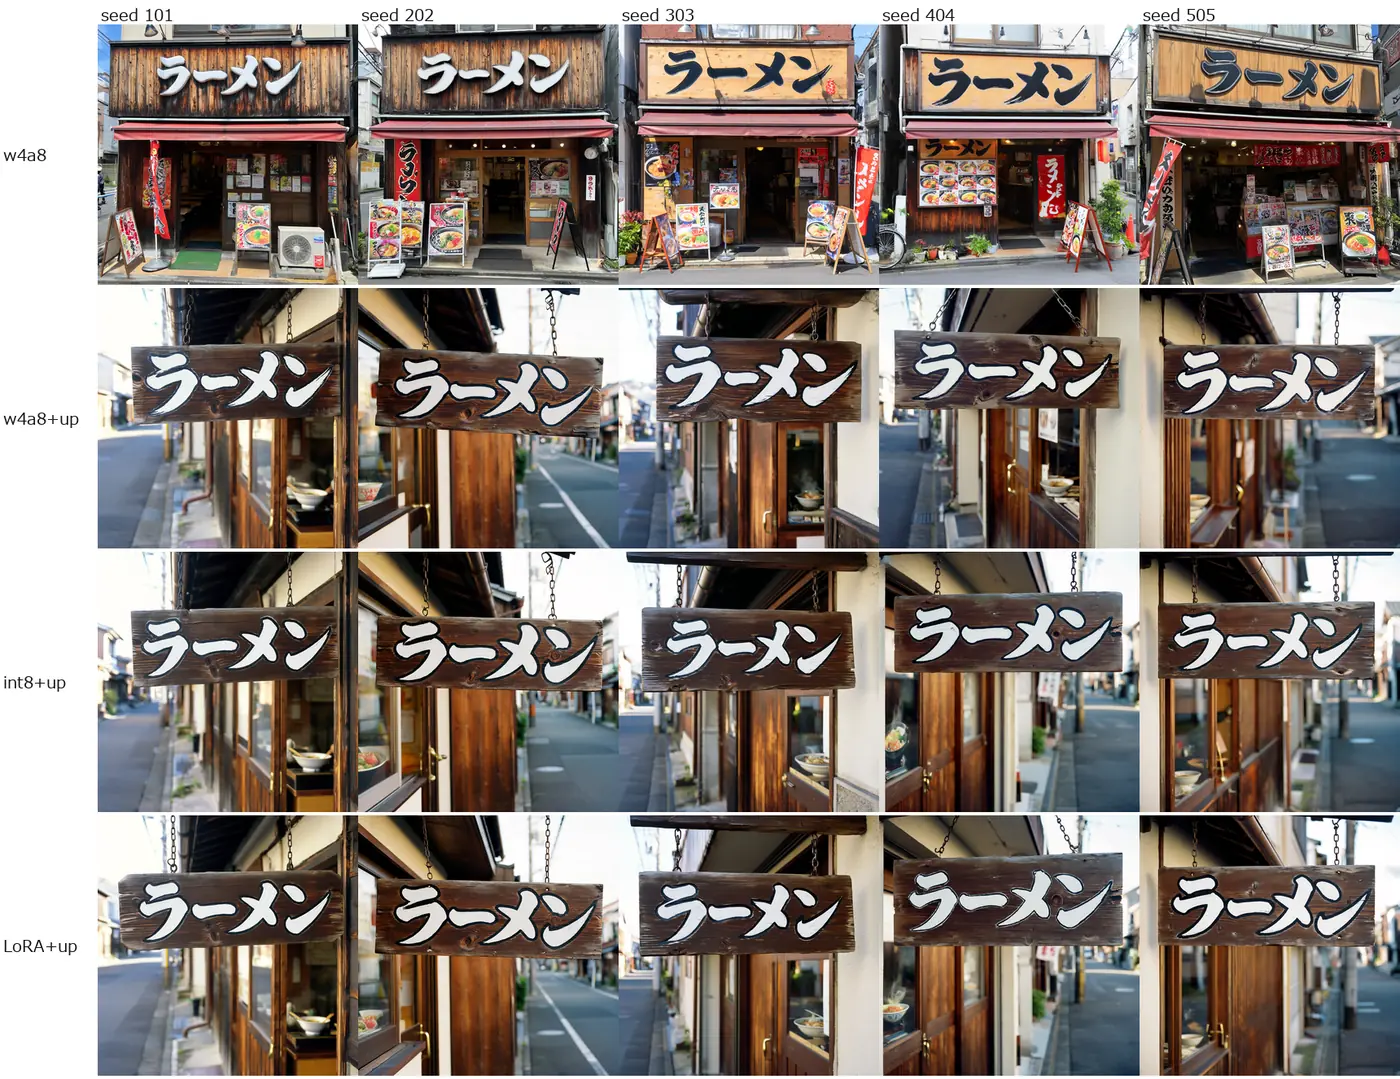
大きなカタカナは、見た範囲ではどれも読めました。一方で「なし」の店頭の小さなメニューやのぼりは、それらしい別の文字になっています。短くて大きい文字なら期待できます。 長い日本語や漢字は試していません。
参照1枚の編集は約12秒
画像を4MP に縮めて編集します。編集の依頼文は英語で試しました。
| 編集 | 1枚(2枚目以降) | 結果(見た範囲) |
|---|---|---|
| 背景を海辺に変える(1枚) | 約11.7秒 | 5枚とも人物を保って変更 |
| エプロンを赤に変える(1枚) | 約12秒 | 5枚ともエプロンだけ変更 |
| 別の画像の帽子をかぶせる(2枚) | 約21.5秒 | 3枚とも成功 |
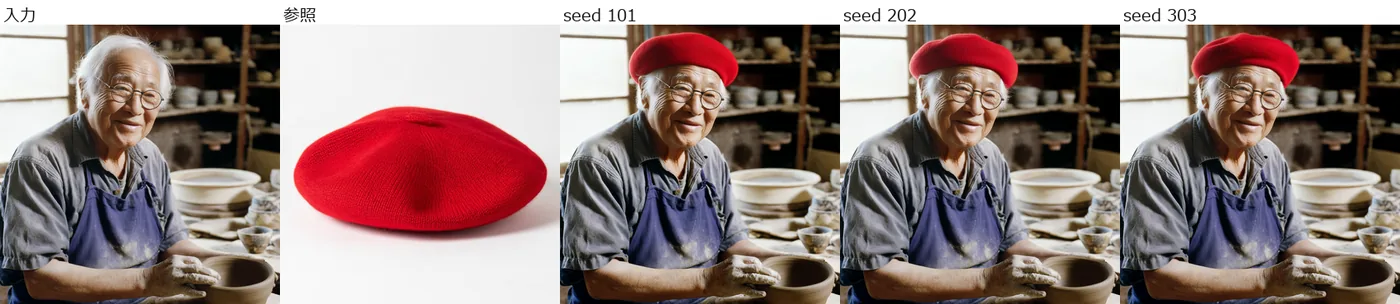
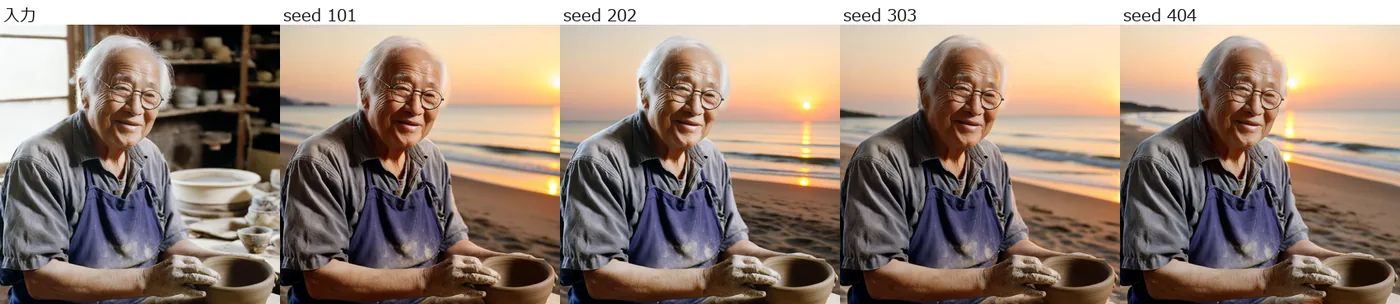
背景の変更では、人物の切り抜きのような違和感は少なめでした。SameFace で測ると、背景や服だけの編集での顔の形のずれは、どれも 0.01% 未満でした。
編集はシードで結果が大きく変わる
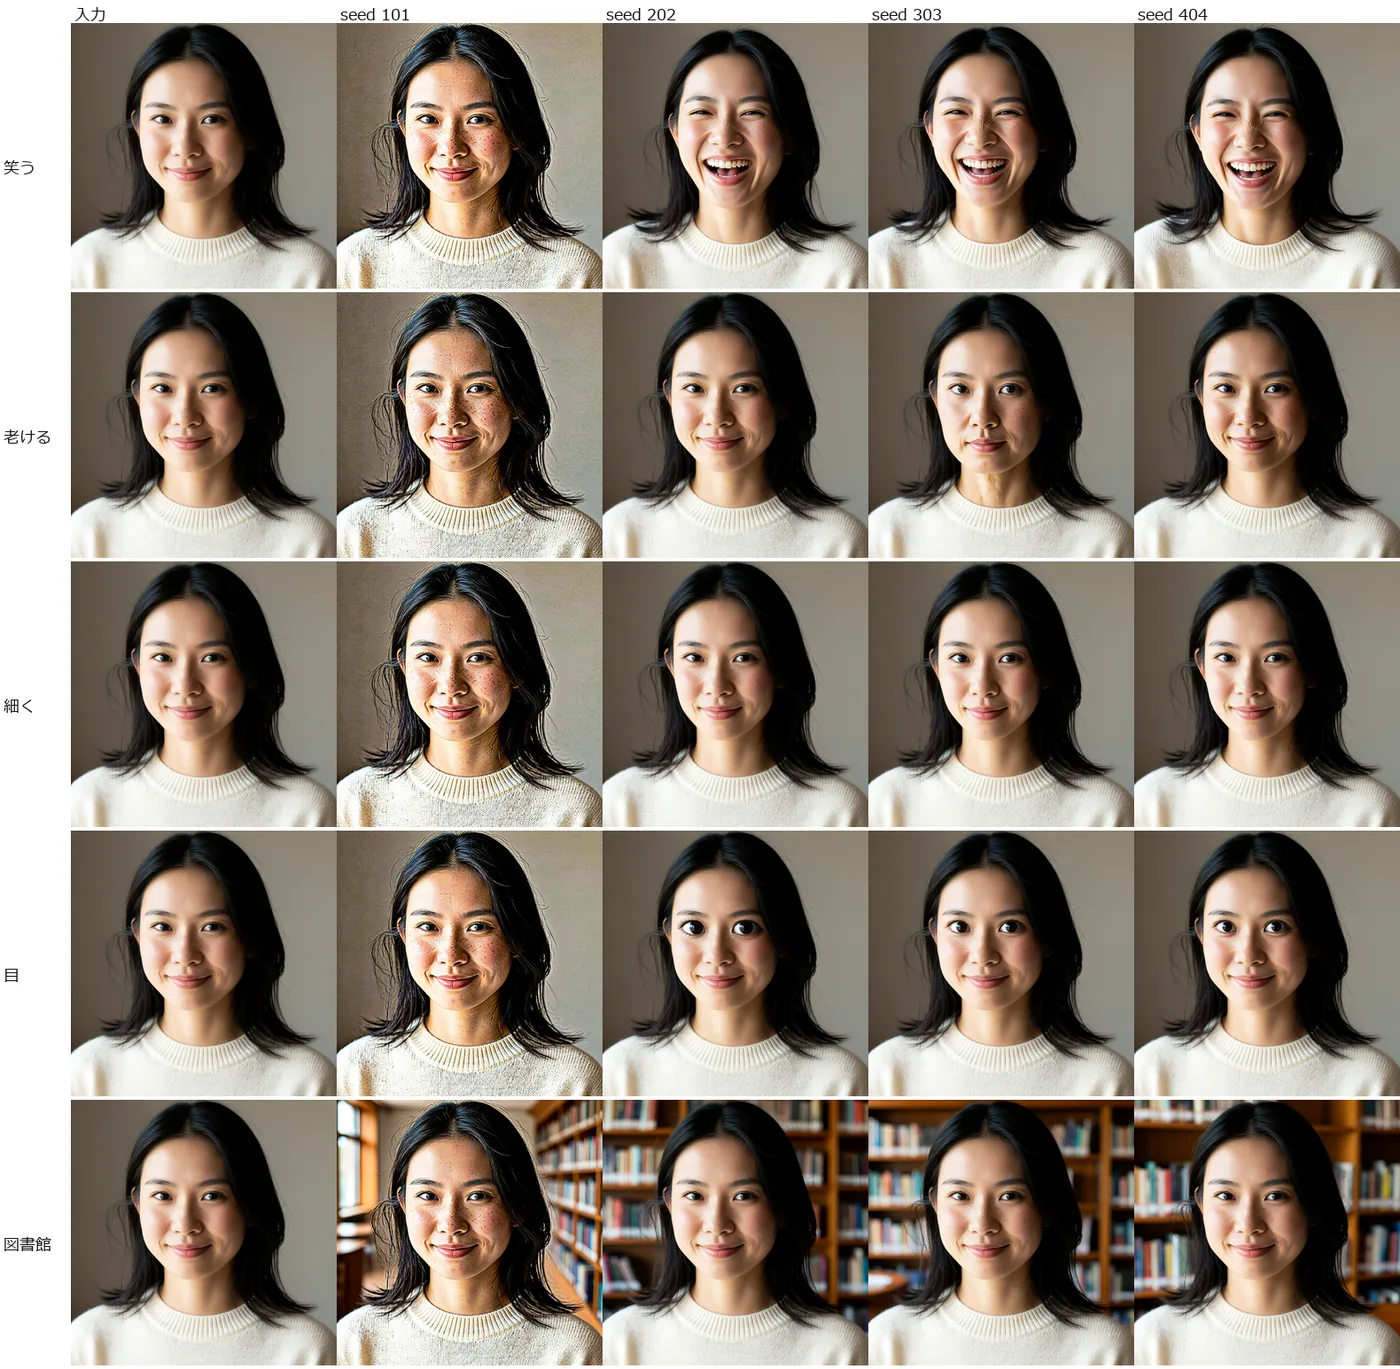
顔を変える依頼を、同じ画像の5シードで試しました。下の画像はそのうち4シードです。
| 依頼 | 見た目(見た範囲) |
|---|---|
| 笑う | seed 101 以外は成功(5枚中4枚) |
| 目を大きく | seed 101 以外は成功(5枚中4枚) |
| 背景を図書館に | 5枚とも成功 |
| 30歳老ける | はっきりしわが出たのは5枚中1枚 |
| 頬を細く | わずかな変化 |
seed 101 だけ、依頼が効かないうえに、肌にそばかすが増えて硬い写りになりました。 最初はこれを見て、編集が苦手なモデルと思い込みました。int8 でも同じ seed で同じ傾向で、w4a8 だけの問題ではありません。1枚で判断せず、シードを変えて確かめてください。
参照の枚数は2枚までしか試していません。最大8枚は公式の説明です。
RTX 5090 以外の人へ
--reserve-vram は、OS などのために VRAM を残しておく設定です。w4a8 +アップサンプラー w4a8 で試しました。20 と 24 は各2枚、指定なしは1枚です。
--reserve-vram | 結果 | 2枚目 | VRAM ピーク(開始時からの増加) |
|---|---|---|---|
| 指定なし | 成功 | 未測定(1枚目は読み込み込み 172.9秒) | 26.3GB(約24.6GB) |
| 20(計算上の残り 約12.1GB) | 成功 | 11.4秒 | 14.0GB(約12.3GB) |
| 24(計算上の残り 約8.0GB) | 成功 | 11.5秒 | 9.8GB(約8.1GB) |
比べる基準は「開始時からの増加」です。総 VRAM の 32,580MB から指定分を引いた残りは約12.1GB と約8.0GB で、増加の約12.3GB と約8.1GB はこれとほぼ同じでした。ピークの 14.0GB と 9.8GB は、開始時に別のソフトが使っていた約1.7GB を含みます。今回はどの指定でも失敗していません。どこまで減らすと失敗するかは測っていません(未確認)。
VRAM 容量が少ない環境を想定した簡易テストです。実際の 8GB・12GB 搭載 GPU での動作を再現・保証するものではありません。 速度の落ちは小さく見えますが、128GB の RAM があっての結果です。ComfyUI の RAM は約30GB でした。公式の説明では、int8 の演算は NVIDIA Ampere 以降か AMD RDNA3/4 向けです。VRAM 不足の対処はこちらにまとめています。
商用で使うときの条件は?
配布の LICENSE は、MiniMax H3 本体の LICENSE と1バイトも違わない同じファイルでした。原文の主な条件です。
- 対象地域:EU、英国、韓国、米国は対象外です。対象外の地域では、モデルも出力も利用が認められていません。
- 表示:MiniMax H3 を使った製品やサービスには「Powered by MiniMax H3」の表示が必要です。
- 大きな事業:年商2,000万ドルを超える商用の製品やサービスは、MiniMax の事前の書面の許可が必要です。
出力にも決まりがあります。MiniMax H3 とその派生以外の AI モデルの改善に使うことは禁止。MiniMax は出力の権利を主張しないとされていて、責任は使う人にあります。
テキストエンコーダーの Qwen3-VL の部分とアップサンプラーは Apache-2.0 と NOTICE にあります。法的な助言ではないので、使う前に全文を確認してください。
よくある質問(FAQ)
Q. ComfyUI のどの版が必要ですか?
今回は v0.44.0 で動きました。対応の変更はこのタグに含まれています。古い版では PH3ImageConditioning がありません。Desktop 版は試していません。
Q. 容量はどれくらいですか?
w4a8 の一式で約20GB、アップサンプラーを足すと w4a8 版で約27GB、bf16 版で約39GB です。
Q. H3 を持っていれば LoRA だけで動きますか?
動きました。ただし P-H3-Image のテキストエンコーダーと VAE は今回も使っています。H3 FL2VA の pruned int8 + LoRA で試しました。
Q. 動画も作れますか?
このモデルは画像用です。動画は MiniMax H3 本体を使います。
Q. 商用で使えますか?
地域、表示、売上などの条件があります。上の節と原文を確認してください。
まとめ
- 8MP が約11秒で、w4a8 の VRAM は公式値どおりでした。
- 短い依頼文なら、アップサンプラーで安定します。解釈の書き足しには注意が必要です。
- 編集は速く、指定した部分をよく変えます。ただしシードで結果が大きく変わります。
検証メモ
- 修正の履歴:2026年11月4日に、編集の節を訂正しました。最初の版では「編集で肌にそばかすが増える」と書きましたが、ほぼ seed 101 だけの現象でした。
- 枚数:プロンプト3種類×5シードを、w4a8、w4a8 +アップサンプラー、int8 +アップサンプラー、LoRA +アップサンプラーで作りました。上の表との対応:w4a8 はアップサンプラーなしの15枚、w4a8 +アップサンプラーは bf16 の15枚です。表の int8 と LoRA は、この15枚ではなく、アップサンプラーなしで別に作った各2枚の値です。
- 判定:画質と文字は私の目視です。文字の正解率は数値にしていません。
- VRAM:起動の時点で別のソフトが約1.7GB 使っています。ピークはこれを含みます。
- 読み込み時間:モデルは USB の HDD にあります。SSD ならもっと短いはずですが、測っていません。
- 公式の値:L40S で 2048×2048 が 6.3秒、という公式の値とは GPU が違うので、比べていません。
- アップサンプラー int8:試そうとしましたが、ファイル名が一覧になく(
value_not_in_list)実行の前に弾かれました。測り直していないので未確認のままです。 - 未確認のこと:bf16、アップサンプラー int8、参照3枚以上、Desktop 版、古い GPU、実際の 8GB・12GB GPU、長い日本語。