この記事について(広告・アフィリエイトリンクはありません)
紹介しているソフトとモデルは、すべて無料で入手できるものです。
ComfyUI を更新したら、生成が数倍遅くなった。ComfyUI の Issue #16969 には、MiniMax H3 で 30〜40 s/it が 260〜300 s/it になり、0.37 に戻すと直ったという報告があります。
PyTorch 2.14 が原因なのでしょうか。ComfyUI と PyTorch を同時に更新すると、どちらのせいか分かりません。 そこで、1つずつ変えて測りました。
数倍の遅延は再現しなかった(今回のテスト条件で)
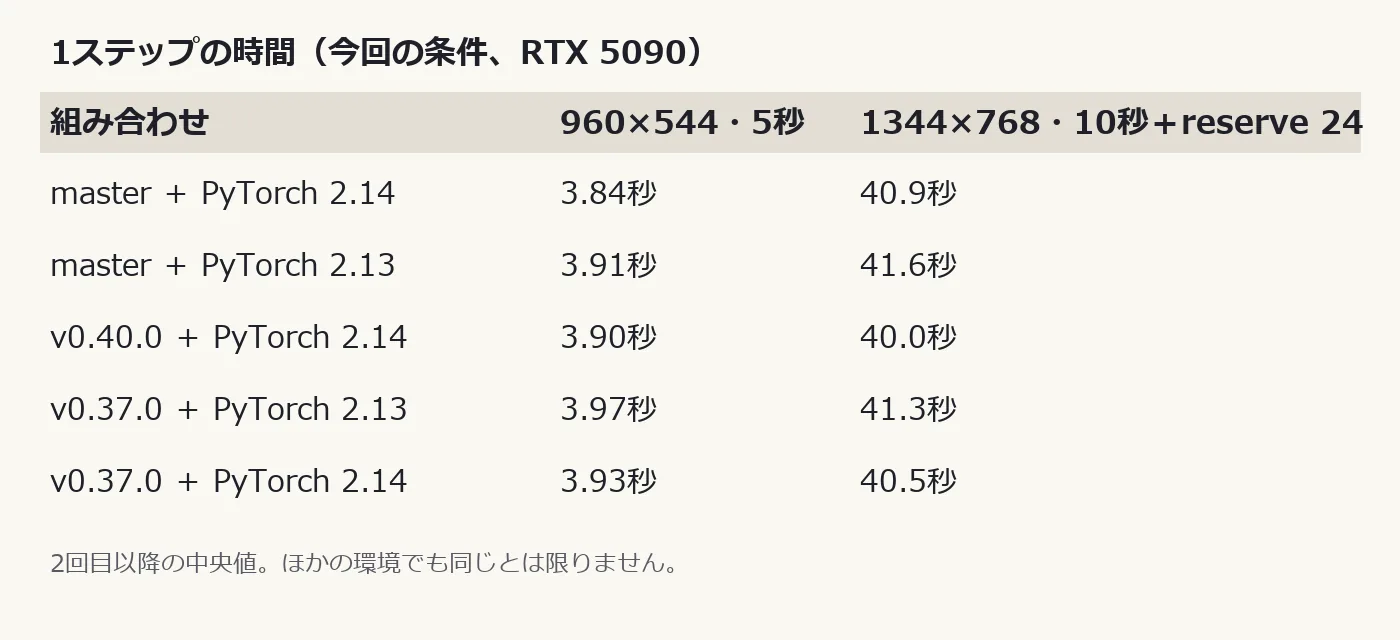
RTX 5090 の今回の条件では、数倍の遅延は再現しませんでした。PyTorch 2.14 が原因とも、原因でないとも言えません。
| 条件 | 1ステップの時間 |
|---|---|
| 960×544、5秒、20 ステップ | 3.8〜4.1秒 |
1344×768、10秒、8 ステップ、--reserve-vram 24 | 40.0〜41.6秒 |
- どの版の組み合わせでも、差は1割未満でした。
- 大きく遅かったのは最初の読み込みです。最初のステップまで約5分かかりました。遅くなったと感じたら、まずこれを疑ってください。
- 報告者の環境と同じとは限りません。報告の「SLA」(Issue には H3 and SLA とだけあり、何を指すかの説明はありません。私も確かめていません)も試していません。
試した環境
| 項目 | 内容 |
|---|---|
| GPU | RTX 5090(32GB) |
| CPU / RAM | Ryzen 9 9950X3D / 128GB |
| OS | Windows 11 |
| モデルの置き場所 | USB 接続の HDD |
| ノード | ComfyUI の標準のノードのみ |
| モデル | H3 ref2va pruned int8、qwen3vl nvfp4、映像 VAE int8、音声 VAE fp32 |
| サンプラー | res_multistep、simple |
| 検証日 | 2026年11月4日 |
本番を変えず、版だけ入れ替えて測った
本番の環境は変えず、Python の検索の先頭に別のフォルダーを足す方法で、必要なものだけ入れ替えました。
| 名前 | ComfyUI | PyTorch | comfy-kitchen / comfy-aimdo |
|---|---|---|---|
| 新+2.14 | master 17ff1dcc(v0.43.0-26) | 2.14.0 | 0.2.40 / 0.6.0 |
| 新+2.13 | 同上 | 2.13.0 | 0.2.40 / 0.6.0 |
| 0.40+2.14 | v0.40.0(Issue と同じ時期) | 2.14.0 | 0.2.37 / 0.5.6 |
| 0.37+2.13 | v0.37.0 | 2.13.0 | 0.2.35 / 0.5.5 |
| 0.37+2.14 | v0.37.0 | 2.14.0 | 0.2.35 / 0.5.5 |
PyTorch と torchvision、各版の requirements.txt にある2つのパッケージだけを合わせました。それ以外のパッケージは同じなので、当時のまっさらなインストールとは完全には一致しません。 起動ログで ComfyUI と PyTorch の版は確かめています。
結果1:1ステップの時間は版でほぼ同じ
960×544、5秒(124 フレーム)、20 ステップ。結論の「3.8〜4.1秒」は、--reserve-vram 24 の実行(最大 4.08秒)を含む範囲で、この表の指定なしの範囲は 3.79〜3.97秒です。各3回(「新+2.14(もう一度)」だけ2回)で、1回目は読み込みが入るので、1ステップの時間は2回目以降の中央値です。
| 組み合わせ | 1ステップ | 全体(2回目以降) | 1回目の最初のステップまで |
|---|---|---|---|
| 新+2.14 | 3.84秒 | 81.9秒 | 298.5秒 |
| 新+2.13 | 3.91秒 | 82.8秒 | 27.9秒 |
| 0.40+2.14 | 3.90秒 | 84.2秒 | 13.1秒 |
| 0.37+2.13 | 3.97秒 | 84.0秒 | 24.2秒 |
| 0.37+2.14 | 3.93秒 | 83.2秒 | 25.8秒 |
| 新+2.14(もう一度) | 3.79秒 | 80.6秒 | 10.6秒 |
最初の 298.5秒は PyTorch のせいではない
同じ「新+2.14」でも、最後にもう一度測ると 10.6秒でした。最初の測定は、この日初めてモデルを HDD から読んだ回です。その後は OS のキャッシュに載っているので速くなったと考えられます。
これは更新後の体感とよく似ています。 更新や再起動のあとの1回目は、進行が 0% のまま数分止まって見えるからです。1回目だけで「遅くなった」と判断しないでください。
結果2:VRAM を絞っても跳ね上がらなかった
報告の 30〜40 s/it に近い重さになるように、1344×768、10秒(243 フレーム)、8 ステップ、--reserve-vram 24 で測りました。各2回です。
| 組み合わせ | 1ステップ | 全体(2回目) | VRAM ピーク |
|---|---|---|---|
| 新+2.14 | 40.9秒 | 351秒 | 10.7GB |
| 新+2.13 | 41.6秒 | 346秒 | 10.6GB |
| 0.40+2.14 | 40.0秒 | 335秒 | 10.6GB |
| 0.37+2.13 | 41.3秒 | 345秒 | 11.3GB |
| 0.37+2.14 | 40.5秒 | 338秒 | 11.3GB |
ここでも差は小さく、260〜300 s/it のような跳ね上がりはありません。
960×544 の条件でも --reserve-vram 24 を試しました。1ステップは 3.8〜4.1秒で、指定なしとほぼ同じでした。
VRAM 容量が少ない環境を想定した簡易テストです。実際の 8GB・12GB 搭載 GPU での動作を再現・保証するものではありません。 RAM は ComfyUI だけで約43〜46GiB 使いました。RAM が足りない環境の動きは、今回は分かりません。
再現しなかったから問題なし、ではない
今回の結果から言えるのは、この PC のこの条件では再現しなかったということだけです。報告の環境とは、次の点が違う可能性があります。
| 違うかもしれない点 | 今回 |
|---|---|
| 報告の「SLA」 | 使っていない |
| GPU と RAM | RTX 5090、128GB |
| カスタムノード | なし |
| ほかの Python パッケージ | 当時のものではない |
| 試した版 | 報告にある 0.38.2 は未測定 |
Issue は2026年11月4日の時点でまだ開いていて、原因は確定していません。
自分の環境ではどう切り分ける?
Issue のコメントでも勧められている方法を、順番にまとめました。
- 同じワークフローを2回続けて実行する。2回目の時間で比べます。
- 読み込みと s/it を分ける。コンソールの進行表示の
s/itを見ます。最初のステップが始まるまでの時間は別に数えます。単位のit/sとs/itは逆なので注意してください。 - 条件をそろえる。モデル、LoRA、解像度、フレーム数、サンプラーを同じにします。
- カスタムノードを外す。
--disable-all-custom-nodesで起動して比べます。 - 0% で止まって見えるなら、RAM とディスクを見る。タスクマネージャーで VRAM、RAM、ディスクの動きを確かめます。読み込みやオフロードの可能性があります。
- 版は1つずつ変える。普段の環境とは別のフォルダーで試します。
版はコマンドか起動ログで分かる
python_embeded\python.exe -c "import torch;print(torch.__version__,torch.version.cuda)"ComfyUI の起動ログの pytorch version: と ComfyUI version: でも分かります。
古い版に戻す回避策は効く?
Issue では、0.37 や 0.38.2 に戻して速度が戻ったという報告があります。これは報告者の環境での回避策で、今回の検証で効果を確かめたものではありません。
戻すなら、注意点が2つあります。
git checkout v0.37.0だけでは足りません。 Issue のコメントのとおり、変わるのは ComfyUI のソースだけで、PyTorch や他のパッケージは戻りません。- 今の環境を残したまま、別のフォルダーに古い版を用意します。 ポータブル版ならフォルダーを分けるだけです。
ComfyUI の更新の手順はこちらにまとめています。更新で PyTorch が入れ替わって起動しなくなる場合は別の記事を見てください。
測定に使ったワークフロー
測定に使った構成です。カスタムノードはありません。プロンプトだけのテストなので、参照はつないでいません。
- h3_speed_test_workflow.jsonComfyUI にドラッグして読み込みます(960×544、5 秒、20 ステップ。カスタムノードなし)
画面から実行して、成功を確かめました(98.5秒)。
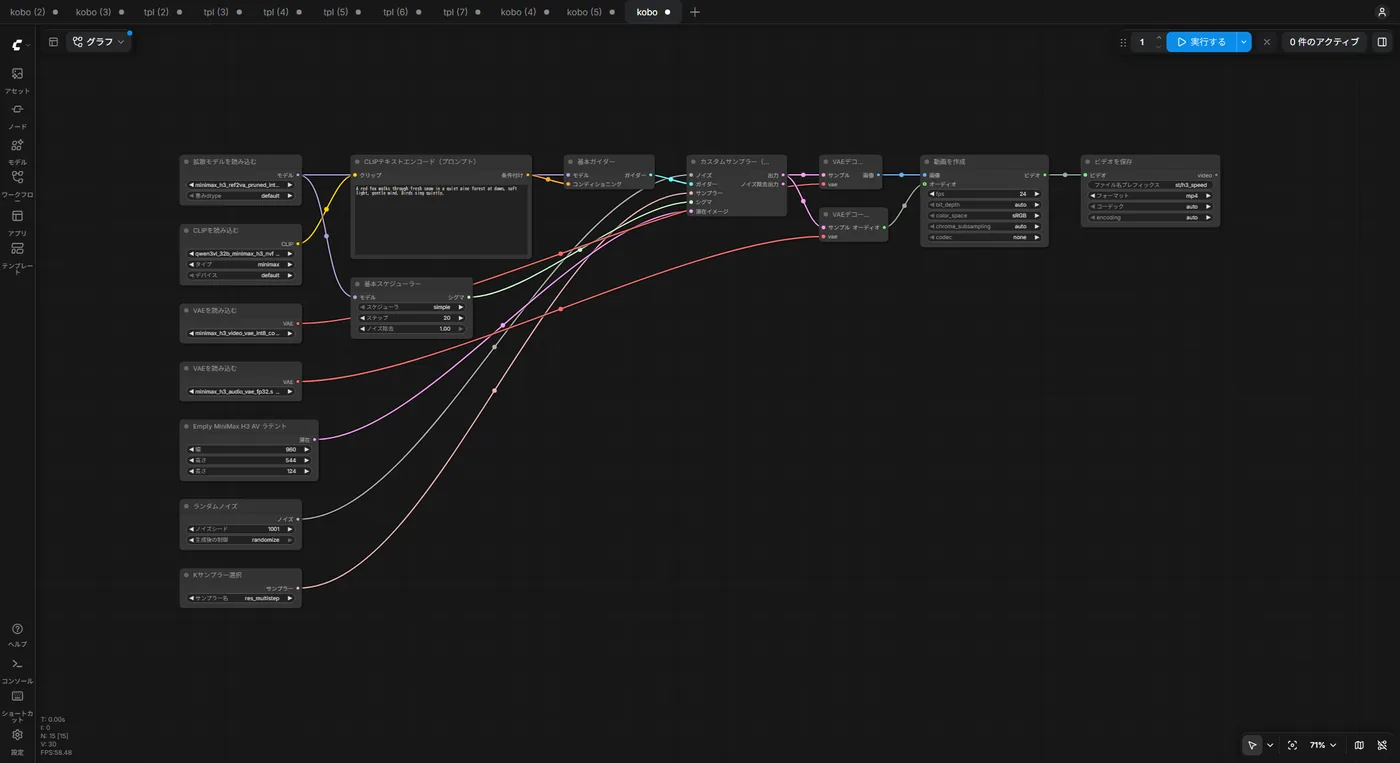
| ファイル | 置き場所 |
|---|---|
| minimax_h3_ref2va_pruned_int8_convrot.safetensors | models\diffusion_models |
| qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors | models\text_encoders |
| minimax_h3_video_vae_int8_convrot.safetensors | models\vae |
| minimax_h3_audio_vae_fp32.safetensors | models\vae |
MiniMax H3 は EU・英国・韓国・米国がライセンスの対象地域外です。基本は導入記事を見てください。
よくある質問(FAQ)
Q. PyTorch 2.14 は遅いのですか?
今回の H3 の条件では、2.13 と差はほとんどありませんでした。ほかのモデルや環境については言えません。
Q. 古い版に戻すべきですか?
まず上の手順で切り分けてください。戻すなら、今の環境を残して別のフォルダーで試します。
Q. 最初だけ遅いのは正常ですか?
今回も最初の読み込みだけ長くなりました。特に HDD では時間がかかります。2回目以降も遅いなら、別の原因を調べます。
Q. it/s と s/it の違いは?
it/s は1秒あたりのステップ数で大きいほど速く、s/it は1ステップの秒数で小さいほど速い値です。
Q. 自分の PC でも再現しませんか?
分かりません。今回は RTX 5090 と 128GB の RAM の結果です。
まとめ
- 今回の条件では、ComfyUI と PyTorch の版の違いで数倍の遅延は起きませんでした。
- 1回目の読み込みと、2回目以降の
s/itを分けて見てください。 - ロールバックは報告されている回避策で、別のフォルダーで試すのが安全です。
検証メモ
- 回数:各条件3回または2回です。1ステップの時間は2回目以降の中央値で、統計的な差を調べたものではありません。
- 順番:新+2.14 の最初の測定が、その日最初のモデルの読み込みでした。ほかの条件はキャッシュの影響を受けています。そのため1回目の読み込み時間は、版どうしの比較に使えません。
- 同時の処理:測定中に別のモデルのダウンロードや、CPU だけの別の検証が重なった時間があります。1ステップの時間には大きな影響は見られませんでした。
- ほかの ComfyUI:別のポートの ComfyUI が2つ待機していて、測定の開始時の VRAM は約1.7GB でした。
- 未確認のこと:SLA、0.38.2、0.39、カスタムノードあり、ほかの GPU、RAM が少ない環境、Comfy Desktop 版。