手元の動画を、絵を大きく変えずに 2K や 4K へ高精細化したい。そのためのカスタムノードが ComfyUI-Tessera です。2026年10月30日に公開されました。MiniMax H3 を使い、画面をタイルに分けて1枚ずつ描き直します。
全9ノードを RTX 5090 で動かしました(Guide Grain は単体のみ、Streamed Decode は保存済み latent からの確認)。通しの時間とメモリーも測っています。H3 自体の導入はMiniMax H3をComfyUIで使う方法を見てください。
先に結論(今回のテスト条件で)
| 変換(5秒・124フレーム) | タイル | 時間(読み込み後) | ComfyUI の RAM ピーク |
|---|---|---|---|
| 544p → 1920×1088(2倍) | 4 | 253秒 | 約64GiB |
| 768p相当 → 2560×1440 | 6 | 464秒 | 約78GiB |
| 544p → 3840×2176(4倍) | 15 | 1,525秒 | 約86GiB |
544p → 3840×2176、low_vram | 24 | 1,086秒 | 約74GiB |
- 元の動画の構図を保つのが一番の特徴です。今回の比較で、同じ入力に対するコアの 2K 経路より元の絵に近い結果になりました。
- 4倍の 4K も完走し、VRAM 32GB でエラーは出ませんでした。
- 重いのは RAM です。システム全体で128GBをほぼ使い切る場面がありました。
- 作者の「15秒の 4K に3時間」は再現していません。
- 迷ったら、作者の既定(
high_vram、Dilate は auto)で 2倍から試してください。今回の 4K ではlow_vramのほうが速かったので、4K はそちらも試す価値があります。
試した環境
| 項目 | 内容 |
|---|---|
| GPU | RTX 5090(32GB)、ドライバー 621.01 |
| CPU / RAM | Ryzen 9 9950X3D / 128GB |
| OS | Windows 11 |
| ComfyUI | ポータブル版+master 17ff1dcc(v0.43.0-26)、フロントエンド 1.57.6 |
| Tessera | コミット 930c882(2026-10-31)、version 1.0.0、MIT。入れたカスタムノードはこれだけ |
| モデル | H3 ref2va pruned int8、qwen3vl nvfp4、映像 VAE int8、音声 VAE fp32(下の表) |
| LoRA | TaoMate 3step(強さ1.0)、LMS(通常0.75・細部1.0) |
| サンプラー | シグマ 1, 0.7, 0.4, 0、er_sde → euler、CFG 1、3ステップ |
| 測り方 | ノード別の時間と1秒ごとの VRAM・RAM。1条件1〜3回 |
入れ方と必要なモデル
作者の案内どおり、custom_nodes に入れるだけです。追加の Python パッケージはありません。カスタムノードの入れ方はこちらで説明しています。
cd ComfyUI/custom_nodes
git clone https://github.com/hashu786/ComfyUI-Tessera| ファイル | 置き場所 |
|---|---|
| minimax_h3_ref2va_pruned_int8_convrot.safetensors(21GB) | models\diffusion_models |
| qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors(15.7GB) | models\text_encoders |
| minimax_h3_video_vae_int8_convrot.safetensors(2.8GB) | models\vae |
| minimax_h3_audio_vae_fp32.safetensors(605MB) | models\vae |
| minimax_h3_lms_v1.0_r64.safetensors(1.24GB) | models\loras |
| minimax_h3_taomate_3step_lora_avg_rank_19_bf16.safetensors(182MB) | models\loras |
作者の JSON は、ほかに KJNodes、rgthree-comfy、Qwen Image 2.1 を使います。今回は入れていません。下の JSON は作者の構成から、次のものを除いて組みました。
MiniMaxChunkFeedForward(VRAM を節約する KJNodes のノード)- プレビュー上書き、比較表示のノード
- Qwen Image 2.1 の1枚目アンカー(作者も4倍以上では外すよう案内)
- SAM3(作者の JSON でもオフ)
読み込むと LoadVideo が空に近い状態なので、自分の動画を選んでください。
- tessera_upscale_workflow.jsonComfyUI にドラッグして読み込みます(H3 ref2va + TaoMate + LMS、544p→2倍。必要なカスタムノードは Tessera だけ)
画面から実行して、成功することを確かめました(571秒、モデル読み込み込み)。
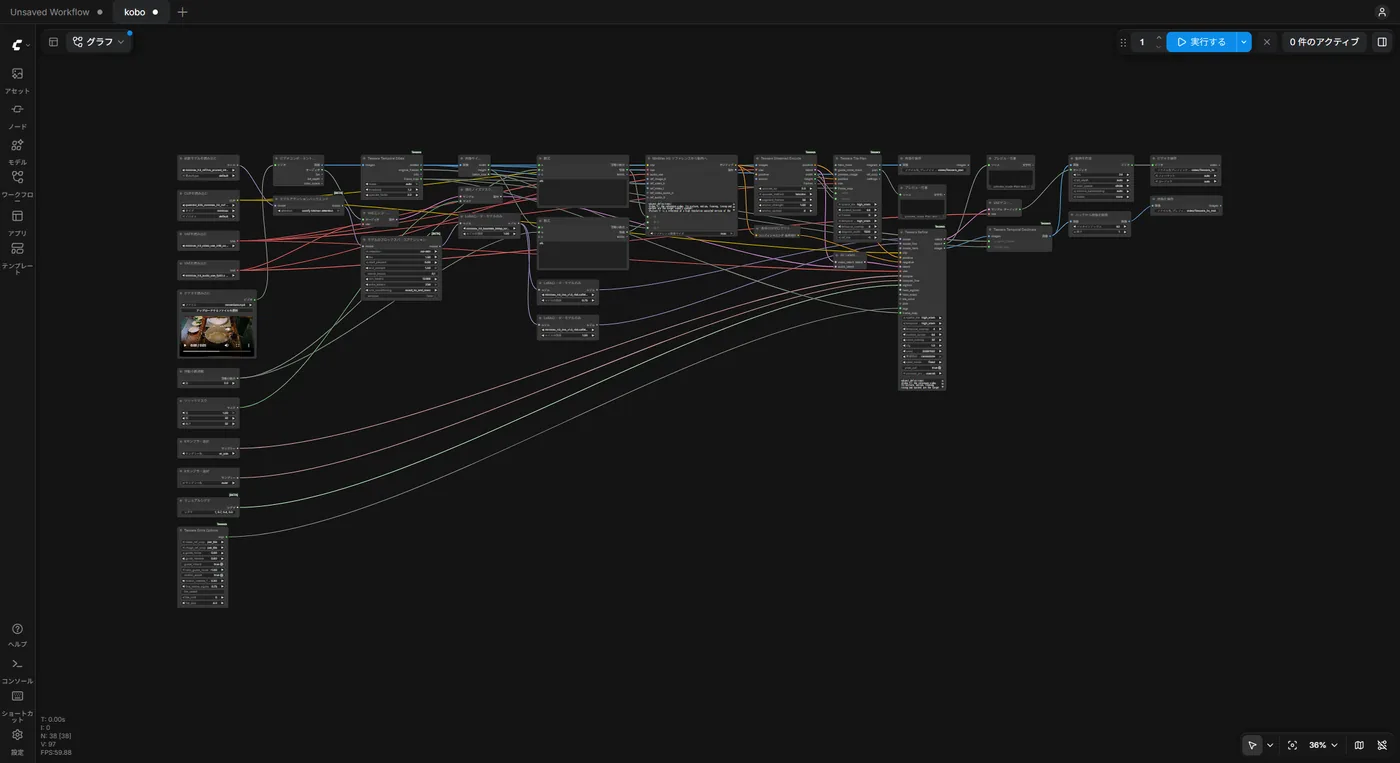
9つのノードを動かした結果
| ノード | 役割 | 試した内容 |
|---|---|---|
| Tessera Tile Plan | 分割の計画を実行前に確認 | 2K で 3×2=6 タイル、図と表を出力 |
| Tessera Streamed Encode | 窓に分けて拡大とエンコード | 2倍は約45〜80秒、4倍は164秒 |
| Tessera Refine | タイルごとの描き直し | 全条件で完走 |
| Tessera Extra Options | 細かい設定 | flat_skip 0 と 4 を比較 |
| Tessera Temporal Dilate | 動きの速い部分のフレーム増し | auto は今回不要と判定。full も完走 |
| Tessera Temporal Decimate | Dilate で増やした分を戻す | 124フレームに戻ることを確認 |
| Tessera Guide Anchor | 詳しい静止画を混ぜる | 単体と Encode の入力で実行 |
| Tessera Guide Grain | ガイドに粒状感を足す | 単体で実行 |
| Tessera Streamed Decode | 保存した latent のデコード | LoadLatent から15秒で動画に |
Tile Plan を先に実行すると、タイル数を確かめてから本番を始められます。
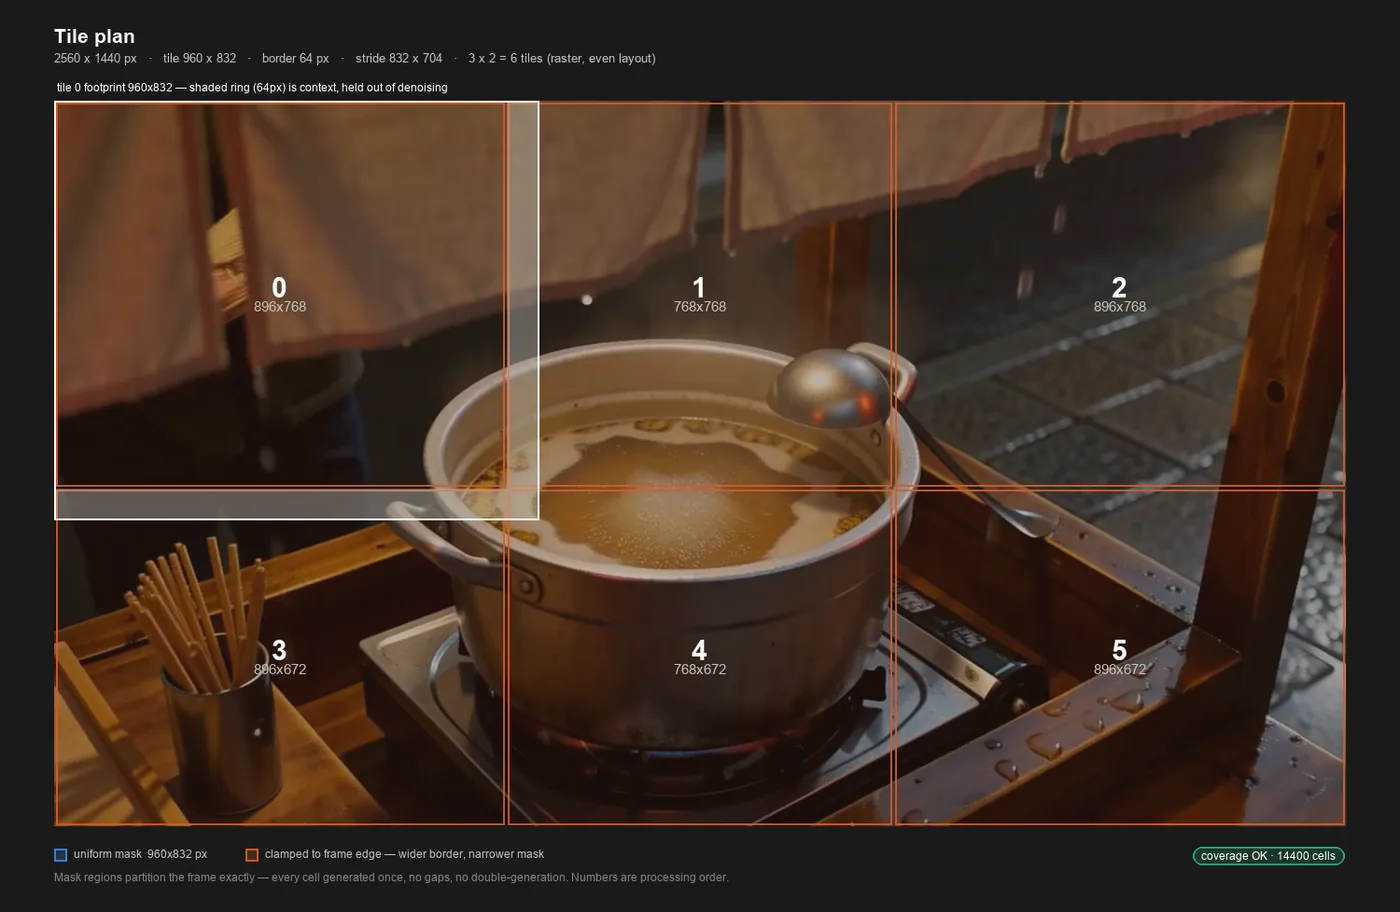
flat_skip は、模様のないタイルを飛ばす設定です。顔のアップでは既定の4で6枚中2枚を飛ばし、4枚で済みました。ラーメンの場面では1枚も飛びませんでした。
時間と VRAM、RAM の実測
1回目は H3 本体を HDD から読むので長くなります。
| 条件 | 全体 | Encode | Refine | RAM(全体 / ComfyUI、GiB) |
|---|---|---|---|---|
| 768p相当→2K(起動直後) | 829秒 | 79秒 | 676秒 | 約117 / 78 |
| 768p相当→2K(2回目) | 464秒 | 79秒 | 377秒 | 約114 / 78 |
768p相当→2K(low_vram) | 500秒 | 80秒 | 383秒 | 約122 / 70 |
| 顔 768p相当→2K | 366秒 | 80秒 | 252秒 | 約109 / 70 |
| 544p→2倍 | 253秒 | 46秒 | 189秒 | 約103 / 64 |
| 544p→2倍、Dilate full | 567秒 | 106秒 | 430秒 | 約114 / 62 |
| 544p→4倍 | 1,525秒 | 164秒 | 1,329秒 | 約126 / 86 |
544p→4倍(low_vram) | 1,086秒 | 164秒 | 889秒 | 約125 / 74 |
全体は、Encode と Refine のほかに動画の読み込み、H3 の条件づくり、音声デコード、保存を含みます。映像のデコードは Refine に含みます。RAM はピークの値で、全体は PC 全体、ComfyUI はそのプロセスの使用量です(搭載の 128GB は Windows 上で約125.6GiB)。
VRAM のピークはどれも31GB台でした。これは「必要な量」ではなく、ComfyUI が空きを使い切った値です。
4K では low_vram のほうが速い結果でした。タイルが小さくなって1回あたりの計算が減り、枚数の増加を上回ったのだと思いますが、原因は調べていません。1回ずつの測定です。
コアの 2K 経路と何が違う?
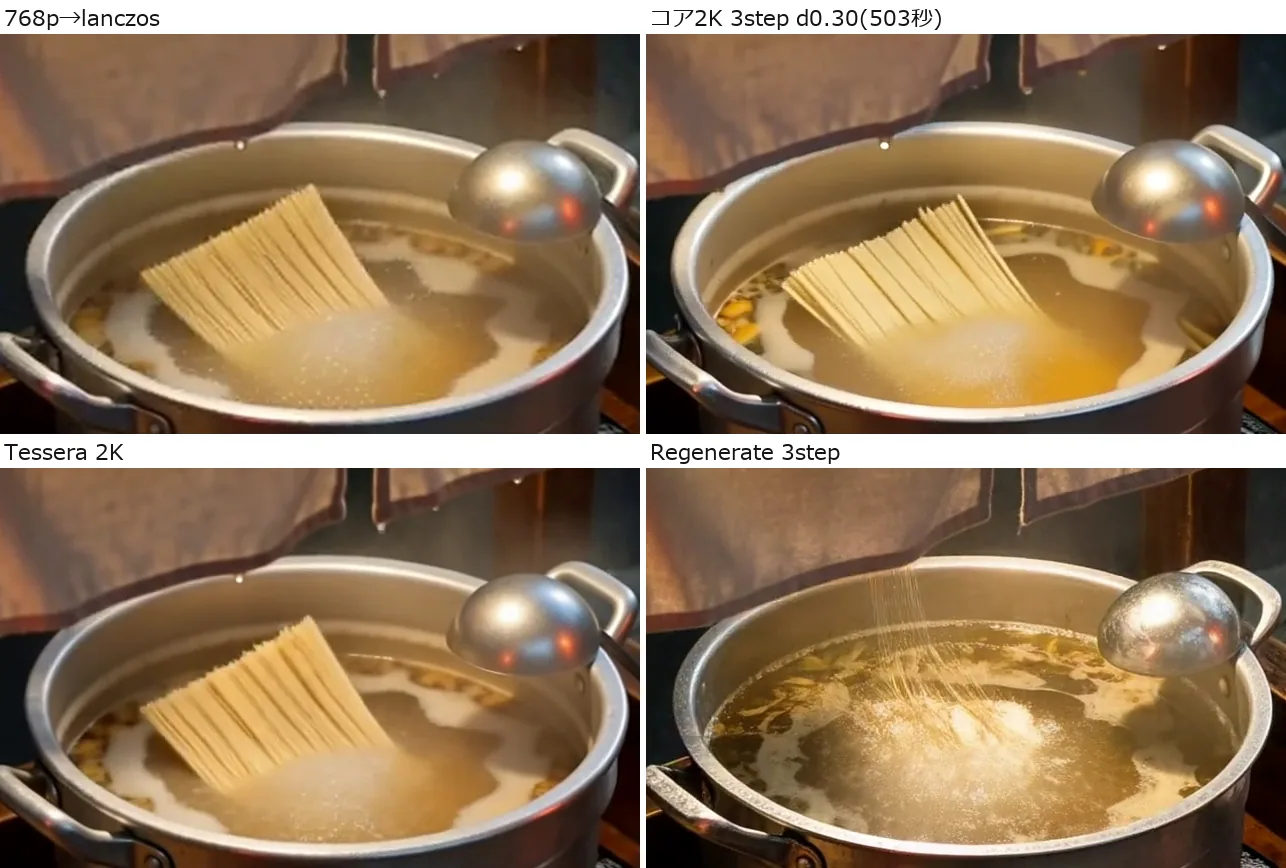
コアノードの 2K 経路と同じ 768p の動画で比べました。Tessera は 1280×720 に縮小してから2倍にしています。出力はどちらも 2560×1440 です。作り直して 2K にする方法はOpen-H3-Regenerate-2K の記事で試しています。
| 経路 | 入力からの時間 | 入力との PSNR | 細部の量(ラプラシアン) |
|---|---|---|---|
| コア2K(潜在拡大+3step d0.30+Sol) | 約404秒(通し503秒から1段目の99秒を除く) | 23.49dB | 66.3 |
| Tessera | 464秒 | 29.42dB | 37.3 |
PSNR は、縮小前の入力(1344×768)を lanczos で同じサイズにした絵との近さです。高いほど元の絵に近いという意味で、高画質という意味ではありません。
- 元の絵を守りたいなら Tessera です。麺の形や具の位置が入力とほぼ同じでした。
- コアの 2K 経路は細部が増えますが、麺の形が変わります。
- 時間はコア経路のほうが短めです。ただしコア経路は生成の途中から続けるので、手元の動画には Tessera のほうが使いやすいです。
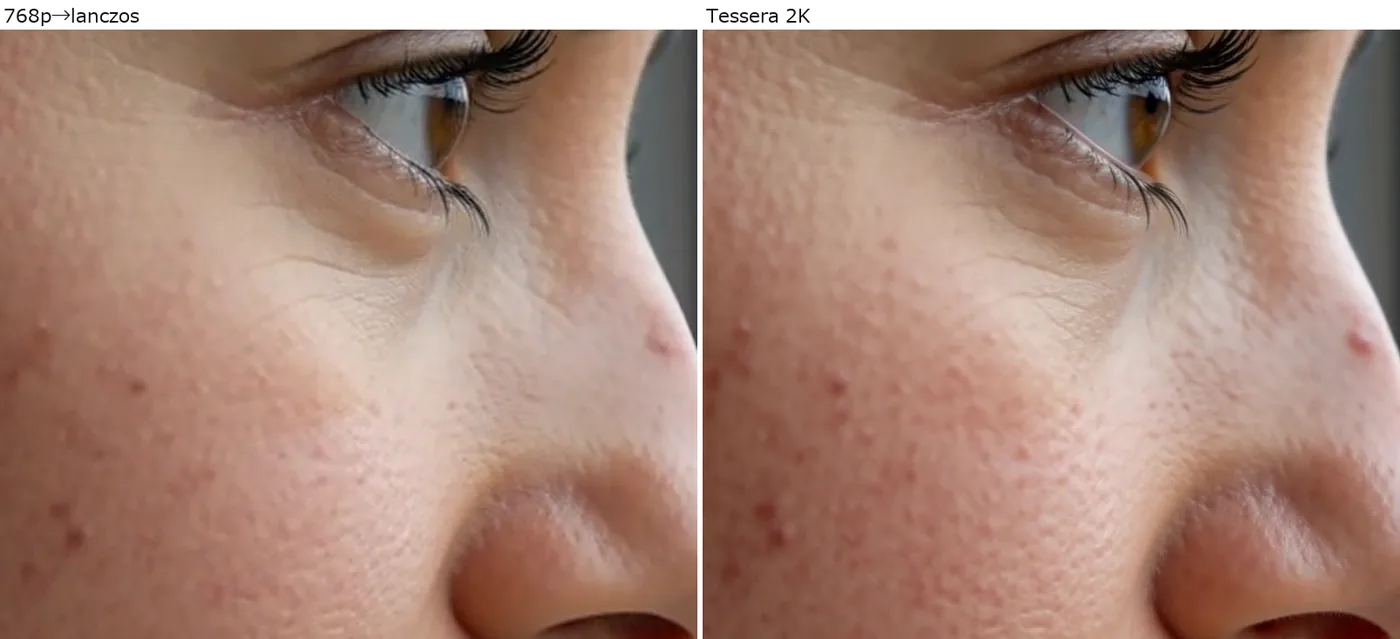
顔でも、毛穴の質感は増えますが、ほくろやシミの位置はそのままでした。
ちらつきの目安として、連続するフレームの差も測りました。Tessera は9.03で、コア経路の9.57と近い値です。動画を再生して目で確かめたものではありません。
音声は元の動画と一致しない
Tessera の出力には音声が入ります。ただし、元の動画と波形は一致しません(相関 0.21〜0.33)。作者の注記でも、音声の描き直しは今後の課題とされています。
一方、条件を変えても音声の音量は同じ値で、タイルや VRAM の設定には影響されませんでした。元の音をそのまま使いたいときは、編集ソフトで差し替えるのが確実です。
音は耳で確かめていません。
作者の「15秒 4K で3時間」は再現できる?
作者のメモには、544p→4K の15秒(Dilate で617フレーム、18窓、24タイル×3分割)が「3時間」とあります。
今回は試していません。作業の都合で GPU を長時間使えなかったため、この記事は5秒の実測だけで公開します。作者の値を確かめられたわけではないので、そのまま目安として受け取らないでください。5秒の4Kが1,525秒でしたが、15秒は窓の分割やメモリーの条件も変わるので、単純に3倍とは言えません。
RTX 5090 以外の人へ
--reserve-vram は、OS などのために VRAM を残しておく設定です。RTX 5090 でこの値を変え、544p→2倍・low_vram で試しました。
--reserve-vram | 結果 | 全体 | VRAM ピーク(増えた分) | ComfyUI の RAM |
|---|---|---|---|---|
| 20(12GB を想定) | 成功 | 307秒 | 14.8GB(約13.3GB) | 約80GiB |
| 24(8GB を想定) | 成功 | 492秒 | 10.7GB(約9.1GB) | 約79GiB |
VRAM 容量が少ない環境を想定した簡易テストです。実際の 8GB・12GB 搭載 GPU での動作を再現・保証するものではありません。 VRAM を抑えても RAM は約80GiB 使いました。RAM が少ない PC では、こちらのほうが壁になりそうです。VRAM 不足の対処はこちらの記事にまとめています。
ライセンスと商用利用
原文を確かめた範囲です(2026年11月3日時点)。
- Tessera のコード:MIT License です。
- MiniMax H3 本体:MiniMax H3 Community License です。EU・英国・韓国・米国は対象地域外、年商2,000万ドルを超える事業者は別途の許諾が必要です。
- TaoMate:元の TaoLiveAIGC/TaoMate-H3 は MiniMax H3 Community License です。今回使った Kijai 版は変換したもので、Kijai のカードにライセンスの記載はありません。
- LMS LoRA:Alissonerdx のリポジトリは「資産ごとに異なる」とし、LMS 用の個別の条件は書かれていません。リポジトリの独自ライセンスが適用されるのは Character Swap と Motion Transfer だけと明記されています。商用で使うなら作者に確認するのが確実です。
よくある質問(FAQ)
Q. Tessera は VRAM がどのくらい必要ですか?
RTX 5090 で31GB台まで使いましたが、これは空きを使い切った値です。--reserve-vram 24 の簡易テストでは、544p→2倍が約9.1GB の増加で成功しました。実際の 8GB GPU での動作は確かめていません。
Q. 4K にするのにどのくらい時間がかかりますか?
5秒の 544p→3840×2176 で1,525秒でした。low_vram では1,086秒です。どちらも RTX 5090 の値です。
Q. RAM はどのくらい必要ですか?
128GB の PC で、ComfyUI が最大で約86GiB を使いました。少ない RAM での動作は試していません。
Q. 元の動画の絵は変わりますか?
今回の例では構図や物の形をほぼ保ちました。入力との PSNR は29.42dB で、コアの 2K 経路の23.49dB より高い値です。細部は描き足されます。
Q. KJNodes は必要ですか?
作者の JSON では使いますが、この記事の JSON では不要です。VRAM を節約するノードを外しているので、VRAM の少ない環境では作者の構成のほうが有利な可能性があります。
Q. 途中で失敗したら最初からやり直しですか?
作者の説明では、最終デコードで失敗すると latent が tessera_rescue_*.latent に保存されます。私は意図的な失敗は試していませんが、保存した latent を Streamed Decode で動画にできることは確かめました。
まとめ
- Tessera は、絵を保ったまま解像度を上げたいときに向きます。
- 5秒なら 2K は464秒、4K は1,086〜1,525秒でした。
- 実行前に Tile Plan でタイル数を見ておくと、時間の見当がつきます。
- RAM を多く使います。128GB でもほぼ埋まる場面がありました。
検証メモ
- 作者の構成との違い:テキストエンコーダーは作者の int8 ではなく nvfp4、シグマは KJNodes の代わりにコアの ManualSigmas です。
MiniMaxChunkFeedForwardは外しました。作者の JSON そのものは実行していません。 - 入力:H3 FL2VA + Turbo 8step で作ったラーメン屋台(768p・544p)と顔(768p)です。2K の条件は 1280×720 に lanczos で縮小してから2倍にしました。
- 全体と内訳の差:768p相当→2K の2回目は464秒に対して Encode と Refine の合計が456秒で、差の約8秒は保存(5.8秒)などです。544p→2倍は253秒に対して235秒で、差の約18秒は H3 の条件づくり(12.4秒)、保存(3.1秒)などです。544p→4倍は1,525秒に対して1,493秒で、差の約32秒は保存(16.3秒)、H3 の条件づくり(12.7秒)などです。
- 配布 JSON の571秒と表の253秒:571秒は ComfyUI を起動し直した直後の1回で、モデルを HDD から読む時間を含みます。253秒はモデルを読み込んだあとの値です。差の約320秒の内訳は、この実行では記録していません。参考までに、同じ 544p→2倍を読み込みありで測った別の1回(latent 保存のテスト)では、テキストエンコーダーの読み込み48秒、H3 の条件づくり139秒(通常12秒)、Refine 364秒(デコードなし。通常189秒)でした。
- PSNR の基準:Tessera の入力は 1280×720 に縮小したものですが、比較の基準は縮小前の 1344×768 です。コア経路も同じ基準です。
- 時間のばらつき:同じ 2K の条件でも、モデルの読み込みの有無で464〜829秒と差があります。ほかのグラフの実行後はモデルを読み直すことがあります。
- 数値の読み方:Tessera のタイル数とフレーム数は実測、作者の「3時間」は作者の文書の値です。比較は1つの場面の中央フレームと、12フレームおきの数値です。
- 未確認のこと:作者の15秒 4K(3時間)の再現、動画を再生したときのちらつき、音の聞き比べ、作者の JSON そのもの、Qwen のアンカー、SAM3 のヒーロータイル、8K、実際の 8GB・12GB GPU、128GB 未満の RAM。