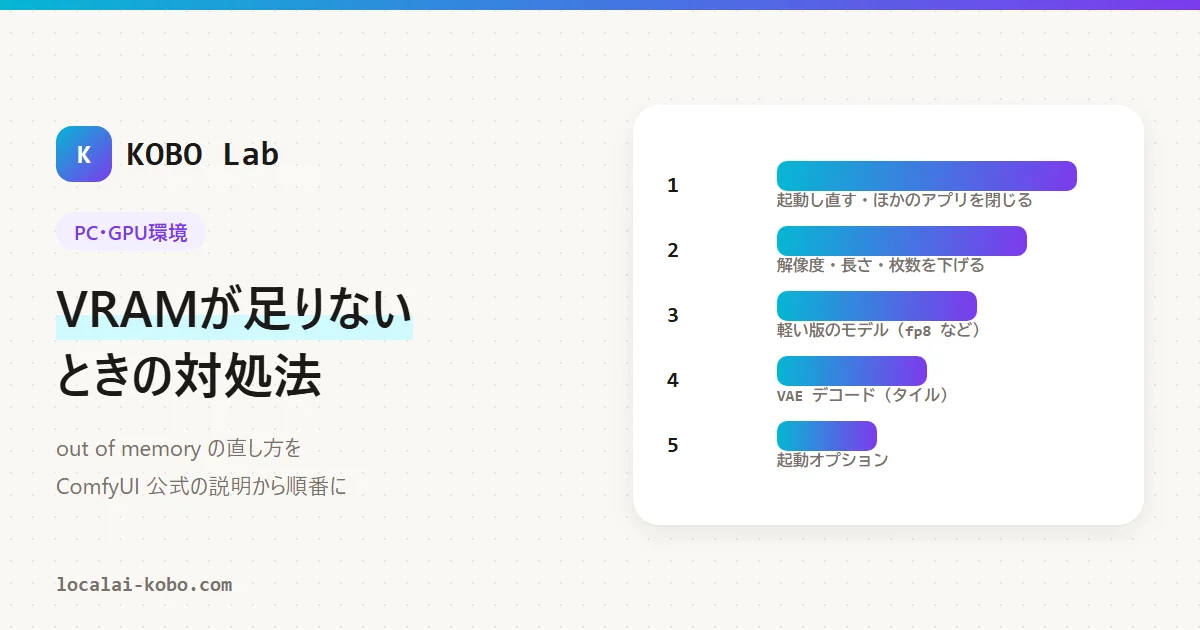
out of memory で止まったら、まず ComfyUI を起動し直し、それでも止まるなら解像度や枚数を下げてください。
「CUDA error: out of memory」「OutOfMemoryError」は、GPU のメモリ(VRAM)が足りないときのエラーです。この記事では、試すことを手軽なものから順番にまとめます。
筆者が試したことと、公式の説明だけのことは分けて書きます。根拠にした資料と試した環境は、末尾の「検証メモ」にまとめました。
VRAM が足りないときに出るエラー
VRAM は、GPU に載っているメモリです。ComfyUI は、モデル(絵を作るための学習済みのファイル)や計算の途中のデータを VRAM に置いて計算します。入りきらないと、次のようなエラーで止まります。
torch.OutOfMemoryError: CUDA out of memory.
CUDA error: out of memory
筆者の RTX 5090 でも、Wan 2.2(動画のモデル)を ComfyUI を起動したまま85本続けて作り、高速化 LoRA ありから LoRA なしに切り替えた直後に、一度だけ「CUDA error: out of memory」で止まりました(Wan が動かないときの対処法)。VRAM が 32GB あっても起きます。
止まったあとに記録したログでは、14B の生成中に GPU 全体で最大約31.8GB/32.6GB(余裕は約0.8GB)を使っていました。止まった瞬間の値とは限りません。
今の ComfyUI の VRAM の使い方を知っておく
公式の README では、ComfyUI は「VRAM とメモリをかしこく管理し、モデルをメインメモリへ逃がす(オフロード)」と説明されています。VRAM に入りきらない分は、PC 本体のメモリ(RAM)に置いて、必要なときに GPU へ送りながら計算します。そのため、VRAM が足りなくても止まらずに、遅くなるだけのことも多いです。
筆者の ComfyUI 0.43.0 は、起動すると「DynamicVRAM support detected and enabled」と表示されました。この仕組み(DynamicVRAM)では、VRAM が空いていれば使えるだけ使ってモデルを読み込みます。ソースコード(main.py)を見ると、NVIDIA の GPU では標準で有効になる作りです。
このため、昔からある起動オプション --lowvram は、今の ComfyUI では効かないことがあります。説明には「DynamicVRAM が有効なときは何もしない」と書かれています。ネットで見かける古い対処法をそのまま使う前に、下の表を見てください。
手順1:起動し直す・ほかのアプリを閉じる
まず ComfyUI を一度閉じて、起動し直します。筆者が out of memory で止まったときも、起動し直すと同じ順番で作っても止まりませんでした。
VRAM は ComfyUI だけのものではありません。Windows の画面表示やブラウザ、ゲーム、動画の再生なども VRAM を使います。筆者の PC では、何も生成していないときでもデスクトップのアプリで約0.5〜0.8GB を使っていました。使っている量は、タスクマネージャーの「パフォーマンス」→「GPU」の「専用 GPU メモリ」で確かめられます。
手順2:--reserve-vram で少し残す
起動するときに --reserve-vram 1 を付けると、約1GB を ComfyUI 以外のために残します。公式の説明は「OS やほかのソフトのために予約する VRAM の量(GB)」です。ポータブル版なら、run_nvidia_gpu.bat をメモ帳で開き、1行目の最後に足して保存します。
.\python_embeded\python.exe -s ComfyUI\main.py --windows-standalone-build --reserve-vram 1筆者は Wan 2.2 で止まったあと、対策としてこの設定を付けました。ただ、もとの止まり方は起動し直すと再現しなかったため、この設定の効果をはっきり確かめたわけではありません。--reserve-vram は VRAM の容量を制限する機能ではないので、値を大きくしても「小さい GPU のふり」にはなりません。
手順3:解像度・長さ・枚数を下げる
作る画像が大きいほど、計算の途中で使う VRAM と時間が増えます。いちばん確実に効く方法です。
- 解像度:「空の潜在画像」(Empty Latent Image)の幅と高さを下げる。SDXL・Illustrious XL・Anima は 1024×1024 前後のモデルなので、それより大きくしているなら戻す
- 一度に作る枚数:「空の潜在画像」の batch_size を 1 にする。2以上だと、その枚数をまとめて計算する
- 動画の長さ:Wan なら「長さ」(フレーム数)を減らす。121フレーム(24fps で約5秒)を 49フレームにするなど
- 拡大(アップスケール):大きくしてから仕上げる組み方なら、拡大の倍率を下げる
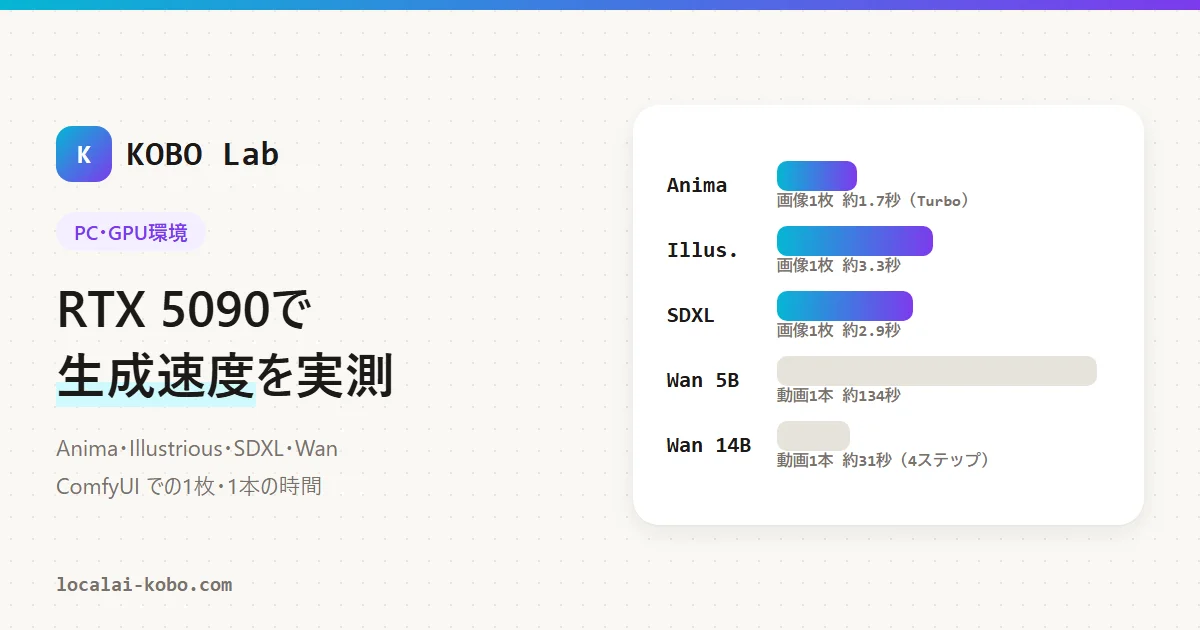
筆者の RTX 5090 での時間の例です(VRAM の量は測っていません)。Wan 2.2 5B は、1280×704・121フレームで約134秒、960×544 にすると約65秒、49フレームにすると約42秒でした。Illustrious XL v2.0 は、832×1216 の約3.5秒が、1248×1824 では約7.7秒でした(RTX 5090 の生成速度の実測)。
手順4:軽い版のモデルにする(fp8 など)
モデルの数値をどれくらい細かく持つかを「精度」といい、fp16・bf16・fp8 などがあります。fp8 は fp16 の半分の大きさで済むかわりに、画質が少し落ちることも。公式の GPU の選び方では、fp8 は「メモリを減らすかわりに画質が下がる」とされ、RTX 40 シリーズ以降が fp8 の計算に対応しています。
- はじめから fp8 の版を使う:Wan 2.2 14B の ComfyUI 公式の配布ファイルは fp8(wan2.2_t2v_high_noise_14B_fp8_scaled など)。文字を読む部品も umt5_xxl_fp8_e4m3fn_scaled という fp8 の版がある
- 読み込むときに fp8 にする:「拡散モデルを読み込む」(Load Diffusion Model)ノードの weight_dtype を fp8_e4m3fn などにする。選べるのは default・fp8_e4m3fn・fp8_e4m3fn_fast・fp8_e5m2(筆者は試していません)
- 小さいモデルにする:Wan 2.2 なら 14B ではなく 5B。公式チュートリアルでは、5B は「ComfyUI の標準のオフロードで VRAM 8GB に収まる」とされている
Anima の Turbo 版は、少ないステップで速く作るための版で、ファイルの大きさは Base と同じくらいです。VRAM を減らす方法ではありません。
GGUF(もっと小さくしたモデル)
GGUF は、モデルをさらに小さな数値に変えた形式です。ComfyUI 本体には入っていないので、カスタムノード(後から足す拡張機能)の ComfyUI-GGUF を使います。この README では「性能の低い GPU で、もっと少ないビット数で動かせる」と説明されています。使うときは、.gguf のファイルを models\unet に置き、「Unet Loader (GGUF)」ノードで読み込む形です。
README では「まだ作りかけ(WIP)」とされていて、LoRA の読み込みも「試験的」です。Wan 2.2 の GGUF 版は、公式チュートリアルのコミュニティの資料の欄に載っていますが、公式の配布ファイルではありません。筆者は、2026年11月1日に FLUX.2 [dev] の GGUF(Q4_K_M・Q8_0)を RTX 5090 で試しました。結果は FLUX.2 [dev] の必要スペックの記事にあります。ほかのモデルの GGUF は試していません。カスタムノードの入れ方は カスタムノードの入れ方にあります。
手順5:「VAE デコード(タイル)」に替える
VAE は、計算した結果を最後に目に見える画像に戻す部品です。大きな画像や動画では、この最後の「VAE デコード」で VRAM が足りなくなることがあります。生成の途中までは進むのに、最後で止まるなら、まずこれを疑ってください。
ComfyUI に最初から入っている「VAE デコード(タイル)」(VAE Decode (Tiled))ノードに替えると、画像を小さな区画(タイル)に分けて順番に戻します。初期値は、区画の大きさ tile_size 512、重ねる幅 overlap 64 です。動画の VAE では、一度に戻すフレーム数 temporal_size(初期値 64)も決められます。値を小さくすると、使う VRAM が減るかわりに時間がかかり、区画のつなぎ目が目立つことがあります(筆者は試していません)。
起動オプション --cpu-vae を付けると、VAE を CPU で動かせます。VRAM は使いませんが、とても遅くなります。
手順6:起動オプションで調整する
ComfyUI の起動オプションのうち、VRAM に関係するものをまとめました。説明は ComfyUI 0.43.0 の comfy/cli_args.py の文を筆者が訳したものです。筆者が試したのは --reserve-vram だけです。
| オプション | 公式の説明(筆者の訳) | メモ |
|---|---|---|
--reserve-vram 数字 | OS やほかのソフトのために予約する VRAM の量(GB) | 筆者は 1 で使用。容量を制限する機能ではない |
--vram-headroom 数字 | DynamicVRAM が、ほかのアプリの分も含めて、これだけ VRAM を空けておくようにする | 未検証 |
--lowvram | DynamicVRAM が有効なら何もしない。無効なら、文字を読む部品を CPU で動かす | 今の ComfyUI では効かないことがある |
--novram | --lowvram でも足りないときに | 未検証。かなり遅くなる見込み |
--cpu | すべてを CPU で動かす(遅い) | 未検証。最後の手段 |
--disable-smart-memory | モデルを VRAM に残さず、積極的にメインメモリへ逃がす | 未検証 |
--cache-none | 毎回すべてのノードを実行し直すかわりに、メモリと VRAM の使用を減らす | 未検証 |
--cpu-vae | VAE を CPU で動かす | 未検証 |
--fp8_e4m3fn-unet | 拡散モデルの重みを fp8 で持つ | 未検証。画質が少し落ちることがある |
--fp8_e4m3fn-text-enc | 文字を読む部品の重みを fp8 で持つ | 未検証 |
オプションは、ポータブル版なら run_nvidia_gpu.bat の1行目の最後に、半角スペースで区切って足します。いくつも足すと、どれが効いたのかわからなくなるので、1つずつ試してください。うまくいかなくなったら、足した文字を消せば元に戻ります。
RTX 5090 以外の人へ
筆者の GPU は RTX 5090(VRAM 32GB)だけで、8〜16GB の GPU では試していません。この記事の「VRAM が減る」という説明の多くは公式の説明で、筆者が少ない VRAM で効果を確かめたものではありません。
筆者は、--reserve-vram の値を変えて、VRAM 容量が少ない環境を想定した簡易テストもしています。Anima・Illustrious XL・SDXL・Wan 2.2 は、8GB・12GB を想定した設定でも最後まで生成できました。ただし、この設定は VRAM 容量を制限する機能ではないため、実際の 8GB・12GB 搭載 GPU での動作を再現・保証するものではありません。結果の表は RTX 5090 の生成速度の実測に、容量ごとの目安は ComfyUI に必要な PC スペックと VRAM の目安にまとめています。
VRAM が 8GB 前後なら、まず画像のモデル(Anima・SDXL・Illustrious XL)を 1024×1024 前後・batch_size 1 で試し、動画は Wan 2.2 5B を短い長さで試すのがおすすめです。
よくある質問(FAQ)
Q. ComfyUI で CUDA out of memory と出たらどうすればいいですか
まず ComfyUI を起動し直し、GPU を使うほかのアプリを閉じます。それでも出るなら、起動オプション --reserve-vram 1 を付け、解像度・動画の長さ・batch_size を下げてください。
Q. ComfyUI の --lowvram は効きますか
ComfyUI 0.43.0 の説明では、DynamicVRAM が有効なときは --lowvram は何もしないとされています。ソースコードを見ると、NVIDIA の GPU では DynamicVRAM が標準で有効になる作りです。
Q. --reserve-vram はいくつにすればいいですか
筆者は 1(約1GB)にしています。公式の説明では、OS やほかのソフトのために予約する VRAM の量(GB)です。大きくしても VRAM 容量を制限する機能ではありません。
Q. VAE デコードで止まるときは
最後に画像に戻す VAE デコードで VRAM が足りなくなっている可能性があります。ComfyUI に入っている「VAE デコード(タイル)」ノードに替えると、画像を区画に分けて順番に戻せます。
Q. GGUF のモデルを使うと VRAM は減りますか
カスタムノード ComfyUI-GGUF の説明では、低い性能の GPU でもっと少ないビット数で動かすためのものとされています。筆者が試したのは FLUX.2 [dev] だけです(2026年11月1日、RTX 5090、ComfyUI-GGUF 6ea2651)。GPU 全体の VRAM の最大は Q4_K_M が28.0GB、Q8_0 が30.9GB、fp8mixed が31.0GB でした。生成時間は Q4_K_M が約37.5秒、Q8_0 が約43.2秒で、RTX 5090 では fp8・NVFP4 より遅くなりました。--reserve-vram 20 の簡易テストでは、Q4_K_M で2枚目が55秒、VRAM の最大は12.6GB でした。12GB の GPU では確かめていません。詳しくは FLUX.2 [dev] の必要スペックの記事にあります。ComfyUI 本体には入っていないので、カスタムノードを入れる必要があります。
Q. VRAM が足りないと画質は落ちますか
メインメモリへ逃がしながら動く場合は、遅くなるだけで画質は変わらないと考えられます。fp8 や GGUF などの軽い版のモデルに替えると、画質が少し変わることがあります。
まとめ
- out of memory が出たら、まず ComfyUI の起動し直しと、ほかのアプリを閉じる
--reserve-vram 1で少し残し、解像度・長さ・batch_size を下げる- 軽い版のモデル(fp8、Wan なら 5B)や「VAE デコード(タイル)」も効く(公式の説明)。今の ComfyUI では
--lowvramが効かないことがあるので、オプションは1つずつ試す
検証メモ
- 試した環境:Windows 11 / GeForce RTX 5090(VRAM 32GB)/ メモリ 128GB / ComfyUI 0.43.0 ポータブル版(試験用のフォルダ)。オプションの説明は、この ComfyUI 0.43.0 に入っている comfy/cli_args.py と README で確かめました(2026年10月29日)。
- 根拠:ComfyUI 公式の README と起動オプションの説明(ソースコードの comfy/cli_args.py)、公式チュートリアル、それに筆者が RTX 5090 で実際に out of memory になったときの記録です。
参考にした公式資料
- ComfyUI(GitHub・公式 README):VRAM とメモリの管理、オフロード
- ComfyUI comfy/cli_args.py(公式):起動オプションの説明(0.43.0 で確認)
- ComfyUI 公式 wiki:Which GPU should I buy for ComfyUI:fp8 と画質・メモリ
- ComfyUI 公式チュートリアル:Wan2.2 Video Generation:5B は 8GB に収まるという説明、fp8 のファイル
- city96/ComfyUI-GGUF(GitHub・カスタムノードの公式):GGUF の置き場所とノード