この記事について(広告・アフィリエイトリンクはありません)
使ったソフトとモデルは、すべて無料で入手できます。試した環境の一覧は検証の記録にあります。
ComfyUI-AudioSR は、音声の高い音(高域)を AI で描き足して 48kHz にするノードです。 MiniMax H3 の動画の音声(32kHz で、16kHz より上がない)に使うと、16〜24kHz の帯域が足されました。4kHz より上を切った古い録音風の音声では、4〜9kHz あたりまでが描き足されています。
RTX 5090 で、5秒の音声が約4秒、41秒の音声が約80秒でした。所要時間は30分ほど、難しさは初心者〜中級です。
先に結論(今回のテスト条件で)
| 素材 | 16〜24kHz の量(全体比) | 1回の時間 |
|---|---|---|
| H3 の音声(32kHz、5秒)→ speech モデル | なし → -49 dB | 4.3秒(fp32、50ステップ) |
| 同じ → basic モデル | なし → -43 dB | — |
| 4kHz で切った音声(16kHz)→ speech | 8〜16kHz:-108 dB → -33 dB | — |
| 32kbps の MP3 → speech | 8〜16kHz:-46 dB → -36 dB | 4.4秒 |
| H3 の音声 41秒 → basic | 4〜16kHz が強くなる(-26 → -18 dB) | 83〜91秒 |
「なし」は、元の音声にその帯域が含まれていないことです。数字は帯域のエネルギーの全体に対する割合で、大きいほどその帯域の音が多いことを表します。
AudioSR とは?
AudioSR は、Haohe Liu さんたちの音声の超解像(帯域を広げる)モデルです(論文は2023年)。2〜16kHz までしか入っていない音声から、48kHz で 24kHz までの音を作ります。ComfyUI-AudioSR は、それを ComfyUI のノードにしたものです(MIT ライセンス)。
H3 や LTX など、音声つきの動画を作るモデルの音は、サンプリングレートが低めのことがあります。今回の MiniMax H3 の動画の音声は 32kHz で、16kHz より上の音がありません。その後処理に使えます。
ワークフロー
「音声を読み込む」→「AudioSR」→「オーディオを保存」をつなぐだけです。
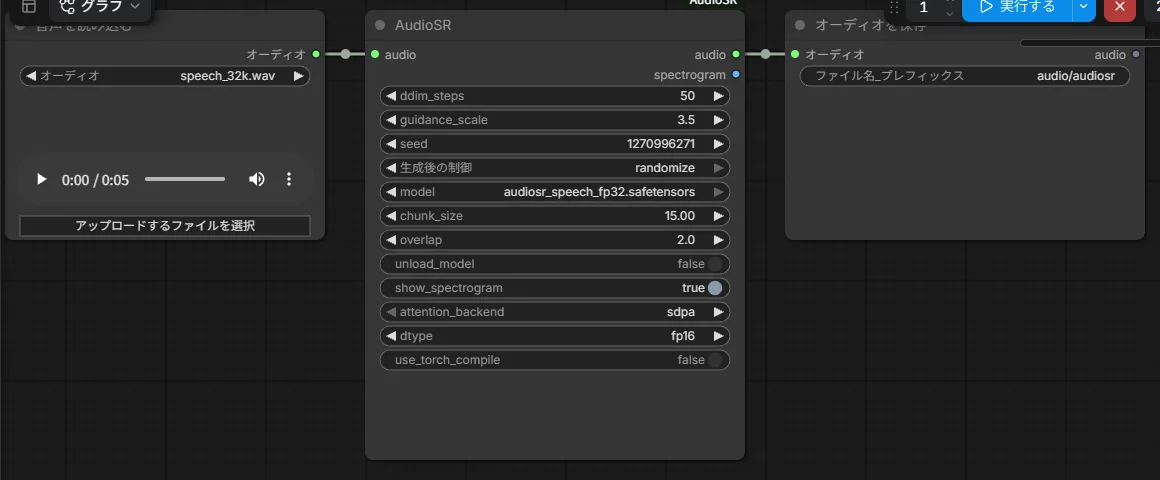
- AudioSR のワークフロー(JSON)ComfyUI-AudioSR が必要です。speech モデル、overlap 2.0、fp16 の設定です
H3 の音声で試す
MiniMax H3 で作った日本語の会話の動画(5秒)から音声を取り出し、speech モデルで処理しました。
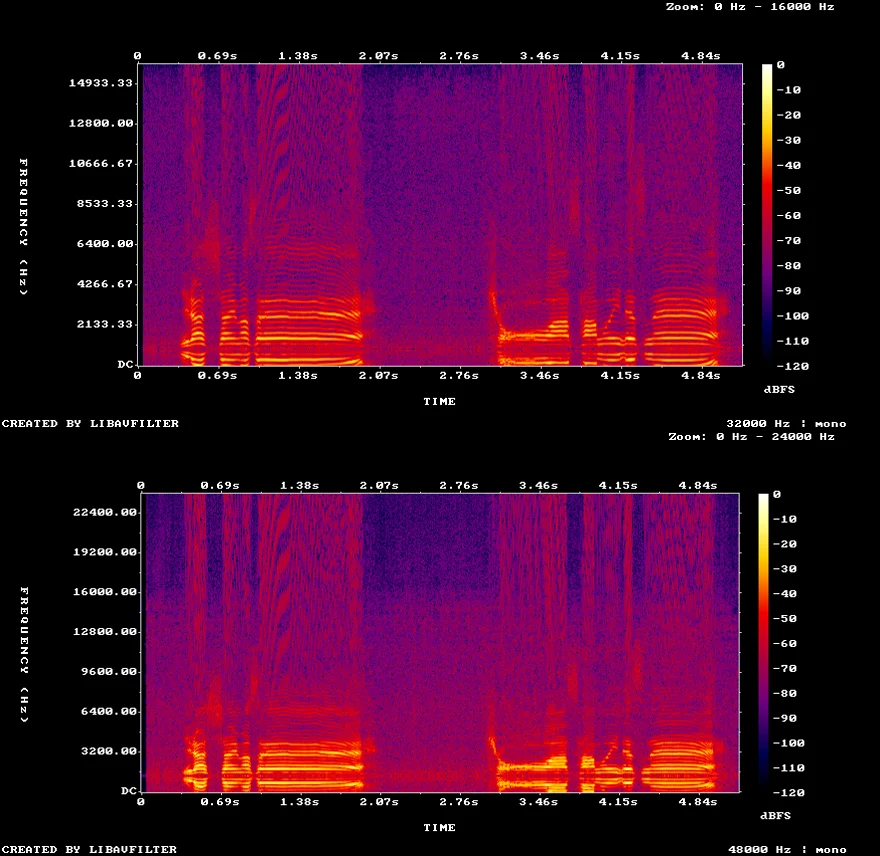
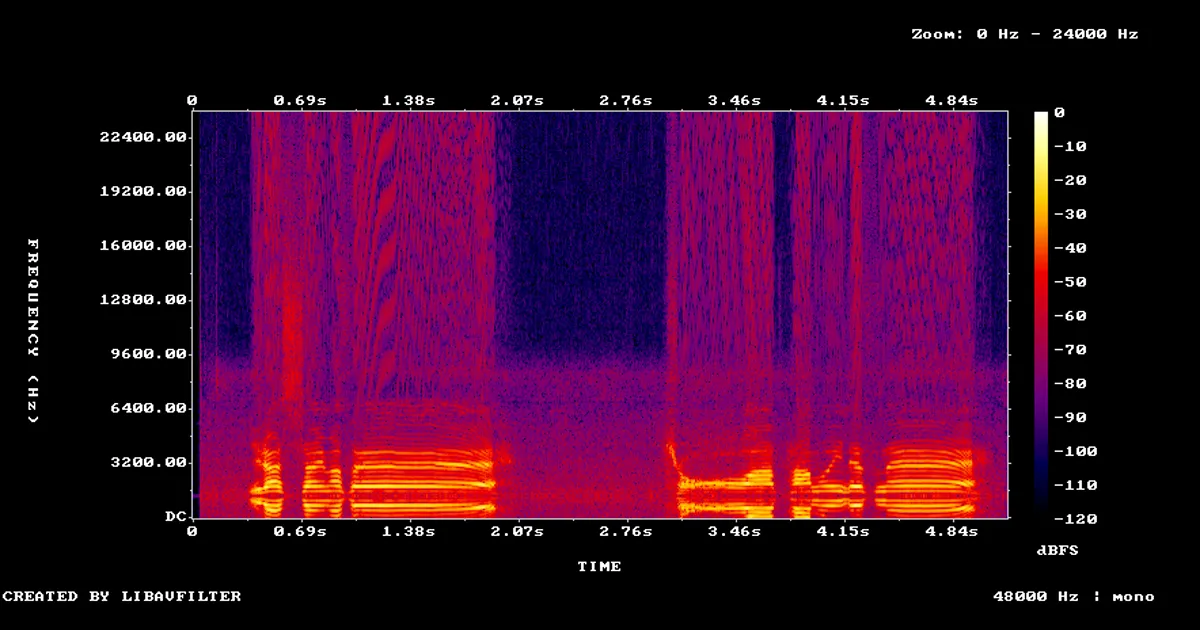
元の音声は 16kHz で切れていて、その上は空です。AudioSR のあとは 24kHz まで音が足されました。4〜16kHz の帯域はほとんど変わっていません。basic モデルのほうが、16kHz より上を強めに足しました(-43 dB と -49 dB)。
帯域の狭い音声で試す
同じ音声を 4kHz より上で切り、16kHz にしたもの(古い録音や電話の音のつもり)でも試しました。
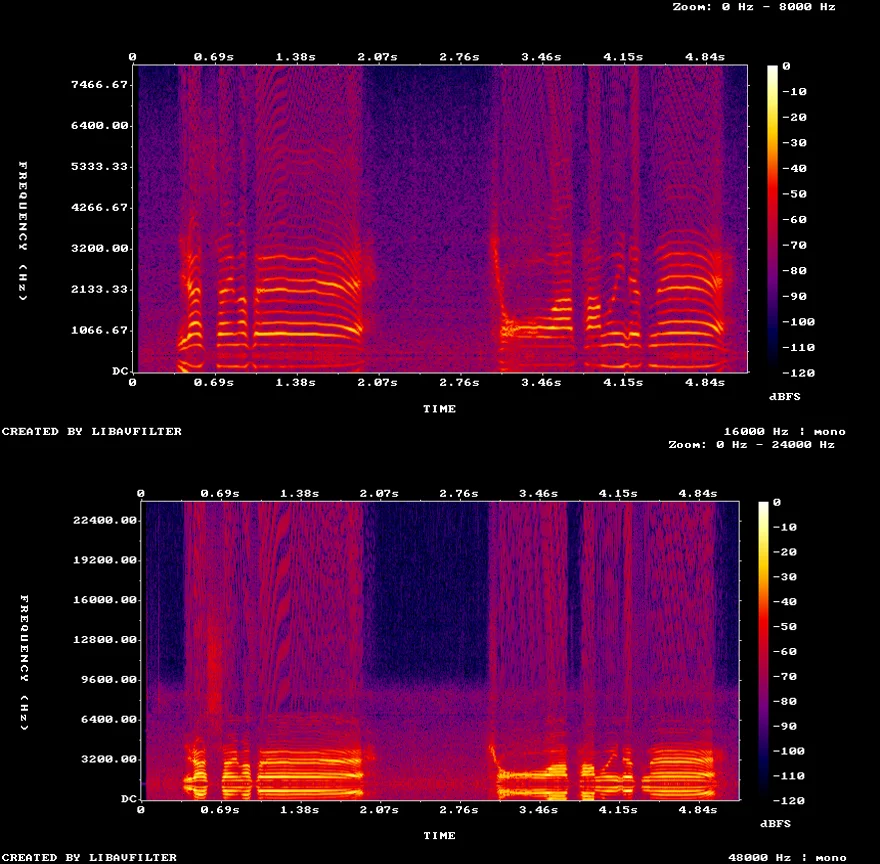
4kHz より上がほぼない音声から、9kHz 前後まで声の成分が描き足され、その上には薄いノイズのような成分が足されました。元の声にあった音を取り戻すのではなく、それらしく描き足している点に注意してください。
長い音声は overlap を付ける
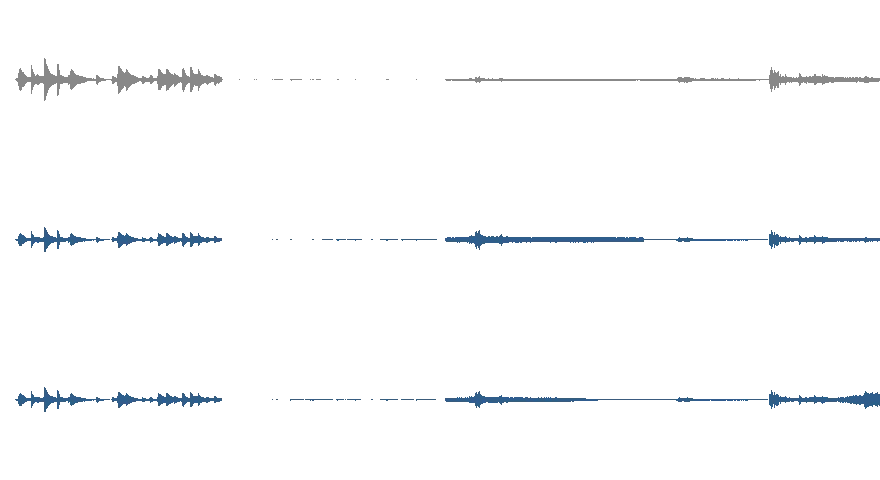
AudioSR は長い音声を chunk_size(既定 15秒)ごとに分けて処理します。H3 の6本の動画の音声をつないだ41秒の素材で、overlap 0(既定)と 2.0 を比べました。
| 15秒の前後(静かな部分) | 元 | overlap 0 | overlap 2.0 |
|---|---|---|---|
| 14.95〜15.0秒 | -49 dB | -53 dB | -42 dB |
| 15.0〜15.05秒 | -49 dB | -40 dB | -42 dB |
overlap 0 では、区切りの15秒ちょうどで音量が 12 dB 跳ねました。30秒の区切りでも 12 dB 下がっています。overlap 2.0 では区切りでの段差はなくなりました。どちらも、元が静かな部分に -40 dB 前後の音が足されています。
設定と時間
| 設定 | 5秒の音声の時間 |
|---|---|
| fp32、50ステップ(既定) | 4.3〜4.4秒 |
| fp32、100ステップ | 8.0秒 |
| fp16、50ステップ | 4.3秒 |
| bf16、50ステップ | 5.2秒 |
100ステップにしても、16〜24kHz の量はほぼ同じでした(-49.7 dB)。最初の1回はモデルの読み込み(5.9GB)で約100秒かかりました。処理のあとの VRAM 使用量は、ComfyUI 全体で 7.5GB です。
導入
ComfyUI\custom_nodesでgit clone https://github.com/Saganaki22/ComfyUI-AudioSR- ComfyUI の Python で
pip install -r ComfyUI-AudioSR\requirements.txt(librosa、phonemizer などが入ります) - モデルを
ComfyUI\models\AudioSRに置く
| ファイル | 大きさ | 用途 |
|---|---|---|
| audiosr_basic_fp32.safetensors | 5.9GB | 音楽・効果音など |
| audiosr_speech_fp32.safetensors | 5.9GB | 声 |
Hugging Face の配布ページでは、ファイルは AudioSR フォルダーの中にあります。
商用で使える?
ノードは MIT ライセンスで、README では元の AudioSR も MIT とされています。モデルの配布ページにもライセンスの記載があるか、使う前に確かめてください。筆者はモデルの配布ページのライセンス欄の原文までは確かめていません。
RTX 5090 以外の人へ
README の目安は VRAM 6GB 以上、メインメモリ 12GB です。今回、処理のあとの VRAM 使用量は ComfyUI 全体で 7.5GB でした。--reserve-vram での簡易テストはしていません。
よくある質問(FAQ)
Q. AudioSR とは?
音声の高い音を AI で描き足して、48kHz・24kHz までの帯域にするモデルです。ComfyUI では ComfyUI-AudioSR のノードで使えます。
Q. H3 の動画の音声に使える?
MiniMax H3 の音声は 32kHz で 16kHz より上がありません。AudioSR を通すと 16〜24kHz の帯域が足されました。5秒の音声で約4秒でした。
Q. 長い音声で音量が途中で変わるのは?
15秒ごとに分けて処理するためで、overlap 0 では区切りで音量の段差が出ました。overlap を 2.0 にすると段差はなくなりました。
まとめ
AudioSR は、音声つき動画の音の帯域を広げる後処理として ComfyUI の中で使えます。描き足すモデルなので、元にない音が足されることと、静かな部分にも音が乗ることは覚えておきます。
声は speech、長い音声は overlap 2.0。最後に音量を確かめる。
検証メモ
- 素材:MiniMax H3 で作った動画の音声(AAC 32kHz)。5秒の会話と、6本をつないだ41秒(会話・環境音)。4kHz で切った版と 32kbps の MP3 は ffmpeg で作りました。
- 帯域の量:音声全体を FFT にかけ、帯域ごとのエネルギーを全体に対する dB で出しました。音の良し悪しの評価ではありません。
- 音量:出力はピークが -6 dBFS にそろえられていました(5秒の音声は RMS で約 4 dB 大きく、41秒の素材は約 2.5 dB 小さくなった)。
- 時間:ComfyUI の実行開始から完了まで。モデルを切り替えた直後の回は読み込みを含みます。
- 未確認のこと:耳での聞き比べの評価、SageAttention、torch.compile、音楽だけの素材、ほかの GPU。