Anima で自分のキャラクターや絵柄を出したいときは、LoRA(元のモデルに追加して使う小さな学習ファイル)を作ります。これまでは学習ツールの環境づくりが大変でしたが、Anima-LoRA-Factory を使うと、画面からボタンを押すだけで学習できます。
この記事では、2026年10月30日に出た v6.0 を RTX 5090 で使い、オリジナルキャラクター「神楽坂すず」の画像60枚から、Anima 2B 用と 2.9B 用の LoRA を作りました。学習時間・VRAM と、できた LoRA で実際に生成した結果をまとめます。
試した環境
| 項目 | 内容 |
|---|---|
| GPU | NVIDIA GeForce RTX 5090(VRAM 32GB) |
| CPU / メモリ | AMD Ryzen 9 9950X3D / 128GB |
| OS | Windows 11 |
| ドライバ | NVIDIA 621.01 |
| Anima-LoRA-Factory | v6.0(2026-10-30、GitHub の Release の ZIP) |
| Python | 3.12.10(Factory 用に別の仮想環境を作成) |
| PyTorch | 2.14.1+cu130(Factory が自動で入れたもの) |
| 学習データ | オリジナルキャラクター「神楽坂すず」60枚(Anima で作った画像。キャプション付き) |
| 確認した日 | 2026年10月31日 |
Anima-LoRA-Factory は何をしてくれる?
Anima-LoRA-Factory は、Anima 用の LoRA を、プログラミングの知識なしで作れるようにした無料のツールです(Apache-2.0)。中身は、LoRA 学習でよく使われる sd-scripts で、それを画面から動かせるようにしてあります。学習が終わると、ComfyUI でそのまま使える形に自動で変換してくれます。
v6.0 で変わったこと
- Anima 2.9B(40ブロック)の学習に対応。モデルのブロック数は自動で読み取る(2B も学習できる)
- 「2エポックごとに保存」:途中の LoRA も ComfyUI 形式で残せる
- 「テキストエンコーダーの出力をキャッシュ」:学習を少し軽くする
- 「テキストエンコーダも学習する」(標準はオフ。絵柄・キャラなら通常オフで十分)
- RTX 50 シリーズで、初回に CPU 版の PyTorch が入ってしまう問題を修正(CUDA 13.0 用の PyTorch 2.14.1 を入れる)
いずれも v6.0 のリリースノート の内容です。
準備するもの
| もの | 入手先・メモ |
|---|---|
| Python(64ビット) | README の推奨は 3.10(3.10.6)。初回のチェックは 3.10〜3.12 を受け付ける(今回は 3.12.10 で動いた) |
| Anima-LoRA-Factory | v6.0 の Release から ZIP を落として展開 |
| Anima の本体 | anima-base-v1.0.safetensors(README の指定。派生モデルでの学習は動作保証なし) |
| テキストエンコーダー | qwen_3_06b_base.safetensors |
| VAE | qwen_image_vae.safetensors |
| 学習用の画像 | 自分で作った画像か、権利を確かめた画像。今回は60枚 |
Anima 自体の入れ方は Anima の使い方 にまとめています。
使い方
- ZIP を展開したフォルダの
start.batをダブルクリックする。初回は仮想環境と PyTorch などを自動で入れるので、数分〜十数分かかる - ブラウザで画面(
http://localhost:8000)が開く - 学習用の画像フォルダを指定する。画像と同じ名前の
.txt(キャプション)がなければ、内蔵の WD14 Tagger で自動タグ付けできる - キャプションから、LoRA に覚えさせたい特徴(髪型や服など)のタグを消す。残したタグは「指示で変えられるもの」として学習される
- Anima 本体・VAE・テキストエンコーダー(Qwen3)の場所を指定する
- VRAM の設定・エポック数などを選び、「LoRA学習開始」を押す
今回のキャプションは「トリガーワード, 1girl, solo, 変わる部分(ポーズや背景)」の形です。キャラクターの外見(髪や服)はわざと書かず、トリガーワード kagurazaka_suzu に覚えさせました。
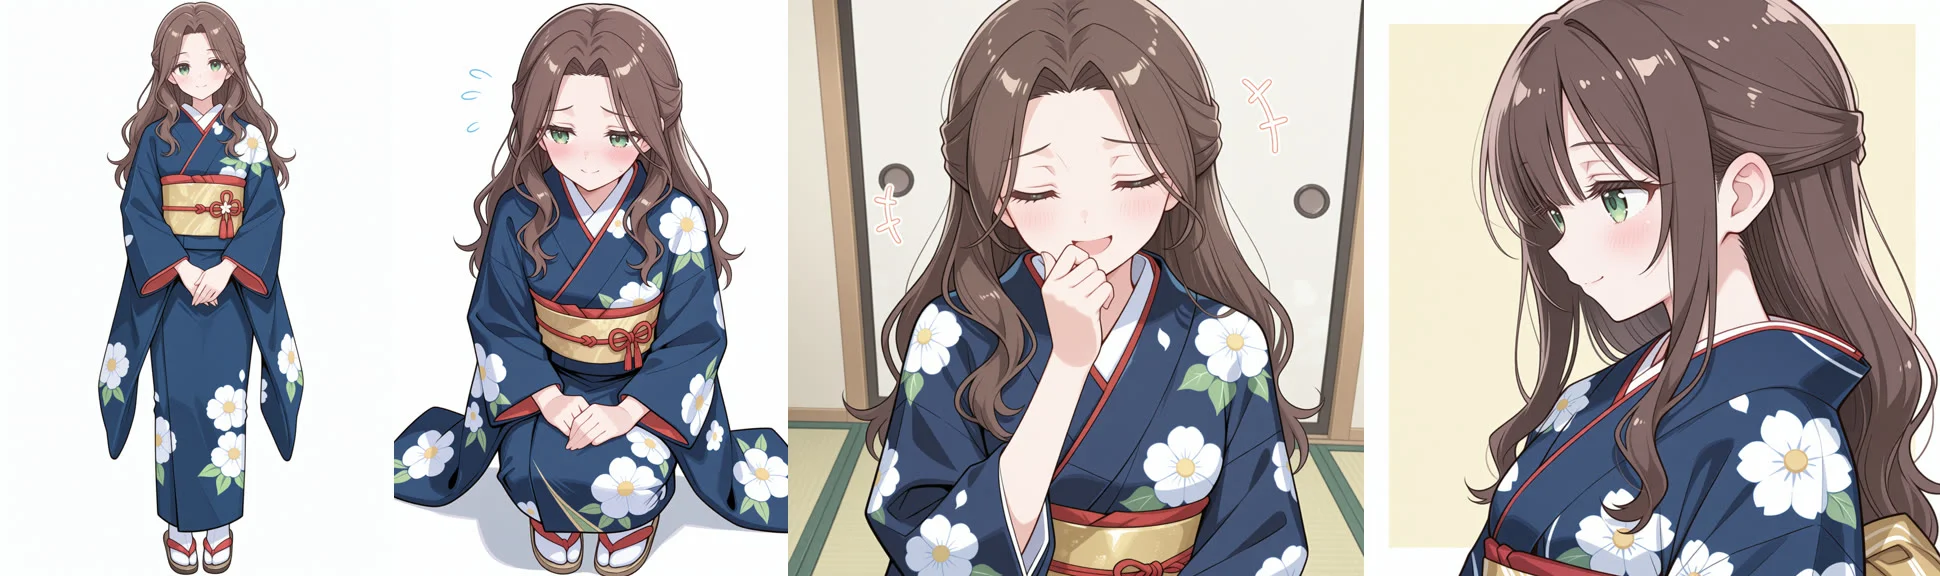
kagurazaka_suzu, 1girl, solo, full body, standing, front view, looking at viewer, smile, simple white background今回の学習設定
| 項目 | 設定 | メモ |
|---|---|---|
| エポック | 10 | 画面の初期値 |
| リピート | 2 | 初期値。60枚×2×10=1,200ステップ |
| 学習率 | 1e-4 | 初期値(「サクッと学習」) |
| Rank / Alpha | 16 / 16 | 初期値 |
| VRAM の設定 | 高画質(VRAM 24GB 以上) | RTX 5090 なので。初期値は「バランス(12〜16GB)」 |
| 2エポックごとに保存 | オン | v6.0 の新機能 |
| テキストエンコーダーの出力をキャッシュ | オン | v6.0 の新機能 |
学習時間と VRAM(実測)
| ベースモデル | ステップ | 学習時間(変換まで) | VRAM 最大(GPU 全体) | ブロック数(自動で読み取り) |
|---|---|---|---|---|
| Anima 2B(anima-base-v1.0) | 1200 | 約21分 | 8.6GB | 28 |
| Anima 2.9B(Anima-2.9B-preview-v1) | 1200 | 約27分 | 10.4GB | 40 |
時間は、Factory の学習履歴に記録された「開始から ComfyUI 形式への変換が終わるまで」です。VRAM は GPU 全体の使用量で、Windows の画面表示などのぶんも含みます。
「高画質」設定では、VRAM の入れ替え(blocks_to_swap)をしないので、VRAM が多い GPU ほど速く学習できます。
2.9B は 2B よりブロックが多いぶん、時間が長くかかりました。学習履歴の合計時間で 2B 1,268秒、2.9B 1,639秒、約1.3倍です。
できた LoRA で生成してみた
学習した LoRA を ComfyUI で読み込み、トリガーワードと「日本庭園で紅葉の中に立つ」という、学習データにない場面の指示で、シードを5つ変えて作りました。指示には、髪型や服装のタグは入れていません。
masterpiece, best quality, score_7, safe, kagurazaka_suzu, 1girl, solo, upper body, looking at viewer, smile, standing in a japanese garden, autumn leaves設定は Anima の基本どおり(30ステップ、CFG 4、er_sde、simple、832×1216、LoRA の強度 1.0)です。ネガティブには nsfw などを入れています。
| 組み合わせ | キャラの特徴が出た枚数 | メモ |
|---|---|---|
| 2B+2B 用 LoRA | 5/5 | 髪・目・着物・帯の特徴がすべてそろった |
| 2B(LoRA なし) | 0/5 | 黒髪で服装もばらばら(トリガーワードだけでは何も起きない) |
| 2.9B+2.9B 用 LoRA | 5/5 | 特徴はそろった。前髪が下りる・赤い髪飾りが付くなど、2B より学習データとの差が少し大きい |
| 2.9B(LoRA なし) | 0/5 | 黒髪で服装もばらばら |
| 2B+2.9B 用 LoRA | 0/5 | LoRA なしとほぼ同じ絵になり、効かなかった |
「キャラの特徴が出た」は、茶色のゆるい長髪・緑の目・紺地に白い花の着物・金の帯がそろっているかを、筆者が1枚ずつ見て数えたものです(筆者の見立て)。
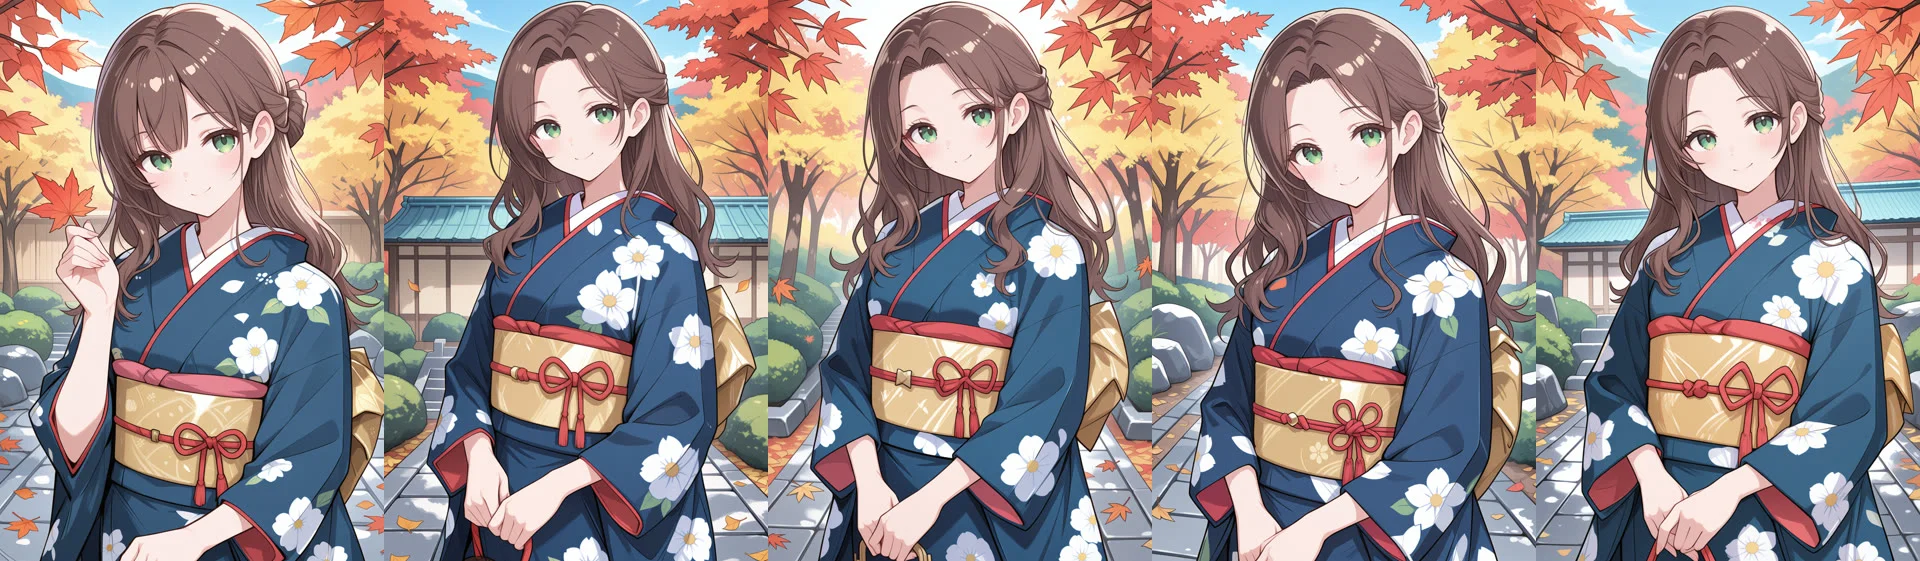
5枚は、葉を持つ、体の向きが違うなど、ポーズにも変化がありました。
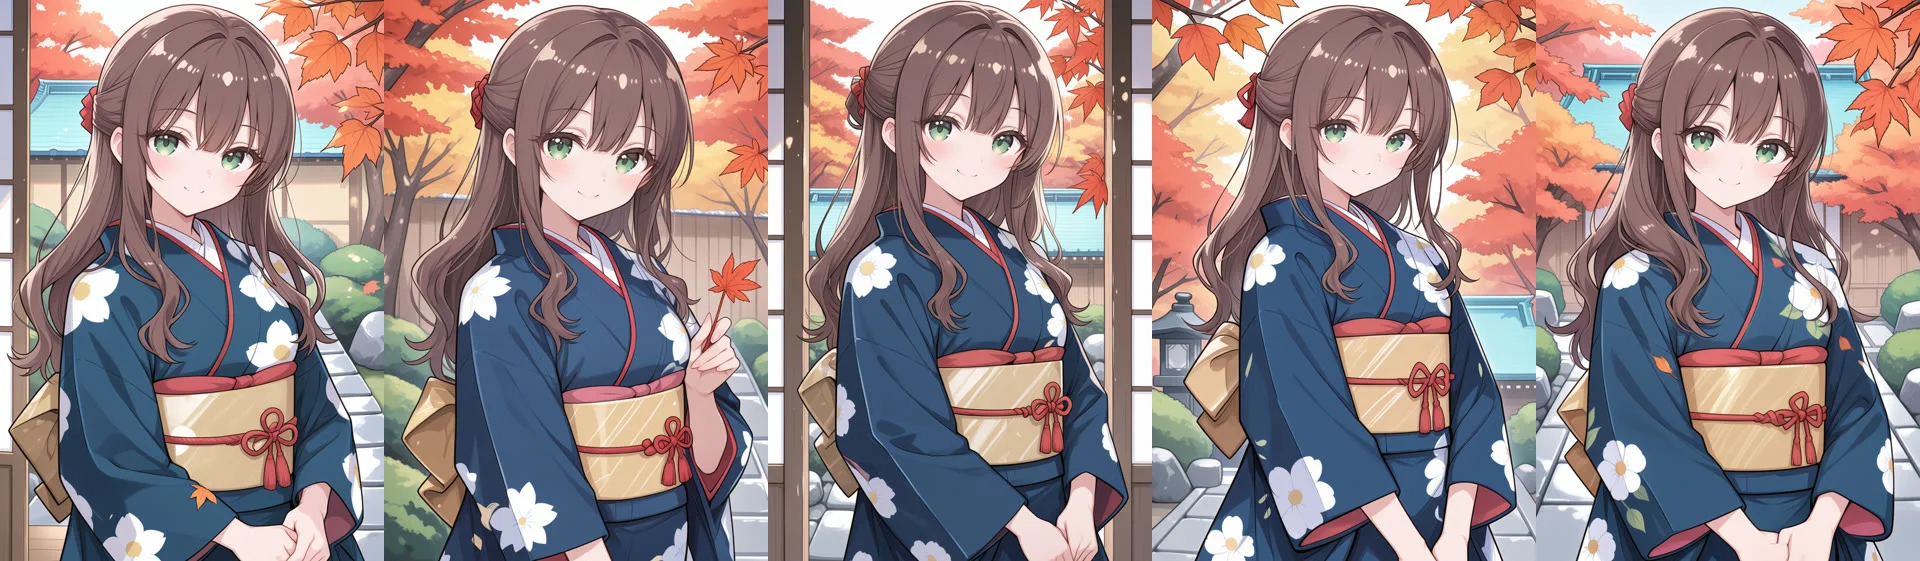
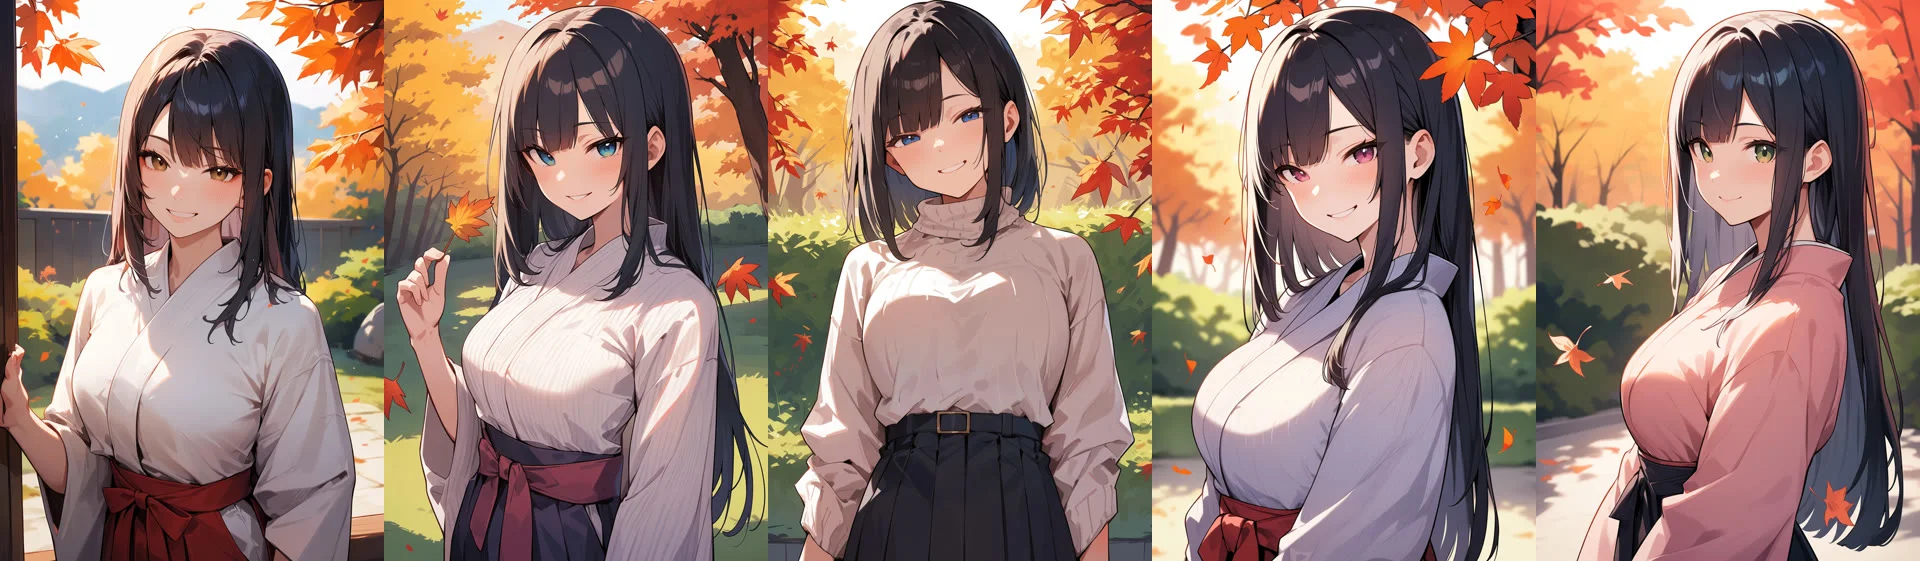
LoRA の使い方そのものは ComfyUI で LoRA を使う方法 で説明しています。複数のキャラクターを1枚に出すときは Anima で複数キャラを描き分ける も参考にしてください。
2B 用と 2.9B 用の LoRA の違い
Anima 2.9B は、Anima 2B(28ブロック)にブロックを足して 40ブロックにし、追加で学習したモデルです。公式の Anima(circlestone-labs)ではなく、Hugging Face の Gazingstars123/Anima-2.9B で配られている第三者のモデルで、ライセンスは Anima と同じ非商用ライセンスです。
ブロックの数が違うので、2.9B で学習した LoRA は 2B では効きません(Factory v6.0 のリリースノート)。2B 用の LoRA を 2.9B に使った場合は今回試していませんが、使うモデルと同じモデルで学習するのが基本です。
第三者のカスタムノード「ComfyUI-Anima-Remap」は、2B 用(28ブロック)の LoRA を 2.9B(40ブロック)で使うとき、ブロックの番号を自動で合わせるノードだと説明しています。この記事では動かしていません(未検証)。以前の「ComfyUI-Anima29B-Remap」は更新が終わっていて、後継のこちらに移っています。
RTX 5090 以外の人へ
今回は RTX 5090 で「高画質(VRAM 24GB 以上)」の設定だけを試しました。Factory には「バランス(VRAM 12〜16GB)」「低容量(VRAM 8GB 以上)」の設定もあり、モデルの一部を学習中に VRAM と RAM の間で入れ替えて(blocks_to_swap)、使う VRAM を減らします。そのぶん学習は遅くなります。これらの設定での時間は測っていません。
ライセンスと注意
- Anima のモデル本体は非商用ライセンスです。一方、作った画像は、商用を含めて自由に使えるとされています(Anima の LICENSE)。
- 個人は、Anima から作った派生モデル(LoRA など)を販売できます。モデルを組み込んだ有料サービスは別のライセンスが必要です(同)。
- Anima-LoRA-Factory 自体は Apache-2.0 です。
- 学習に使う画像は、自分で作ったものか、権利を確かめたものにしてください。実在の人物や他人のキャラクターの学習は、権利や規約の問題になることがあります。
よくある質問(FAQ)
Q. Anima の LoRA はどうやって作りますか?
Anima-LoRA-Factory を使うと、画像フォルダとモデルの場所を指定して「LoRA学習開始」を押すだけで作れます。学習後は ComfyUI 形式に自動で変換されます。
Q. Anima の LoRA 学習にかかる時間は?
今回は60枚・1,200ステップで、RTX 5090 で 2B が約21分、2.9B が約27分でした。
Q. Anima の LoRA 学習に必要な VRAM は?
RTX 5090 の「高画質」設定で、GPU 全体の VRAM が最大 約8.6GB(2B)でした。Factory には VRAM 8GB 以上・12〜16GB 向けの設定もありますが、今回は試していません。24GB 未満の GPU で「高画質」設定が動くかも未確認です。
Q. 2.9B 用の LoRA は 2B で使えますか?
使えません。Factory v6.0 のリリースノートで、2.9B で学習した LoRA は 2.9B 専用とされています。今回、2.9B 用の LoRA を 2B に付けて試したところ、5枚とも特徴は出ませんでした(0/5)。逆の組み合わせ(2B 用を 2.9B に)は今回試していないので、使うモデルと同じモデルで学習してください。
Q. RTX 50 シリーズで CPU 版の PyTorch が入ってしまいます
v6.0 で直っています。今回の RTX 5090 では、初回の起動で PyTorch 2.14.1(CUDA 13.0 版)が自動で入りました。
Q. 作った LoRA や画像は商用で使えますか?
Anima の LICENSE では、作った画像は商用でも使え、個人は LoRA などの派生モデルを販売できるとされています。モデルを組み込んだ有料サービスは別のライセンスが必要です。
まとめ
Anima-LoRA-Factory v6.0 を使うと、RTX 5090 で60枚の LoRA が 2B なら約21分で作れました(今回のテスト条件で)。RTX 50 シリーズでも環境づくりで止まらず、学習から ComfyUI 用の変換まで画面だけで終わります。2.9B を使う人は、2.9B で学習し直すのを忘れないでください。
検証メモ
- 学習時間の中身:合計時間には ComfyUI 形式への変換の時間を含みます。1ステップごとの時間は記録に残っていません。
- 別のツールとの差:同じ60枚を ZenTrainer 0.4.0 で学習したときは、1200ステップの学習本体が602秒でした。rank・学習率・解像度などの設定も VRAM の測り方も違うので、速さの比較にはなりません。この LoRA の5枚は構図がほぼ同じで、Factory の 2B 用のようなポーズの変化は出ませんでした。原因は確かめていません。
- 試していないこと:2B 用の LoRA を 2.9B に使う組み合わせ、ComfyUI-Anima-Remap、Factory の「バランス」「低容量」の設定、24GB 未満の GPU。