この記事について(広告・アフィリエイトリンクはありません)
使ったモデルは、すべて無料で入手できます。試した環境の一覧は検証の記録にあります。
P-H3-Image を2ステップで描くための「pDMD 2-step student」LoRA は、ComfyUI の LoRA ローダーにそのまま入れると、624個の重みがすべて読み込まれず、何も効きませんでした。 名前を ComfyUI の形に変換して効かせても、2ステップの絵はぼやけたままで、LoRA なしの2ステップと大差ありませんでした。
作者自身も「学習不足で、自分の評価で負けている」「使用はおすすめしない」と書いています。速くしたいなら、同じ作者の Turbo LoRA で4ステップにするのが、今回いちばんよい結果でした。所要時間は30分ほど、難しさは中級です。
先に結論(今回のテスト条件で)
| 条件 | 1枚の時間(2048×2048) | 結果 |
|---|---|---|
| 8ステップ(LoRA なし、公式の手順) | 約4.9秒 | くっきり。基準 |
| 2ステップ(LoRA なし) | 約2.4秒 | 全体がぼやける |
| 2ステップ+student(そのまま) | 約2.4秒 | LoRA が読み込まれず、LoRA なしと完全に同じ画像 |
| 2ステップ+student(変換して適用) | 約2.2秒 | 効いたが、ぼやけたまま。細部が少し変わる程度 |
| 2ステップ+Turbo LoRA | 約2.4秒 | ぼやける |
| 4ステップ+Turbo LoRA(shift 12) | 約3.0秒 | 8ステップに近い。文字もはっきり |
P-H3-Image int8、3つのプロンプト(ネオンのラーメン店、窓辺の人物、ロゴのポスター)、シード 101。時間はモデルの読み込みのあと、ComfyUI 0.44.0 の実行開始から完了までです。
pDMD 2-step student とは?
akhaliq/p-h3-image-pdmd-2step-lora は、P-H3-Image を2回の計算(2ステップ)で描けるように、pDMD という方法で学習させた rank 128 の LoRA です。学習の途中の6つのチェックポイント(各1.3GB)が公開されています。
作者の README によると、6つのプロンプトを見比べた評価で、8ステップの基準が6つ中5つで勝ち、この student は0、LoRA なしの2ステップも0でした。作者は「学習の記録として公開する。使うのはおすすめしない」と書き、2ステップで使うなら動画用の pDMD LoRA(Turbo LoRA)を勧めています。
ComfyUI に入れても効かない
一番新しい iter 1400 を ComfyUI の LoraLoaderModelOnly に入れると、コンソールに「lora key not loaded」が624行出ました。ファイルの中の重みの数も624個で、1つも読み込まれていません。
[WARNING] lora key not loaded: transformer.token_refiner.refiner_blocks.0.attn.to_k.lora_A.weight
[WARNING] lora key not loaded: transformer.token_refiner.refiner_blocks.0.attn.to_k.lora_B.weight
...(624行)
実際に、LoRA なしの2ステップと、student を入れた2ステップの画像を比べると、3つともピクセルの差は0でした。README にあるとおり、この LoRA は diffusers の名前の付け方(transformer.transformer_blocks.N.attn.to_q など)で保存されていて、ComfyUI の H3 の名前(blocks.N.attn.qkv_proj など)と合わないためです。
エラーで止まらず、警告だけで最後まで動くので、効いていないことに気づきにくい点に注意が要ります。
名前を変換して効かせると
比べるために、名前を ComfyUI の形に変換しました。q・k・v の3つを、ComfyUI のまとめた形(qkv_proj)に合わせてつなぎ、to_out を out_proj、ff を mlp に置き換えています。変換後は警告が出ず、画像も変わりました。
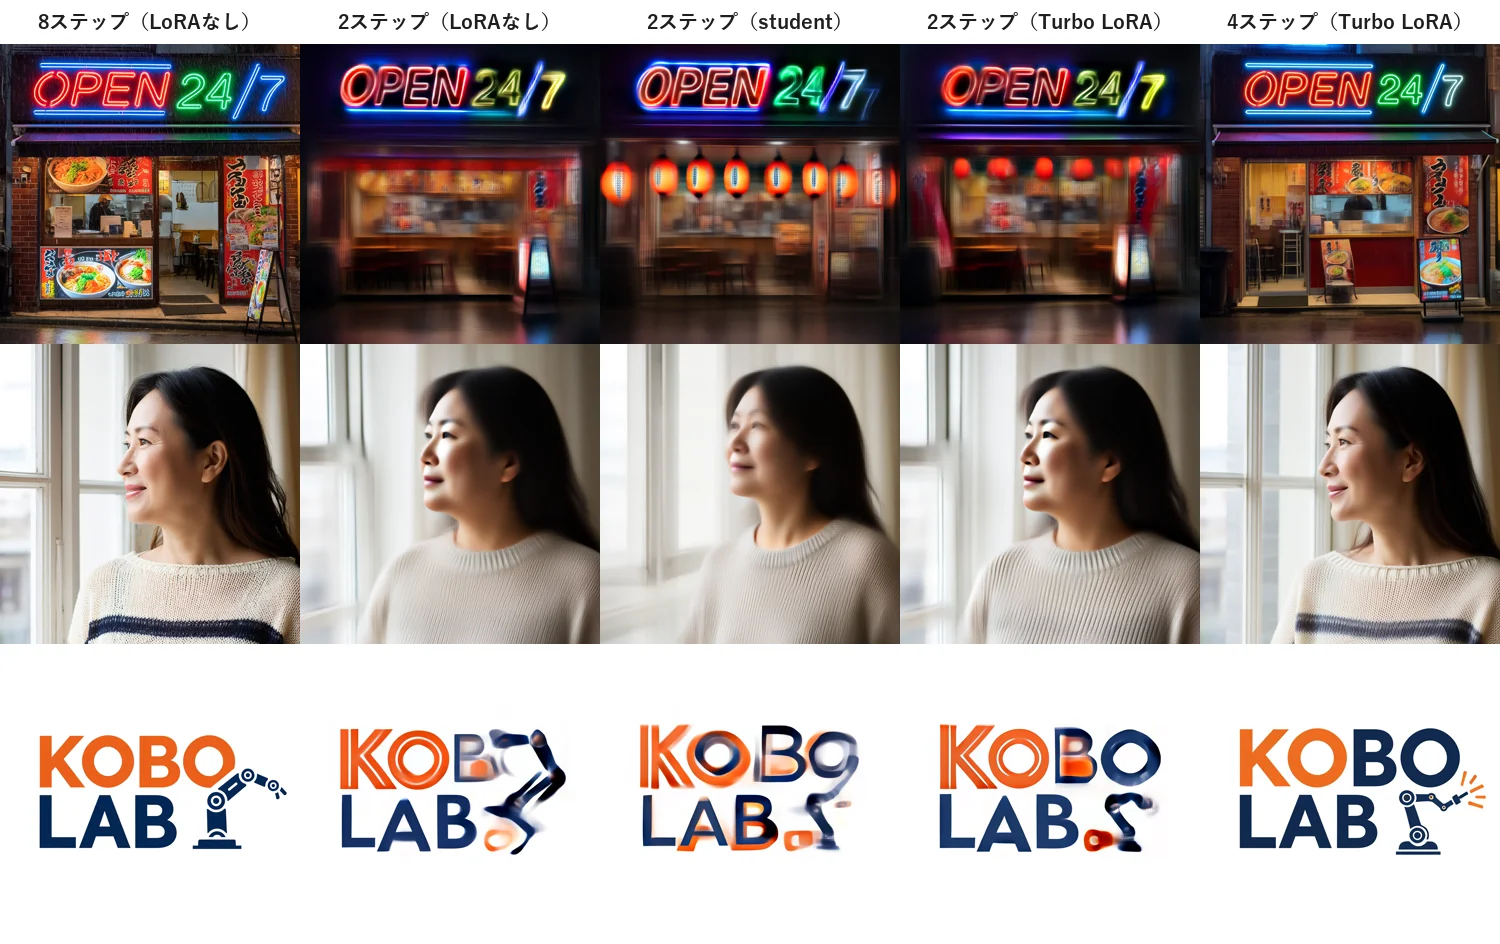
それでも2ステップの画像はぼやけたままでした。ラーメン店では提灯が足されるなど細部は変わりましたが、ロゴの文字やロボットの腕は崩れ、8ステップには届きません。作者の「0/6」という評価と同じ傾向でした。
一方、Turbo LoRA の4ステップ(shift 12)は、看板の文字、人物の服のしま模様、ロボットの腕まで、8ステップに近い絵になりました。
商用で使える?
student LoRA と Turbo LoRA は、どちらも MiniMax H3 Community License の派生物です。README では、別のライセンスなしの EU・英国・韓国・米国での利用が除外され、「Powered by MiniMax H3」の表示が必要とされています(H3 の導入編で説明しています)。
よくある質問(FAQ)
Q. P-H3-Image を2ステップで使える?
今回の試験では、どの方法でも2ステップの絵はぼやけました。pDMD 2-step student は作者もおすすめしていません。
Q. lora key not loaded が大量に出るのは?
LoRA の重みの名前が ComfyUI の形と合わず、読み込まれていないときに出ます。pDMD student は diffusers の名前なので、そのままでは1つも効きませんでした。
Q. P-H3-Image を速くするには?
Turbo LoRA を使い、shift 12 で4ステップにするのが今回いちばんよい結果でした。2048×2048 で1枚約3秒でした。
まとめ
pDMD 2-step student は、ComfyUI ではそのままでは効かず、変換しても2ステップの画質は出ませんでした。作者の評価どおり、今のところは使わないのが正解です。
速くしたいなら Turbo LoRA で4ステップ。lora key not loaded の警告は見逃さない。
検証メモ
- 設定:PH3ImageConditioning、2048×2048(4メガピクセル)、euler。8ステップは公式のシグマの並び(ManualSigmas)、そのほかは ModelSamplingMiniMaxH3(shift 12)と simple。作者の README は shift 12・2ステップと書いています。
- 変換:q・k・v の lora_A を縦につなぎ、lora_B をブロック対角に並べて、qkv_proj(rank 384)にしました。alpha は rank と同じ(倍率1)です。作者が想定した使い方(diffusers)ではないので、効き方が完全に同じとは限りません。
- Turbo LoRA の shift:shift 1 の4ステップは、モザイク状に崩れました。shift 12 で上の結果になりました。
- 試していないこと:diffusers での実行、ほかのチェックポイント(iter 210〜840)、参照画像ありの編集、作者の評価と同じ解像度(2912×2912)。