結論:手がかりがある写真なら数十m以内、ない写真は「分からない」と答えた
geo-sleuth は、写真の撮影場所を OpenStreetMap・標高データ・衛星画像・ストリートビュー を突き合わせて推定し、根拠のファイルつきで答えるエージェントスキルです。Claude Code などのAIエージェントに入れて「この写真はどこで撮った?」と頼むだけで動きます。
位置情報(EXIF)を消した公開写真3枚で試した結果はこうでした。
| 写真 | 手がかり | 所要時間 | エージェントの答え | 正解との距離 |
|---|---|---|---|---|
| ① 甲府の街中 | 看板の文字 | 7.8分 | 甲府駅南口(誤差18m・信頼度「中」) | 20m |
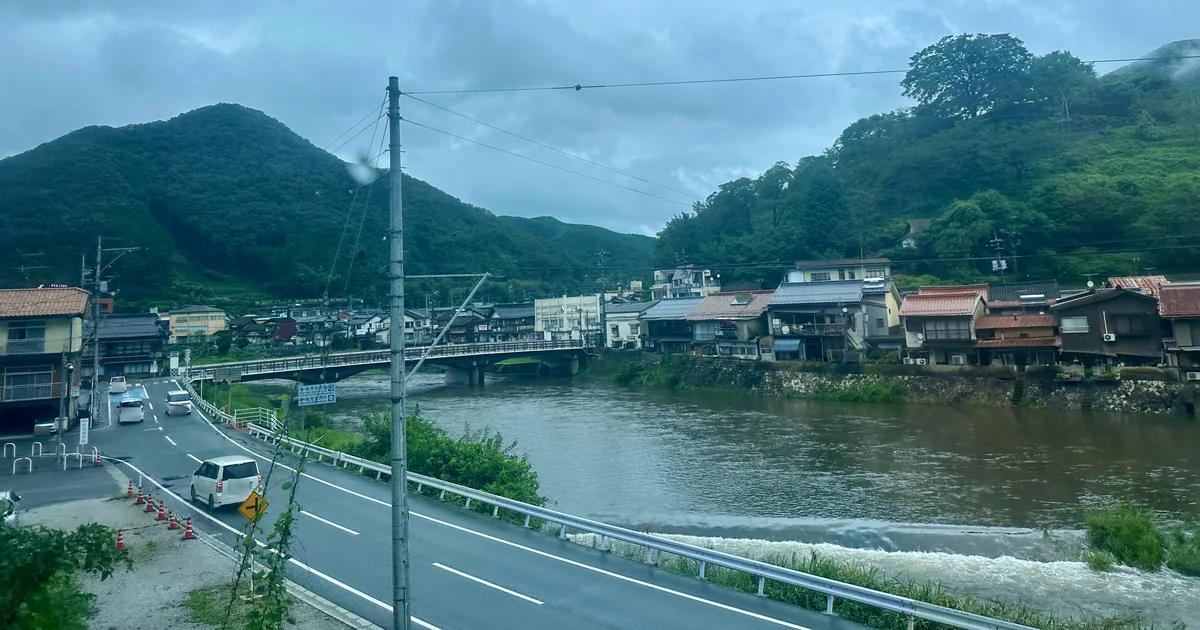
| ② 岡山県新見市の郊外 | 山・川・線路・ぼやけた標識 | 11.9分 | 新見市の伯備線沿い(誤差40m・信頼度「中」) | 2m |
| ③ 茨城県の水田 | ほぼなし | 14.6分 | 「特定できない」(参考点は栃木県南部、誤差100km・信頼度「低」) | 28.3km(当たりではない) |
※ 各写真1回ずつの結果です。精度の統計ではありません。
できること
- 看板・標識・線路・山並みなどの手がかりから、撮影地点を数十m単位まで絞り込む
- 答えに「誤差半径」と「信頼度」を付け、根拠になった画像やコマンド結果をファイルで残す
- 手がかりが足りないときは、無理に1点を言い切らず「特定できない」と返す(今回の③)
この記事では、導入手順、3枚のテスト結果、RTX 5090 で GPU を使うときの注意点を順に紹介します。使う前に知っておきたいプライバシーとデータ利用条件は、後半の「検証メモ」にまとめました。
geo-sleuth はどんなスキルか
- リポジトリ:Oldcircle/geo-sleuth(ライセンス:MIT)
- 公開日:2026-09-18/コミット82件/リリースなし(2026-11-03 時点)
- 対応エージェント:Claude Code、Codex、Cursor、Gemini CLI、OpenCode、GitHub Copilot(README 記載)
中身は SKILL.md(エージェント向けの手順書)と、20本あまりの Python スクリプトです。スクリプトが候補を絞り込んで順位を付け、AI は上位の数件から選ぶ、という役割分担になっています。
主な道具は次のとおりです(README の Toolbox より)。
| 役割 | スクリプト |
|---|---|
| EXIF・文字読み取り(OCR)・画像検索をまとめて実行 | intake.py |
| 太陽と影から方角・時刻を推定 | sun.py |
| OpenStreetMap から道路・線路・送電線などを検索 | osm.py |
| 標高データから山並み(スカイライン)を計算して照合 | terrain.py |
| ストリートビュー画像と写真を比較して順位付け | gsv.py / match.py |
| 衛星画像に撮影位置と視野を描いた証拠画像を作る | evidence.py |
スター数は注目度の数字です:GitHub のスター数は 5,681(2026-11-03 時点)ですが、精度を示すものではありません。README に載っている「誤差2m」などの事例も、作者によれば「1つのモデルで1回走らせた記録」です。
導入手順(Windows)
手順1:前提ツールを確認する
README が挙げる必須のものは Python 3.10 以上、uv、curl です。ほかに、npx skills で入れるなら Node.js、画像検索には Google Chrome(または Playwright の Chromium)を使います。検証PCのバージョンは次のとおりでした。
| ツール | バージョン |
|---|---|
| Python | 3.12.10(uv は自前の 3.14.9 を使用) |
| uv | 0.12.17 |
| curl | 8.21.0 |
| Node.js / npx | 24.14.1 / 11.11.0 |
| Google Chrome | 156 |
手順2:スキルを入れる
npx skills add Oldcircle/geo-sleuth -g -a claude-code -y-a claude-code で Claude Code 用にだけ入れています。検証PCでは 4.8秒 で終わりました。
手順3:doctor.py で環境をチェックする
インストールされたスキルの scripts フォルダにある doctor.py を実行します(パスは環境で変わるので、エージェントに「doctor.py を実行して」と頼むのが簡単です)。
uv run <スキルのフォルダ>/scripts/doctor.py
uv run <スキルのフォルダ>/scripts/doctor.py --network
--network を付けると、外部サービスにつながるかも確かめます(写真はアップロードされません)。
検証PCでは、FAIL は OpenStreetMap の検索サーバー(Overpass)の1件だけでした。1回目は接続タイムアウト、再実行では HTTP 502 の警告で、サーバー側が混んでいたようです。スクリプトは別のミラーに切り替えるので、テスト自体は進みました。
手順4:写真を渡して頼む
Claude Code に写真を渡して、こう頼むだけです。
この写真がどこで撮られたか特定して(find where this photo was taken)
RTX 5090 で GPU を使うときの注意(README のコマンドでは動かない)
ストリートビュー照合の match.py と衛星画像スキャンの sat_scan.py は、PyTorch で画像モデルを動かします。README には「Windows の既定は CPU 版。GPU を使うなら --find-links …/cu126/ を付ける。初回は約2.4GB」と書かれていますが、RTX 5090 ではそのままでは GPU が使えませんでした。
| 試したこと | 結果 |
|---|---|
README どおり --find-links …/cu126/torch/ | PyPI の CPU 版 torch(2.15.0)のほうが新しいため、uv が CPU 版を選んだ。ダウンロード約121MB、表示は ready (cpu, ...) |
--with "torch==2.14.1+cu126" で CUDA 版を指定 | 約2.4GiB ダウンロードして ready (cuda) と出るが、推論でエラー(RTX 5090 の sm_120 用カーネルがない) |
| cu134 版の torch 2.15.0 を指定 | 動作した(ダウンロード約2.0GiB・87秒、VRAM 増加は約900MB) |
動いたコマンドはこちらです。
uv run --find-links https://download.pytorch.org/whl/cu134/torch/ --with "torch==2.15.0+cu134" <スキルのフォルダ>/scripts/match.py rank --query photo.jpg --images cands/ --out ranked.jsonなお、候補画像1枚の小さなテストでは、GPU と CPU の処理時間はほぼ同じでした。GPU で速くなるかどうかは、今回は確かめられていません。 GPU がなくても geo-sleuth は動きます。RTX 30/40 シリーズでは cu126 版でも動く可能性がありますが、未検証です。
3枚の写真で試した
テストの条件
- 写真:Wikimedia Commons の公開写真3枚(出典は記事末尾)。撮影位置の座標が分かっているものを選び、EXIF(GPSなど)をすべて消してから、地名の入らないファイル名(photo1〜3.jpg)にしました。
- 担当:正解を知らない新しいエージェント(Claude Code のサブエージェント)に、写真と「どこで撮られたか特定して」という依頼を渡しました。地名のヒントはなし。
- 画像検索:3枚とも、Baidu・Yandex への画像アップロードを止めるオプション(
--no-rev)で実行。写真②だけ、画像検索ありでもう1回実行して比べました。
写真①:甲府の街中(看板あり)
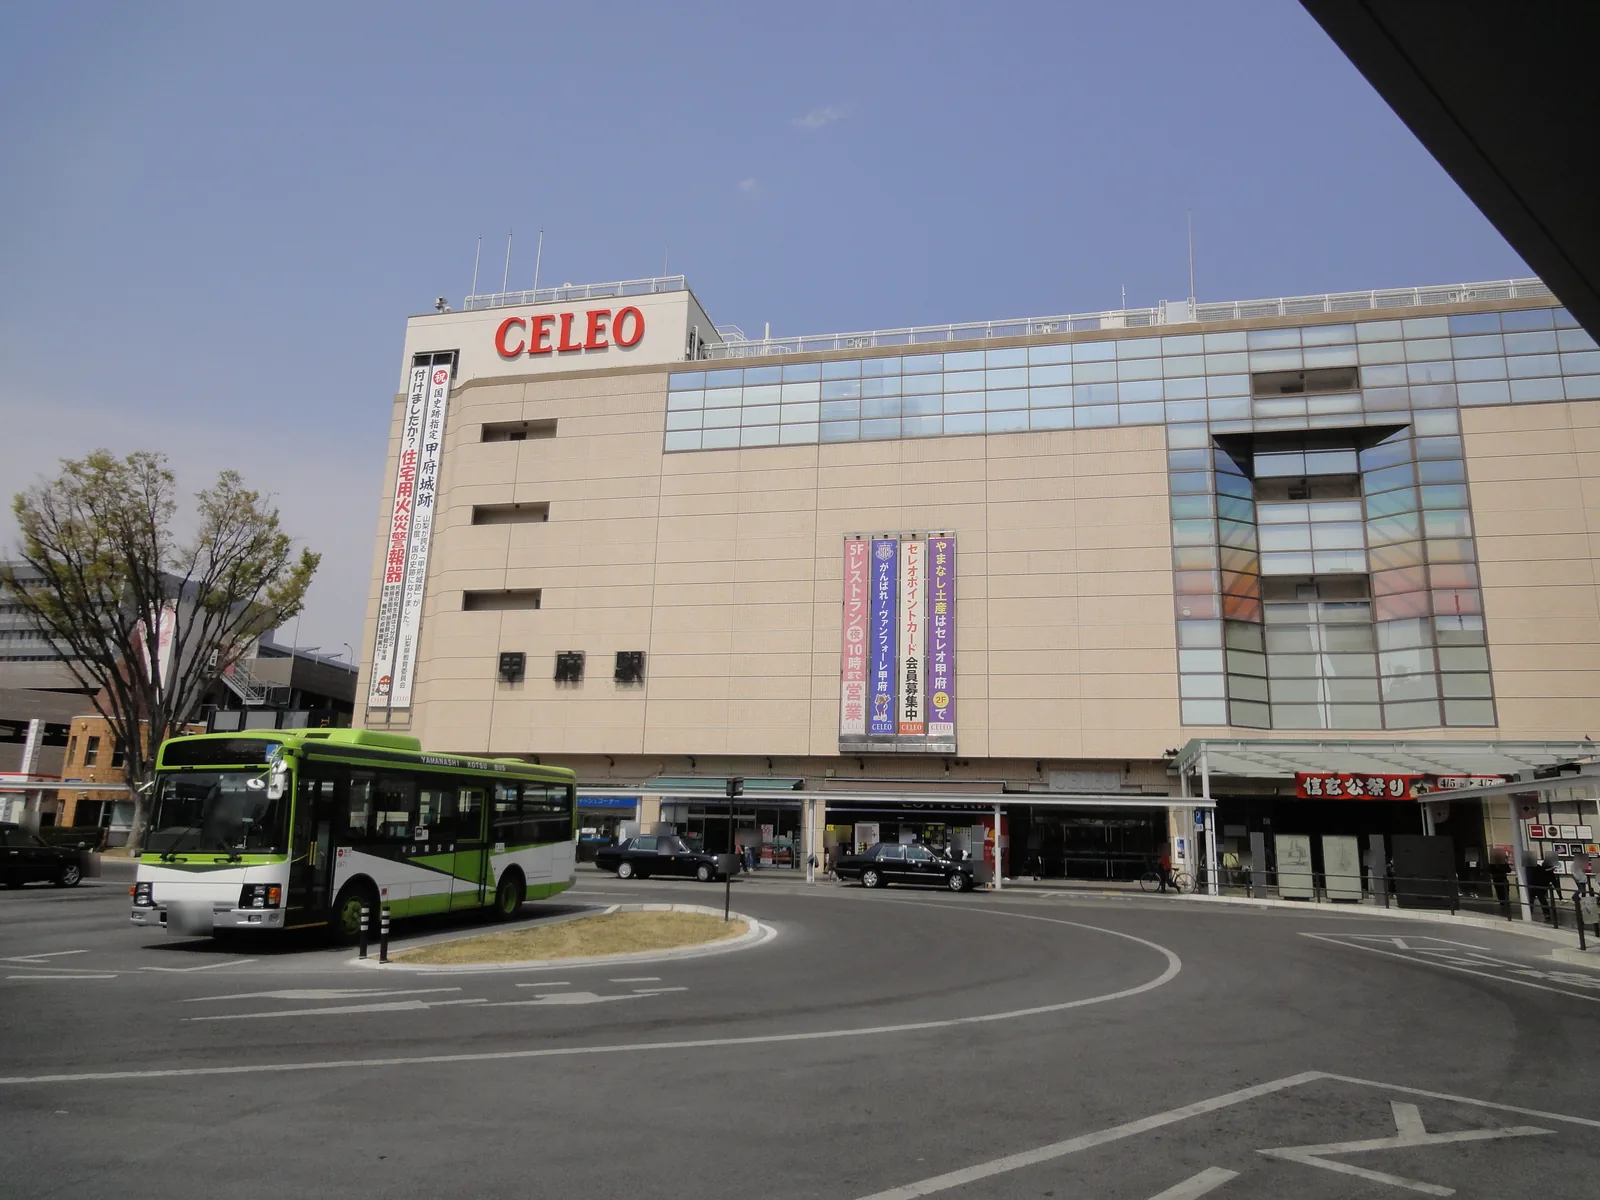
- 所要時間:7.8分(ツール呼び出し40回)
- 答え:甲府駅南口付近、誤差18m、信頼度「中」
- 正解との距離:20m
- 決め手:写真に写る看板の文字
看板の文字が読めたことが決め手になり、3枚の中で最も短い時間で答えにたどり着きました。距離の20mは、答えの誤差半径18mをわずかに超えています。
写真②:岡山県新見市の郊外(山・川・線路)
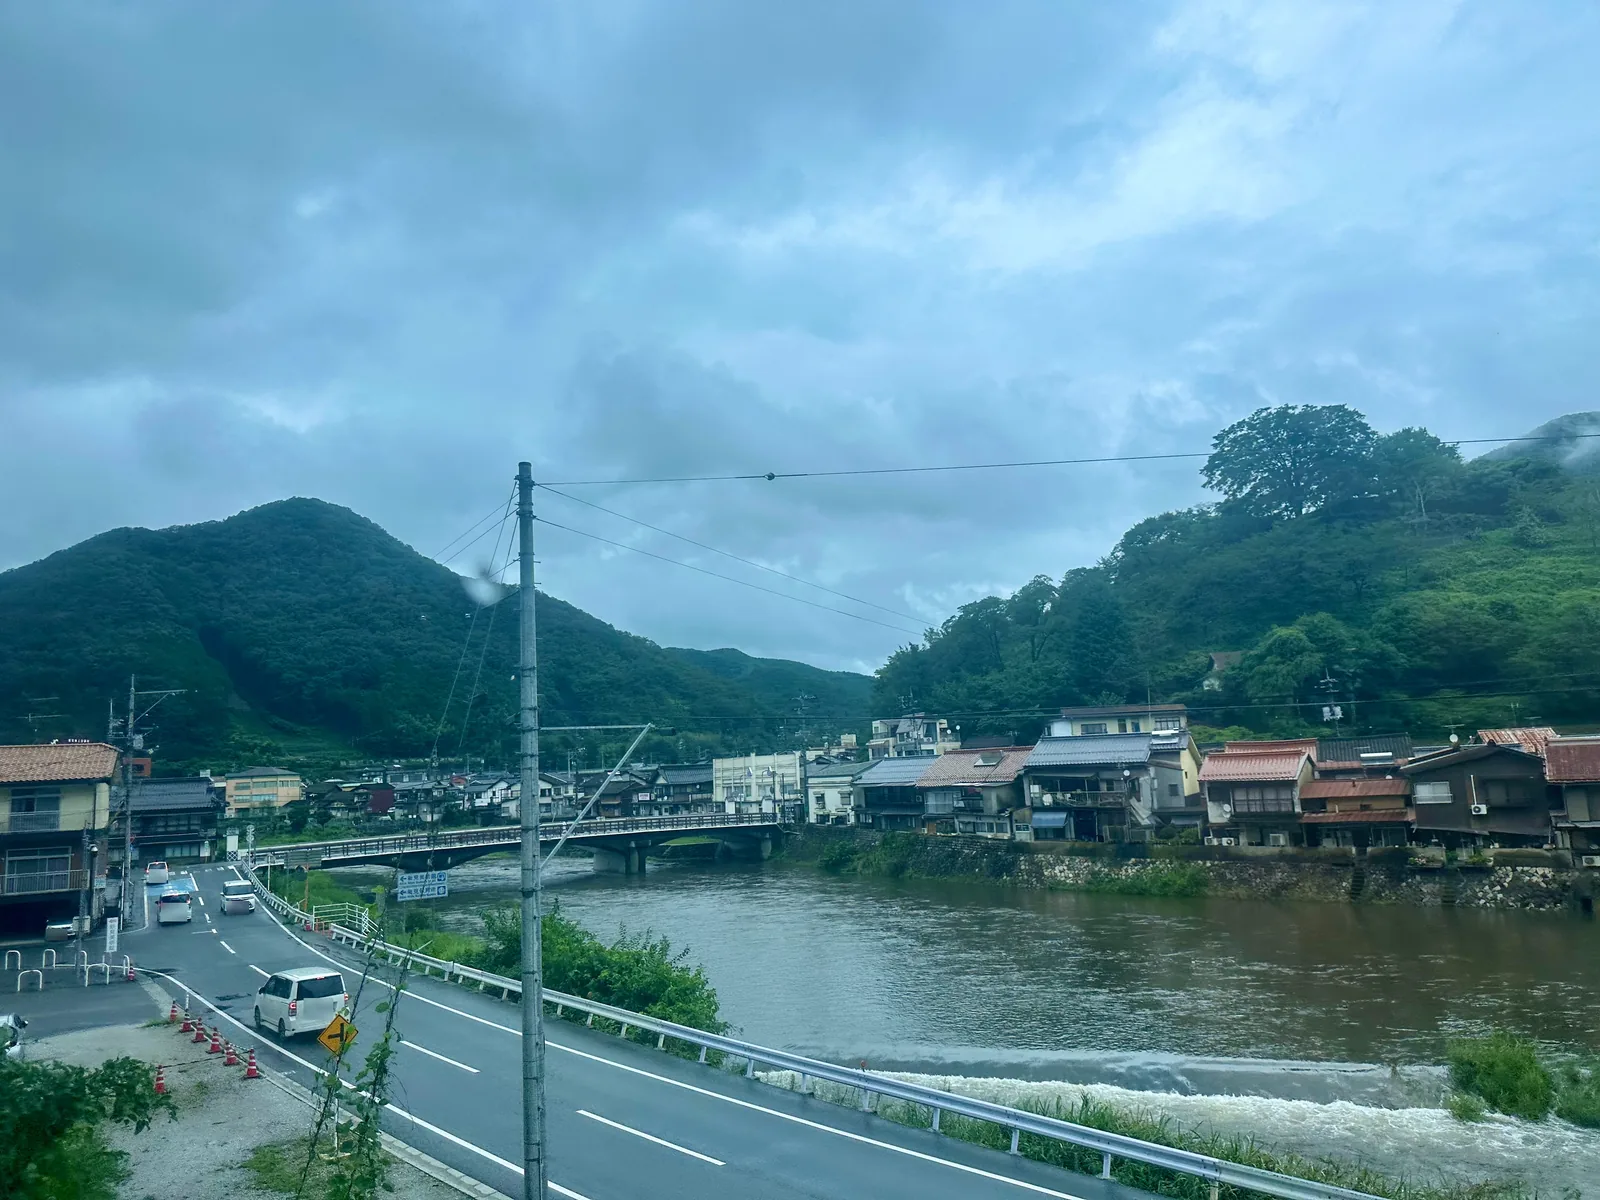
- 所要時間:11.9分(ツール呼び出し36回)
- 答え:新見市内の伯備線沿い、誤差40m、信頼度「中」
- 正解との距離:2m
- 決め手:ぼやけた標識の「新見美術館」の文字と、ストリートビューとの照合
2m という数字は偶然の要素が大きいと考えています。答えの誤差半径が40mなので、40m以内に入ったこと自体が成果です。また、正解の座標は走行中のスマホのGPSで記録された可能性があり、正解側にも数十mのずれがありえます。
写真②(画像検索あり):精度は同じで時間が長くなった
- 所要時間:16.3分(ツール呼び出し45回)
- 答え:同じ場所、誤差50m、信頼度「中」
- 正解との距離:11m
Commons で公開済みの写真なので元ページが見つかるかと思いましたが、見つかりませんでした。Yandex は島根県津和野町の別の写真を最上位に出し、Baidu は類似画像0件でした。今回の写真では、画像検索を足しても答えの場所は変わらず、時間が4.4分延びました。
写真③:茨城県の水田(手がかりがほとんどない)
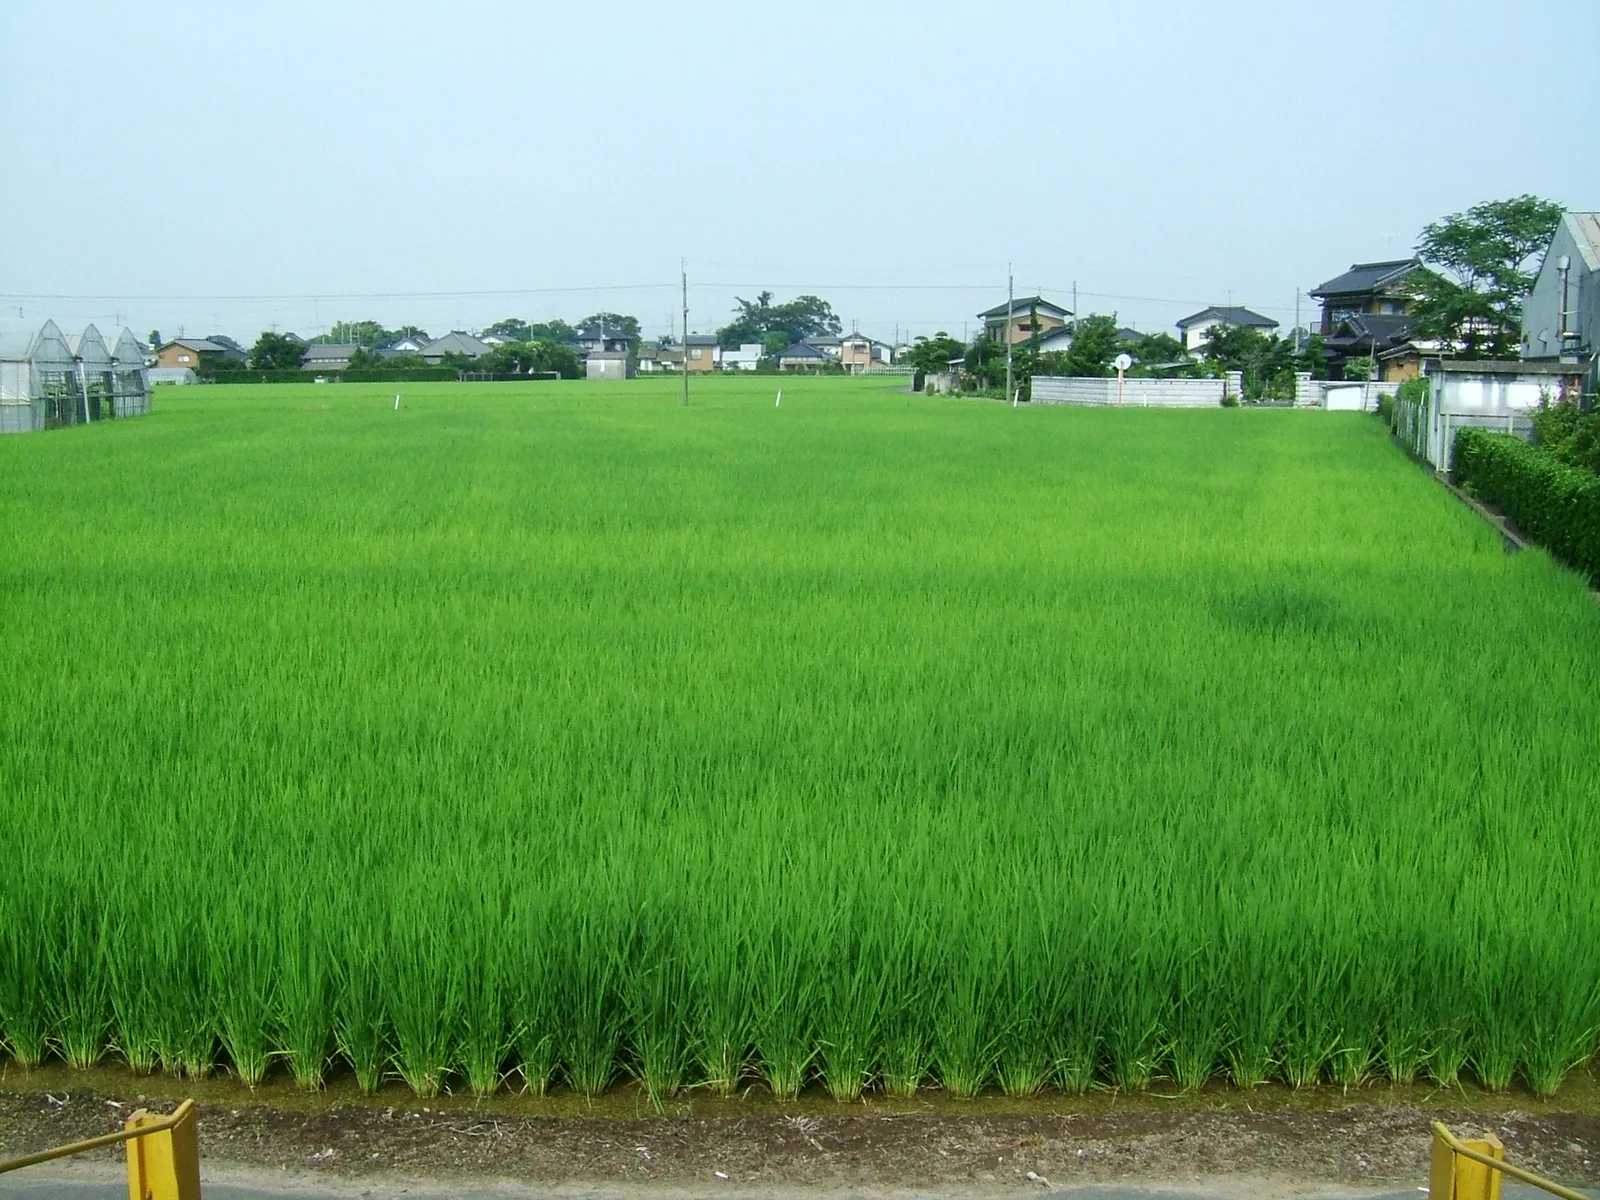
- 所要時間:14.6分(ツール呼び出し50回)
- 答え:「特定できない」。参考点として栃木県南部を挙げ、誤差100km・信頼度「低」
- 正解との距離:28.3km
田んぼと遠くの家並みだけで、読める看板も山並みもない写真です。エージェントは無理に1点を言い切らず、信頼度「低」で答えを保留しました。28.3km は「当たった」のではなく、広い範囲の中に正解が入っていただけです。なお、この写真の正解座標は写真のGPSではなく投稿者の申告値なので、距離は参考値です。
根拠の示し方
答えには毎回、誤差半径・信頼度・根拠にしたファイル(読み取った文字、比較したストリートビュー、衛星画像に視野を描いた証拠画像など)が付きます。「なぜそこなのか」を後から自分で確かめられるので、答えをうのみにせずに済みます。
失敗パターン:どんな写真が苦手か
今回の3枚と、スキルの資料から言えることをまとめます。
- 手がかりのない写真:田畑・空・林だけの写真は、地域まで絞れても地点までは届きません(写真③)。
- ストリートビューがない場所:照合の決め手になるので、カバーされていない山道や私有地は不利です。今回の写真②でも、決め手の1つがストリートビューでした。
- OpenStreetMap のデータが少ない地区:スキルの手順書は、データが少ない地区は候補から気づかないまま漏れるとして、先に
osm.py coverageで確かめるよう書いています。
OpenStreetMap の検索サーバー(Overpass)が不調だと、時間がかかったり再試行が必要になったりします(今回も 502 が出ました)。細かすぎる山並みも苦手で、標高データの解像度は約30m、100m より小さい地形は当てにならないとスキルの資料に書かれています。
実行の記録を読むと、途中の詰まりも見えました。文字の読み取り(OCR)では「甲府駅」が「甲府歌」に、「新見美術館」が「新见美热」に、稲の葉が「NAHA」に誤読されています。写真③では衛星画像スキャン(sat_scan.py)のスコアが 0.997〜1.00 に張り付き、順位が意味を持ちませんでした。同じ写真③では、board.py children Japan が3分を超えて走る間に候補を手で足したところ、後から終わった処理が board.json を上書きして証拠が消えました(入れ直して修復)。
よくある質問(FAQ)
Q. geo-sleuth は無料で使えますか?
スキル自体は MIT ライセンスで無料です。使うAIエージェント(Claude Code など)の利用料は別にかかります。今回の検証では有料APIは使っていません。
Q. GPU は必要ですか?
なくても動きます。RTX 5090 で GPU を使うなら、cu134 版の torch を指定してください(上の「RTX 5090 で GPU を使うときの注意」参照)。
Q. 1枚にどれくらい時間がかかりますか?
今回は8〜16分でした。README の事例では32〜72分かかったものもあり、写真の難しさで大きく変わります。
Q. ディスク容量はどれくらい必要ですか?
PyTorch のダウンロードだけで約2GBです。今回の検証全体では、torch を3種類試したこともあり、uv のキャッシュが約17.5GB増えました。内訳は検証メモにまとめました。
Q. 他人の写真の場所も調べられますか?
技術的にはできてしまいますが、本人の同意なく位置を調べるのはやめてください。README も「自分の写真か、分析の許可がある写真だけに使う」と明記しています。下の検証メモも読んでください。
検証メモ(留保・注意点)
ディスク使用量の内訳
uv のキャッシュは 14.47GB から 32.01GB に増えました(約17.5GB)。torch のダウンロードは3種類で合計約4.5GB(CPU 版 約0.12GB、cu126 約2.4GB、cu134 約2.0GB)で、展開後は約7.3GB になります(3.90GB、2.94GB、0.45GB)。残りには依存パッケージと実行環境が含まれ、細かい内訳は未確認です。
プライバシーの注意
他人の写真の位置特定に使わないでください。 今回、手がかりのある写真は数十m以内まで当たりました。SNS に上げた何気ない写真から、自宅や行動範囲が分かりうるということです。README の「Responsible use」も、同意していない人を探すことを禁じています。
- 自分の写真を公開するときも注意が必要です。 EXIF を消しても、看板・標識などから場所は特定されます。自宅周辺の写真は、写り込みを確認してから公開しましょう。
- 標準設定では写真が外部に送られます。 最初の手順(
intake.py)は、写真を Baidu(中国)と Yandex(ロシア)の画像検索にアップロードします。止めたい場合は--no-revを付けるよう、エージェントに指示してください。今回の写真②では、検索ありでも答えの場所は変わりませんでした。 - 写真そのものの写り込み:今回の写真①では、拡大するとバスのナンバーが読め、エージェントのレポートにもその文字列が残りました。結果を人に見せるときは、レポートの中身も確認してください。
コードのライセンスと、外部データの条件は別
| 対象 | 条件 |
|---|---|
| geo-sleuth のコード | MIT |
同梱の data/ のうち Wikipedia 由来の表 | CC BY-SA 4.0 |
| OpenStreetMap(Overpass でその場で検索) | ODbL。結果を公開するときは「© OpenStreetMap contributors」の表記が必要 |
| 標高データ | AWS Terrain Tiles(Terrarium) |
| 衛星画像 | 既定は Google の衛星タイル(予備で Esri World Imagery) |
| ストリートビュー | Google Street View を、APIキーなしで、公式 API ではない窓口から取得(スキルの data-sources.md と doctor.py より) |
| 画像検索 | Baidu・Yandex |
MIT なのはコードだけです。衛星画像やストリートビューの画像は各サービスの規約に従う必要があり、この記事でもそれらの画像は転載していません。エージェントが作った証拠画像をブログやSNSに載せる場合も、元の画像の規約を確認してください。
この検証の限界
- 各写真1回ずつの結果で、精度の統計ではありません。同じ写真でも、モデルや判断の違いで結果は変わりえます(README も同じ注意を書いています)。
- テスト写真は公開写真です。運営者自身の写真ではありません。Commons の写真は元ページがネット上にあるため、画像検索で見つかる可能性がありました(今回は見つからず)。
- 4本のテストを同時に実行したので、所要時間は単独で動かした場合と少し違う可能性があります。
- 最初は
claude -pで4本を起動しましたが、この PC のコマンドが未ログインの状態で、1秒以内に終了しました。そこで新しいサブエージェントでの実行に切り替えています。 - エージェントには「どこで撮られたか特定して」の一文に、作業上の条件(読むフォルダの制限・geo-sleuth を使うこと・
--no-revの有無など)を足して渡しました。実行記録を確認し、正解ファイルを参照していないこと、検索なしの回で--no-revが使われたことを確かめています。ただし正解ファイルを OS 上で読めなくしたわけではありません。 - 写真③のエージェントは、元画像を探す検索を Commons 向けも含めて3回行いましたが、元画像には届いておらず、回答への影響はありませんでした。
- GPU で処理が速くなるかは未確認です(候補1枚では CPU と同程度)。
- テスト担当のモデル:Claude Opus 5.5(Claude Code のサブエージェント)
画像の出典(Wikimedia Commons)
- 写真①:Kofu 20190407124702 (48316456602).jpg by inunami, CC BY 2.0(ナンバー・顔をぼかし加工、縮小)
- 写真②:Niimi Okayama 2023 august 17 various.jpeg by Nesnad, CC BY 4.0(車のナンバーをぼかし加工、縮小。アイキャッチはこの写真を切り抜いたもの)
- 写真③:Rice paddy fields near Tamamura Station Ibaraki Japan 20080715.jpg by LERK, CC BY 3.0(縮小)
検証環境
- PC:Ryzen 9 9950X3D / RTX 5090(32GB)/ RAM 128GB / Windows 11 Home
- 検証日:2026-11-03
- geo-sleuth:2026-11-03 時点の main(リリースなし)