ZenTrainerを使うと、LoRA学習をComfyUIの中でできます。筆者のRTX 5090では、AnimaのLoRA(60枚・1200ステップ)の学習が約10分で終わり、5枚中5枚でキャラの特徴が出ました。
これまでは、別の学習ツールを用意するのが普通でした。2026年10月30日に公開された0.4.0で、AnimaやSDXLにも対応しました。
この記事では、ZenTrainer 0.4.0の特徴と導入方法を公式の説明をもとに紹介し、筆者の学習結果も載せます。後半では、低VRAM向けの別の学習ツールも紹介します。情報は2026年10月31日時点(JST)のもので、測定の補足は末尾の「検証メモ」へ。
用語メモ:LoRA=元のモデルはそのままに、キャラクターや画風などを追加で覚えさせる小さな追加ファイル。学習させた絵柄やキャラを、生成のときに呼び出せます。
用語メモ:LoRA学習=自分で用意した画像を使って、LoRAを作ること。
ZenTrainer 0.4.0はComfyUIの中でLoRAを学習するツール
ZenTrainerは、ComfyUIの中でLoRAを学習するためのオープンソースのツールです。配布元はGitHubの Nynxz/ZenTrainer で、ライセンスはMITです。
公式の説明で挙げられている特徴のうち、使うときに関わるのは次の3つ。
- ComfyUIが持っているモデルのコードとGPUを、そのまま使って学習する
- 学習したLoRAは、そのままComfyUIのLoRAローダーに出てくる
- 「Simple」ではレシピ(おすすめ設定)を選ぶだけ、「Advanced」では全部の設定を自分で決められる
学習の途中で、一時停止、サンプル画像の生成、保存、学習率の変更もできます。キャラクターのLoRAでは、学習元の画像とどれくらい似ているか(類似度)を確かめられます。対応はNVIDIAのGPU(CUDA)とAMDのGPU(ROCm)で、WindowsとLinuxで動き、macOSには未対応です。
対応しているモデル
0.4.0で、学習を最初から最後まで確かめたと公式が書いているモデルは、次の10種類です。
- MOSS Image、Krea 2、Fibo 2.0、FLUX 3 Image、FLUX.2 Klein 9B、Qwen Image 2.1、Z-Image、Anima、SDXL(PonyやIllustriousなどの派生モデルを含む)、MiniMax H3(動画)
ほかのモデルも一覧に出てきますが、「untested(未確認)」と表示されます。
公式の説明による0.4.0の主な変更点は、次のとおりです。
- Anima、FLUX.2 Klein、SDXLとその派生モデルに新しく対応
- 学習したLoRAの情報(メタデータ)に、データセットのフォルダ名やキャプションが残らないようにした
- 「Animaの学習が1ステップ目で必ず失敗する」不具合を修正
注意:GitHubには、「ZenTrainer.exe だけをダウンロードして」と書かれた同じ名前の別のリポジトリがあります。本家の Nynxz/ZenTrainer は exe ファイルを配っていません。導入するときは、必ず本家から入れてください。筆者はこの別のリポジトリの中身を確かめていませんが、使わないことをおすすめします。
ZenTrainerのインストール方法
公式の説明では、入れ方は主に2つです。
方法1:カスタムノードとして入れる
- ComfyUI Manager から ZenTrainer をインストールする(または、
ComfyUI/custom_nodes/に git clone する) - ComfyUIを再起動する
- 画面上部のバーにある「蓮(lotus)」のアイコンをクリックする
ComfyUI 0.41以降が必要です。
用語メモ:カスタムノード=ComfyUIに機能を追加する拡張機能。ComfyUI Managerを使うと、画面から入れられます。
方法2:専用のComfyUIごと入れる
ZenTrainer専用のComfyUIを別に用意する方法です。普段使っているComfyUIを更新しても、学習に影響しないのが利点です。Windowsでは、Git for Windowsを入れてからリポジトリをcloneし、start-windows.bat をダブルクリックします。初回は、モデルの場所を聞かれ、GPUに合ったPyTorchが自動で選ばれます。
細かい手順は、公式の説明を参照してください。
関連記事:ComfyUIのカスタムノードの入れ方
ZenTrainerの使い方
公式の「Quick start」に書かれている流れは、次の3ステップです。
- New run → Simple を選び、レシピを選ぶ。写真を15〜40枚入れて、名前を付ける。足りないモデルは自動でダウンロードされ、写真のキャプション(説明文)も自動で付けられる
- 学習の様子を見守る
- できたLoRAは
output/zentrainer/loras/に保存される
データセットについての公式の説明は、次のとおりです。
- ComfyUIの
input/の中のフォルダが、そのままデータセットになる - キャプションは、ComfyUIを通してQwen-VLやGemmaで自動で付けられる
- SAM3で被写体を見つけるか、自分で塗ったマスク(白い部分だけ学習する範囲)を使える
用語メモ:キャプション=学習画像ごとに付ける説明文。「どんな絵か」をモデルに教えるために使います。
AnimaのレシピはAnimaの作者の推奨に沿ったもので、1500ステップ、解像度1024、rank 32、学習率2e-5です(公式の説明)。公式のメモには、37枚の写真で学習したとき、類似度が500ステップで0.41、1500ステップで0.60だったと書かれています。
なお、キャラクターの類似度を測る機能には、InsightFaceのモデル(非商用のみ)、または商用で使えるAuraFaceとYuNetを使うと書かれています。商用で使う場合は、この点を確かめてください。
それ以外の細かい使い方は、公式の説明を参照してください。
筆者の環境でAnimaのLoRAを学習してみた
条件
筆者の環境で、ZenTrainer 0.4.0を使い、AnimaのLoRAを学習しました。
| 項目 | 内容 |
|---|---|
| PC | RTX 5090(VRAM 32GB)/RAM 128GB/Win11 |
| ComfyUI | ポータブル版 v0.43.0(2026年10月30日のコミット)、torch 2.14.0+cu130 |
| ZenTrainer | 0.4.0(カスタムノードとして git clone、ほかのカスタムノードなし) |
| ベースモデル | Anima Base v1.0 |
| 学習データ | 筆者のオリジナルキャラクター「神楽坂すず」の画像60枚(キャプション付き、自動キャプションは使わず) |
| 設定 | rank 32、学習率 2e-5、解像度 1024、1200ステップ(以前の記事とそろえるため、レシピの1500から変更) |
学習は、画面ではなく、ZenTrainerのAPIから投入しました。設定の中身は、Simpleのレシピとほぼ同じです。
結果
| 項目 | 結果 |
|---|---|
| モデルの読み込み | 約2分11秒 |
| 学習(1200ステップ) | 602秒(約10分)、平均 約2.0 it/s(1200÷602秒) |
| 投入から完了まで | 751秒(約12.5分) |
| GPUのメモリ使用量(最大) | 23,974MiB(ComfyUIが持つモデルのキャッシュを含む) |
| できたLoRAのファイル | 約92MB |
用語メモ:it/s=1秒あたりに進む学習ステップの数。
できたLoRAで、学習データにない場面(日本庭園と紅葉)の画像を5枚作り、学習データの特徴(茶色の波打つ長い髪、緑の目、紺地に白い花の着物、金色の帯と赤い組紐)がそろっているかを、筆者が目で見て確かめました。
| 条件 | 特徴がそろった枚数 |
|---|---|
| LoRAあり | 5枚中5枚 |
| LoRAなし | 5枚中0枚 |
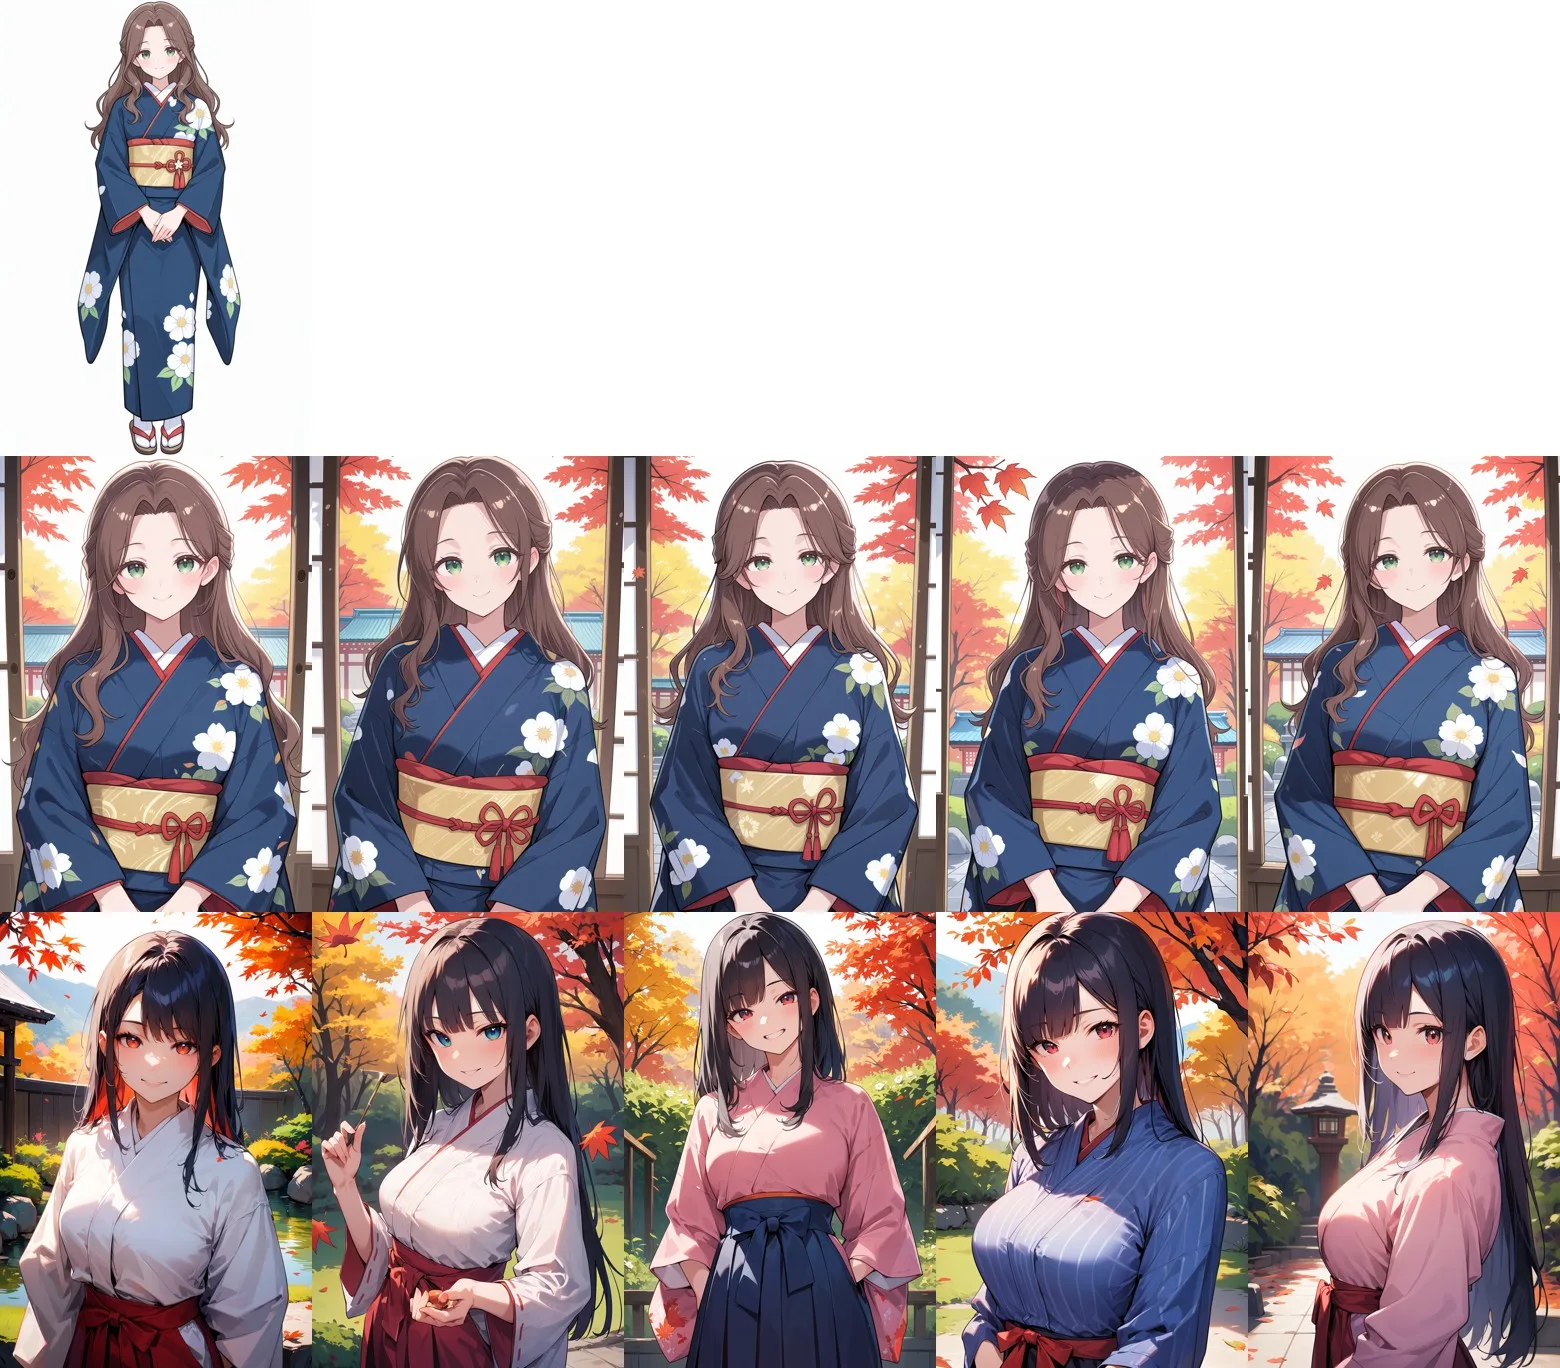
LoRAなしでは、髪が黒く、服もばらばらでした。LoRAを使うと、5枚ともキャラクターの特徴が出ています。
気になった点もあります。LoRAありの5枚は、構図がほぼ同じでした(正面、胸から上、両手を前で重ねる、紅葉が窓枠や柱越しに見える)。以前の記事でAnima-LoRA-Factoryを使ったときは、葉を持つ、体の向きが違うなど、5枚の姿勢に変化がありました。原因は確かめていません。
Anima-LoRA-Factoryとの違い
以前の記事では、同じ60枚・1200ステップ・Anima Base(2B)で、Anima-LoRA-Factoryを使って学習しました。そのときは約1,268秒、VRAMの最大は約8.6GBでした。
ZenTrainerのほうが学習時間は短くなりましたが、rankや学習率などの設定も、VRAMの測り方も違います。どちらが速いかを比べる結果ではありません。
低VRAM向けの比較:LoRAlab-TrainerStudio
VRAMが少ないGPUでLoRA学習をしたい人向けに、別の学習ツールも紹介します。
LoRAlab-TrainerStudio は、家庭用のNVIDIAのGPUで、VRAM 8GBからLoRAを学習できるとうたうツールです(作者の説明、自己申告)。
- モデルを4ビット(NF4)で読み込んで、VRAMの使用量を抑えている
- 対応モデルは、画像が Anima、MOSS-Image、SDXL(Pony・Illustrious・NoobAI など)、Z-Image、FLUX.2 Klein 9B、Qwen-Image 2.1、Krea 2、動画が LTX-2.3、MiniMax-H3(README の表、2026年11月1日に確認)
- 必要なVRAMの目安は、Anima が4GB(NF4)/6GB(BF16)、MOSS-Image が6GB(512²)/8GB、SDXL が4GB(NF4)/12GB(BF16)、Z-Image・Qwen-Image 2.1・Krea 2・MiniMax-H3 が8GB、FLUX.2 Klein 9B・LTX-2.3 が12GBから(MiniMax-H3はブロックスワップを使う)
- Windows 10/11 または64ビットの Linux。NVIDIA は RTX 20シリーズ/GTX 16シリーズ以降、ドライバ580以降が必要。AMD(RX 7000/9000、Ryzen AI Max)は試験的な対応(2026年11月1日に確認)
- コードのライセンスはMIT。モデルはそれぞれのライセンスに従う(Qwen-Image 2.1は非商用)
用語メモ:ブロックスワップ=モデルの一部を、使うときだけGPUに載せて、それ以外はメインメモリに置いておく方法。VRAMは減りますが、そのぶん時間がかかります。
作者の説明では、MiniMax-H3の学習はVRAM 16GBで約37分、8GBでは約80分かかったとされています(RTX 5080 16GBなどでの作者の測定。自己申告で、筆者は未検証)。
ZenTrainerと同じく、Anima にも対応しています。READMEでは、Anima は NF4 で4GBから、BF16 で6GBからとされています(作者の説明、自己申告)。筆者は試していません(未検証)。
補足:ZenTrainerが対応するMOSS-Imageはどんなモデルか
ZenTrainerが対応しているMOSS-Imageは、10月16日にオープンウェイトで公開された、50億パラメータの画像生成モデルです。ライセンスはApache 2.0で、ASCII.jpの試用記事では、日本語の文字を描く力が高いと紹介されています。
よくある質問(FAQ)
Q. ZenTrainerは、VRAMが何GBあれば使えますか?
公式の説明には、必要なVRAMの数値は書かれていません。筆者のRTX 5090では、AnimaのLoRA学習でGPUのメモリを最大で約24GB使いました(ComfyUIのキャッシュを含む)。
Q. 普段のComfyUIに入れても大丈夫ですか?
カスタムノードとして入れられます。普段の環境と分けたいなら、専用のComfyUIごと入れる方法が用意されています。
Q. 学習用の写真は何枚くらい必要ですか?
公式のQuick startでは、15〜40枚とされています。筆者は60枚で学習しました。
まとめ
- ZenTrainer 0.4.0は、ComfyUIの中でLoRAを学習できるツール。AnimaやMOSS-Imageなど10種類のモデルに対応。導入は ComfyUI Manager から。本家は Nynxz/ZenTrainer で、exeを配る同名のリポジトリは使わない
- 筆者のRTX 5090では、AnimaのLoRA(60枚・1200ステップ)が約10分で学習でき、5枚中5枚でキャラの特徴が出た。5枚の構図がほぼ同じになった点は、今後の検証課題
- Anima にも対応し、4GB(NF4)から学習できるとうたう LoRAlab-TrainerStudio もある
関連記事
- Animaの使い方【2026年版】導入方法とおすすめ設定をTurbo・サンプラー・CFGで比較
- ComfyUIでLoRAを使う方法【2026年版】入れ方・強さ・商用利用の注意
- ComfyUIのアップデート方法|ポータブル版の更新手順とカスタムノードの注意点
検証メモ
- 学習の速度:表の約2.0 it/s は、1200ステップを学習時間の602秒で割った平均です。ZenTrainer のログに出る it/s の値は2.26〜2.35でした。2つの値が違う理由は確認していません。
- 確かめた画像:LoRAありとなしで5枚ずつ、832×1216・30ステップ・CFG 4で作り、1枚は約6.6秒でした(最初の1枚を除く)。特徴の判定は筆者の目視です。構図が似た理由として、学習画像の多くが正面の立ち絵であることが考えられますが、確かめていません。
- 導入前の確認:起動前にコードを読みました。ネットへの接続は、Hugging Face からのモデル取得と、画面用のファイルを git で取る処理でした。
参考リンク
- ZenTrainer(GitHub):https://github.com/Nynxz/ZenTrainer
- ZenTrainer 0.4.0 リリースノート:https://github.com/Nynxz/ZenTrainer/releases/tag/v0.4.0
- 不可思議ちゃん氏の投稿(X、ZenTrainer 0.4.0の紹介):https://x.com/UNfukashigi/status/2116347195641504169
- LoRAlab-TrainerStudio(GitHub):https://github.com/AcademiaSD/AcademiaSD_LoRAlab-TrainerStudio
- ASCII.jp「無料の画像生成AI『Moss-Image』がすごい 日本語も漫画も生成、商用利用OKの実力を試した」:https://ascii.jp/elem/000/004/445/4445534/