FLUX.2 [dev] は、Black Forest Labs(BFL)が公開している画像生成モデルです。最大 4MP(約400万画素)の画像を作れて、参照画像を最大10枚まで使えます(Comfy 公式の説明)。
そのぶんモデルが大きく、本体だけで 35GB 前後あります。この記事では、RTX 5090(VRAM 32GB)と RAM 128GB の PC で、ComfyUI 公式の fp8 版と、BFL 公式の NVFP4 版を動かし、時間・VRAM・RAM を測りました。
試した環境
| 項目 | 内容 |
|---|---|
| GPU | NVIDIA GeForce RTX 5090(VRAM 32GB) |
| CPU / メモリ | AMD Ryzen 9 9950X3D / 128GB |
| OS | Windows 11 |
| ドライバ | NVIDIA 621.01 |
| ComfyUI | master(コミット b5a43215、2026-10-30)ポータブル版。カスタムノードなし(GGUF の測定だけ ComfyUI-GGUF を追加) |
| PyTorch | 2.14.0+cu130 |
| 確認した日 | 2026年10月31日(GGUF は 11月1日) |
必要なファイルと置き場所
| ファイル | 置き場所(ComfyUI/models/) | サイズ |
|---|---|---|
| flux2_dev_fp8mixed.safetensors(Comfy-Org) | diffusion_models | 35.46GB |
| flux2-dev-nvfp4-mixed.safetensors(BFL 公式) | diffusion_models | 22.77GB |
| mistral_3_small_flux2_fp8.safetensors | text_encoders | 18.03GB |
| mistral_3_small_flux2_bf16.safetensors(今回は使っていない) | text_encoders | 35.58GB |
| mistral_3_small_flux2_fp4_mixed.safetensors(今回は使っていない) | text_encoders | 12.28GB |
| flux2-vae.safetensors | vae | 0.34GB |
本体は fp8 版か NVFP4 版のどちらか1つでかまいません。テキストエンコーダー(指示の文章を読む部分、Mistral 3 Small)も大きいので、今回は fp8 版を使いました。
NVFP4 は、RTX 50 シリーズなどの新しい GPU で速く計算できる4ビットの形式です。詳しくは ComfyUI の NVFP4 は速い? で比べています。
使い方
ComfyUI のテンプレート一覧にある「Flux.2 Dev」(image_flux2)は、参照画像を使って画像を直すワークフローです。今回は参照画像を使わず、テキストだけから作る形にしました。設定はテンプレートと同じです。
| 項目 | 設定 |
|---|---|
| ステップ | 20(Flux2Scheduler) |
| サンプラー | euler |
| ガイダンス | 4.0(FluxGuidance) |
| CFG | 使わない(BasicGuider) |
| 解像度 | 1024×1024(ほかに 1408×1408 も) |
テンプレートには、ステップを 8 に減らせる「Turbo LoRA」の切り替えも入っていますが、今回は使っていません。
- FLUX.2 [dev] テキストから画像(API 形式 .json)今回使った形。ComfyUI の画面にドラッグすると読み込める
- Flux.2 Dev 公式テンプレート(.json)参照画像で直す形
RTX 5090 での時間・VRAM・RAM(実測)
机の上の PC と「KOBO Lab」と書かれたマグカップの写真風の指示で、シードを変えて測りました。時間は ComfyUI に送ってから画像が保存されるまでです。
| 本体 | 解像度 | 1枚目(読み込み込み) | 2枚目以降 | VRAM 最大(GPU 全体) | ComfyUI の RAM |
|---|---|---|---|---|---|
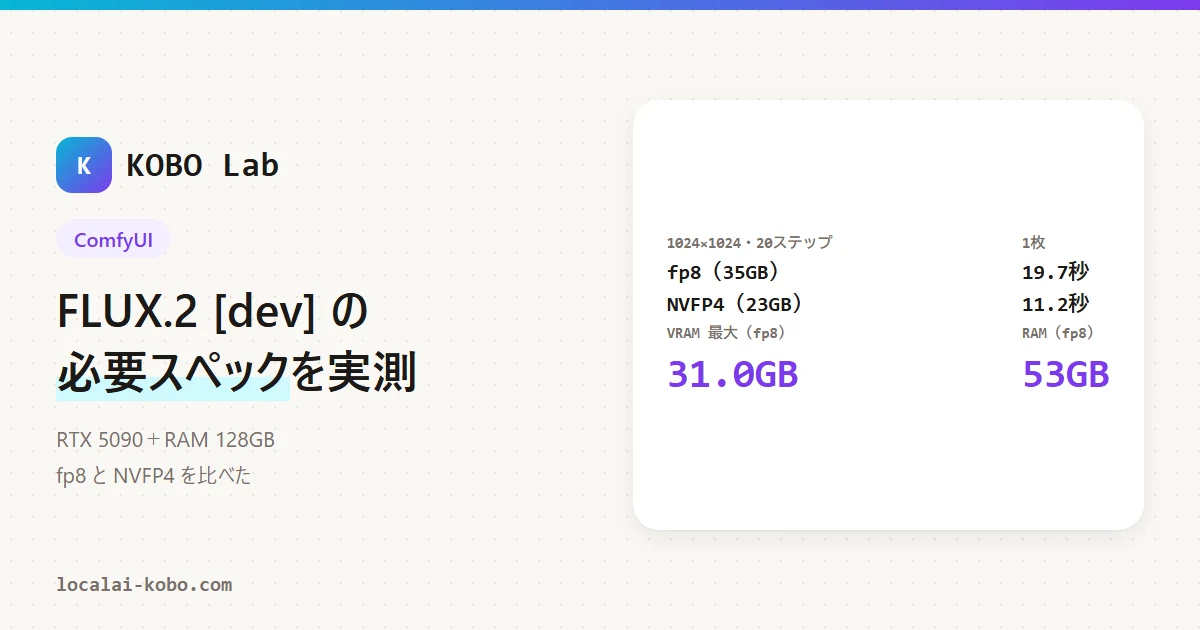
| fp8(Comfy-Org) | 1024×1024 | 521秒 | 19.7秒 | 31.0GB | 53GB |
| NVFP4(BFL) | 1024×1024 | 242秒 | 11.2秒 | 23.7GB | 44GB |
| fp8(Comfy-Org) | 1408×1408(約2MP) | — | 66秒 | 31.2GB | 53GB |
VRAM 最大は2枚目以降の回の値です。1枚目はこれより高く出ることがあり、NVFP4 は約26.1GB、Q4_K_M は約28.4GB でした。
1枚目は、ディスクからモデル(本体+テキストエンコーダーで 約40〜54GB)を読み込むので時間がかかります。NVFP4 の1枚目は、fp8 のあとに本体だけを読み替えた時間です。
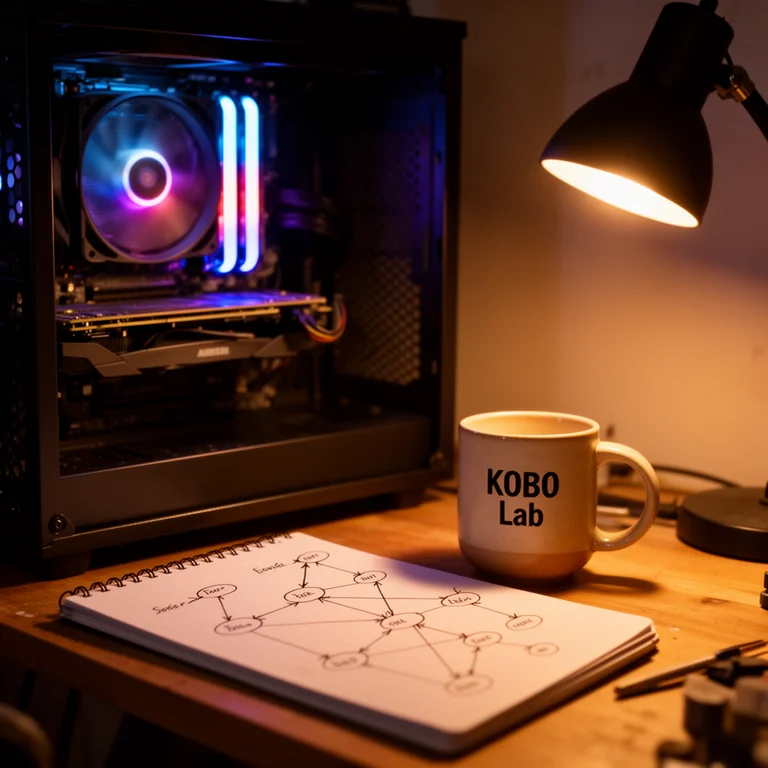
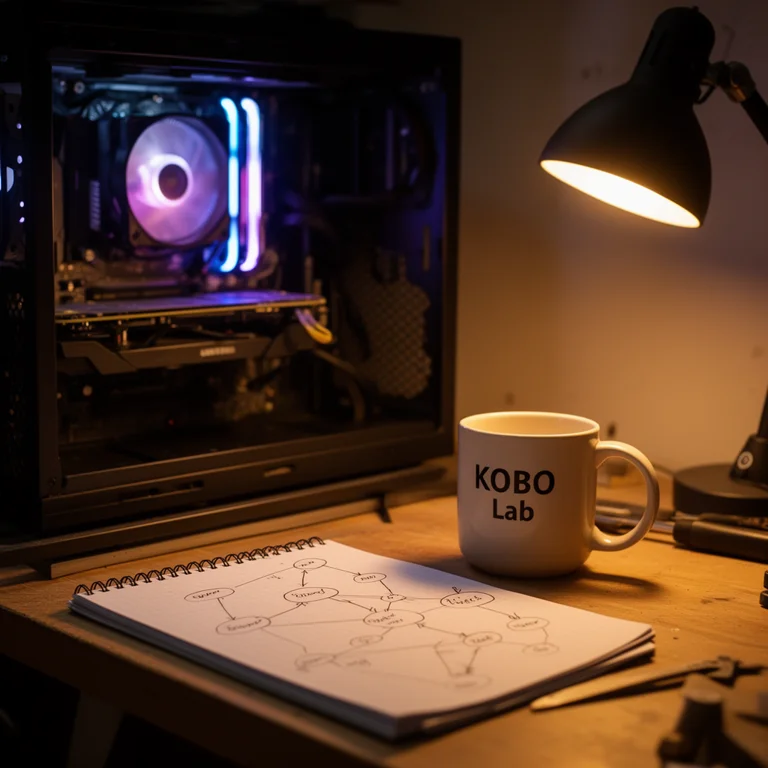
同じシードなので構図はほぼ同じで、NVFP4 のほうが全体に少し暗く、細部が変わりました。今回の1組では、どちらも「KOBO Lab」の文字がマグカップに描かれています。画質の優劣は、1組の比較では言えません。
RTX 5090 以外の人へ(VRAM が少ない環境を想定した簡易テスト)
ComfyUI の --reserve-vram で VRAM の一部を使わずに残し、使える VRAM が少ない環境を想定して試しました。
| 本体 | 想定 | 結果 | 2枚目の時間 | VRAM 最大(GPU 全体) | ComfyUI の RAM |
|---|---|---|---|---|---|
| fp8 | 16GB 相当(--reserve-vram 16) | 生成できた | 22.1秒 | 17.2GB | 53GB |
| fp8 | 12GB 相当(--reserve-vram 20) | 生成できた | 23.0秒 | 13.3GB | 53GB |
| NVFP4 | 16GB 相当(--reserve-vram 16) | 生成できた | 12.3秒 | 17.3GB | 45GB |
| NVFP4 | 12GB 相当(--reserve-vram 20) | 生成できた | 13.1秒 | 13.5GB | 45GB |
VRAM を絞っても、入りきらないぶんを RAM に置いて動きます。そのぶん RAM は多めに必要です。RAM が少ない PC での動作は試していません。
GGUF 版は fp8・NVFP4 より遅かった
FLUX.2 [dev] には、ファイルを小さくした GGUF 版も配られています(city96/FLUX.2-dev-gguf、第三者による変換)。ComfyUI で GGUF を読むには、カスタムノード「ComfyUI-GGUF」が必要です。2026年11月1日に、このノード(コミット 6ea2651)を入れて、本体の読み込みを「Unet Loader (GGUF)」に替え、ほかは同じ条件で測りました。
| 本体 | サイズ | 1枚目(読み込み込み) | 2枚目以降 | VRAM 最大(GPU 全体) | ComfyUI の RAM |
|---|---|---|---|---|---|
| flux2-dev-Q4_K_M.gguf | 20.08GB | 384秒 | 37.5秒 | 28.0GB | 20GB |
| flux2-dev-Q8_0.gguf | 35.00GB | 320秒 | 43.2秒 | 30.9GB | 10GB |
| (比較)fp8mixed | 35.46GB | 521秒 | 19.7秒 | 31.0GB | 53GB |
| (比較)NVFP4 mixed | 22.77GB | 242秒 | 11.2秒 | 23.7GB | 44GB |
ComfyUI の RAM は2枚目以降の値です。1枚目の時間の読み方は、末尾の検証メモに書きました。
今回の RTX 5090 では、GGUF は fp8 や NVFP4 より遅くなりました。GGUF は計算のたびに重みを元の形に戻すぶん、時間がかかると考えています(筆者の見立て)。
そのかわり、ComfyUI が使う RAM は少なめでした。ファイルを小さくしたいときや RAM が少ない PC では選ぶ意味があります。RTX 50 シリーズで速さを求めるなら、NVFP4 から試すのがおすすめです。
--reserve-vram 20(12GB 相当を想定した簡易テスト、実際の 12GB GPU での動作を保証するものではありません)でも Q4_K_M は生成でき、2枚目は 55秒、VRAM は最大 12.6GB(GPU 全体)でした。
モデルは非商用ライセンス、生成した画像は別の扱い
FLUX.2 [dev] の公式ページでは、ライセンスの名前が「FLUX Non-Commercial License」(非商用ライセンス)となっていて、ダウンロードには利用条件への同意(ゲート)が必要です。今回使った NVFP4 版と Comfy-Org の配布ページも、非商用のライセンスを指しています(Hugging Face の表示、2026年10月31日時点)。
Hugging Face 上の本文は、同意しないと読めません。ただし、BFL の GitHub に、ライセンス文が公開されています(black-forest-labs/flux2 の model_licenses、2026年11月1日に確認)。
- LICENSE-FLUX-DEV「FLUX [dev] Non-Commercial License v2.0」(対象に FLUX.2 [dev] が名前で挙がっています)
- LICENSE-FLUX-NON-COMMERICAL「FLUX Non-Commercial License v2.1」
Hugging Face で配られているモデルに、どちらの版が当てはまるかは確かめていません(未確認)。
2つに共通して、次のことが書かれています(原文は英語。筆者の訳です)。
- 非商用の目的とは、金銭を受け取らない範囲での、個人の研究・実験・テスト・趣味などです。収益を生む活動は、非商用の目的にあたりません。
- 生成した画像(Outputs)について、BFL は所有権を主張しません。禁止されたものを除いて、商用を含むどんな目的にも使えます。ただし、競合するモデルの学習や蒸留には使えません。
- 違法・権利侵害のコンテンツを防ぐ対策と、法律で必要な範囲のAI生成の表示が、条件です。
この記事は法律の助言ではありません。仕事で使う前に、必ず原文(公式のページ、GitHub のライセンス文)を読んでください。
よくある質問(FAQ)
Q. FLUX.2 [dev] に必要な VRAM はどれくらいですか?
RTX 5090(32GB)では、fp8 版で GPU 全体の VRAM が最大 約31.0GBになり、足りないぶんは RAM に置いて動きました。VRAM が少ない環境を想定した簡易テストの結果は本文の表を見てください(実際の GPU での動作を保証するものではありません)。
Q. RAM はどれくらい必要ですか?
今回は ComfyUI が RAM を約53GB使いました。ほかのアプリも動かすなら 64GB 以上が安心です(筆者の見立て)。
Q. fp8 と NVFP4 はどちらがいいですか?
今回の条件では、時間は fp8 が約19.7秒、NVFP4 が約11.2秒でした。ファイルは NVFP4 のほうが小さく(22.77GB)、RTX 50 シリーズなら NVFP4 から試すのがおすすめです(筆者の見立て)。
Q. FLUX.2 [dev] は商用利用できますか?
公式ページでは、モデルのライセンスは「FLUX Non-Commercial License」(非商用)とされています。細かい条件は、上のライセンスの節にある GitHub の原文と、公式ページの原文を確認してください。
Q. GGUF 版は使えますか?
カスタムノード ComfyUI-GGUF を入れると使えました。RTX 5090 では Q4_K_M が約37.5秒、Q8_0 が約43.2秒で、fp8・NVFP4 より遅い結果でした。
Q. ストレージはどれくらい必要ですか?
fp8 一式で約54GB、NVFP4 も入れるとさらに約23GB です。SSD に置くと読み込みが速くなります。
まとめ
FLUX.2 [dev] は、RTX 5090 と RAM 128GB の PC で、1024×1024 が fp8 版で約19.7秒、NVFP4 版で約11.2秒でした(今回のテスト条件で)。VRAM 32GB でも入りきらず RAM を使うモデルなので、試すなら VRAM と RAM の両方に余裕のある PC が向いています。
検証メモ
- GGUF の最初の測定:1回目は ComfyUI に接続できず(接続拒否)、8条件すべて失敗しました。本文の表は、そのあと測り直した値です。接続できなかった原因は記録していません。
- GGUF の1枚目:Q4_K_M の384秒は起動直後の測定で、Q8_0 の320秒はその直後の測定です(テキストエンコーダーなどが読み込まれた状態)。ファイルの大きさの順にならなかったのは、この測定順のためと考えていますが、同じ条件で測り直してはいません。
- GGUF の RAM:2枚目以降の ComfyUI の RAM は Q4_K_M が約20GB、Q8_0 が約10GB でした。1枚目は Q4_K_M が37.3GB、Q8_0 が41.4GB です。2枚目以降の大小関係の理由は未確認です。