この記事について(広告・アフィリエイトリンクはありません)
アダプターもノードもモデルも、すべて無料で入手できます。試した環境の一覧は検証の記録にあります。
MOSS-Image-IDM-2-Steps は、MOSS-Image を2回の計算・CFG なしで動かす LoRA(アダプター)です。RTX 5090 で、1024×1024 の画像が1枚約1.25秒でできました。ふつうの50ステップ(CFG 3)は約30秒なので、約24倍の速さです。
写真もアニメ調も、2ステップとは思えない仕上がりでした。ただし看板の文字は、「KOBO LAB」の LAB が縦に回ってしまうなど、配置が崩れることがありました。所要時間は20分ほど(アダプター 1.2GB のダウンロードを除く)、難しさは中級です。
先に結論(今回のテスト条件で)
| 方法 | 1枚の時間(1024×1024) | 見た目 |
|---|---|---|
| IDM 2ステップ(CFG なし) | 約1.25秒 | 写真・アニメ調とも整っている。看板の文字の配置が崩れることがある |
| ふつうの MOSS-Image SFT(50ステップ、CFG 3) | 約30秒 | 文字の配置も正しい |
MOSS-Image SFT bf16、テキストエンコーダー qwen3.5_9b int8、シード42、プロンプト3つ。時間はモデルを読み込んだあとの回です(最初の1枚は読み込み込みで203秒)。ふつうの50ステップは KSampler(euler、simple)で組んだもので、作者の教師モデルの設定と同じとは限りません。
MOSS-Image-IDM-2-Steps とは?
akhaliq/MOSS-Image-IDM-2-Steps は、MOSS-Image の SFT 版(50ステップ・CFG 3、つまり100回の計算)を、IDM という方法で2回の計算にまとめた LoRA です(Apache-2.0)。8ステップ、4ステップの先行例に続く、2ステップ版です。
作者は、文字から画像にはv1(runs/idm/export/000750)を勧めています。編集用に続けて学習したv2は、文字から画像の質が下がったと明記されています。髪の色や表情などの編集は2ステップでもできるが、スケッチから写真のような構造の変換はできない、とも書かれています。
導入
ComfyUI では、darask0 の4ステップ版のリポジトリに入っている「rapid-moss」のノードを使います。LoRA をモデルに混ぜずに fp32 のまま当てるためで、標準の LoRA ローダーで混ぜると効き方が弱くなる、と作者は説明しています。
custom_nodes/rapid-moss:darask0/MOSS-Image_4-step_adapter_lora の comfyui/rapid-moss フォルダー(__init__.py、nodes.py、例のワークフロー)models/rapid_moss/akhaliq-idm-2step:runs/idm/export/000750 の lora.safetensors(1.2GB)、time_embedding.safetensors、dataspace.safetensorsmodels/diffusion_models:moss_image_sft_bf16.safetensors(作者は bf16 を指定、量子化版は未検証)- テキストエンコーダー(qwen3.5_9b)と flux2-vae は、ふつうの MOSS-Image と同じ
ワークフローは rapid-moss の例「rapid-moss-4step-native」を開き、MOSS-Image Few-Step Adapter のノードで adapter を akhaliq-idm-2step、steps を 2 にします。2ステップ用のシグマの並びは dataspace.safetensors から自動で読まれます。追加のパッケージは要りませんでした。
2ステップと50ステップを比べる
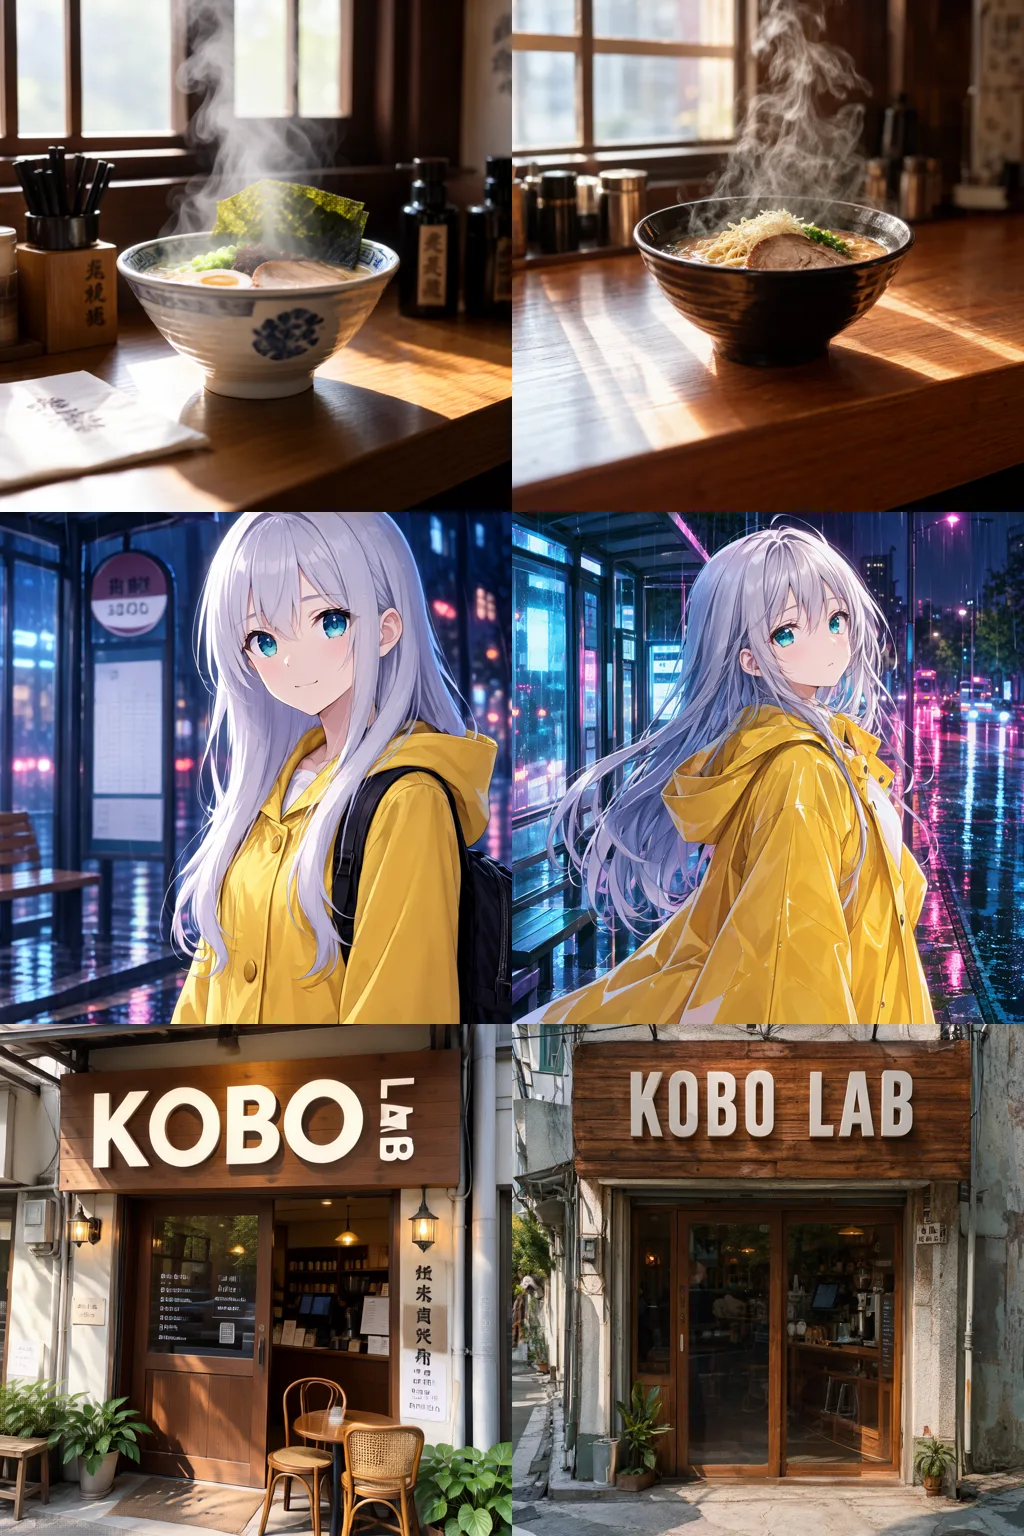
ラーメンとアニメ調の少女は、2ステップでも湯気や雨の反射、髪の細かさまで描けていて、50ステップと比べても見劣りしません。構図や色は変わりますが、どちらが上とは言いにくい出来でした。
一方、看板に「KOBO LAB」と書かせると、2ステップでは KOBO は正しく大きく出たものの、LAB が横倒しの縦書きになりました。50ステップでは1行にきれいに並びました。文字の配置のように細かい指示は、ステップ数を減らすと崩れやすいようです。
商用で使える?
IDM の LoRA と rapid-moss のノードは Apache-2.0 です。もとの MOSS-Image の扱いは、MOSS-Image の記事を見てください。
よくある質問(FAQ)
Q. MOSS-Image-IDM-2-Steps とは?
MOSS-Image を2回の計算・CFG なしで動かす LoRA です。ComfyUI では rapid-moss のノードで読み込みます。
Q. どれくらい速い?
RTX 5090 で 1024×1024 が約1.25秒でした。ふつうの50ステップ(CFG 3)は約30秒でした。
Q. 画質は落ちる?
写真やアニメ調は2ステップでも整っていました。看板の文字の配置は崩れることがありました。
まとめ
MOSS-Image-IDM-2-Steps は、1秒ちょっとで実用的な画像が出る、とても速いアダプターでした。文字の入った1枚だけは、50ステップで仕上げるのが安全です。
rapid-moss で akhaliq-idm-2step・2ステップ。文字が大事な絵は50ステップで。
検証メモ
- 時間:ComfyUI の execution_start から execution_success まで。3つのプロンプトとも同じくらいでした(2ステップ 1.24〜1.29秒、50ステップ 29.0〜30.0秒)。
- 試していないこと:v2(編集用)、属性の編集、darask0 の4ステップ版との比較、int8 のベース、日本語の文字。