この記事について(広告・アフィリエイトリンクはありません)
使ったソフトとモデルは、すべて無料で入手できます。試した環境の一覧は検証の記録にあります。
ComfyUI-H3-FaceRefine は、MiniMax H3 の動画で小さく写った顔を、フレームごとに追いかけて切り出し、大きくして作り直してから元の動画に戻すノードです。 顔の高さが約26ピクセルの全身の動画(896×512、5秒)で、崩れていた口元が整った顔になりました。RTX 5090 で1本約28秒でした(モデルを読み込んだあと)。
強さ(denoise)は0.4〜0.6がちょうどよく、0.8では髪の輪郭が変わって貼り合わせの境目が見えました。所要時間は1時間ほど、難しさは中級〜上級です。
先に結論(今回のテスト条件で)
| denoise | 時間 | 切り出した顔(512×512) | 元の動画に戻したあと |
|---|---|---|---|
| 0.25 | 18.6秒 | モザイクのような粗さが残る | —(比べていない) |
| 0.4(作者の既定値) | 約28秒 | ブロック状の粗さが残る | 縮めると粗さは見えず、顔は整う |
| 0.6 | 約28秒 | なめらかで細かい | 顔が整い、境目も目立たない |
| 0.8 | 26.9秒 | 背景や服まで別物になる | 髪の輪郭が変わり、境目が見える |
MiniMax H3 fl2va(int8)+ Turbo 8step LoRA、8ステップ、er_sde。時間は ComfyUI の実行開始から完了までです。1回目はモデルの読み込みを含めて138秒でした。GPU のメモリは、どの条件もほぼいっぱい(約31GB)まで使われました。
H3-FaceRefine とは?
Carasibana/ComfyUI-H3-FaceRefine は、静止画で顔を直す FaceDetailer の考え方を、H3 の動画に持ち込んだノード集です(MIT ライセンス)。2026年11月7日時点でスターは569、今回は v1.1.2 を使いました。
作者の説明では、H3 は顔が画面の小さな一部のときに崩れやすく、これは解像度を上げても変わりません。そこで顔のまわりを切り出して、顔が画面いっぱいの状態で H3 に作り直させます。
- H3 Face Track + Crop:顔を検出して追跡し、フレームごとに切り出す
- H3 Inject Video Latent:切り出した動画を、H3 の作り直しの出発点にする(H3 の標準ノードにはこの経路がない)
- H3 Per-Frame Denoise:顔が小さいフレームほど強く作り直す
- H3 Face Stitch Back:作り直した顔を、元の動画に戻す
試した動画
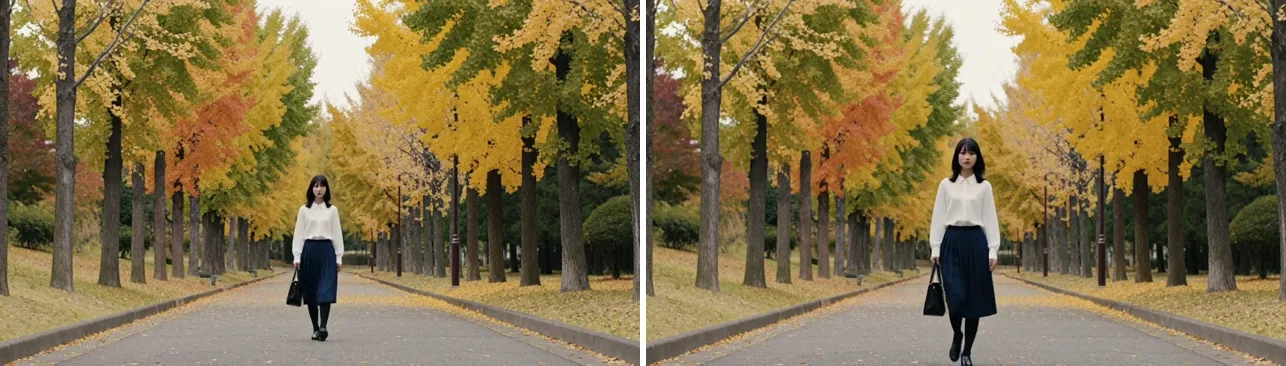
Pika H3 Flex で、イチョウ並木を歩いてくる女性の全身を、引きの画で作りました。顔の高さは21〜32ピクセル(平均26ピクセル)で、口元が崩れたフレームがあります。
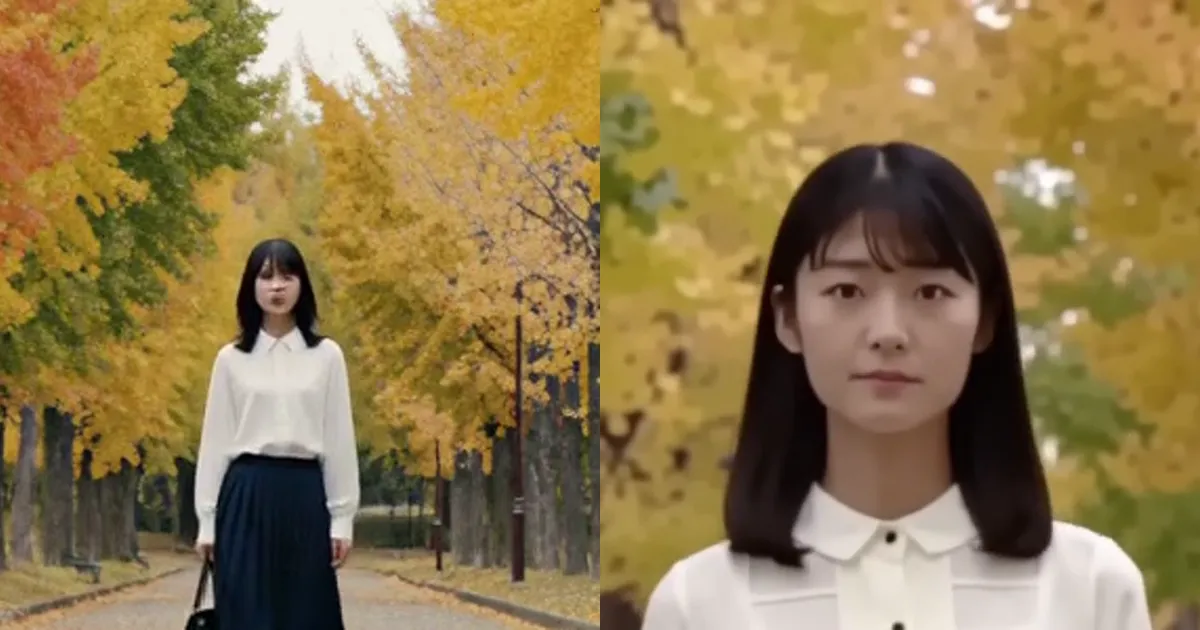
Face Track + Crop は、124フレームすべてで顔を見つけ、平均6.7倍に拡大して 512×512 で切り出しました。追跡のぶれは、平滑化で 0.65 から 0.32 ピクセル/フレームに減ったと報告されました。
denoise で比べる
切り出した顔の動画(真ん中のフレーム)を並べました。左から、切り出しただけの入力、0.4、0.6、0.8 です。
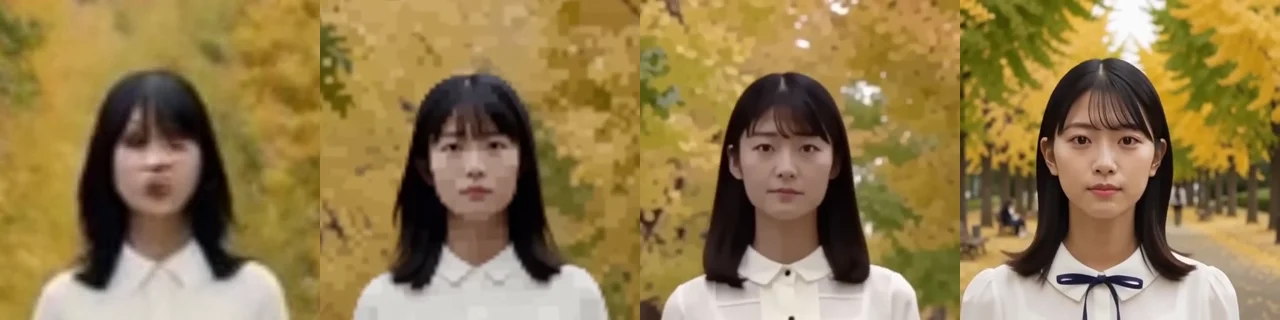
0.4 以下では、拡大した入力のぼやけが、ブロック状の粗さとして残りました。0.6 で細かい顔になり、0.8 では襟にリボンが付き、背景の並木も作り直されました。
元の動画に戻したあとの顔のまわりを、2倍に拡大して並べました。左から元の動画、0.4、0.6、0.8 です。
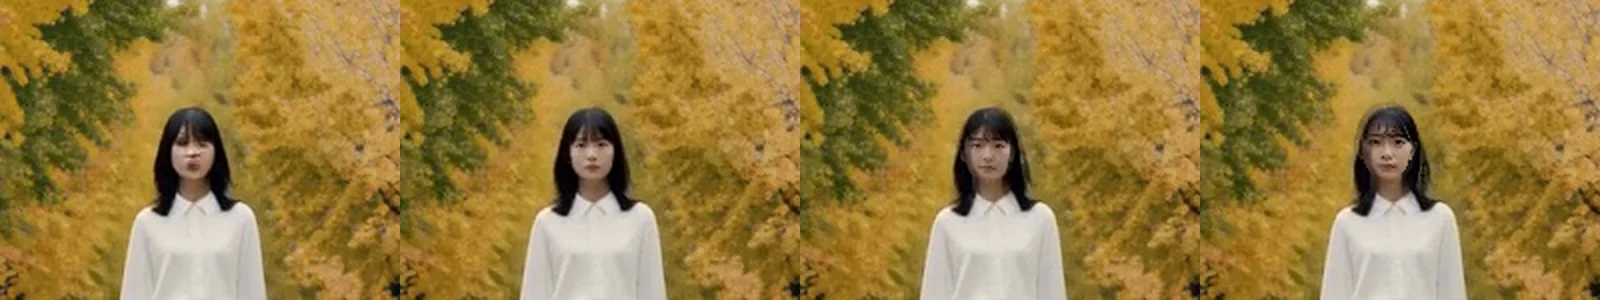
元のサイズに縮めて戻すので、0.4 の粗さはほとんど見えなくなりました。0.8 は顔が別人寄りになり、貼った範囲の境目で髪の線がずれました。別のシードの動画(顔の高さ平均31ピクセル)でも、0.4 は粗く、0.6 はなめらかという同じ傾向でした。
導入
cd ComfyUI\custom_nodes
git clone https://github.com/Carasibana/ComfyUI-H3-FaceRefine
..\..\python_embeded\python.exe -m pip install ultralytics scipy "scenedetect>=0.7"
requirements.txt には insightface もありますが、同じ人物かどうかの判定(identity_track)を使わなければ要りません。今回は1人だけの動画なので、オフにして試しました。
顔の検出には face_yolov8m.pt(52MB)を models/ultralytics/bbox に入れます。H3 のモデルは導入編と同じです。
作者の例のワークフローは、VideoHelperSuite、Impact Pack(SAM のマスク、初期は無効)、GGUF のローダー、音声を固定するノード(NativeAudioLock)も使っています。今回は ComfyUI 標準の LoadVideo と SaveVideo に置き換え、話していない動画なので音声の固定は外しました。
- H3-FaceRefine のワークフロー(JSON)ComfyUI 標準の動画ノードで組み直したものです。denoise 0.6、音声の固定なし
商用で使える?
ノードのコードは MIT ライセンスです。顔の検出モデル face_yolov8m.pt は Apache-2.0 と表示されていますが、読み込みに使う ultralytics ライブラリは AGPL-3.0 です。作った動画の扱いは MiniMax H3 本体の規約に従います(導入編で説明しています)。
同じ人物の判定に insightface を使う場合、その顔認識モデルは非商用の条件が付くことがあるので、配布元の条件を確かめてください。
RTX 5090 以外の人へ
作り直すのは 512×512 の顔の動画なので、全体を作り直すより軽い処理です。ただし H3 本体(int8 で19.5GB)とテキストエンコーダーを読み込むため、VRAM の少ない PC ではメインメモリに置く分だけ時間が延びます(今回は測っていません)。
よくある質問(FAQ)
Q. H3-FaceRefine とは?
MiniMax H3 の動画で小さく写った顔を、フレームごとに切り出して作り直し、元の動画に戻す ComfyUI のノードです。FaceDetailer の動画版にあたります。
Q. denoise はいくつにする?
今回は0.4〜0.6が適当でした。0.4 は切り出した顔が粗く見えますが、元の動画に戻すと目立ちません。0.8 では髪の輪郭が変わり、境目が見えました。
Q. insightface は必要?
同じ人物かどうかを判定する機能(identity_track)を使うときだけ必要です。1人だけの動画ならオフで動きました。
Q. 時間はどれくらい?
RTX 5090 で、896×512・5秒の動画が1本約28秒でした(モデルを読み込んだあと)。
まとめ
H3-FaceRefine は、全身を引きで撮った H3 の動画の、崩れた小さな顔を整えるのに効きました。denoise は強すぎると別人寄りになるので、0.5前後から試すのがよさそうです。
引きの画で顔が崩れたら、FaceRefine で顔だけ作り直す。denoise は0.5前後から。
検証メモ
- 元の動画:Pika H3 Flex の文字から動画のテンプレート、896×512、5秒、シード 11 と 23。
- 設定:作者の Auto Select の例に合わせ、crop_factor 3.0、canvas は auto_capped_768(今回は 512×512 になった)、per_frame、Per-Frame Denoise(小さい顔1.0倍、大きい顔0.35倍)、Stitch は face_only。プロンプトは元の動画のものを、顔のアップに書き換えて使いました。
- 試していないこと:話している動画での口の動き(NativeAudioLock)、複数人やカットのある動画での取り違え、SAM のマスク、アニメ調の動画、時間方向のちらつきの数値での測定。