この記事について(広告・アフィリエイトリンクはありません)
使ったソフトとモデルは、すべて無料で入手できます。試した環境の一覧は検証の記録にあります。
ComfyUI-MossPanelDataset を使うと、MOSS-Image で、コマ割りを見本の画像から選び、人物・場面・セリフを欄に入れるだけで漫画を作れます。 4コマを12枚作ったところ、コマの数と形はすべて指定どおりで、日本語のセリフも11枚は正しく描かれました。
1枚(1024×1536)は RTX 5090 で約11秒です。所要時間は30分ほど、難しさは初心者向けです。
先に結論(今回のテスト条件で)
| 見たところ | 結果(12枚) |
|---|---|
| コマの数と形 | 12枚ともコマ割りどおり(縦4段、2×2、斜め、大きな楕円+小コマ) |
| セリフの文字 | 「新しい原稿です!」「うーん……」「最高です!」「ほんとに?」「やった!」が11枚で正しく出た。1枚は4コマ目に「ほんとに?」が重なった |
| 読む順番 | 2×2 や小コマの並びでも、右から左の順にセリフが入った |
| 人物のそろい方 | 黒髪の女性と、明るい髪で眼鏡の男性が、どのコマでも見分けられた |
| 時間 | 1枚 約11秒(初回だけモデルの読み込みで 79秒) |
MossPanelDataset とは?
sepiablue-ai/ComfyUI-MossPanelDataset は、MOSS-Image で漫画を作るための ComfyUI のカスタムノードです。作者は日本の方で、ノードの表示も README も日本語に対応しています。
- 2〜6コマのコマ割り196種類を、見本の画像から選べる
- 人物(最大3人)の外見、各コマの場面・登場人物・セリフ(1コマ最大3つ)を欄に入れると、MOSS 用のプロンプトを組み立てる
- 1〜3人向けの構図の見本120種類を、コマごとに選べる
- 人物の画像から外見の英文を取り出す機能(MOSS のテキストエンコーダーを使い、追加のモデルは不要)
翻訳や追加の LLM は使わず、見本のデータも同梱なので、外部のサービスにはつながりません。2026年11月2日に公開され、11月7日時点でスターは39です。
コマ割りを選ぶ
「コマ割りを選ぶ」ノードの「画像からコマ割りを選ぶ」を押すと、見本の一覧が開きます。コマ数と種類(通常・直線・斜め・特殊)で絞り込み、お気に入りにも登録できます。
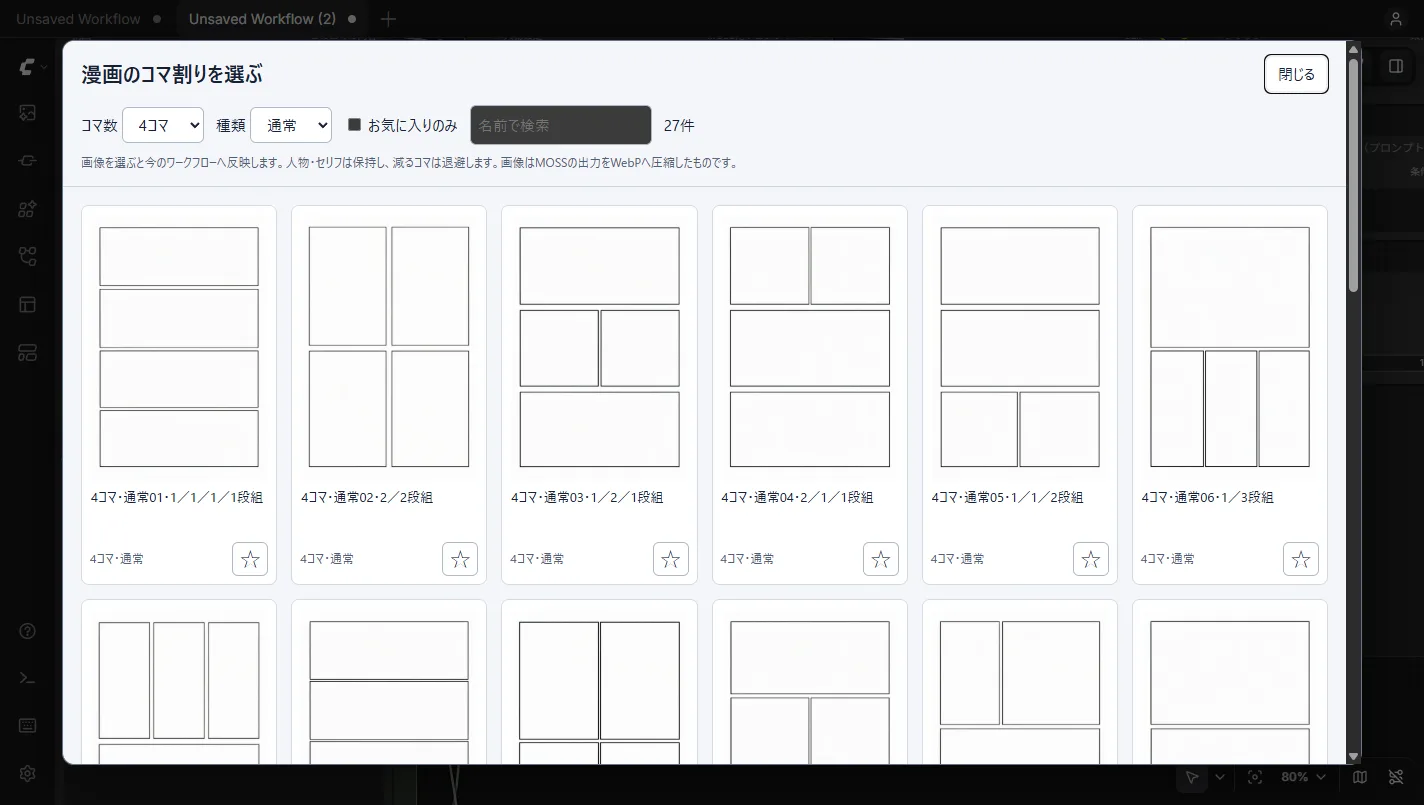
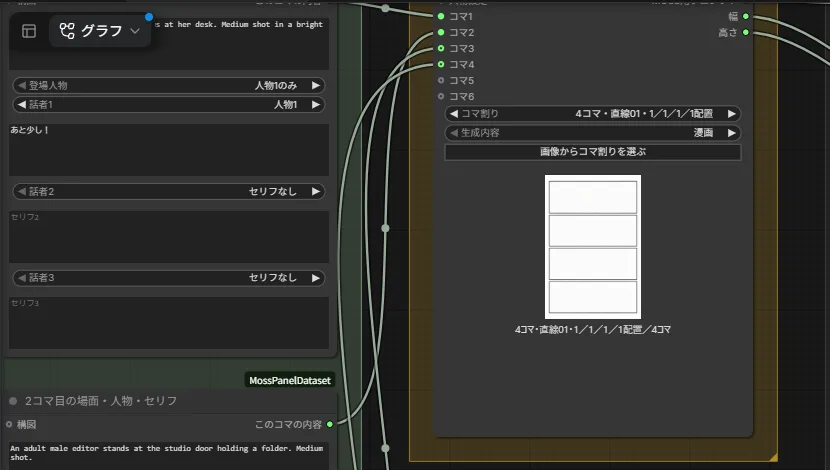
選ぶと、コマの数に合わせて「コマの内容」ノードと接続が自動で増減します。
RTX 5090 で試すとどうなる?
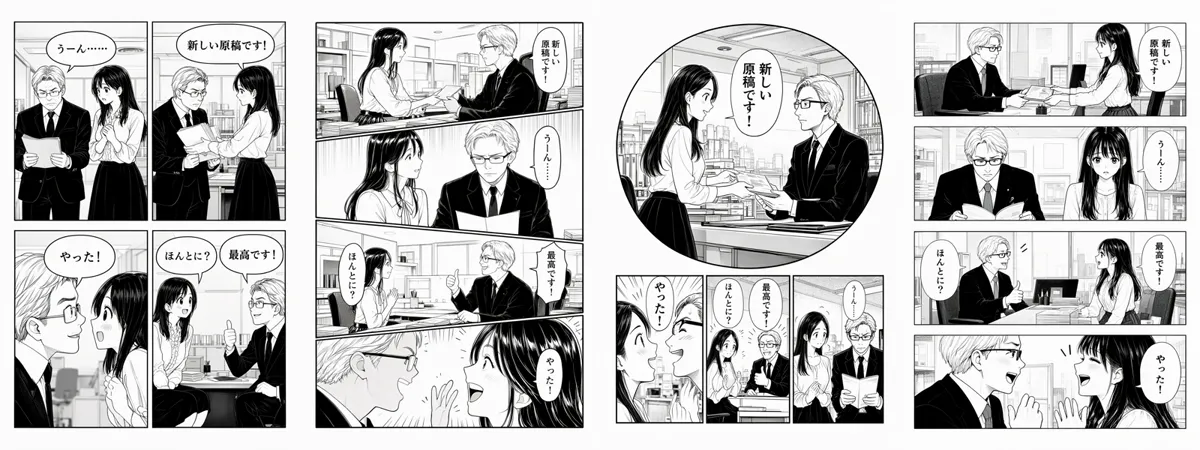
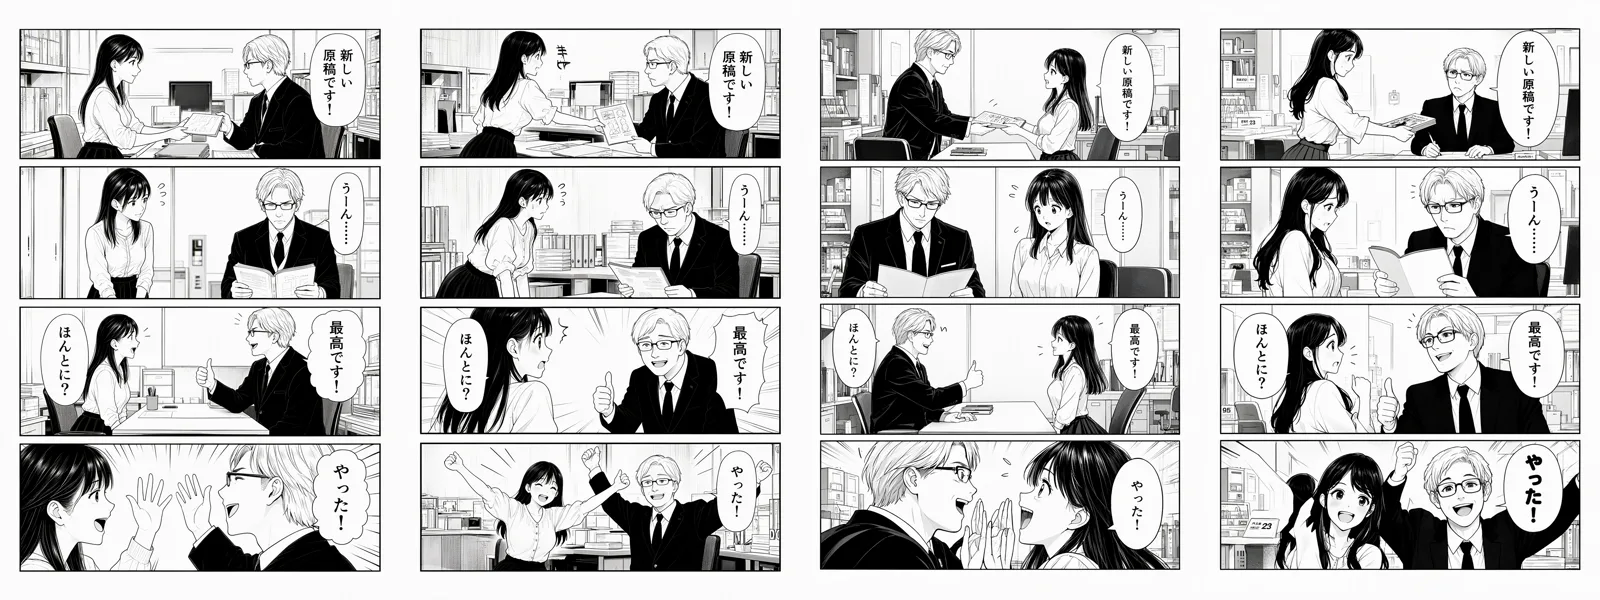
漫画家の女性が編集者に原稿を見せる4コマを作りました。場面は英語で、セリフは日本語で入れています。
| コマ | 場面(要約) | セリフ |
|---|---|---|
| 1 | 原稿を編集者に渡す | 人物1「新しい原稿です!」 |
| 2 | 編集者が難しい顔で読む | 人物2「うーん……」 |
| 3 | 編集者が笑って親指を立てる | 人物2「最高です!」、人物1「ほんとに?」 |
| 4 | 2人で手を上げて喜ぶ | 人物1「やった!」 |
縦4段のコマ割りで、構図の指定あり・なしをシード3つずつ、ほかのコマ割り3種類をシード2つずつ、計12枚作りました。
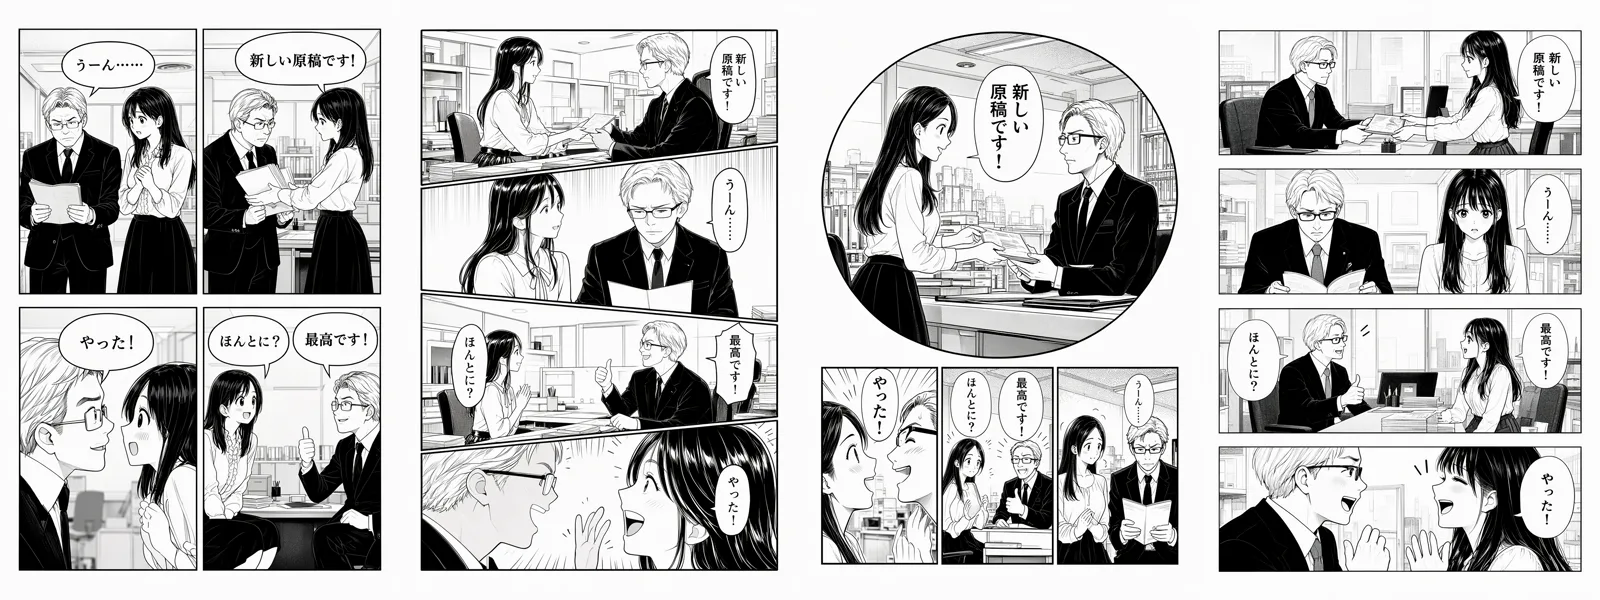
どのコマ割りでも、コマの数と形は見本どおりでした。2×2 では右上のコマから、楕円の下の小コマでは右から順にセリフが入っていて、日本の漫画の読む順番になっています。
セリフは、吹き出しの中に正しい日本語で描かれました。「……」や「!」「?」も崩れていません。ただ、2×2 のシード2では、4コマ目に3コマ目のセリフ「ほんとに?」がもう一度入りました。吹き出しが話している人物の近くに来ないコマもありました。
構図の指定は要る?
同梱の composition_duo の設定(正面の掛け合い、横並び、机越し、近距離の言い合い)で構図を指定した場合と、指定しない場合を比べました。
今回の4コマでは、どちらもコマの内容に合った絵になり、はっきりした差はありませんでした。構図ありのシード1では、4コマ目が2人の顔のアップになっていて、指定(近距離で言い合う)が効いています。人物の位置や距離をそろえたいときに使う、と考えるのがよさそうです。
導入
ComfyUI\custom_nodesでgit clone https://github.com/sepiablue-ai/ComfyUI-MossPanelDataset(追加の pip は不要)- 下の3つのモデルを置く
- ComfyUI を再起動し、
example_workflows\make_manga.jsonをドラッグして開く(テンプレートの画面からも開けます)
MOSS-Image のネイティブ対応が入った ComfyUI が必要です。作者は v0.42.0 で確かめていて、筆者は 0.44.0 で動きました。作者の README によると、ComfyUI Registry の 0.1.0 は Flagged の状態で、git で入れる方法が案内されています。
ワークフローは、リポジトリに同梱されているもの(example_workflows)をそのまま使いました。今回の試験は composition_duo.api.json の人物とセリフを書き換えたものです。
| ファイル | 大きさ | 置き場所 |
|---|---|---|
| moss_image_sft_int8_convrot.safetensors | 5.0GB | models\diffusion_models |
| qwen3.5_9b_int8_convrot.safetensors | 9.1GB | models\text_encoders |
| flux2-vae.safetensors | 0.3GB | models\vae |
MOSS-Image の基本はMOSS-Image の記事でまとめています。
商用で使える?
ノード本体、コマ割りのデータ、同梱の見本画像は MIT ライセンスで、商用を含めて使えます(著作権表示を残す)。MOSS-Image のモデルは別に配られていて、作者の README では Apache-2.0 とされています。作った漫画を販売物に使う前に、使うモデルの配布ページのライセンスを確かめてください。
RTX 5090 以外の人へ
作者は RTX 3060 12GB でデータセットを作ったと書いています。生成のあとの VRAM 使用量は、ComfyUI 全体で 14.4GB でした(テキストエンコーダーを含む)。--reserve-vram での簡易テストはしていません。
よくある質問(FAQ)
Q. ComfyUI で漫画のコマ割りを作るには?
ComfyUI-MossPanelDataset を入れ、MOSS-Image で make_manga.json を開きます。見本の画像からコマ割りを選び、人物・場面・セリフを入れると、コマ割りどおりの漫画ができます。
Q. 日本語のセリフはきれいに出る?
今回の4コマ12枚では、11枚でセリフがすべて正しく描かれました。1枚は、前のコマのセリフが次のコマにも入りました。場面と外見は英語、セリフは日本語のまま入れます。
Q. どれくらい時間がかかる?
RTX 5090 で 1024×1536・25ステップが1枚約11秒でした(最初の1枚はモデルの読み込みで 79秒)。
まとめ
MossPanelDataset は、コマ割りとセリフの入れ方を考えなくてよいところまで仕組みにしてあり、MOSS-Image の文字の強さがそのまま漫画に生きます。
まず make_manga.json で、構図の指定なしの4コマから。
検証メモ
- 設定:同梱のとおり 1024×1536、25ステップ、CFG 2.5、er_sde・simple。人物は同梱の2人(漫画家の女性、編集者の男性)の外見をそのまま使いました。
- 判定:コマの数・形、セリフの文字、人物の見分けを、12枚すべて目で確かめました。
- 時間:ComfyUI の実行開始から完了まで。2枚目以降は 10.9〜11.8秒でした。
- 未確認のこと:2・3・5・6コマ、3人の登場、人物画像からの外見の抽出、DMD LoRA、VRAM の少ない GPU。