この記事について(広告・アフィリエイトリンクはありません)
使ったモデルとノードは、すべて無料で入手できます。試した環境の一覧は検証の記録にあります。
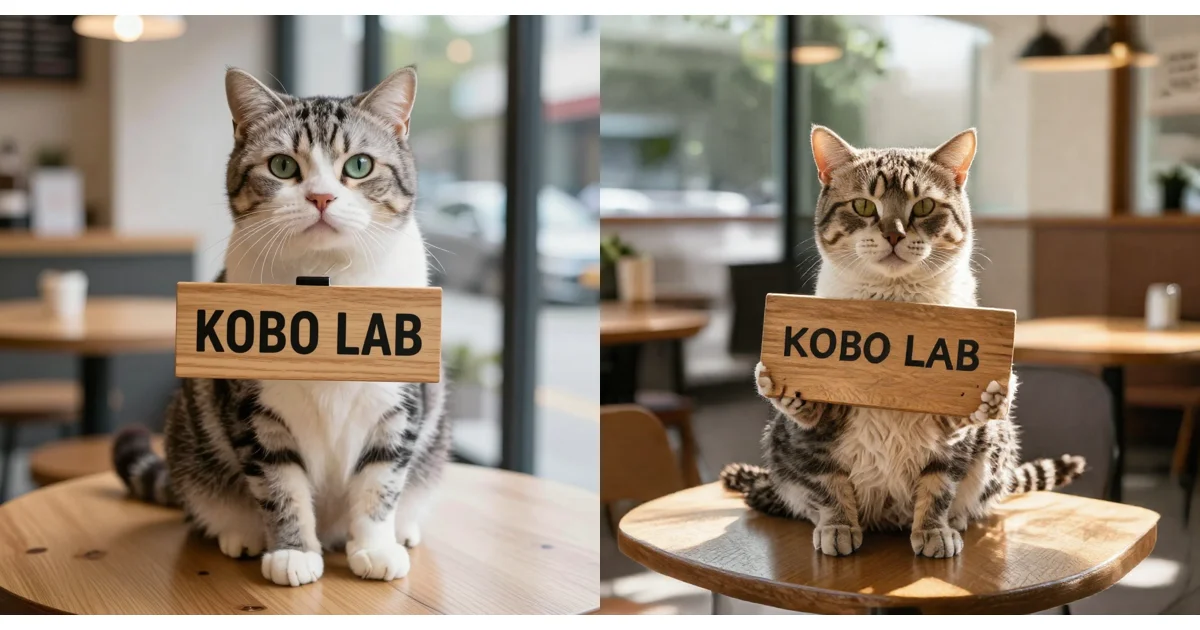
VAE を使わずにピクセルを直接描く研究用のモデル P-JiT 21K が、ComfyUI で動きました。 RTX 5090 では 1024×1024 の1枚が bf16 で約4.6秒です。人物や風景は形になりますが、看板の文字は6枚(bf16・int8 で3枚ずつ)のうち1枚も読めませんでした。
P-JiT は、Linum が約2万1千ドルの計算資源で学習した約2B(20億パラメーター)の画像モデルです。配布元は「粗さの残る研究用のチェックポイント」と書いています。ComfyUI で使うには、別の作者(PedroMarinhoDev さん)のノード ComfyUI-PJiT と、ComfyUI v0.44.0 以降が必要です。
先に結論(今回のテスト条件で)
| 項目 | 結果 |
|---|---|
| 1枚の時間(1024×1024、50ステップ) | bf16 約4.6秒、int8 約6.1秒 |
| bf16 と int8 の見た目 | 9組ともほぼ同じ |
| 人物・アニメ | 形にはなる。構図はシードごとに変わる |
| 看板の文字「KOBO LAB」 | 読めたのは0枚(bf16・int8 とも3枚中0枚) |
| 増えた VRAM(2枚目、指定なし) | bf16 約9.3GB、int8 約7.3GB |
写真風・アニメ風・看板の3つのプロンプトを、シード3つずつ作りました(bf16・int8 で各9枚)。
VAE を使わないとはどういうこと?
Stable Diffusion や Z-Image などの多くのモデルは、絵を小さな「潜在」という形に縮めてから描き、最後に VAE で絵に戻します。P-JiT は縮めずに、ピクセルそのものを描きます。
ComfyUI では、Load VAE で pixel_space を選ぶだけです。VAE のファイルは要りません。
VAE やノードの役割は、ComfyUI の基本ノード10選で説明しています。
どんな絵が描ける?
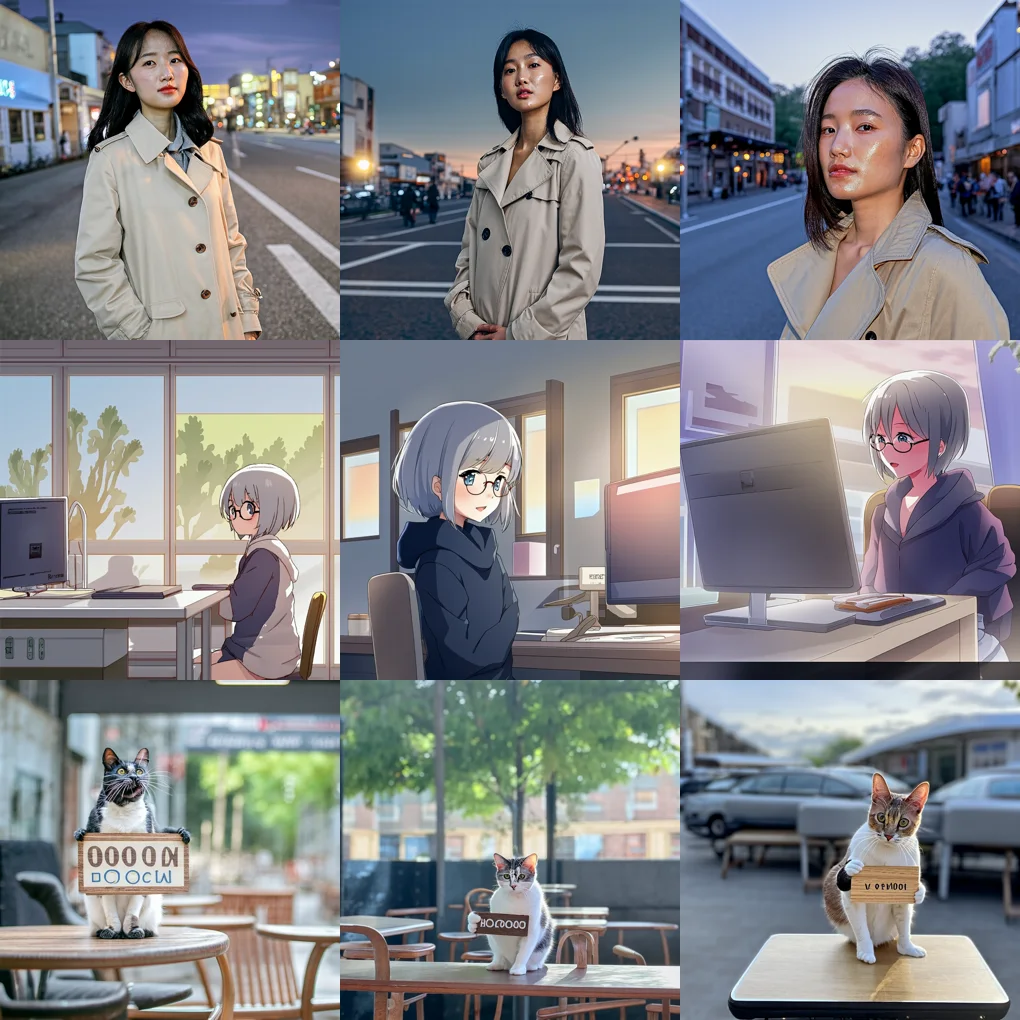
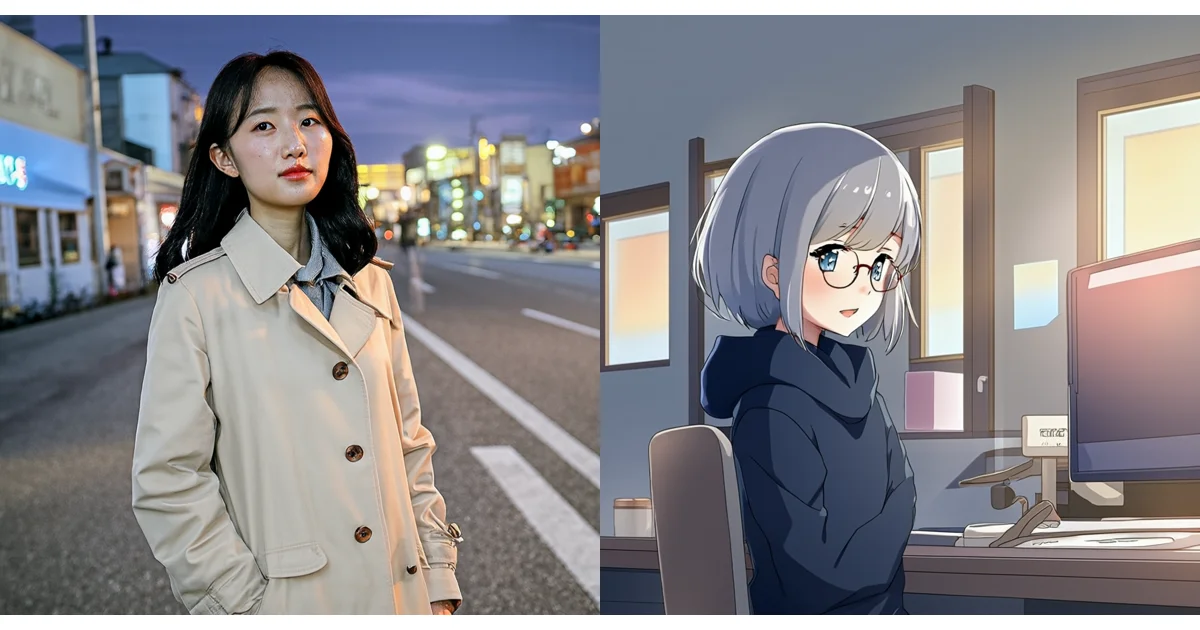
写真風は、トレンチコートの女性と夕方の街が描けています。肌が強く光って見える回がありました。アニメ風は、銀髪と眼鏡の指定は守られていますが、線がやや甘めです。
苦手なのは文字でした。猫の看板には、読めない記号のような形しか出ません。今日試した NitroFusion2 は同じプロンプトで4つの条件の20枚すべて読めたので、差がはっきりしています。
bf16 と int8 のどちらを使う?
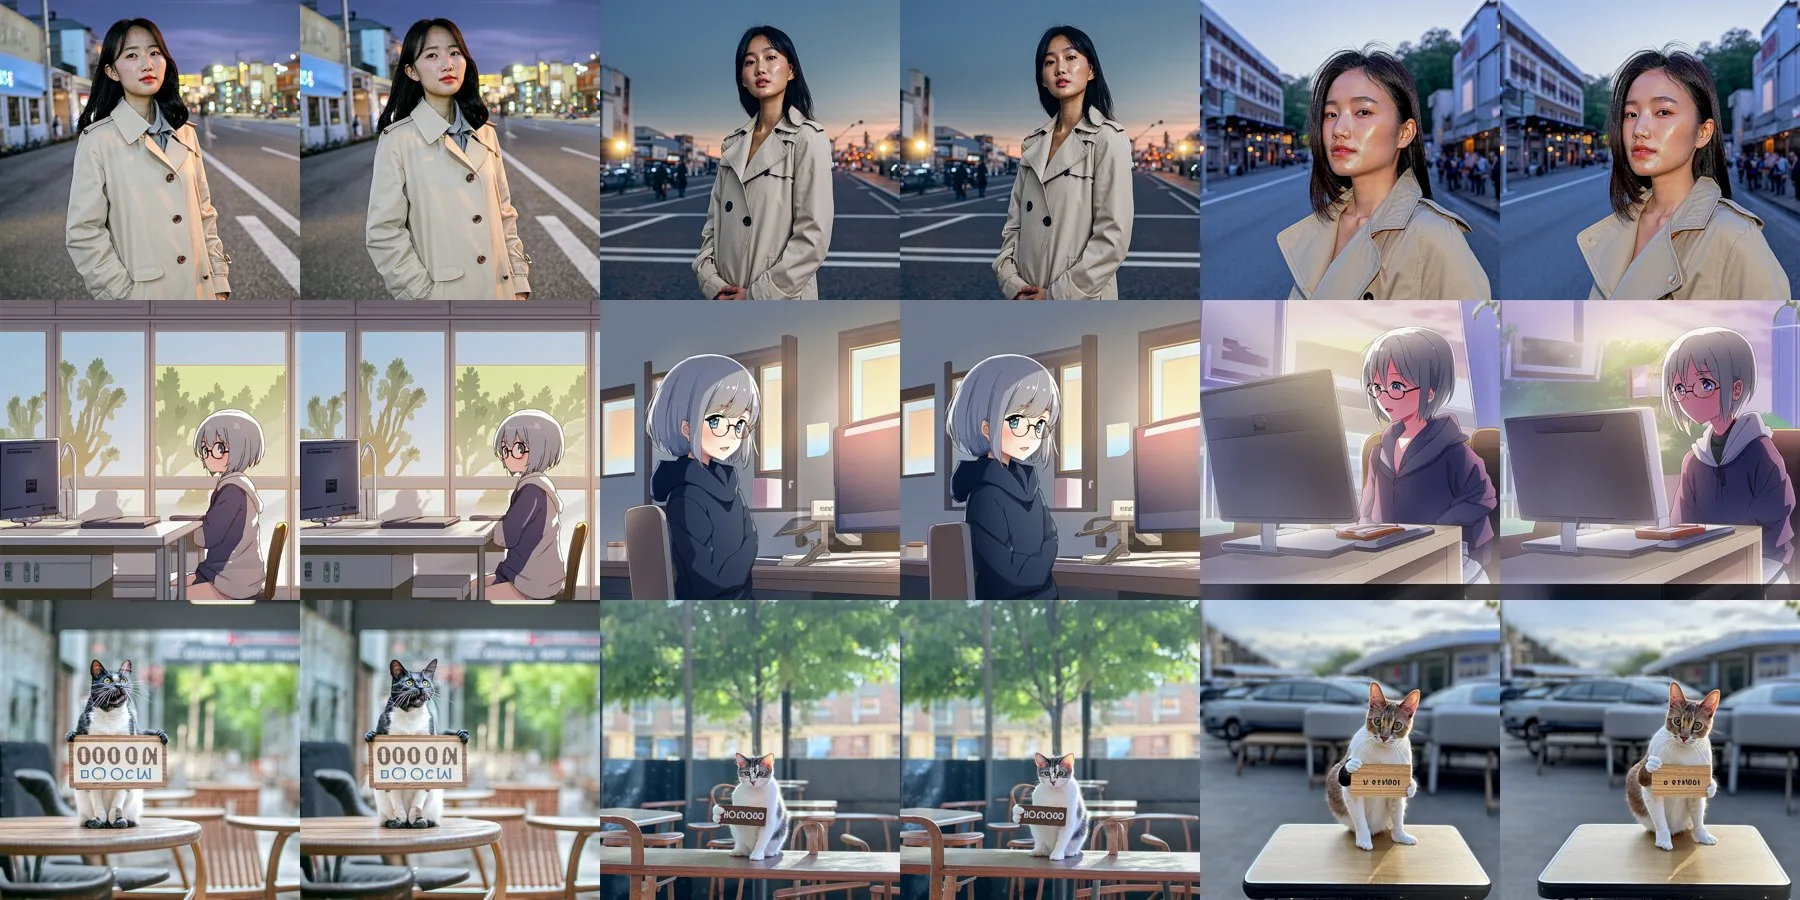
見た目の差は、筆者には見分けられませんでした。意外だったのは速さです。配布元の説明では int8 のほうが約1.8倍速いとされていますが、RTX 5090 では bf16 が約4.6秒、int8 が約6.1秒で、bf16 のほうが速くなりました。
配布元の数字がどの GPU で測ったものかは確かめていません。GPU によって int8 の計算の速さは変わるので、手元で両方を試して速いほうを選ぶのが確実です。
導入の手順
ComfyUI-PJiT を ComfyUI\custom_nodes に入れます。pip で追加するものはありません。ComfyUI は v0.44.0 以降にしておきます。
cd ComfyUI\custom_nodes
git clone https://github.com/PedroMarinhoDev/ComfyUI-PJiT.git| ファイル | 大きさ | 置き場所 |
|---|---|---|
| pjit_21k_bf16.safetensors | 4.4GB | models\diffusion_models |
| pjit_21k_int8_convrot.safetensors(どちらか1つ) | 2.3GB | models\diffusion_models |
| qwen3.5_4b_int8_convrot.safetensors | 4.7GB | models\text_encoders |
ほかのカスタムノードの入れ方はカスタムノードの入れ方、ComfyUI の更新はアップデート方法にあります。
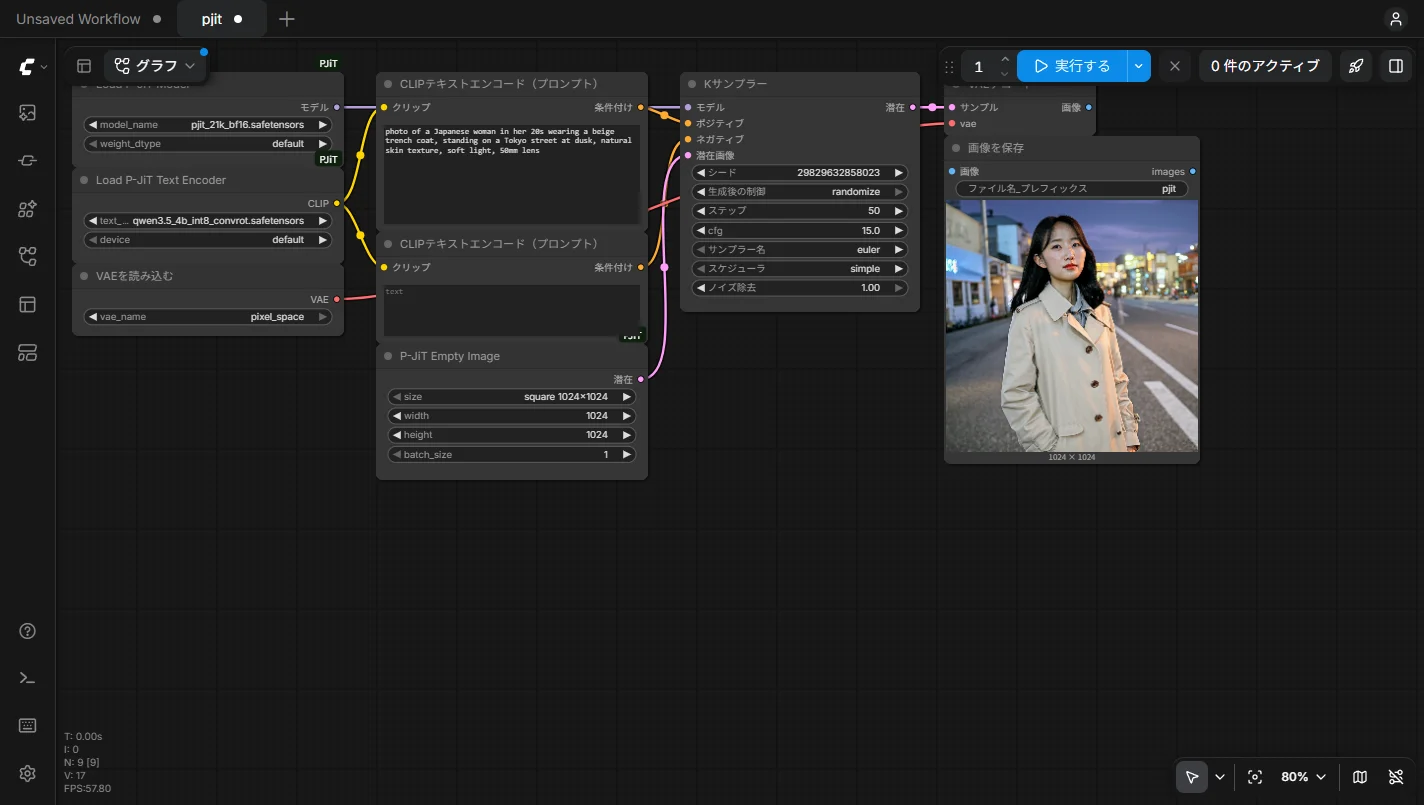
配布元の例と同じく、50ステップ、CFG 15、euler、simple です。プロンプトを長く書き直す機能(プロンプトアップサンプラー)は有料の OpenRouter を使うので、今回は使っていません。
- P-JiT bf16 のワークフロー(JSON)ComfyUI にドラッグして読み込みます。ComfyUI-PJiT が必要です
RTX 5090 以外の人へ
RTX 5090 で --reserve-vram の値を変え、VRAM が少ない環境を想定した簡易テストをしました。--reserve-vram は OS などのために VRAM を残しておく設定で、容量そのものを制限する機能ではありません。実際の 8GB・12GB の GPU での動作を再現・保証するものではない点に注意してください。
| 想定 | --reserve-vram | bf16(2枚目) | int8(2枚目) |
|---|---|---|---|
| 指定なし | なし | 4.65秒・増分 9.3GB | 6.10秒・増分 7.3GB |
| 12GB 程度 | 20 | 4.63秒・増分 9.3GB | 6.10秒・増分 7.3GB |
| 8GB 程度 | 24 | 4.64秒・増分 6.3GB | 6.20秒・増分 4.4GB |
どれも生成できて、時間もほとんど変わりませんでした。配布元は VRAM 4GB から動くとしています。
商用で使える?
モデルの重みは Apache-2.0 です(Linum の元のモデルと、ComfyUI 用のファイルのどちらも、Hugging Face のモデルカードの表示)。生成した画像の商用利用を含め、使い道の制限はほとんどありません。ノード ComfyUI-PJiT のコードは GPL-3.0 です。ノードを改変して配るときは GPL-3.0 の条件に従います。
よくある質問(FAQ)
Q. P-JiT とは?
Linum が学習した約2B パラメーターの画像生成モデルで、VAE を使わずにピクセルを直接描きます。配布元は研究用のチェックポイントとしています。
Q. P-JiT を ComfyUI で使うには?
ComfyUI を v0.44.0 以降にして、ComfyUI-PJiT を custom_nodes に入れます。モデルとテキストエンコーダーを置き、Load VAE では pixel_space を選びます。
Q. P-JiT は文字を描ける?
今回の検証では、看板の文字「KOBO LAB」を bf16・int8 とも3枚中0枚しか読める形で描けませんでした。
Q. P-JiT の int8 は速い?
RTX 5090 では bf16 が約4.6秒、int8 が約6.1秒で、bf16 のほうが速くなりました。int8 の利点はファイルと VRAM が小さいことです。
まとめ
P-JiT は、VAE を使わない作りを試せる、珍しいモデルです。ComfyUI の標準の KSampler でそのまま動き、導入も手軽でした。
仕組みに興味がある人の実験用。 文字や仕上がりを求める用途には、まだ向きません。
検証メモ
- 本数:写真風・アニメ風・看板の3つのプロンプト×シード 11・22・33 を、bf16 と int8 で9枚ずつ作りました。シードが3つなので、傾向の目安です。
- 設定:1024×1024、50ステップ、CFG 15、euler、simple、ネガティブは空。配布元の pjit_text_to_image.json と同じです(サイズだけ 1024×1024 に変更)。
- 時間:ComfyUI の実行開始から完了まで。読み込みを除くため、各条件の前に4ステップの空回しをしました。
- VRAM:ComfyUI を起動する前と比べた GPU 全体の増分です。
- 未確認のこと:リファイナーとプロンプトアップサンプラー、1024×1024 以外、ほかの GPU での int8 の速さ、実際の 4GB・8GB の GPU。