この記事について(広告・アフィリエイトリンクはありません)
紹介しているソフトとモデルは無料で入手できます。
Hex は、キーを押して話すと文字にして貼り付ける音声入力アプリです。文字起こしは自分の PC で行います。
音声をクラウドに送らずに日本語を入力できるのか、Windows 11 で確かめました。先に大事な点を書くと、今回は人の声もマイクも使っていません。 Windows の合成音声を WAV にして、Hex のコマンドに渡しました。キーを押して話し、アプリに貼り付けるという普段の流れは試せていません。
先に結論(今回のテスト条件で)
| 確かめたこと | 結果 |
|---|---|
| 日本語の文字起こし | 動いた。普通の文はおおむね正確 |
| 間違えやすいもの | 同音異義語、地名、英語の製品名 |
| 1文の時間 | 約1.1秒(Whisper、モデルの読み込みを含む) |
| 文字起こし中の通信 | 記録した範囲ではなし |
| アプリ起動中の通信 | anoma.ly への接続が1件(更新の確認) |
| マイクでの入力、アプリへの貼り付け | 未確認 |
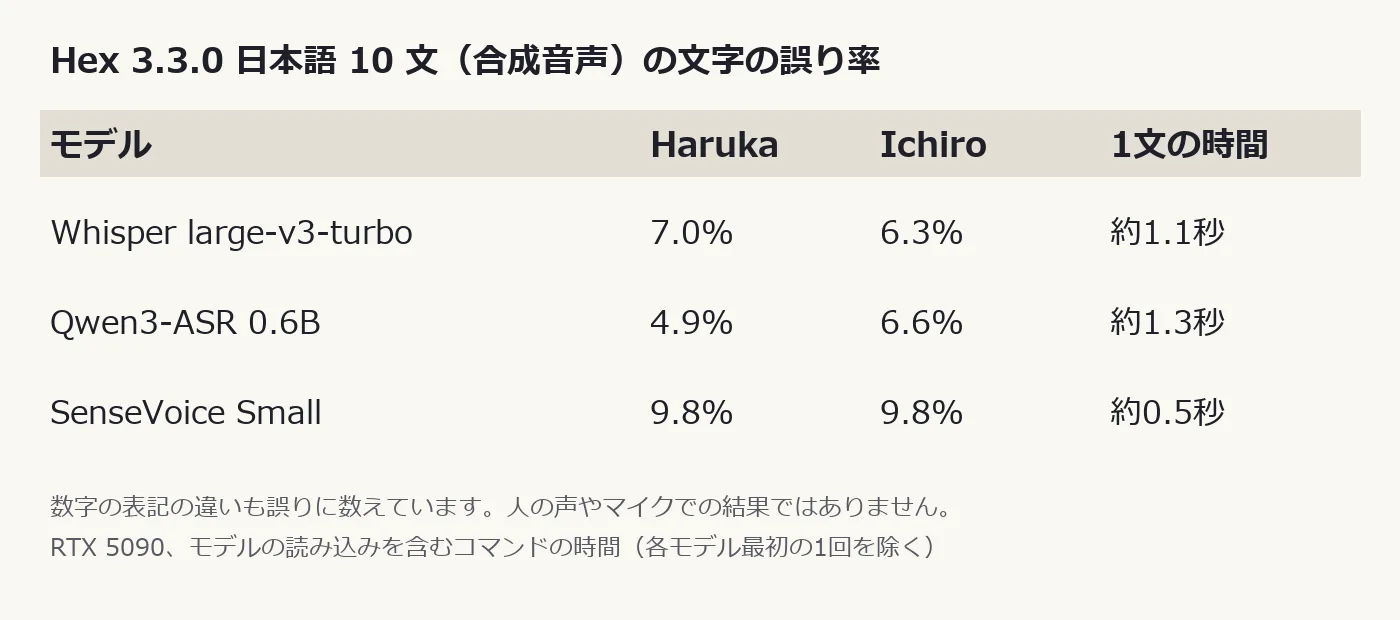
- 誤字率は Qwen3-ASR が最も低い結果でした(2つの声の平均 5.75%)。 Whisper large-v3-turbo は 6.62%、SenseVoice は 9.76% です。数字の表記も誤りに数えた、合成音声10文だけの値です。Hex の案内は、日本語では Whisper large-v3-turbo を先に勧めています。
- 「何も送らない」は文字起こしの話です。初回のモデルの取得と、更新の確認は通信します。
- 合成音声の結果なので、人の声でも同じ精度とは言えません。
試した環境
| 項目 | 内容 |
|---|---|
| GPU | RTX 5090(32GB)。Hex は Vulkan で使用 |
| OS | Windows 11 |
| Hex | 3.3.0。hex-3.3.0-windows-x64.exe(インストーラーではない単体のファイル) |
| 音声 | Windows の Microsoft Haruka Desktop と Microsoft Ichiro で作った 16kHz の WAV |
| 文 | 自作の 10 文 |
| データの場所 | 検証用のフォルダーに分離 |
| 検証日 | 2026年11月4日 |
入れ方
通常は、公式のインストーラーを使います。管理者権限は要らず、現在のユーザーに入ります。
- Hex のダウンロード(
hex-setup-3.3.0-windows-x64.exe)
今回は PC の環境を変えないよう、インストーラーは実行せず、単体のファイルで試しました。インストーラーの動きは確かめていません。
| 確認 | 結果 |
|---|---|
| SHA-256 | GitHub のリリースの値と一致 |
| 署名 | 有効(Anomaly Innovations, Inc) |
| 必要なもの | x64 は AVX2 の CPU と Vulkan のドライバー(公式の説明) |
公式の説明では、Windows 版はベータの扱いです。既定のショートカットは Ctrl+Space で、一致している間はほかのアプリや入力方式に渡りません。日本語入力の切り替えなどに Ctrl+Space を使っている人は、設定で変えてください。
モデルの取得
初回にモデルをダウンロードします。今回の取得の時間です。回線によって変わります。
| モデル | サイズ | 取得の時間 |
|---|---|---|
| Whisper large-v3-turbo | 886MB | 約3分35秒 |
| Qwen3-ASR 0.6B | 850MB | 約2分48秒 |
| SenseVoice Small | 253MB | 約55秒 |
コマンドでも入れられます。
hex model install whisper_large_v3_turbo --language ja音声の入れ方(今回の工夫)
人が話せないので、次の手順にしました。
- PowerShell の
System.Speechで、日本語の文を読み上げた WAV を作る - Hex の
model transcribeに WAV を渡す
hex model transcribe --model whisper_large_v3_turbo --language ja sample.wav仮想のマイクは入れていません。ドライバーを入れることになるので、PC への影響を避けました。
日本語の結果
文字の誤り率は、句読点と空白を除いて、元の文との違いを数えたものです。今回の10文、合成音声の値です。
| モデル | Haruka の誤り率 | Ichiro の誤り率 | 1文の時間 |
|---|---|---|---|
| Whisper large-v3-turbo | 7.0% | 6.3% | 約1.1秒 |
| Qwen3-ASR 0.6B | 4.9% | 6.6% | 約1.3秒 |
| SenseVoice Small | 9.8% | 9.8% | 約0.5秒 |
表は小数1桁に丸めています。本文の平均(Qwen3-ASR 5.75%、Whisper 6.62%、SenseVoice 9.76%)は、丸める前の値(Whisper は 6.97% と 6.27%)を2つの声で単純に平均したものです。
時間は、コマンドを1回実行する間で、モデルの読み込みを含みます。音声の長さは1文あたり数秒です。各モデルの最初の1回は 3〜12秒かかりました。
数字の表記も誤りに数えています。 たとえば「十二万三千四百円」を「123,400円」と書くのは正しい内容です。率だけで優劣は決められません。
実際の文字
| 元の文 | Whisper | Qwen3-ASR | SenseVoice |
|---|---|---|---|
| 十二万三千四百円 | 123,400円 | 十二万三千四百円 | 12万3400円 |
| 明日の午後三時 | 午後3時 | 午後三時 | 午後3時 |
| GPU のメモリが | GPUのメモリが | GPU のメモリが | GPU が抜けた |
| 本日は晴天なり | 晴天なり | 晴天なり(Ichiro は「正典」) | 「聖天」 |
| 港区芝公園 | 港区芝公園(Haruka は「港串場公園」) | 港区白石公園など | 港福芝公園など |
間違えやすいもの
- 同音異義語:「箸を持って橋を渡り、端に座って雨と飴の話」は、どのモデルも全部を区別できませんでした。音だけでは決めにくい文です。
- 地名:「港区芝公園」は、モデルや声で結果が分かれました。
- 製品名:「ComfyUI」は「CAMHUE」「カムフイ」などになりました。ただし合成音声の読み方自体が怪しいので、Hex の弱点とは言い切れません。専門用語が多いなら、語彙の登録機能を試す価値があります(今回は未確認)。
SenseVoice では、単語の間に空白が入ることがありました。日本語の文章としては、後で直す手間があります。
普通の文(「猫が窓のそばで…」「すみません、もう少し…」)は、3つとも誤りがないか、ごくわずかでした。
本当に通信していないのか
README には「最初にモデルを取得したあとは、何も PC の外に出ない」とあります。そこで、Hex の通信を記録用のプロキシに通して、宛先を記録しました。
| 場面 | 記録された宛先 |
|---|---|
| WAV の文字起こし | なし |
| アプリを起動して約70秒 | anoma.ly:443 が1件 |
同時に、Hex の接続を一定の間隔で見る方法も試しましたが、こちらでは外部への接続を捉えられませんでした。短い接続は見逃します。
ログによると、anoma.ly への接続は更新の確認で、判定は up_to_date でした。ソースにも更新の情報の取得先として同じ場所があります。中身は見ていません。
言えること、言えないこと
- 文字起こしの間に音声が外へ送られる様子は、今回の記録にはありませんでした。
- ただし、プロキシを使わない通信は記録できません。 完全に送っていないと証明したわけではありません。
- 初回のモデルの取得と、自動更新は通信します。
hex.exeを自動で更新する仕組みが公式の説明にあります。
「Modes」で文章を書き直す機能は、OpenCode を通します。設定によっては文章が外部のモデルに渡る可能性があります(今回は未確認)。
文字にした内容は、既定で history.json に残ります。音声は既定で残さないと公式の説明にあります。保持の期間の既定は1週間です(ソースの src/history.rs の既定値が Week)。実際に1週間で消えることは確かめていません。
会議の録音や画面の録画の機能も入っています。音声入力だけのつもりで入れる人は、設定を一度見ておくと安心です。
試せなかったこと
- マイクからの入力:マイクは開いていません。
- キーを押して話す流れ:起動したときの状態は
Disabledで、ショートカットは有効になっていませんでした。単体のファイルで起動したためか、理由までは確かめていません。 - 貼り付け:ブラウザーやメモ帳などへの貼り付けは未確認です。
話し終えてから文字が出るまでの時間も測っていません。測ったのはコマンドの時間だけです。インストーラーと自動更新の実際の動きも未確認です。
使い心地そのものを評価するには、人が話して試す必要があります。
ライセンスは MIT、モデルは別
LICENSE は MIT です。音声認識のモデルにはそれぞれのライセンスがあります。
確認時点で GitHub のスターは 4,548、フォークは 255 です。プルリクエストは受け付けず、Issue から開発する方針と README にあります。スターは品質の保証ではありません。
よくある質問(FAQ)
Q. オフラインで使えますか?
今回の WAV の文字起こしで、記録した範囲では通信はありませんでした。ネットワークを切った状態では試していません。
Q. 日本語にはどのモデルがいいですか?
今回の合成音声では、誤字率は Qwen3-ASR が最も低い結果でした(平均 5.75%、Whisper は 6.62%)。Hex は日本語で Whisper turbo を先に案内しています。人の声では試していません。
Q. 無料ですか?
はい。Modes で有料のモデルにつなぐ場合は、その料金がかかります。
Q. GPU は必須ですか?
公式の説明では、x64 は Vulkan で GPU を使います。今回は RTX 5090 だけで試しました。CPU だけの場合の速度は確かめていません。
Q. Windows 標準の音声入力より良いですか?
比べていません。
まとめ
- 日本語の文字起こしはローカルで動き、普通の文はおおむね正確でした。
- 同音異義語、地名、製品名には注意が必要です。
- マイクと貼り付けは未確認なので、最後は自分の声で試してください。
検証メモ
合成音声:読み上げの品質がそのまま結果に出ます。人の声、雑音、早口、方言の精度は分かりません。
評価:自作の10文を2つの声で、各モデル20回です。言語は ja を指定しました。
時間:Whisper と Qwen の間は、最初の読み込みの差も大きいです。最初の1回はドライバーやモデルの読み込みで長くなり、Whisper 11.95秒、Qwen 7.18秒、SenseVoice 3.15秒でした。
データの分離:HEX_APPLICATION_SUPPORT_DIR と APPDATA を検証用のフォルダーに向けました。USERPROFILE を変えると Hex は起動時にエラーで止まりました。これは私の検証のしかたの影響で、普通の使い方では出ません。
自動起動:実行の前後で Windows の Run キーは変わっていません。
片付け:終了後に Hex のプロセスがないことを確かめました。1回目はプロセスを強制終了したので、次の起動で「前回の起動がクラッシュした」という記録が出ました。
未確認のこと:上の「試せなかったこと」のほか、語彙の登録、Modes、会議の機能、ARM64、CPU のみの動作。