ComfyUI と LM Studio を同じ GPU で使うなら、LLM を外してから画像を作るのが手軽で、VRAM のピークも下がります。
LM Studio でローカルLLMを動かせば、日本語で「夕暮れの海辺で麦わら帽子の女の子」と書くだけで、英語のプロンプトを作ってもらえる組み合わせです。
ただ、LLM と画像生成モデルを両方動かすとVRAM の取り合いが起きます。この記事では、2つのつなぎ方と、対策なしを含む4つの条件で比べた VRAM の実測を紹介します。測定の条件は末尾の「検証メモ」に書きました。
結論:LLMを使い終わったら外してから画像を作る
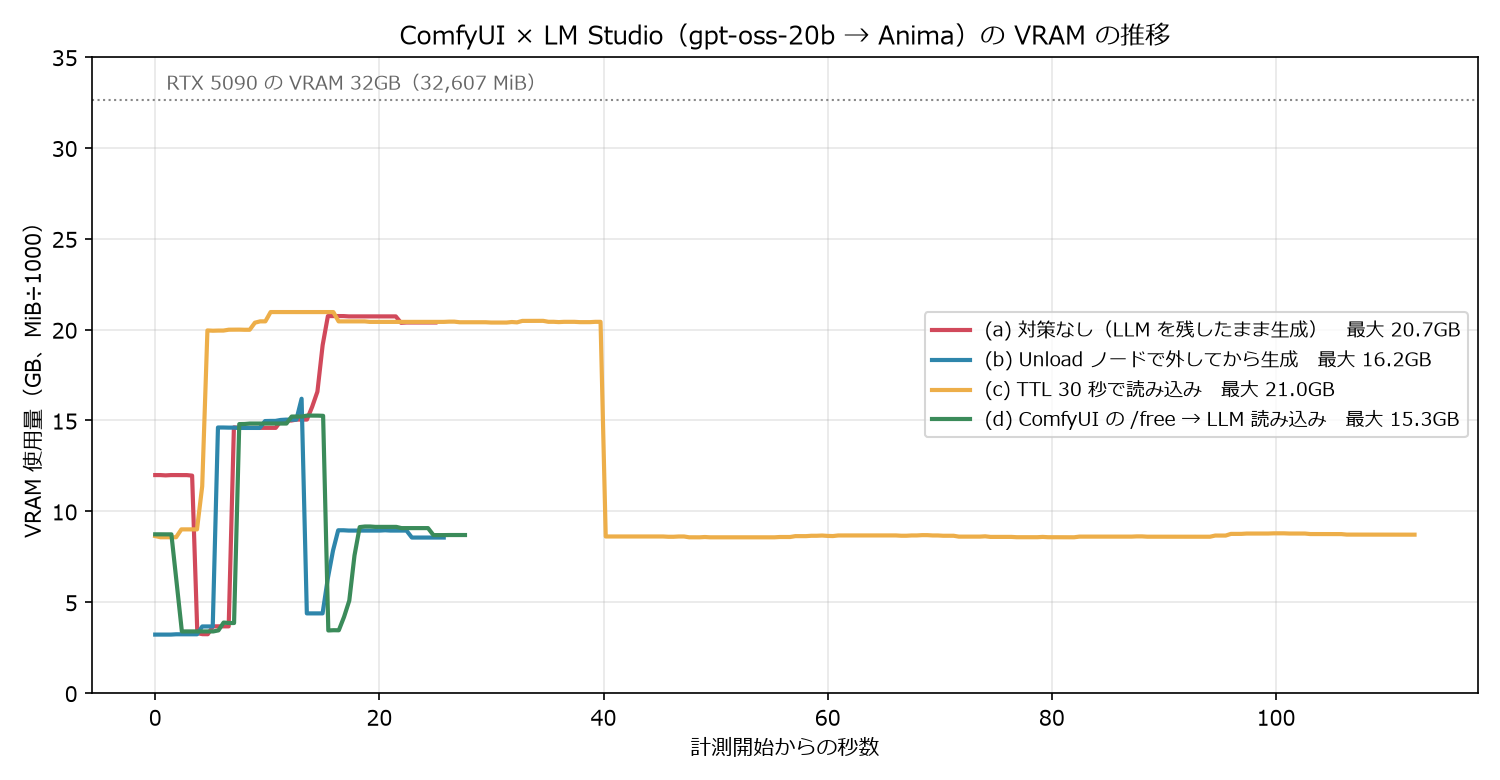
- 何も対策しないと、VRAM のピークは 20.7GB でした。画像を作り終わった後も、LLM(読み込みで約10.9GB 増えた分)が VRAM に残ったままになります。
- LLM を外してから画像を作ると、ピークは 16.2GB まで下がりました。
- ComfyUI 側のモデルを先に解放してから LLM を読み込むと、ピークは 15.3GB でした。
- LM Studio の TTL(使われないと自動で外れる時間)を短くする方法は、後片付けには便利ですが、ピークは下がりませんでした。
VRAM が 16GB 以下の GPU では、対策なしだとモデルが VRAM に収まらないおそれがあります。その場合は「使い終わった方が VRAM を返す」順番を作るのが大切です。
検証した環境
| GPU | NVIDIA GeForce RTX 5090(32GB) |
| OS | Windows 11 |
| ComfyUI | v0.43.0(ポータブル版) |
| LM Studio | 0.4.25 |
| LLM | openai/gpt-oss-20b(MXFP4、約12GB) |
| 画像生成モデル | anima_jp_extended(896×1152、30ステップ、CFG 4、er_sde/simple) |
| カスタムノード | ComfyUI-EBU-LMStudio 1.0.10 |
| 検証日 | 2026年10月29日 |
なぜVRAMの取り合いになるのか
ComfyUI も LM Studio も、一度読み込んだモデルを VRAM に残しておきます。次に使うときに読み込み直さなくて済むので速いのですが、2つのアプリが同時にモデルを持つと、その合計が VRAM を占めます。
他のアプリからの呼び出しで自動的に読み込まれたモデル(JIT 読み込み)は、最後に使われてから60分は VRAM に残る、というのが LM Studio の公式ドキュメントの説明です。lms load コマンドで読み込んだモデルは、手で外すまで残る仕様です。
ComfyUIとLM Studioのつなぎ方
手順1:LM Studio の準備
- LM Studio でモデル(今回は openai/gpt-oss-20b)をダウンロードします。
- LM Studio のローカルサーバーを起動します(標準のポートは 1234)。
- コマンドプロンプトで
lms lsを実行し、モデルの一覧が出ることを確かめます。出ない場合は、lms コマンドの場所が PATH に入っていません。
手順2:ComfyUI 側のカスタムノード
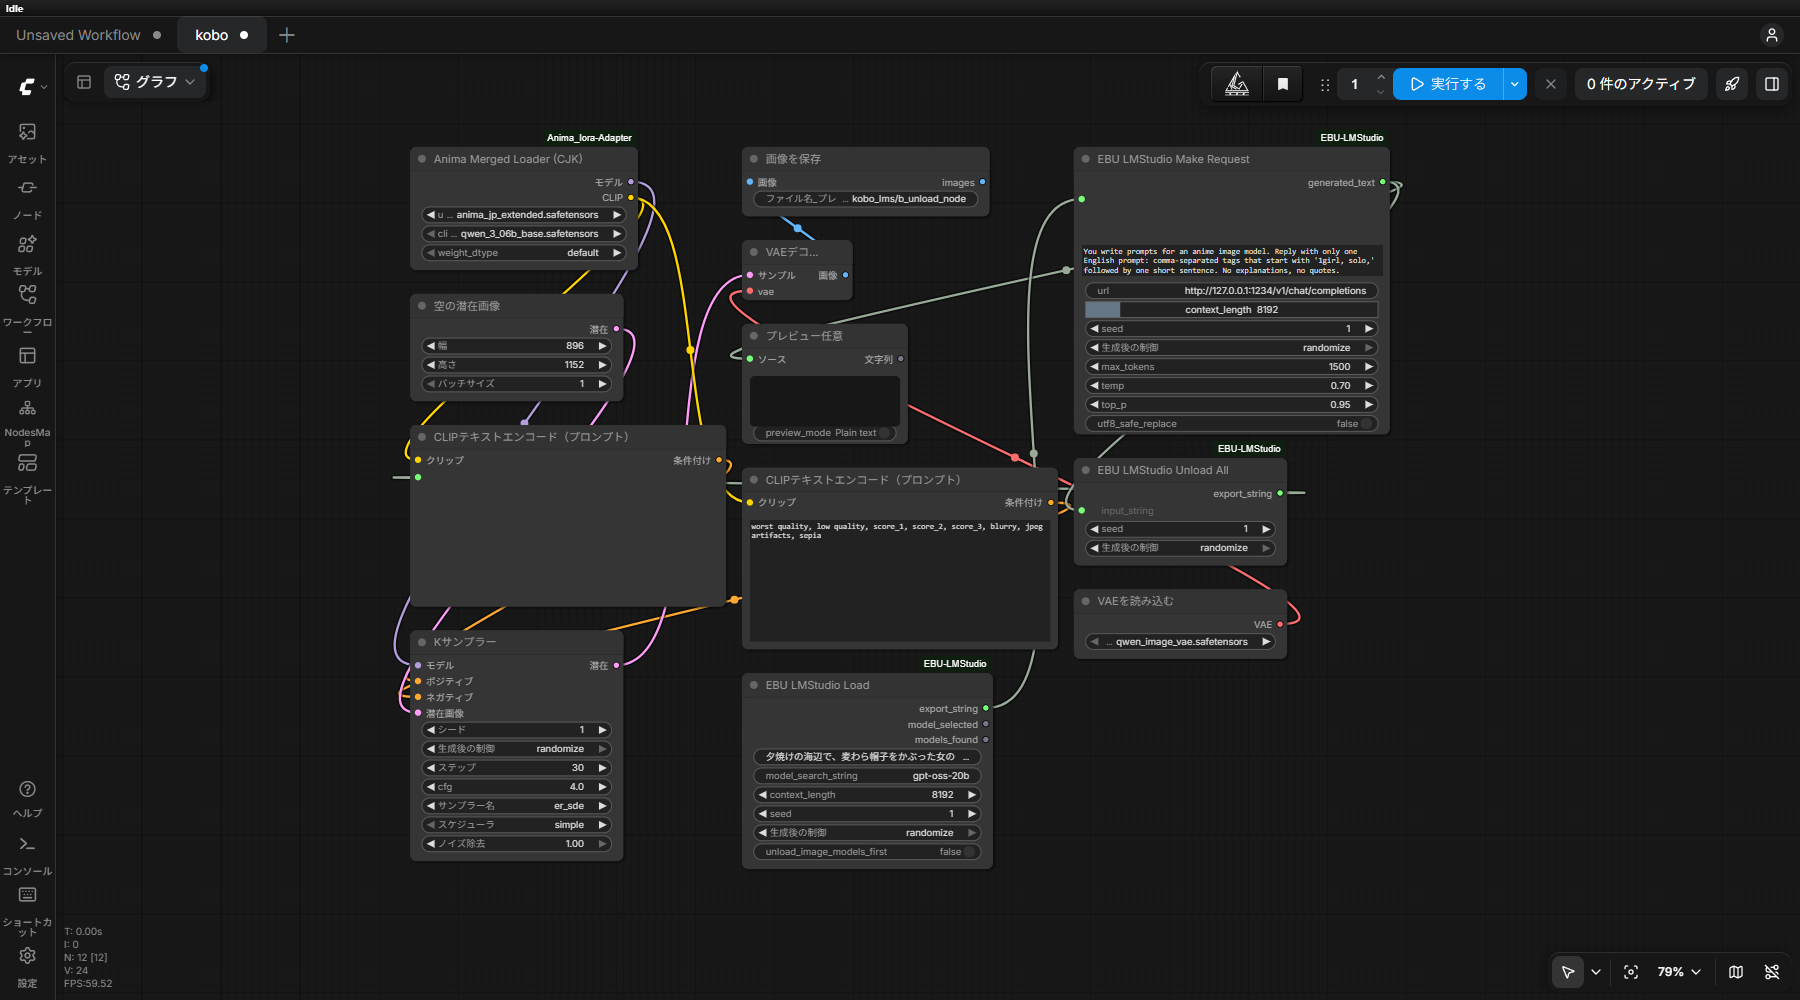
ComfyUI から LM Studio を呼ぶノードはいくつかありますが、今回は ComfyUI-EBU-LMStudio(MIT ライセンス)を使いました。LLM の読み込み・問い合わせ・解放のノードがそろっていて、VRAM の管理まで ComfyUI の中でできるからです。導入前にコードを読み、LM Studio(127.0.0.1:1234)以外への通信がないことを確認しました。
cd ComfyUI/custom_nodes
git clone https://github.com/burnsbert/ComfyUI-EBU-LMStudio
今回使ったノードは次の3つです。
| ノード | 役割 |
|---|---|
| EBU LMStudio Load | LM Studio にモデルを読み込ませる |
| EBU LMStudio Make Request | 指示文を送り、LLM の返事を文字列として受け取る |
| EBU LMStudio Unload All | LM Studio に読み込まれている LLM をすべて外す |
注意:Load ノードと Unload ノードは、内部で lms unload --all を実行します。LM Studio で手動で読み込んでおいた別のモデルもまとめて外れます。実際に、手で読み込んでおいた qwen3.5-9b も外れました。LM Studio を別の用途でも使っている人は気をつけてください。
手順3:ワークフロー
流れは「日本語の指示 → LLM が英語プロンプトを書く → そのプロンプトで画像を作る」です。Make Request の出力を、画像生成のプロンプト(CLIP Text Encode)の入力につなぎます。
「夕焼けの海辺で、麦わら帽子をかぶった女の子が振り返って笑っている、やさしい雰囲気のイラスト」という日本語の指示から、gpt-oss-20b は次のプロンプトを書きました(4回とも同じ結果でした)。
1girl, solo, sunset, seaside, straw_hat, smiling, looking_back, gentle. A girl with a straw hat smiles softly as she looks back at the setting sun.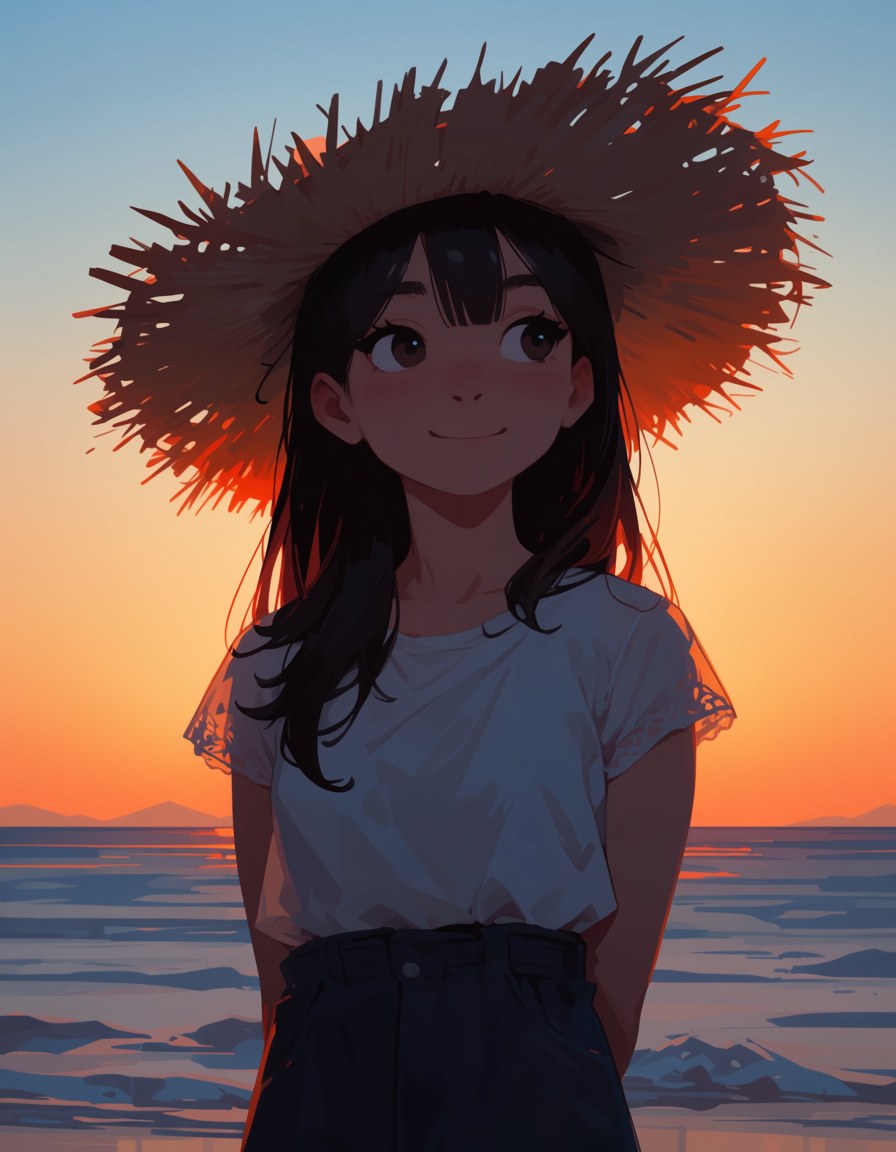
ComfyUIとLM Studioを併用する4条件でVRAMを比較(実測)
同じワークフローを、対策なしを含む4つの条件で動かし、nvidia-smi で VRAM の使用量を約0.5秒ごとに記録しました。ピークが下がったのは (b) と (d) で、(c) は対策なしとほぼ同じでした。
| 方法 | VRAMのピーク | かかった時間 | 終わった後 |
|---|---|---|---|
| (a) 対策なし | 20.7GB | 20.6秒 | LLM が残る(読み込みで約10.9GB 増えた分) |
| (b) Unload All で LLM を外してから生成 | 16.2GB | 21.3秒 | 8.6GB(画像モデルだけ) |
(c) lms load --ttl 30 で読み込んでおく | 21.0GB | 8.1秒※ | 20〜30秒後に LLM が自動で外れる |
| (d) ComfyUI の /free でモデルを解放してから LLM を読み込む | 15.3GB | 21.4秒(/free の2.1秒は含まない) | 8.7GB(画像モデルだけ) |
時間は、ComfyUI にワークフローを送ってから画像が保存されるまでです。(a)(b)(d) には、LLM の読み込み、LLM の応答、画像モデルの読み込み、生成が含まれます。※(c) は LLM(約7秒)も画像モデルも読み込み済みの状態から測ったので、ほかの3つとは条件が違います。(c) の時間が短いのは主にこのためです。
(b) LLM を外してから画像を作る(いちばん手軽)
Make Request の後に Unload All ノードを置き、LLM を外してから画像生成に進むようにつなぎます。対策なしと比べて時間は0.7秒しか増えず、ピークは4.5GB 下がりました。作り終わった後に VRAM に残るのも画像モデルだけです。
(c) TTL を短くする(後片付けは楽だがピークは下がらない)
TTL は「使われなくなってから何秒で自動的に外すか」の設定です。lms load モデル名 --ttl 30 のように秒数で指定できます。実際に30秒にしたところ、使い終わってから20〜30秒で LLM が外れました。
ただ、外れるのは画像生成の後です。生成中は LLM も画像モデルも VRAM に載っているので、ピークは対策なしと同じでした。VRAM に余裕がある人が「放っておいても後で空く」ようにする方法と考えてください。LLM を前もって読み込んでおけば、ワークフローを動かしたときの待ち時間は短くなります。
(d) ComfyUI のモデルを先に解放する
ComfyUI には、読み込んだモデルを VRAM から外すための /free という仕組みがあります(ComfyUI のソースコードで確認)。ComfyUI を起動した状態で、コマンドプロンプトから次のように呼び出します。
curl -X POST http://127.0.0.1:8188/free -H "Content-Type: application/json" -d "{\"unload_models\": true, \"free_memory\": true}"ポート番号は自分の ComfyUI に合わせてください。今回はこの方法がいちばんピークが低く、15.3GB でした。
VRAM が少ないGPUの人へ
今回の数字は RTX 5090(32GB)で測ったものです。VRAM の少ない GPU では試していません。目安として、gpt-oss-20b を読み込むと VRAM が約10.9GB 増え(10,949 MiB を1000で割った値。GiB では約10.7)、今回の画像生成モデルで約5.3GB(読み込み前との差)を使いました。両方を同時に載せられない GPU では、(b) か (d) のように「片方を外してからもう片方を使う」流れにしてください。もっと小さい LLM を選ぶのも有効です。
ComfyUI 側の VRAM 不足の対処法は、ComfyUI の VRAM 不足の記事にまとめています。
まだ試していないこと
ほかの LM Studio 連携ノードでの動作と、Ollama と ComfyUI の組み合わせは試していません。VRAM 8〜16GB の GPU での実際の動きも未確認です。
LM Studio の REST API(/api/v1/models/unload)から外す方法も、今回は使いませんでした。
よくある質問(FAQ)
Q. ComfyUI から LM Studio につながりません
LM Studio のローカルサーバーが起動しているか、ポート(標準は1234)が合っているかを確かめてください。EBU-LMStudio は lms コマンドも使うので、コマンドプロンプトで lms ls が動くことも必要です。
Q. TTL の初期値はどれくらいですか?
LM Studio の公式ドキュメントでは、他のアプリから呼ばれて自動で読み込まれたモデルは60分です。lms load で読み込んだモデルには TTL がなく、手で外すまで残ります。
Q. LLM が書いたプロンプトはそのまま使えますか?
今回の例では、指示どおりの絵が出ました。ただ、LLM はいつも同じ答えを返すとは限りません。気に入らないときは、指示文にタグの形式や長さを書き足すと調整しやすくなります。
検証メモ
- 版:LM Studio は検証時点で 0.4.25 です。2026年10月30日に確認した最新は 0.4.27 で、最新版での動作は未確認です。
- 測定の回数と開始時の状態:4条件を1回ずつ測りました。(a) は手で読み込んだ qwen3.5-9b(8.28GB)がある状態で始め、ComfyUI にモデルはありません。(b) は LLM も ComfyUI のモデルもない状態、(c) と (d) は Anima を読み込み済みの状態からです。計測中に GPU を使い続けるアプリはなく、開始時の VRAM は約3.2GB でした。
- 測り直し:(a) の1回目は VRAM の記録ファイルが空になったので、もう一度実行して測っています。
- LLM の条件:コンテキスト長 8192、max_tokens 1500、シードは固定です。プロンプトが4回とも同じになったのは、シードを固定したためです。
参考にした公式情報
- LM Studio:Idle TTL and Auto-Evict
- LM Studio:REST API
- ComfyUI:server.py(/free の実装)
- ComfyUI-EBU-LMStudio(GitHub)