gpt-oss-120b は、OpenAI が公開している 1,170億パラメータの言語モデルです。ライセンスは Apache-2.0 で、商用でも使えます。これまでの記事では小さい gpt-oss-20b を使いましたが、今回は大きい 120b が、RTX 5090(VRAM 32GB)と RAM 128GB の PC で動くかを試しました。
試した環境
| 項目 | 内容 |
|---|---|
| GPU | NVIDIA GeForce RTX 5090(VRAM 32GB) |
| CPU / メモリ | AMD Ryzen 9 9950X3D / 128GB |
| OS | Windows 11 |
| ドライバ | NVIDIA 621.01 |
| llama.cpp | b12002(公式の Windows 用 CUDA 13.4 版、2026-10-30) |
| モデル | ggml-org/gpt-oss-120b-GGUF の gpt-oss-120b-MXFP4.gguf(63.39GB) |
| 確認した日 | 2026年10月31日 |
gpt-oss-120b の基本
| 項目 | 内容 |
|---|---|
| 公開 | OpenAI(Hugging Face 2025-08-04) |
| ライセンス | Apache-2.0(商用利用可) |
| 大きさ | 全体 約1,170億パラメータ、1トークンで使うのは約51億(MoE) |
| 形式 | MXFP4(4ビット)。GGUF は 63.39GB の1ファイル |
MoE(Mixture of Experts)は、たくさんの「専門家(エキスパート)」の重みを持ち、1トークンごとにその一部だけを使う作りです。全部の重みは大きいので VRAM に入りませんが、毎回使うのは一部なので、エキスパートの重みを RAM に置いても動きます。
必要なもの
- モデル:gpt-oss-120b-MXFP4.gguf(63.39GB)。置き場所はどこでもよく、起動のときに場所を指定します
- llama.cpp:公式のリリースページ の Windows CUDA 版(
llama-b〇〇〇〇-bin-win-cuda-13.4-x64.zip)とcudart-llama-bin-win-cuda-13.4-x64.zip - RAM:96GB 以上が目安(今回は 128GB)
- SSD の空き:70GB 以上
起動のしかた
llama.cpp を展開したフォルダで、次のように起動します。今の llama.cpp は、VRAM に入りきらないぶんを自動で振り分けてくれます(--fit、既定で有効)。
llama-server.exe -m gpt-oss-120b-MXFP4.gguf -fa on -c 32768 --port 8080手で振り分けたいときは、--n-cpu-moe 数(前から数えた層のエキスパートを CPU 側に置く)や --cpu-moe(全部の層のエキスパートを CPU 側に置く)を足します。
RTX 5090+RAM 128GB での速さ(実測)
日本語の説明・英語のコード・日本語の手順説明の3種類の指示で、それぞれ 512 トークン出したときの速さです。温度 0 で、2回目以降の平均です。
| 振り分け | コンテキスト | 生成(トークン/秒) | 読み込み(トークン/秒) | VRAM 最大 | RAM(llama.cpp) | 起動まで |
|---|---|---|---|---|---|---|
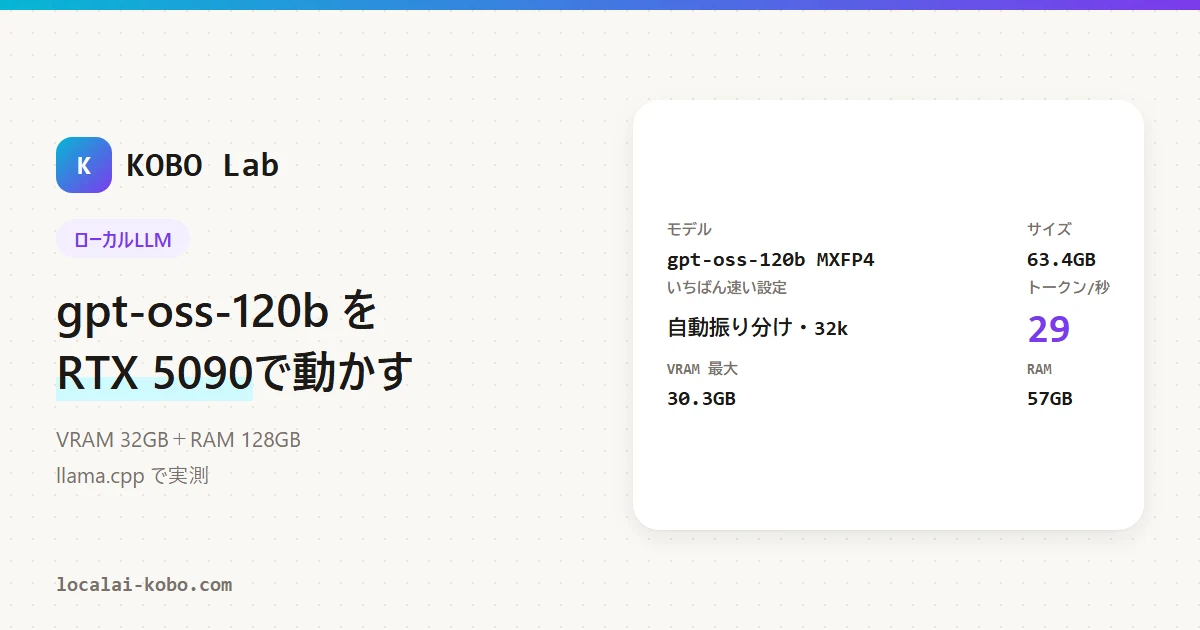
自動(--fit 任せ、-ngl なし) | 32k | 28.6 | 48 | 30.3GB | 57GB | 18秒 |
-ngl 99(全部 GPU に載せる指定) | 32k | 9.3 | 58 | 30.2GB | — | 512秒 |
--n-cpu-moe 24 | 32k | 23.3 | 35 | 23.5GB | — | 16秒 |
--cpu-moe(エキスパートを全部 CPU 側) | 32k | 16.9 | 26 | 4.7GB | — | 8秒 |
自動(--fit 任せ) | 128k | 23.3 | 42 | 30.1GB | 57GB | 18秒 |
| 自動+EAGLE3 の先読み | 32k | 25.7 | 44 | 31.3GB | 59GB | 28秒 |
「読み込み」は指示の文章を読む速さ、「RAM(llama.cpp)」は llama-server のプロセスが使ったメモリ(タスクマネージャーのワーキングセット)の最大値です。「—」はこの測定で記録していません。
-ngl 99 の起動 512秒は、最初の1回でモデルをディスクから読んだ時間。ほかの行は、ファイルが PC のメモリに残った状態で測りました。
EAGLE3 は、小さな別モデル(eagle3-gpt-oss-120b-Q8_0.gguf、0.85GB)で先読みする方法です。--spec-type draft-eagle3 -md eagle3-gpt-oss-120b-Q8_0.gguf で使えます。今回は先読みの 47% が当たりましたが、EAGLE3 なしより遅くなりました。先読み用のモデルが VRAM を使うぶん、本体の重みをより多く RAM に置くことになったためだと考えています(筆者の見立て)。
RAM が足りない人へ
今回は RAM 128GB の PC だけで試しました。gpt-oss-120b はファイルだけで 63GB あるので、RAM 64GB の PC は試していません。Windows やほかのアプリのぶんを考えると、余裕がない可能性があります(筆者の見立て)。RAM を増やせないときは、小さい gpt-oss-20b(約12GB)が現実的です。
第三者の報告(Hugging Face のデータセット、2026年6月3日付)に、RAM 64GB(DDR5-5600)・RTX 5090・Ubuntu で、--n-cpu-moe 20 と -ngl 99 の設定を llama-bench で測り、生成 46.5 トークン/秒(tg128)とあります。OS・測り方・設定が違うので、この記事の速さとは並べません。この記事では 64GB は試していません。
よくある質問(FAQ)
Q. gpt-oss-120b は RTX 5090 で動きますか?
動きました。VRAM 32GB には入りきりませんが、llama.cpp が残りを RAM に置いて、今回の条件で約29トークン/秒出ました(RAM 128GB の PC)。
Q. gpt-oss-120b に必要なメモリはどれくらいですか?
モデルのファイルが 63.39GB あります。VRAM と RAM を合わせて 80GB 以上、RAM は 96GB 以上が目安です(筆者の見立て)。
Q. RAM 64GB で動きますか?
今回は試していません。ファイルだけで 63GB あるので、Windows やほかのアプリのぶんを考えると、余裕がない可能性があります(筆者の見立て)。
Q. gpt-oss-120b は商用利用できますか?
ライセンスは Apache-2.0 で、商用利用もできます。
Q. gpt-oss-20b とどちらがいいですか?
手軽さと速さは 20b です。大きいモデルを試したいなら 120b で、RAM が 96GB 以上あれば今回くらいの速さで動きます。答えの質の比較はしていません。
Q. LM Studio でも動きますか?
今回は llama.cpp 単体でだけ試しました。LM Studio での速さは測っていません。
まとめ
gpt-oss-120b は、RTX 5090 と RAM 128GB の PC で、llama.cpp を使って約29トークン/秒で動きました(今回のテスト条件で)。VRAM より RAM の量が大事なモデルなので、これから PC を組むなら、GPU と一緒に RAM 96〜128GB を考えておくと、120B クラスのモデルも試せます。
検証メモ
- RAM 64GB:試していません。ファイルだけで 63GB あるので、Windows やほかのアプリのぶんを考えると余裕がない可能性があります(筆者の見立て)。
--n-cpu-moe:24 だけ試しました。ほかの値は試していません。- VRAM が 32GB より少ない GPU:エキスパートを CPU 側に置く量を増やせば動く可能性はありますが、今回は測っていません。
- 答えの質:gpt-oss-20b との比較はしていません。LM Studio での速さも測っていません。