Qwen3.8-27B は、Qwen が公開している 270億パラメータの言語モデルです。日本語も得意で、RTX 5090(VRAM 32GB)なら 4ビットの量子化版がまるごと VRAM に入ります。
llama.cpp には、モデルの中にある「先読み用の頭(MTP)」を使って、1回に何トークンかまとめて出す機能があります。オプションを1つ足すだけで動くので、RTX 5090 でどれくらい変わるかを測りました。
比べたのは、MTP あり・なしの速さ、先読みの数、Q6_K と 128k の場合です。機能そのものは新しくありません。llama.cpp の MTP 対応は2026年5月に入り(PR #22673)、Qwen3.8 の MTP 付き GGUF は8月に出ました。
試した環境
| 項目 | 内容 |
|---|---|
| GPU | NVIDIA GeForce RTX 5090(VRAM 32GB) |
| CPU / メモリ | AMD Ryzen 9 9950X3D / 128GB |
| OS | Windows 11 |
| ドライバ | NVIDIA 621.01 |
| llama.cpp | b12002(公式の Windows 用 CUDA 13.4 版、2026-10-30) |
| モデル | unsloth/Qwen3.8-27B-GGUF の UD-Q4_K_M・UD-Q6_K |
| 確認した日 | 2026年10月31日 |
測っている間は、ComfyUI など GPU を使うほかのソフトは止めました。
MTP は先の数トークンを予想して、まとめて確かめる
ふつうの LLM は、1回の計算で1トークン(文字のかたまり)ずつ文章を作ります。MTP に対応したモデルは、本体とは別に「この先の数トークンを予想する小さな頭」を持っています。
llama.cpp の draft-mtp は、この頭で先の数トークンを予想して、本体でまとめて確かめる方式です。予想が当たったぶんだけ一度に進むので、速くなる仕組み。外れた予想は本体が確かめて捨てるので、でたらめな文章にはなりません(llama.cpp の公式ドキュメント)。
必要なファイル
| ファイル | サイズ | メモ |
|---|---|---|
| Qwen3.8-27B-UD-Q4_K_M.gguf | 16.46GB | 今回のおすすめ。RTX 5090 なら 128k でも VRAM に入った |
| Qwen3.8-27B-UD-Q5_K_XL.gguf | 20.88GB | 今回は試していない |
| Qwen3.8-27B-UD-Q6_K.gguf | 21.98GB | 32k なら入った(ほかのアプリを閉じた状態) |
| Qwen3.8-27B-Q8_0.gguf | 29.05GB | 今回は試していない。32GB では余裕がない |
| MTP/mtp-Qwen3.8-27B-Q4_0.gguf | 1.37GB | MTP の頭だけのファイル。今回の GGUF では不要だった |
llama.cpp は 公式のリリースページ から、Windows の CUDA 版(llama-b〇〇〇〇-bin-win-cuda-13.4-x64.zip)と、同じページの cudart-llama-bin-win-cuda-13.4-x64.zip の2つを落として、同じフォルダに展開します。
起動のしかた
コマンドプロンプトで、llama.cpp を展開したフォルダに移動して、次のように起動します。違いは最後の --spec-type draft-mtp だけです。
rem MTP なし
llama-server.exe -m Qwen3.8-27B-UD-Q4_K_M.gguf -ngl 99 -fa on -c 32768 --port 8080

rem MTP あり
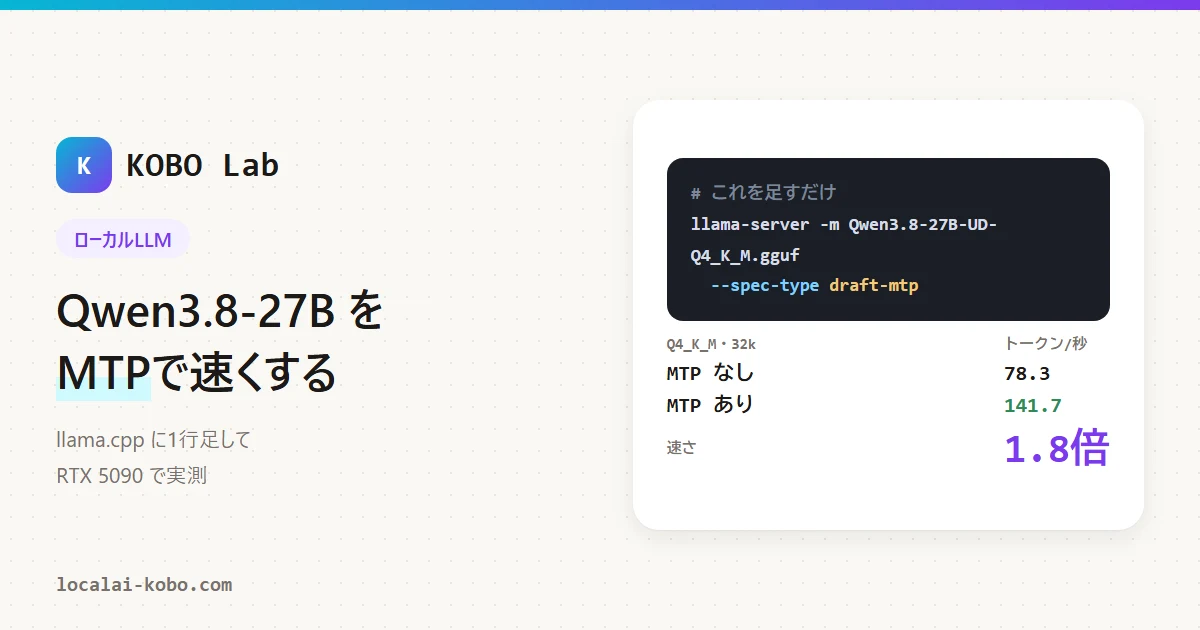
llama-server.exe -m Qwen3.8-27B-UD-Q4_K_M.gguf -ngl 99 -fa on -c 32768 --port 8080 --spec-type draft-mtp
-ngl 99:モデルを全部 GPU に載せる-fa on:Flash Attention(速くて省メモリな計算方法)を使う-c 32768:コンテキスト(一度に扱える長さ)を 32k トークンにする--spec-type draft-mtp:モデルの中の MTP の頭で先読みする
起動したら、ブラウザで http://127.0.0.1:8080 を開くとチャット画面が使えます。OpenAI 互換の API にもなるので、Hermes Agent や Claude Code からもつなげます。
RTX 5090 での速さ(実測)
日本語の説明・英語のコード・日本語の手順説明の3種類の指示で、それぞれ 512 トークン出すのにかかった速さを測りました。温度 0(毎回同じ答えになる設定)で、2回目以降の平均です。
| 設定(Q4_K_M・32k) | 生成の速さ(トークン/秒) | MTP なしと比べて | 先読みが当たった割合 | VRAM 最大 |
|---|---|---|---|---|
| MTP なし | 78.3 | 1.00倍 | — | 18.2GB |
| MTP あり(先読み 2) | 135.1 | 1.73倍 | 67% | 20.0GB |
| MTP あり(先読み 3=既定) | 141.7 | 1.81倍 | 57% | 20.6GB |
| MTP あり(先読み 5) | 124.6 | 1.59倍 | 37% | 21.8GB |
| MTP あり(頭を別ファイルで指定) | 145.7 | 1.86倍 | 56% | 21.4GB |
「先読みが当たった割合」は、予想したトークンのうち、本体の確認で採用されたものの割合です。コードの指示のほうが当たりやすく、速くなりました(指示ごとの値は下の表)。
先読みの数について、Unsloth の説明は、1〜6 を試して自分の環境でいちばん速い値を選ぶ、です。第三者の note の報告(WSL2、UD-Q5_K_XL、各1回)では、2・3・4・6 の中で 3 がいちばん速かったとあります。環境が違うので、速さの数字は並べません。
| 指示 | MTP なし | MTP あり(先読み 3) | 当たった割合 |
|---|---|---|---|
| 日本語の説明 | 78.8 | 123.8 | 46% |
| 英語のコード | 77.7 | 160.7 | 70% |
| 日本語の手順 | 78.3 | 140.7 | 58% |
Q6_K と長いコンテキスト
| 設定 | 生成の速さ(トークン/秒) | VRAM 最大 |
|---|---|---|
| Q6_K・32k・MTP なし | 62.2 | 23.1GB |
| Q6_K・32k・MTP あり | 106.7 | 25.4GB |
| Q6_K・16k・MTP あり | 106.6 | 24.4GB |
| Q4_K_M・128k・MTP あり・KV キャッシュ q8_0 | 118.9 | 23.8GB |
同じ Q6_K・32k・MTP なしでも、壁紙アプリなどで VRAM が約9GB 埋まっていたときは 25.7 トークン/秒しか出ませんでした(アプリを閉じると 62.2)。最初に測ったのがこの状態で、Q4_K_M も MTP なし 59.7、MTP あり 108.4 トークン/秒止まりでした。
VRAM がいっぱいになると、Windows が足りないぶんを PC のメモリ(共有 GPU メモリ)に逃がすため、急に遅くなります。速さが急に落ちたら、ほかのアプリを閉じるか、コンテキストを短くするか、ひとつ小さい量子化にしてください。
-ctk q8_0 -ctv q8_0 は、会話の履歴を置く KV キャッシュを 8ビットにして VRAM を節約するオプションです。
MTP が効かない・遅くなるときのチェック
- 速さがまったく変わらないときは、その GGUF に MTP の頭が入っていない可能性がある。
-mdで MTP のファイル(MTP フォルダの GGUF)を指定する - VRAM があふれていないか。MTP は約2GB 余分に使う(Unsloth の説明)。今回の実測では、既定の先読み3で約2.4GB 増えたので、ぎりぎりのときは遅くなる
- llama.cpp が古くないか。
--spec-typeがないと言われたら新しい版にする - 温度を高くすると先読みが外れやすくなる。速さを比べるときは温度 0 で比べる
RTX 5090 以外の人へ
今回は RTX 5090 だけで測りました。ほかの GPU の速さは測っていません。目安になるのは「モデルのファイルサイズ+コンテキストのぶん+MTP のぶん(約2GB。今回の先読み3では約2.4GB)が VRAM に入るか」です。
| VRAM | 目安(筆者の見立て) |
|---|---|
| 32GB(RTX 5090) | Q4_K_M なら 128k でも入った(実測 23.8GB) |
| 24GB | Q4_K_M(16.5GB)+短めのコンテキストなら入る計算。実測はしていない |
| 16GB 以下 | Q4_K_M は入りきらない。IQ3 系(11〜12GB)など、もっと小さい量子化を選ぶ。実測はしていない |
GPU とメモリの選び方は ComfyUI に必要な PC スペック でも説明しています。LLM と画像生成を同時に動かすときの VRAM の取り合いは ComfyUI と LM Studio を同時に使う を見てください。
よくある質問(FAQ)
Q. llama.cpp の MTP はどう使いますか?
llama-server の起動オプションに --spec-type draft-mtp を足します。MTP の頭が入った GGUF なら、それだけで動きます。
Q. Qwen3.8-27B は RTX 5090 で何トークン/秒出ますか?
今回の条件(Q4_K_M・32k・llama.cpp b12002)では、MTP なしで 78.3、MTP ありで 141.7 トークン/秒でした。
Q. MTP を使うと答えの中身は変わりますか?
同じ文章になるとは限りません。先読みした内容は本体が確かめてから採用しますが、筆者の測定では、同じ指示でも日本語の説明の出力が 972 トークンから 793 トークンに変わりました。繰り返しなどの崩れは、どの条件でも出ていません。
Q. MTP 用のファイルは別に必要ですか?
unsloth の Qwen3.8-27B の GGUF では不要でした。MTP の頭が入っていない GGUF のときは、MTP フォルダのファイルを -md で指定します。
Q. Qwen3.8-27B に必要な VRAM は?
Q4_K_M のファイルは 16.46GB で、32k のコンテキストと MTP を足すと、RTX 5090 で VRAM を 20.6GBほど使いました(GPU 全体の使用量。Windows の画面表示などのぶんを含む)。
Q. LM Studio でも MTP は使えますか?
今回は llama.cpp 単体でだけ試しました。LM Studio での設定は確かめていません。LM Studio の Bionic の変更履歴(Bionic 1.1.3、2026年9月17日)に「MTP speculative decoding for more compatible models」という項目があります。Qwen3.8 で使えるか、設定方法は未確認です。
まとめ
Qwen3.8-27B は、llama.cpp に --spec-type draft-mtp を足すだけで、RTX 5090 で 78.3 → 141.7 トークン/秒(約1.8倍)になりました(今回のテスト条件で)。出力の長さが変わることはありましたが、繰り返しなどの崩れは出なかったので、Qwen3.8 を llama.cpp で使うなら、つけておいて損はない設定です。
検証メモ
- 同時に使う数:
-np(--parallel)は指定していません(llama.cpp の標準は自動)。起動ログのスロット数は 4(n_slots = 4)で、測定は1回に1つの質問だけを送りました。 - 複数の質問を同時に処理するとき:MTP 対応の PR(#22673)には「並列実行の MTP は対応済みだが、まだ十分に最適化されていない」という注記があります。この使い方では速さが変わる可能性があり、今回は測っていません。
- 当たった割合の計算:全体の割合は、予想した総数に対して当たった数で計算しています(指示ごとの割合の単純平均とは少し違います)。
- 別の指示で測り直した値:同じ日の夜に、指示4種類(日本語3・英語コード1)、最大 1024 トークン、ほかのアプリを閉じた状態で測り直しました。Q4_K_M の MTP なしが約74〜77、MTP ありが日本語で約113〜132、英語コードで約184〜189 トークン/秒でした。指示が違うので本文の表とは並べません。このとき Q8_0(MTP なし)も動かし、約48〜49 トークン/秒でした。