この記事について(広告・アフィリエイトリンクはありません)
Kensaku は無料(MIT)で、アカウントもクラウドも使いません。今回はポータブル版を、試験用のフォルダーだけに向けて試しました。
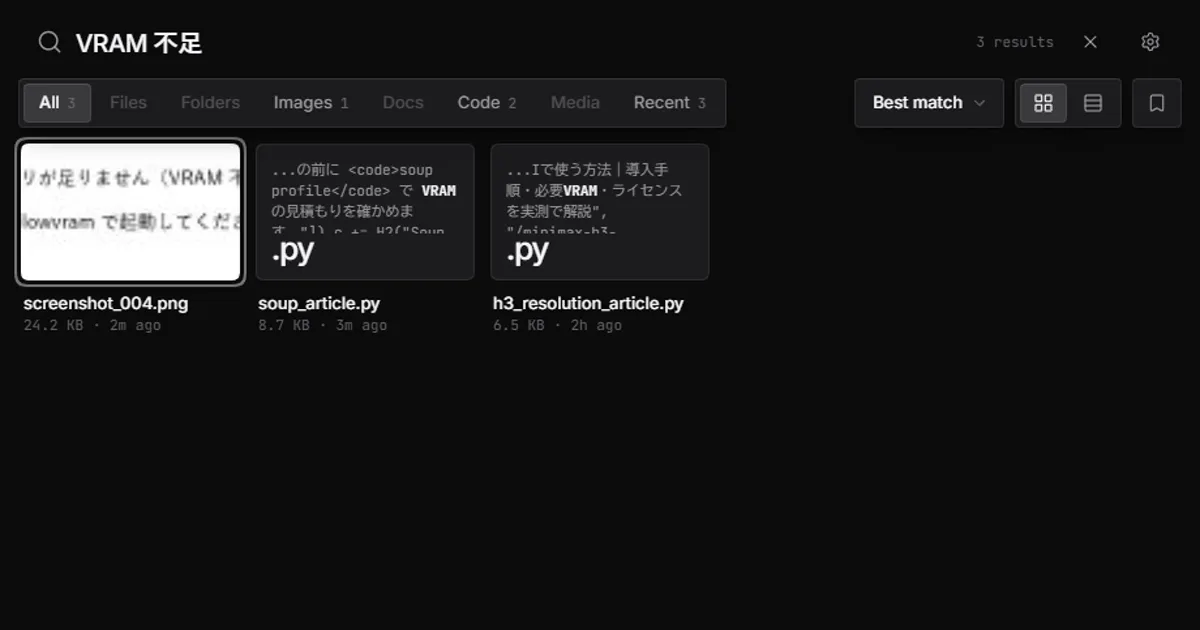
Kensaku は、ファイル名だけでなく、ファイルの中身やスクリーンショットの文字まで、PC の中だけで探せるランチャーです。日本語のエラー画面のスクリーンショットも、文字認識(OCR)で「VRAM 不足」「商用利用」などの言葉で見つかりました。
検索は1回 7〜90ミリ秒でした。一方で、言い換え(「メモリが足りない」で「VRAM 不足」を探すなど)はうまく当たりませんでした。所要時間は15分ほど、難しさは初心者向けです。
先に結論(今回のテスト条件で)
| 検索した言葉 | 見つかったもの |
|---|---|
| VRAM 不足 | 日本語のエラー画面のスクリーンショット(1位)と、文中に VRAM がある .py |
| shape is invalid | エラーのスクリーンショット(1位)と、それを説明した .py |
| 商用利用 | ライセンスの画面のスクリーンショット(日本語) |
| 32の倍数 | その言葉がある .py |
| メモリが足りない(言い換え) | 見つからない |
| out of memory(英語で言い換え) | 見つからない |
試験用のフォルダー(.py 3つ、PNG のスクリーンショット4枚)で、索引作りは数秒で終わりました。時間は kensaku-cli の表示(search_time_ms)とコマンド全体の時間です。
Kensaku とは?
yjid/kensaku は、Rust で書かれたローカル検索のランチャーです(MIT)。2026年11月7日時点でスターは約1,200で、11月6日に 1.0.16 が出ています。
ファイル名、文書やコードの中身、画像の中の文字(OCR)、意味の近さ(埋め込み)で探せます。README では、使用データの送信もアカウントもなく、外への通信は更新の確認とモデルのダウンロードだけとされています。AI エージェントから使う MCP サーバーもあります。
導入と最初の設定
GitHub のリリースから、インストーラー(13.6MB)、MSI、ポータブル版(19.6MB)、コマンド版(kensaku-cli)を選べます。今回はポータブル版を使いました。設定と索引は、exe の隣の data フォルダーに入ります。
起動すると3つの手順があります。
- 探すフォルダー:Documents や Downloads が候補に出ます。今回は試験用のフォルダーだけを入れました
- 画像の文字の読み取り:PP-OCRv6(おすすめ、約6MB、入っていた)、Indra OCR(約27MB、80以上の言語)、Tesseract から選びます
- 開き方:ふつうのウィンドウか、Alt+Space で開くランチャー
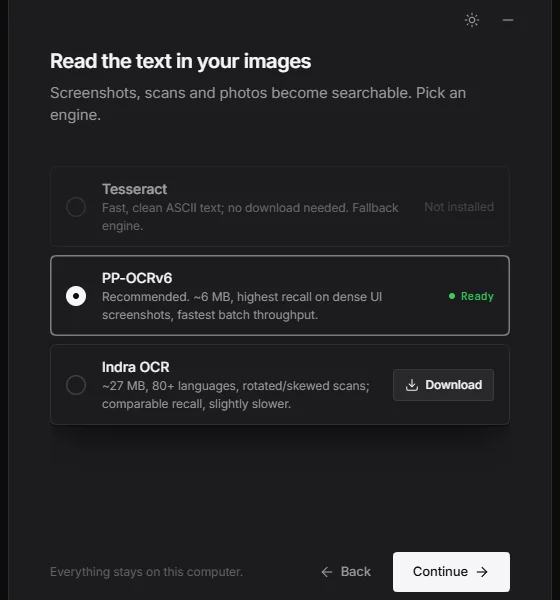
今回、開き方の選択がうまく反映されず、ランチャー(Alt+Space)になりました。Alt+Space は Windows のウィンドウのメニューにも使われるので、気になる人は設定で変えてください。
探してみる
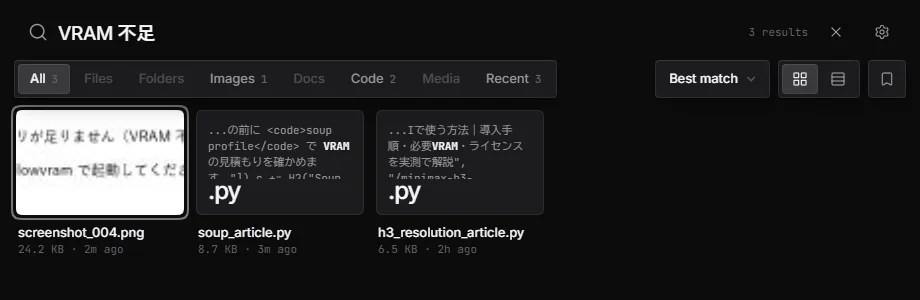
「VRAM 不足」では、日本語で「エラー: CUDA のメモリが足りません(VRAM 不足)」と書いたスクリーンショットが1位に出ました。英語の「shape is invalid」も、エラーのスクリーンショットが1位でした。画像の中の日本語も、ちゃんと読めています。
一方で、言い換えの「メモリが足りない」「out of memory」では見つかりませんでした。意味の検索に使われていたのは potion-base-8M という小さな英語向けの埋め込みモデルで、日本語の言い換えまでは届かないようです。
コマンドと MCP
kensaku-cli search "VRAM 不足" --limit 3 --json
kensaku-cli state
kensaku-cli mcp
kensaku-cli は、アプリが作った索引をコマンドで検索します。ポータブル版の索引を使うには、kensaku-cli.exe をポータブル版の kensaku.exe と同じフォルダーに置きます。
kensaku-cli mcp は MCP サーバーとして動き、search、read_snippet、regex_search、find_symbol、index_state、health_check の道具を出しました。README では、読み取り専用で、資格情報のファイルは返さないとされています。Claude Code などへの登録(connect)は、設定を書き換えるため今回は行っていません。
よくある質問(FAQ)
Q. Kensaku とは?
ファイル名、中身、画像の中の文字まで、PC の中だけで探せる無料の検索ランチャーです。AI エージェント用の MCP サーバーもあります。
Q. スクリーンショットの日本語も探せる?
探せました。PP-OCRv6 で、日本語のエラー画面の「VRAM 不足」や「商用利用」が見つかりました。
Q. 言い換えでも見つかる?
今回は、日本語・英語とも言い換えでは見つかりませんでした。書かれている言葉で探すのが確実です。
まとめ
Kensaku は、スクリーンショットの中の文字まで一瞬で探せるのが強みでした。言い換えの検索はまだ弱いので、エラーの文などそのままの言葉で探す使い方に向いています。
探すフォルダーを絞って、エラーの文そのままで探す。
検証メモ
- 素材:当サイトの記事を作ったスクリプト(.py)3つと、記事の画像から作った PNG 4枚(英語と日本語のエラー画面、日本語のライセンス画面)。
- 操作:アプリの画面を、WebView2 のリモートデバッグで操作しました。検索の結果は kensaku-cli の JSON 出力で確かめました。
- 試していないこと:大きなフォルダー(数万ファイル)での索引の時間、PDF・Office 文書、Indra OCR、MCP を Claude Code に登録しての利用、Doctor(自己修復)の機能。