こまたろ

ComfyUI

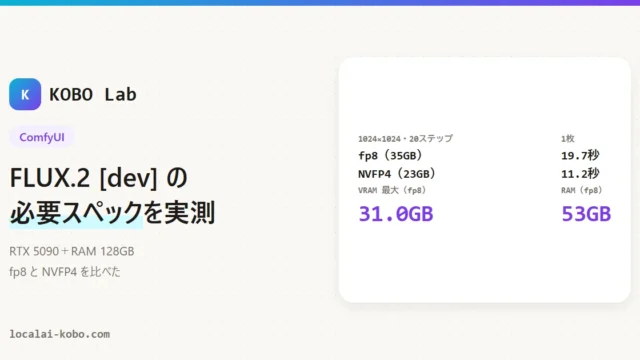
FLUX.2 [dev]の必要スペックをRTX 5090で実測|fp8とNVFP4の違い

FLUX.2 [dev] を ComfyUI で、RTX 5090(VRAM 32GB)と RAM 128GB の PC で動かしました。1024×1024 は fp8 で約19.7秒、NVFP4 で約11.2秒。必要なファイルと容量、VRAM と RAM、少ない VRAM を想定した簡易テスト。
ComfyUI
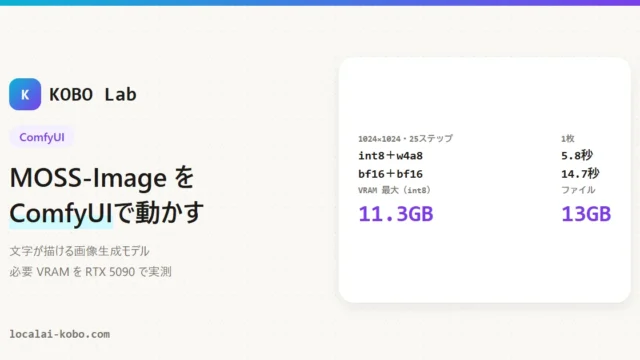
MOSS-ImageをComfyUIで動かす|必要VRAMと生成時間をRTX 5090で実測

文字が描ける画像生成モデル MOSS-Image を ComfyUI の公式テンプレートで動かしました。RTX 5090 で int8 版の 1024×1024 が約5.8秒。必要なファイルと置き場所、VRAM、小型エンコーダーの位置づけ。
PC・GPU環境

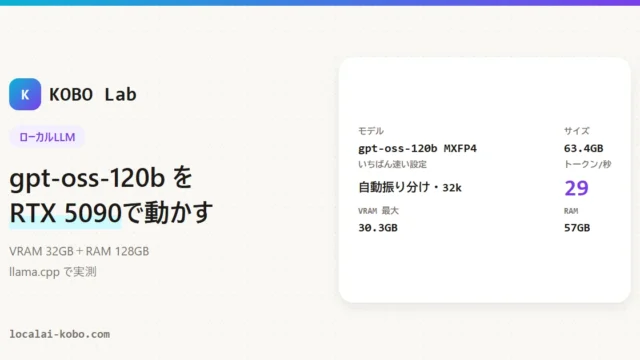
gpt-oss-120bはRTX 5090とRAM 128GBで動く?llama.cppで実測

OpenAI の gpt-oss-120b(63GB)を、RTX 5090(VRAM 32GB)と RAM 128GB の PC で llama.cpp を使って動かしました。いちばん速い設定で約29トークン/秒。必要なメモリ、起動コマンド、振り分けの比較。
PC・GPU環境

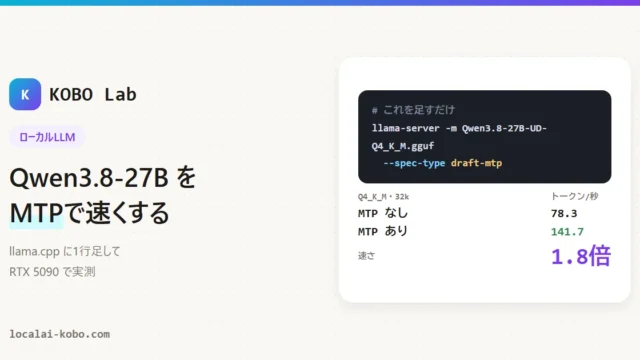
Qwen3.8-27Bをllama.cppのMTPで速くする設定【RTX 5090実測】

Qwen3.8-27B を llama.cpp で動かすとき、--spec-type draft-mtp を足すだけで RTX 5090 で 78→142 トークン/秒(約1.8倍)になりました。起動コマンド、先読み数の比較、Q6_K と128k の結果、効かないときのチェック。
AI動画・プロンプト

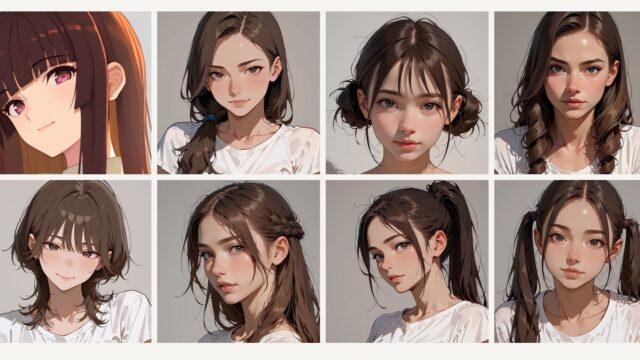
AIイラストの髪型プロンプト20選|髪色・前髪も画像から探してコピペ【2026年版】

コピーしてそのまま使える髪型プロンプトを20種類、髪色12色・前髪6種類と合わせて生成画像つきでまとめました。Anima・Illustrious XL・SDXL で5枚ずつ試した結果と、うまく出ないときの対処法も載せています。
ローカルLLM

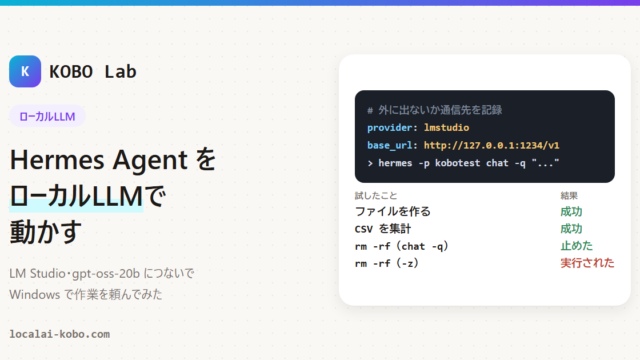
Hermes AgentをローカルLLMで動かす方法|LM Studio×gpt-oss-20bで実際に試した【Windows】

Hermes AgentをLM Studioのgpt-oss-20bで動かした実測。通信先・VRAM・危ないコマンドの扱いも確認。
AI動画・プロンプト

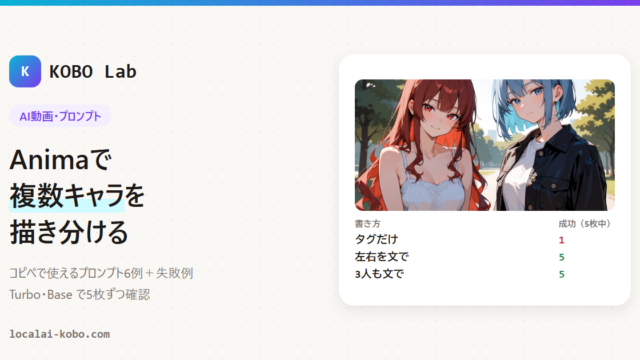
Animaで複数キャラを描き分けるプロンプト6選|コピペ用と生成画像【2026年版】

Animaで2人・3人を描き分けるプロンプト集。タグだけと文で書く方法をTurbo・Baseで5枚ずつ比較。
ComfyUI

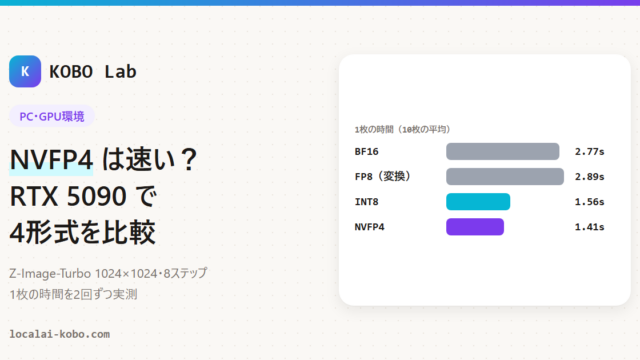
ComfyUIのNVFP4は速い?RTX 5090でFP8・INT8・BF16と比較【Z-Image-Turbo実測】

Z-Image-TurboでNVFP4・INT8・FP8・BF16をRTX 5090で実測比較。速さ・VRAM・画像の違い。
ComfyUI

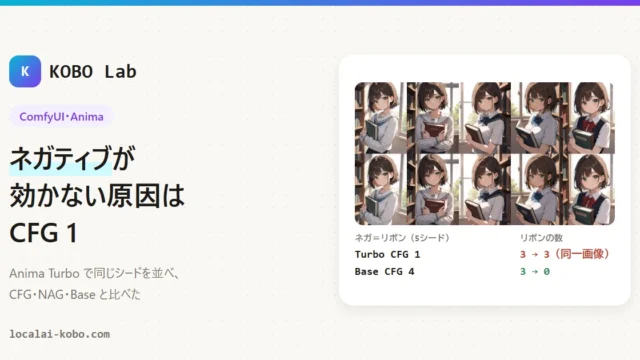
ComfyUIでネガティブプロンプトが効かない原因はCFG 1|Anima TurboとNAGで検証【2026年版】

CFG 1ではネガティブが使われません。Anima TurboでCFG・NAG・Baseを同じシードで比べた結果です。
ComfyUI

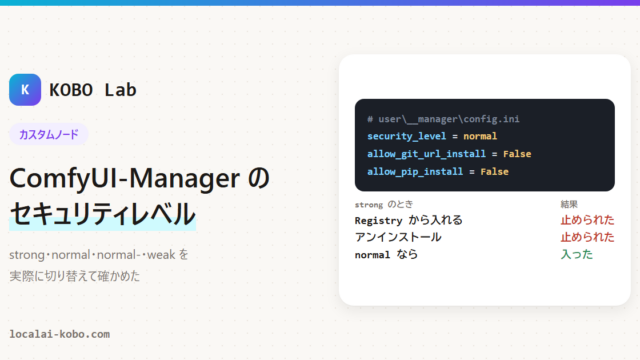
ComfyUI-Managerのセキュリティレベルとは?カスタムノードを安全に入れる確認手順【2026年版】

ComfyUI-Managerのセキュリティレベルを実際に切り替えて確認。カスタムノードを入れる前の安全チェックも。