Anima に日本語のセリフを描かせるなら、CJK Vocab Pack という追加データを足すと、短い一言まで描けるようになります。
標準の Anima では、日本語らしい文字は出ても、頼んだ文字にはなりません。この記事では吹き出しの中にセリフを描く手順を紹介します。
ComfyUI で 82 枚を生成して確かめた結果も、うまくいかなかった例ごと載せました。測定の範囲や条件は末尾の「検証メモ」にまとめています。
結論:短い言葉は描けるが、長い文はまだ崩れる
- 標準の Anima では、4 枚とも頼んだセリフにはならず、日本語らしい無関係の文字が描かれました。
- Vocab Pack を使うと、「おはよう!」や「何言ってるの?」のような短いセリフは、4 枚中 1〜2 枚で正しく描けました。残りも一部の文字は合っています。
- 10 文字の「今日はいい天気ですね」は、4 枚とも途中が崩れました。学習されていない漢字(例:薔薇)は描けません。
英語だけのプロンプトには影響しないので、パックを入れたままでも、いつもの絵はそのまま出ます。
「吹き出しの中に短い一言を入れたい」という用途なら試す価値があります。長い文章を正確に描きたいときは、今のところ画像編集ソフトで後から入れる方が確実です。
検証した環境
| GPU | NVIDIA GeForce RTX 5090(32GB) |
| OS | Windows 11 |
| ComfyUI | v0.43.0(ポータブル版) |
| カスタムノード | ComfyUI-Anima_lora-Adapter 3.15.0 |
| モデル | anima-base-v1.0、anima_jp_extended、anima-turbo-v1.1 |
| Vocab Pack | anima_cjk_vocab_pack_jp_v1 |
| 検証日 | 2026年10月29日 |
なぜ標準の Anima は指定した日本語を描けないのか
画像生成モデルは、プロンプトの文字を「トークン」という番号に分けてから読み取ります。配布元の説明によると、Anima のテキスト側の仕組み(T5 のトークナイザー)には日本語の文字に割り当てる番号がありません。そのため、プロンプトに日本語を書いても、モデルにはその文字の形が伝わりません。
CJK Vocab Pack は、この足りない部分を補うデータです。ひらがな 81 字、カタカナ 82 字、漢字 1,410 字の計 1,573 字ぶんの情報を追加します。LoRA とは別物で、LoRA 用のローダーでは読み込めません。
使い方は2通り(結果はまったく同じ)
| 方法 | 使うもの | 向いている人 |
|---|---|---|
| A. 統合済みモデルを使う | anima_jp_extended(約4.47GB)+ Anima Merged Loader (CJK) ノード | これから Anima を始める人 |
| B. 手持ちの Anima にパックを足す | anima-base-v1.0 + Vocab Pack(約285MB)+ Anima Vocab Pack Loader (CJK) ノード | anima-base-v1.0 をすでに持っている人 |
anima_jp_extended は、anima-base-v1.0 にこのパックをあらかじめ組み込んだモデルです。実際に同じプロンプトと同じシードで 24 組を作って比べたところ、A と B の画像はピクセル単位で完全に一致しました。どちらを選んでも結果は変わらないので、ダウンロード量の少ない B から試すのがおすすめです。
必要なファイルと置き場所
| ファイル | 置き場所 | 入手先 |
|---|---|---|
| anima_jp_extended.safetensors(方法A) | ComfyUI/models/diffusion_models/ | Hugging Face:sorryhyun/anima-jp-extended |
| anima_cjk_vocab_pack_jp_v1.safetensors と同名の .json(方法B) | ComfyUI/models/vocab_packs/ | Hugging Face:sorryhyun/anima-vocab-pack-cjk |
| qwen_3_06b_base.safetensors(テキストエンコーダー) | ComfyUI/models/text_encoders/ | Hugging Face:circlestone-labs/Anima |
| qwen_image_vae.safetensors(VAE) | ComfyUI/models/vae/ | 同上 |
方法Bでは、.safetensors と .json の2つを必ず同じフォルダーに置いてください。片方だけでは動きません。テキストエンコーダーと VAE は通常の Anima と同じものです。すでに Anima を使っている人は追加のダウンロードは要りません。
導入手順
手順1:カスタムノードを入れる
ComfyUI の custom_nodes フォルダーで次のコマンドを実行します(配布元によると ComfyUI Manager からも入れられます。今回は git clone で入れました)。バージョン 3.15.0 以上が必要です(Merged Loader は 3.15.0 で追加されました)。追加の Python パッケージは要りません。
cd ComfyUI/custom_nodes
git clone https://github.com/sorryhyun/ComfyUI-Anima_lora-Adapter
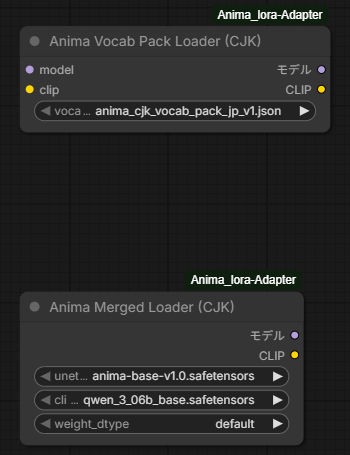
インストール後に ComfyUI を再起動すると、ローダーの中に「Anima Merged Loader (CJK)」と「Anima Vocab Pack Loader (CJK)」が出てきます。
KOBO Lab ではノードを入れる前にコードを読み、外部への通信やプログラムの実行など、気になる処理がないことを確認しました。カスタムノードの基本的な入れ方はカスタムノードの入れ方で解説しています。
手順2:ワークフローを組む
方法Aでは、通常の「Load Diffusion Model(UNET)」と「Load CLIP」の2つを、Anima Merged Loader (CJK) 1つに置き換えます。このノードは MODEL と CLIP の両方を出すので、両方を先につなぎます。
方法Bでは、通常どおりモデルと CLIP を読み込んだあとに Anima Vocab Pack Loader (CJK) をはさむ形です。こちらも MODEL と CLIP の両方を通してください。
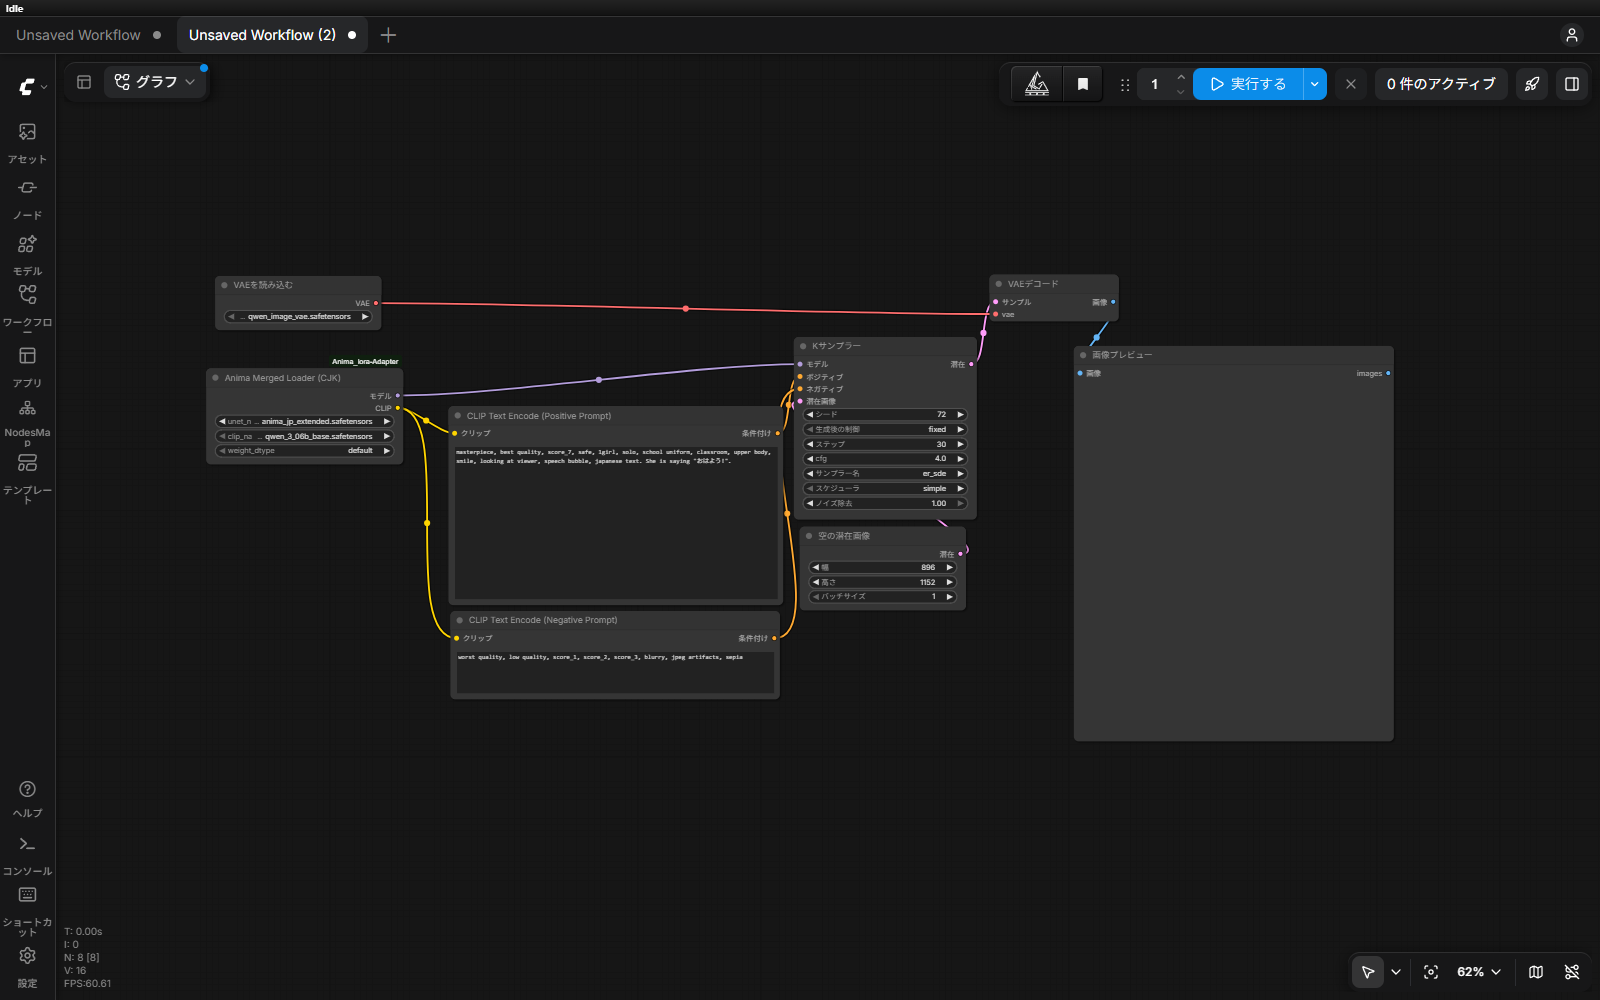
今回は配布元のワークフロー(anima-jp-extended のページの workflows/anima_jp_extended.json)をそのまま使いました。ComfyUI の画面にドラッグすると読み込めます。配布ワークフローは VAE の読み込みに KJNodes のノードを使っています。KJNodes が入っていない場合は、標準の「Load VAE」ノードに置き換えてください。
つまずきやすい点
- Vocab Pack Loader の選択肢に .json も出る:パックを置いた直後は .json が初期値で選ばれていました。.safetensors の方を選んでください。
- 通常の UNET ローダーでも anima_jp_extended は読み込めてしまう:その場合は日本語に対応しない、ふつうの Anima として動きます。ログに「unet unexpected」と1行出るのが目印です。
- 古いノードでは新しいパックを読めない:jp_v1 パックにはノード 3.14.0 以上が必要です。
プロンプトの書き方
配布元が勧める書き方は、英語の文の中に、描きたい日本語をダブルクォーテーションで入れる形です。ほかのタグは英語で書きます。
1girl, solo, speech bubble. Text reads as "何言ってるの?".「猫耳」「銀髪」のように、タグを日本語で書くのはおすすめしません。実際に試したところ、パックなしでもパックありでも猫耳と銀髪は反映されず、パックありでは漢字のような模様が描かれて絵柄も大きく変わりました。英語の cat ears、silver hair に直すと、どちらもきちんと出ました。モデルの配布ページにも「日本語のタグは想定した使い方ではない」と書かれています。
なお、タグではなく日本語の文章で絵の内容を書いた場合も、内容はほとんど反映されませんでした(詳しくは下の検証)。
検証:5種類のセリフを4シードずつ描かせた結果
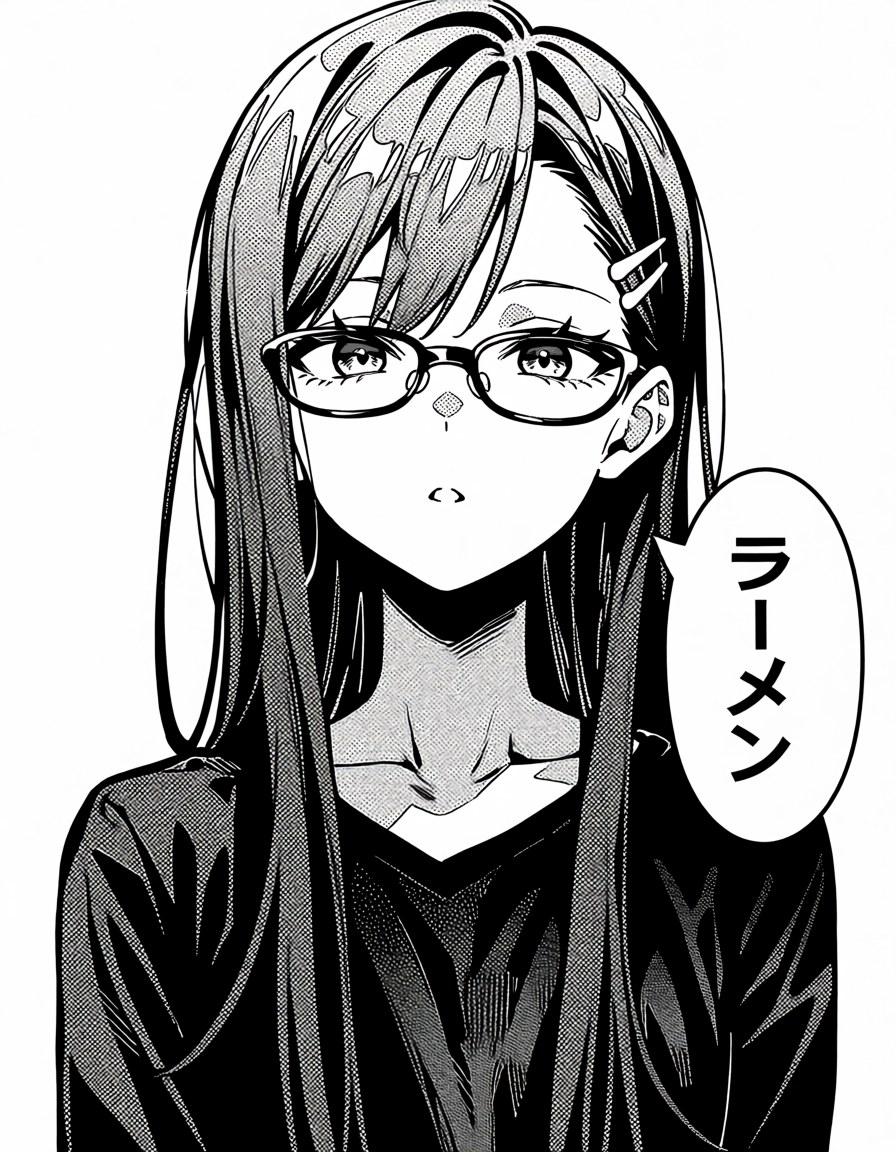
最初に配布ワークフローの設定で1枚だけ(シード72)作ったときは、吹き出しは出たものの、文字は「何1 / 〒言言 って / るるるの?」でした。1枚では判断できないので、シードを4つに増やして比べています。
同じプロンプトとシード(1〜4)で、「パックなし(anima-base-v1.0)」と「パックあり」を比べました。生成設定は配布ワークフローのままです(896×1152、30ステップ、CFG 4、サンプラー er_sde、スケジューラー simple)。文字が読めたかどうかは目で見て、次の3段階で判定しました。
- 完全一致:指定した文字列がそのまま読める
- 一部一致:一部の文字は合っているが、抜け・重複・崩れがある
- 崩れ:指定した文字列として読めない
| セリフ | パックなし(4枚) | パックあり(4枚) | メモ |
|---|---|---|---|
| おはよう! | 崩れ 4 | 完全一致 2/一部一致 2 | 「おはよ♪う!」など |
| ラーメン | 崩れ 4 | 一部一致 4 | 「ラーメ」「ラーメメン」など |
| 何言ってるの? | 崩れ 4 | 完全一致 1/一部一致 3 | 完全一致の1枚も、吹き出しの外に関係ない字が2つ出た |
| 今日はいい天気ですね | 崩れ 4 | 一部一致 4 | 「天気」は一度も出なかった |
| 薔薇 | 崩れ 4 | 崩れ 4 | 2文字ともパックに含まれない漢字 |
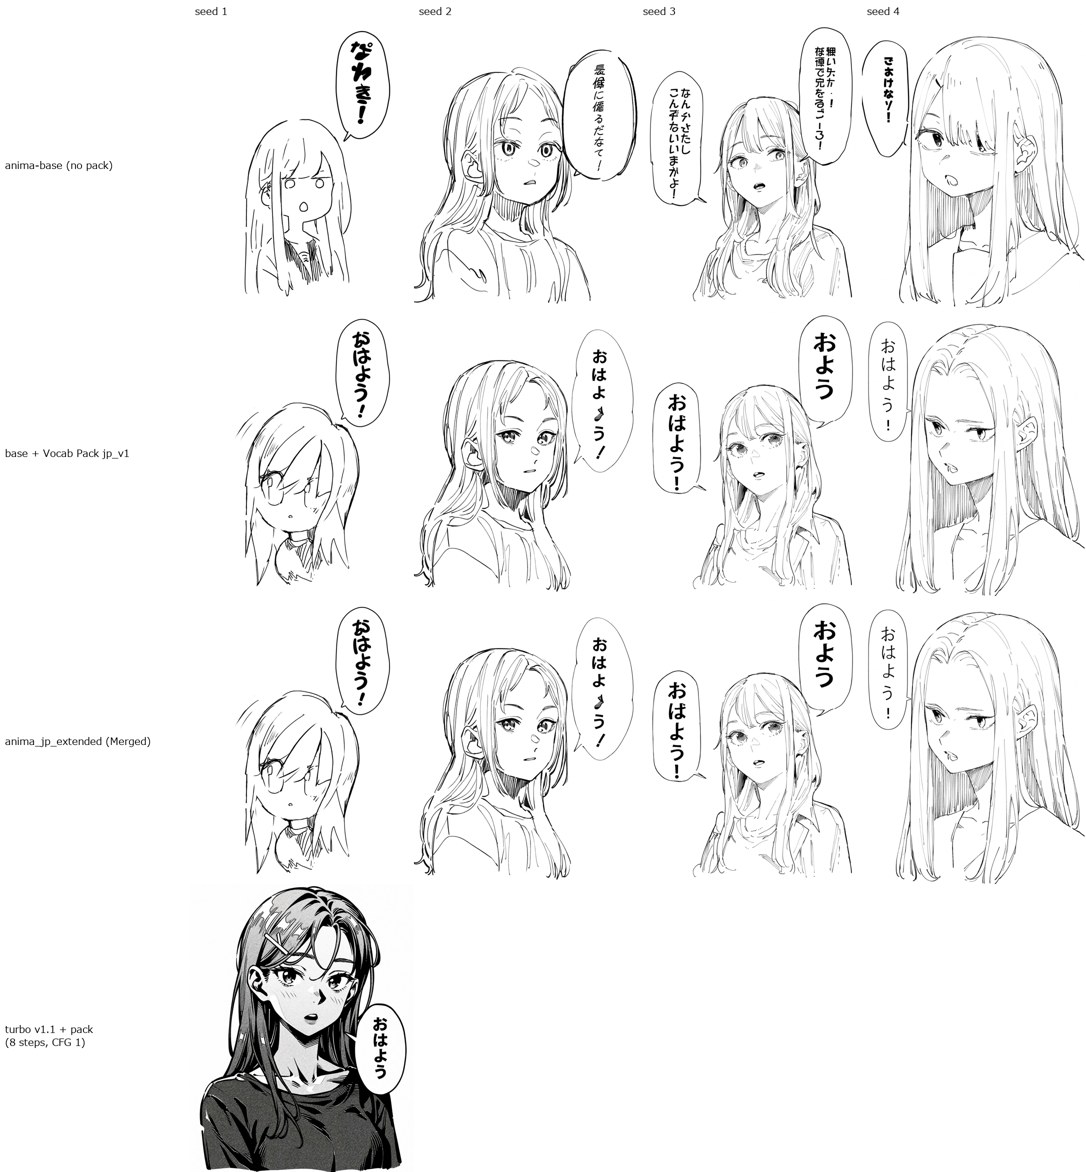
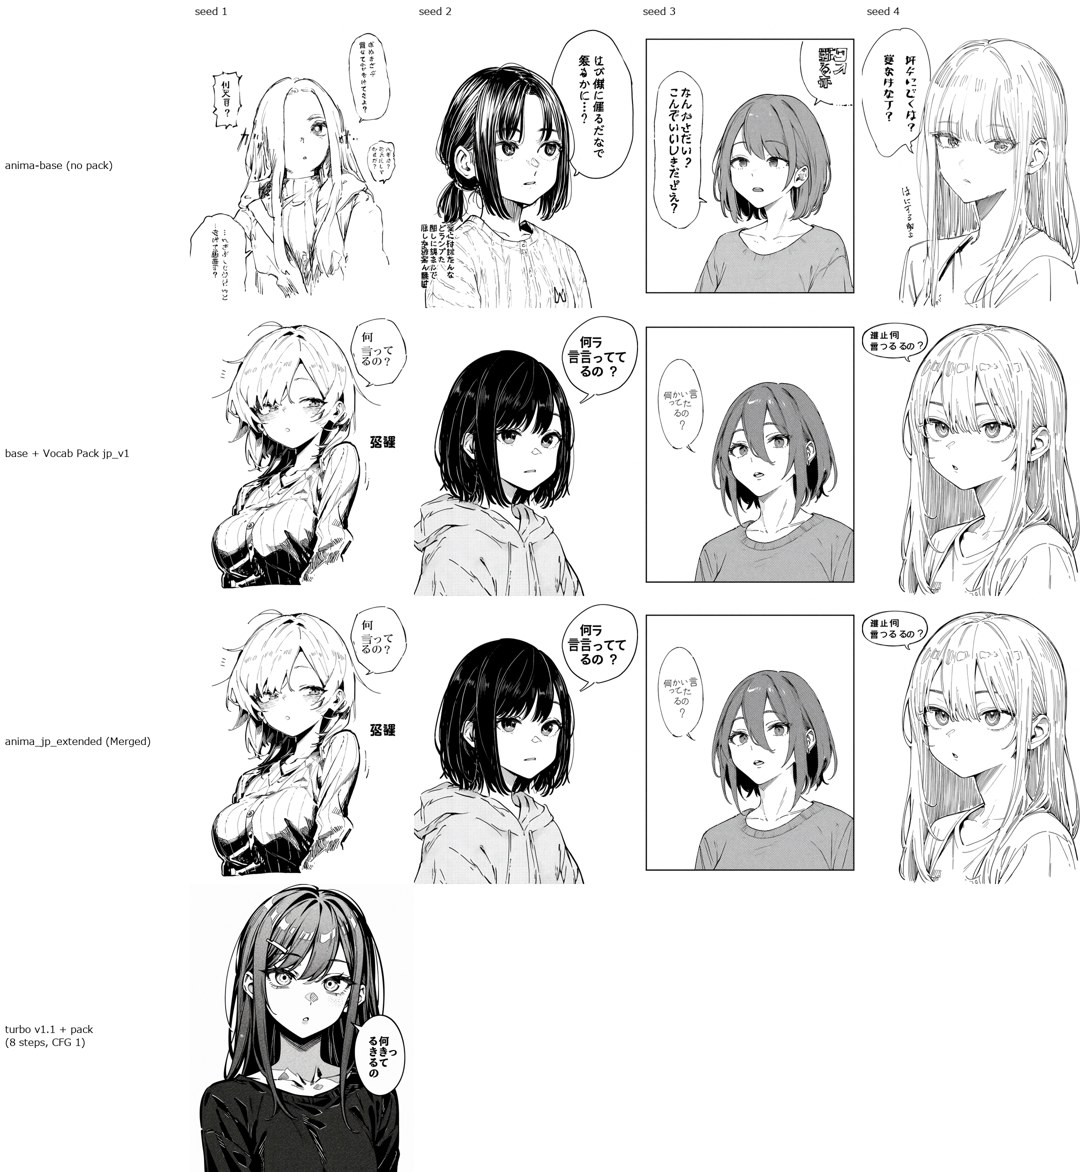
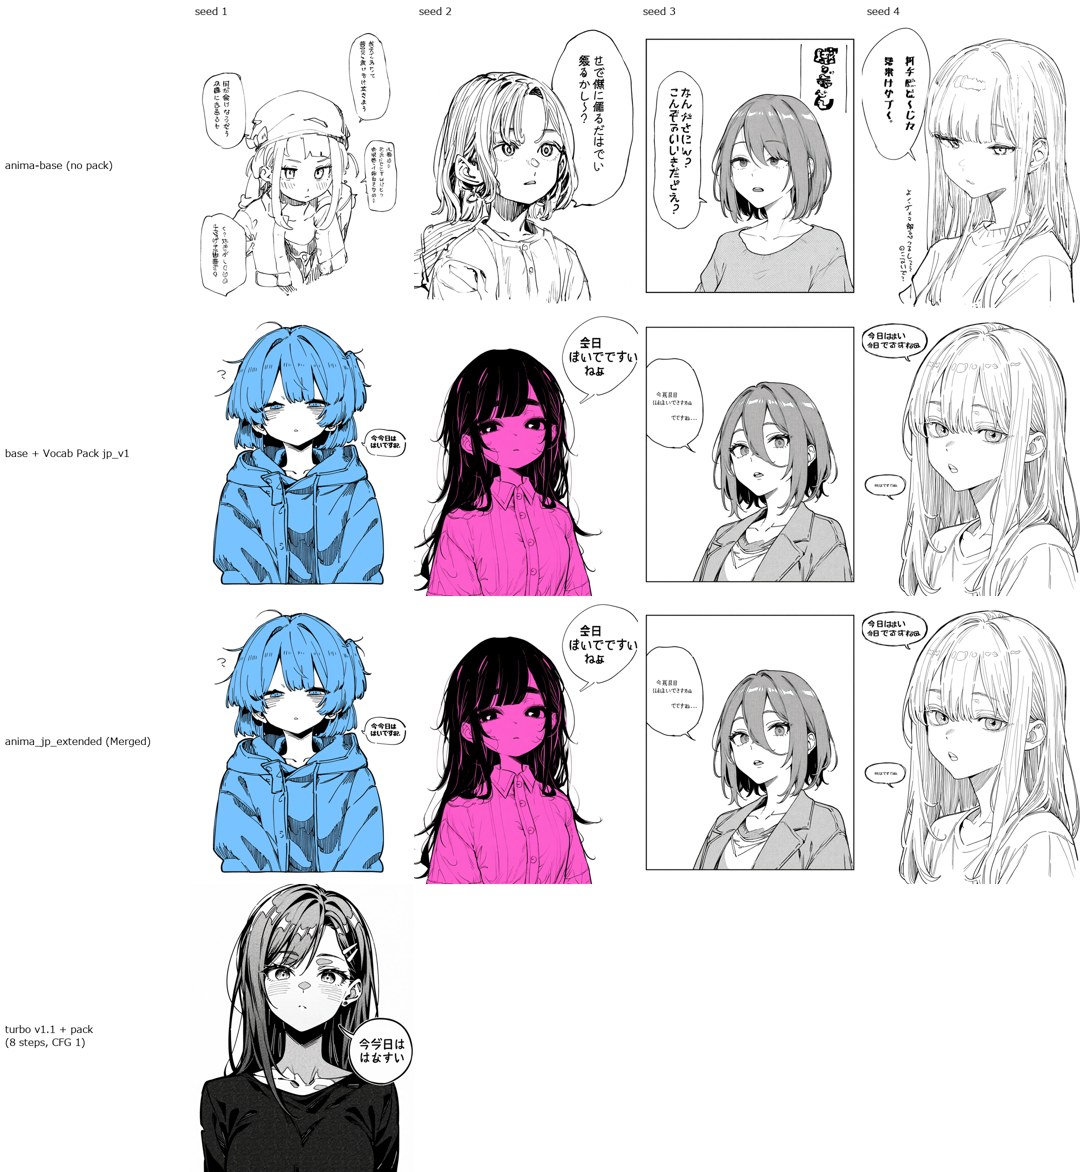
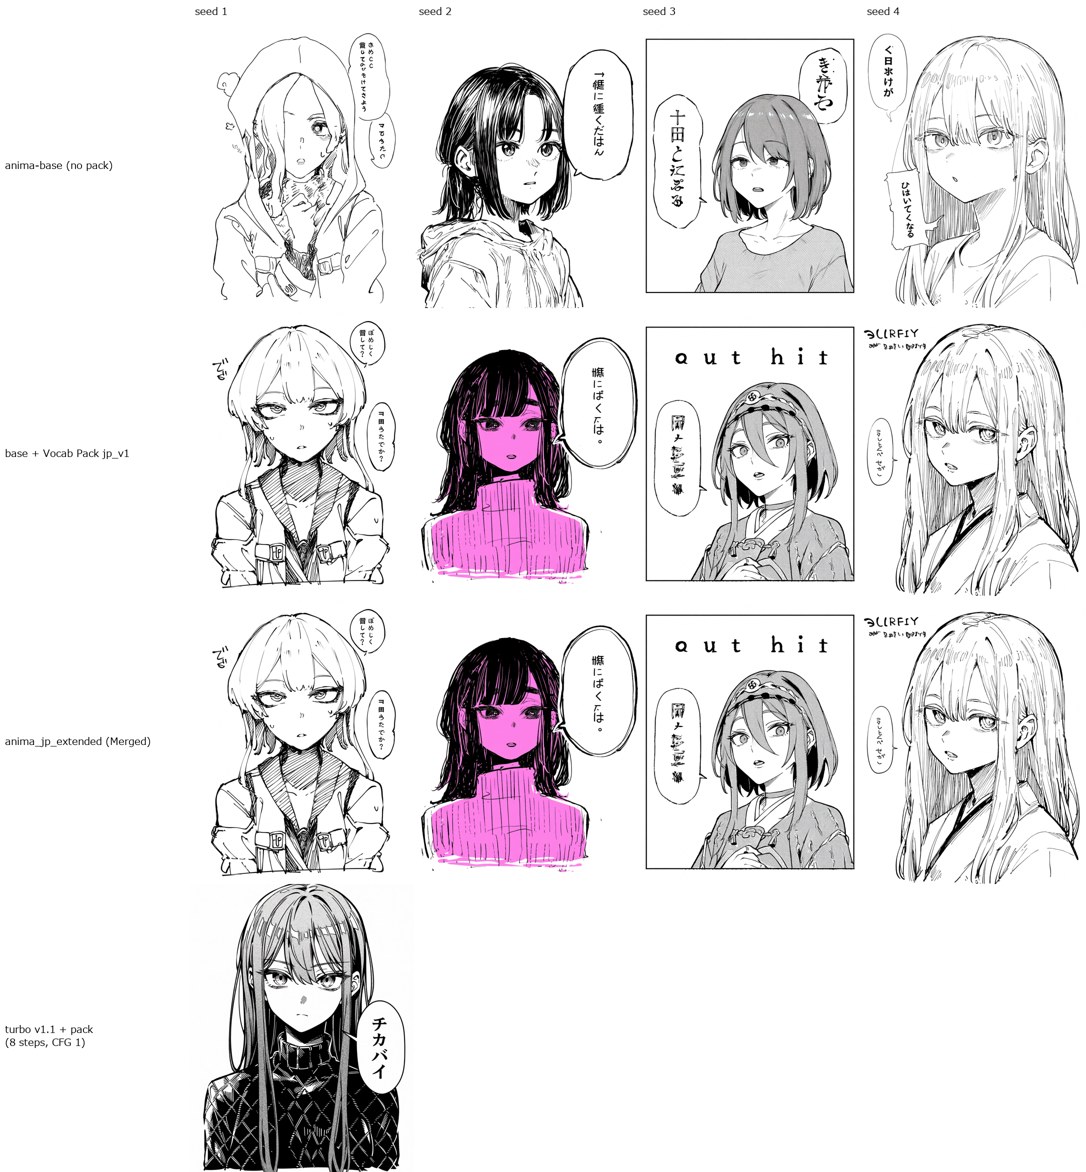
パックなしでは、日本語らしい文字は出るものの、どのセリフも頼んだ文字列にはなりませんでした。パックありでは、短いセリフほど正しく描ける割合が上がりました。10文字の文は全体の形はそれらしくなるものの、途中の文字が抜けたり別の字になったりします。配布元も「10文字以上の行が正確に描けることはまれ」「シードによって結果が変わる」と書いており、今回の結果もその説明どおりでした。
使える漢字を知りたいときは、パックと一緒に配られている anima_cjk_vocab_pack_jp_v1_trained.json に学習済みの文字の一覧が入っています。今回の「薔薇」は、この一覧にない字を選んで試しました。
英語のプロンプトには影響しない
英語のタグだけで作った画像を、パックありとなしで比べたところ、ピクセル単位で同じでした。普段のプロンプトの結果は変わらないので、パックを入れっぱなしにしておいても困りません。
Anima Turbo でも使えるか
KOBO Lab でよく使っている anima-turbo-v1.1 にもパックを足して、各セリフを1枚ずつ(8ステップ、CFG 1)作りました。「ラーメン」は完全に一致し、「おはよう!」「何言ってるの?」「今日はいい天気ですね」は一部一致、「薔薇」は崩れました。1シードずつの結果なので、Turbo の方が文字に強いとまでは言えません。
生成時間とVRAM(RTX 5090 の実測)
| 条件 | 1枚あたり(2枚目以降の中央値) |
|---|---|
| anima-base-v1.0(パックなし) | 8.38 秒 |
| anima-base-v1.0 + Vocab Pack | 8.22 秒 |
| anima_jp_extended(Merged Loader) | 6.80 秒 |
| anima-turbo-v1.1 + Vocab Pack(8ステップ) | 1.27 秒 |
パックを足しても生成時間はほとんど変わりませんでした。最初の1枚だけはモデルの読み込みがあり、10〜72秒かかりました。VRAM の使用量は最大 10.4GB でした。この値は RTX 5090 で測ったもので、VRAM の少ない GPU での動作はまだ試していません。VRAM が足りないときの対処はVRAM 不足の記事にまとめています。
日本語の文章でプロンプトを書けるか(英語と比べた)
セリフではなく、絵の内容そのものを日本語の文章で頼めるかも試しました(2026年10月30日に追加)。同じ内容を日本語と英語の文で書き、同じシードで描き比べています。
| モデル | Anima Base v1.0(30ステップ・CFG 4・er_sde)、Anima Turbo v1.1(10ステップ・CFG 1・euler) |
| パック | それぞれ Vocab Pack なし/あり(Anima Vocab Pack Loader (CJK)、anima_cjk_vocab_pack_jp_v1) |
| 共通 | 832×1216、シード 11・22・33・44・55、頭に masterpiece, best quality, score_7, safe, |
| 枚数 | 3つの内容×日本語・英語×4条件×5シード=120枚 |
| 環境 | RTX 5090 / ComfyUI v0.43.0 |
使ったプロンプト(日本語と、その英語訳)です。
p1_ja: 銀髪で猫耳の女の子が、夕焼けの教室の窓際で本を読んでいる。女の子は青いセーラー服を着ている。
p1_en: A girl with silver hair and cat ears is reading a book by the window of a classroom at sunset. She is wearing a blue sailor uniform.
p2_ja: 赤い傘をさした黒髪の女の子が、雨の夜の商店街を歩いている。街の明かりが濡れた道に映っている。
p2_en: A girl with black hair holding a red umbrella is walking through a shopping street on a rainy night. The city lights are reflected on the wet road.
p3_ja: 1girl, solo, upper body. 金髪のツインテールで、緑色の目をしている。白いパーカーを着て笑っている。
p3_en: 1girl, solo, upper body. She has blonde twintails and green eyes. She is wearing a white hoodie and smiling.| 条件 | 英語の文で指示どおり | 日本語の文で指示どおり |
|---|---|---|
| Base(パックなし) | 15枚中14枚 | 15枚中0枚 |
| Base+パック | (英語は画像がパックなしと同一) | 15枚中0枚 |
| Turbo(パックなし) | 15枚中15枚 | 15枚中0枚 |
| Turbo+パック | (英語は画像がパックなしと同一) | 15枚中0枚 |
「指示どおり」は、髪の色・耳・持ち物・服・場所など、文に書いた主な内容がそろった枚数です(筆者が目で判定)。英語の文では、銀髪と猫耳の女の子が夕焼けの教室で本を読む絵、赤い傘で雨の夜の商店街を歩く絵などがそろって出ました(Base の1枚だけ、猫耳が猫耳型のヘッドホンになりました)。
日本語の文では、内容がそろった画像は1枚もありませんでした。代わりに、吹き出しや日本語らしい文字の入った、指示と関係のない人物の絵になりました。違う内容の日本語の文(教室と雨の商店街)でも、パックなしでは似た絵になりました(同じシードどうしの似ている度合い SSIM が 0.74〜0.80。英語の文どうしでは約0.3)。日本語の文の中身が、絵の内容としてはほとんど伝わっていないと考えられます。
下は、英語の文で作った画像です(上が Base、下が Turbo、左からシード 11〜55)。日本語の文で作った画像は、指示と無関係なうえ、サイトの方針に合わない内容を含むものがあったため、掲載していません。
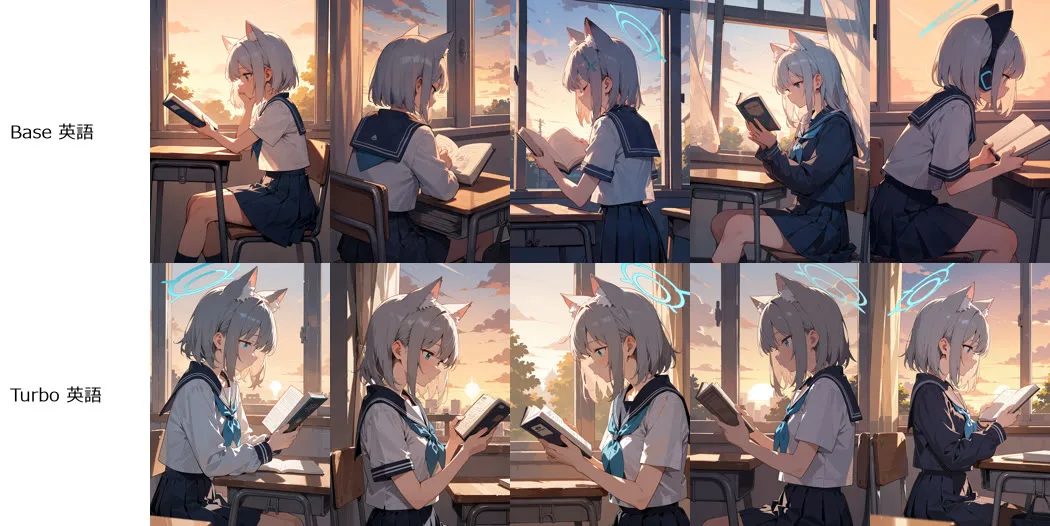
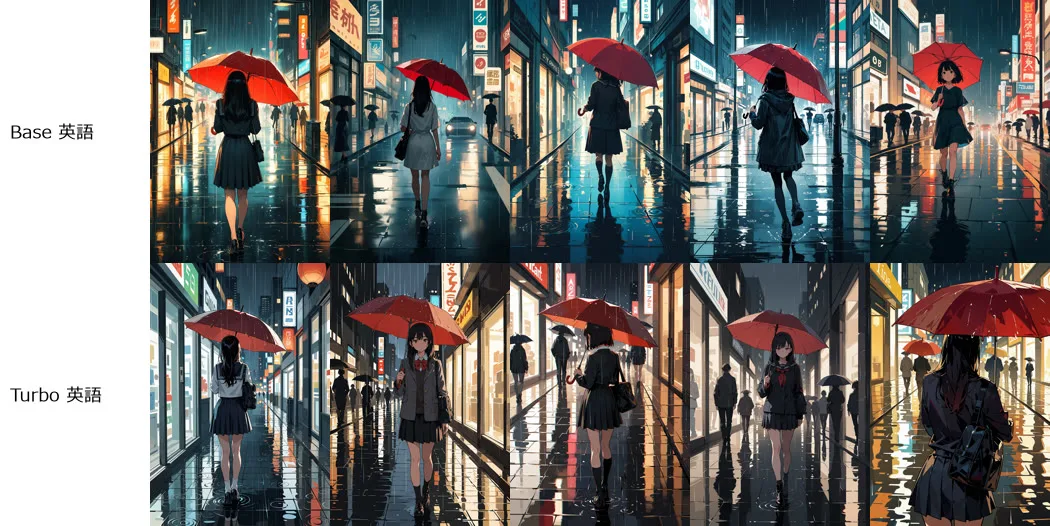
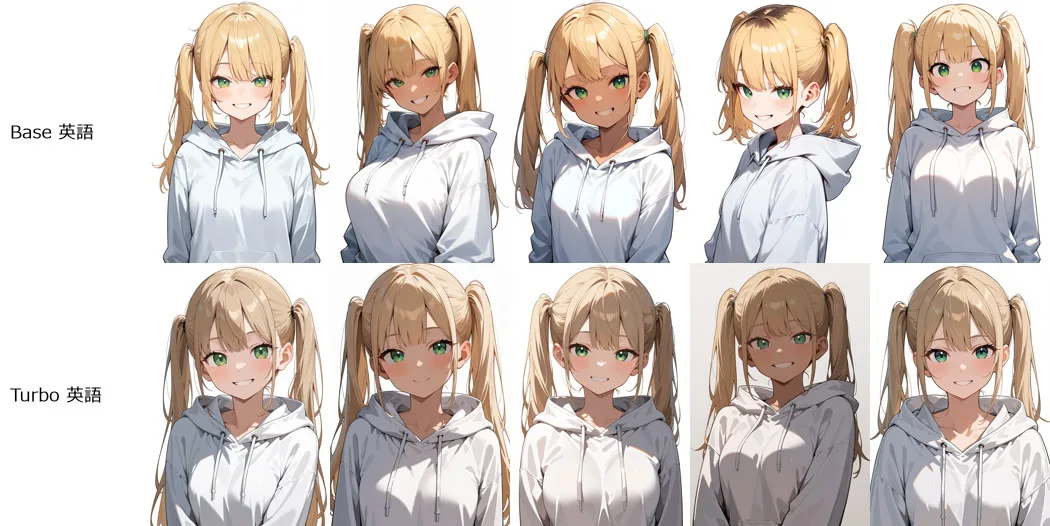
Vocab Pack は、日本語の文字(セリフ)を描くためのものです。パックを入れても、日本語の文で絵の内容を伝えられるようにはなりませんでした。英語の文だけの画像は、パックのあり・なしで1画素も変わりませんでした(30組すべて)。
まとめ:絵の内容(人物・服・場所)は英語のタグか英語の文で書き、日本語は描かせたいセリフの部分(Text reads as "…")だけに使うのが、今回の結果ではいちばん確実です。日本語で考えたプロンプトを英語にしたいときは、ComfyUI と LM Studio を一緒に使う方法のように、ローカルLLMに英語へ直してもらう方法もあります。
ライセンスの注意
anima_jp_extended と CJK Vocab Pack は、元の Anima と同じ circlestone-labs の非商用ライセンスで配布されています。生成した画像を商用で使う予定がある人は、必ず配布ページでライセンスの条件を確認してください。カスタムノード(ComfyUI-Anima_lora-Adapter)自体は MIT ライセンスです。
まだ試していないこと
韓国語・中国語のセリフは、配布元によると、まだ描画の学習がされていません。横書きと縦書きの違いも、配布元が「横書きは未測定」としています。
筆者の手元でも、VRAM 8〜16GB の GPU での動作と、LoRA との組み合わせ(配布元は「どの Anima の LoRA も重ねられる」と説明)は未確認です。中国語・韓国語の文で絵の内容を書いた場合も試していません(日本語の文は2026年10月30日に検証済み)。
よくある質問(FAQ)
Q. 標準の Anima で日本語のセリフを描く方法はありますか?
今回の検証では、標準の Anima では日本語らしい文字は出たものの、頼んだセリフどおりになった画像は1枚もありませんでした。指定した日本語を描くには CJK Vocab Pack か、それを組み込んだ anima_jp_extended が必要です。
Q. anima_jp_extended とパックのどちらを使えばいいですか?
結果は同じなので、anima-base-v1.0 を持っているならパック(約285MB)、持っていないなら anima_jp_extended(約4.47GB)が手軽です。
Q. 長いセリフを正確に描くコツはありますか?
今回の検証では、10文字の文は4シードすべてで崩れました。短く区切るか、何枚か作って良いものを選ぶ、または画像編集ソフトで後から文字を入れるのが現実的です。
Q. パックを入れると普段の絵が変わりますか?
英語だけのプロンプトでは、パックありとなしでピクセル単位で同じ画像になりました。日本語を含むプロンプトのときだけ影響します。
Q. 絵の内容を日本語の文章で書いても大丈夫ですか?
おすすめしません。日本語の文で書いた60枚では、指示した内容がそろった画像は0枚で、指示にない内容の絵も出ました。英語の文なら同じ内容で30枚中29枚がそろいました。日本語はセリフの部分だけに使ってください。
検証メモ
- 文字の判定:完全一致・一部一致・崩れは、筆者が目で見て分けました。パックありの枚数は、シード1〜4の4枚ずつです。
- Turbo:配布元は「パックは anima-base-v1.0 でしか学習・測定していない」としており、Turbo での動作は保証されていません。
- 方法AとBの速さ:方法Aの方が1枚あたり約1.4秒速くなりました。出てくる画像は同じですが、速さが違う原因までは確かめていません。
参考にした公式情報
- sorryhyun/anima-jp-extended(Hugging Face)
- sorryhyun/anima-vocab-pack-cjk(Hugging Face)
- ComfyUI-Anima_lora-Adapter(GitHub)
- circlestone-labs/Anima(Hugging Face)