ローカルLLM

ローカルLLM

Strataの量子化の選び方|Q2_0・IQ2_XS・IQ3_XXS・IQ3_S・Coder・Swift 1.5の違い

Strataで Qwen3.8-Flash-Next を動かす際の量子化の選び方。Q2_0・IQ2_XS・IQ3_XXS・IQ3_S と Coder・Swift 1.5 の違い、RAM別の早見表、筆者のQ2_0・IQ3_Sの実測を載せます。
ローカルLLM

Strataは安全?インストーラの中身と未署名exeの事実、VMで試す前に知ること

Strataは安全か。Linux・Windowsのインストーラの中身、Windows版のインストーラが未署名である事実、筆者が確かめたハッシュと署名、作者の自己申告の通信の説明を整理し、安全に試す順番を紹介します。
ローカルLLM

Strataのエラー対処集|起動しない・遅い・RAM不足のときに確かめること

Strataで起きやすいトラブルを症状ごとにまとめました。起動が遅い、RAM不足でエンジンが止まる、ドライバが古い、ポート8080が使われている、更新後に遅くなったときの、公式の資料にある対処と既知のIssueを紹介します。
PC・GPU環境

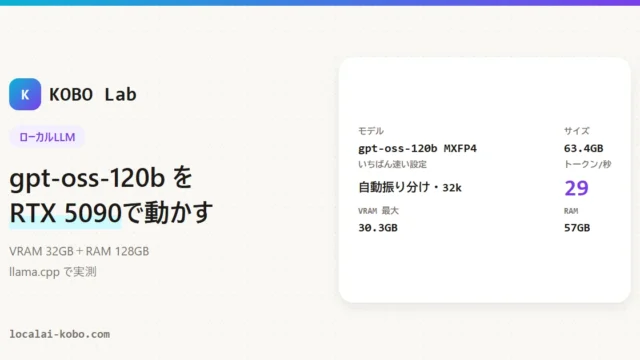
gpt-oss-120bはRTX 5090とRAM 128GBで動く?llama.cppで実測

OpenAI の gpt-oss-120b(63GB)を、RTX 5090(VRAM 32GB)と RAM 128GB の PC で llama.cpp を使って動かしました。いちばん速い設定で約29トークン/秒。必要なメモリ、起動コマンド、振り分けの比較。
PC・GPU環境

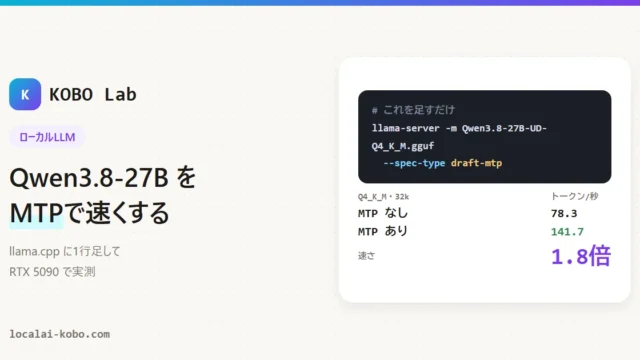
Qwen3.8-27Bをllama.cppのMTPで速くする設定【RTX 5090実測】

Qwen3.8-27B を llama.cpp で動かすとき、--spec-type draft-mtp を足すだけで RTX 5090 で 78→142 トークン/秒(約1.8倍)になりました。起動コマンド、先読み数の比較、Q6_K と128k の結果、効かないときのチェック。
ローカルLLM

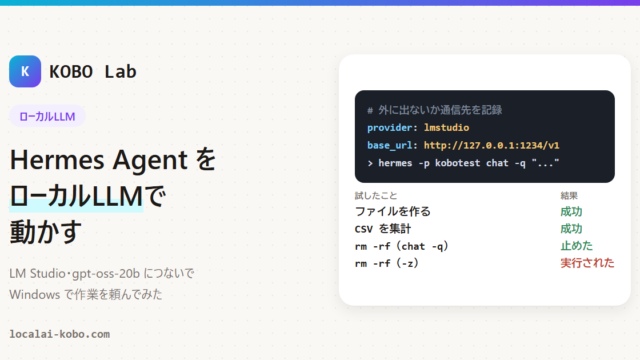
Hermes AgentをローカルLLMで動かす方法|LM Studio×gpt-oss-20bで実際に試した【Windows】

Hermes AgentをLM Studioのgpt-oss-20bで動かした実測。通信先・VRAM・危ないコマンドの扱いも確認。
クラウドAI

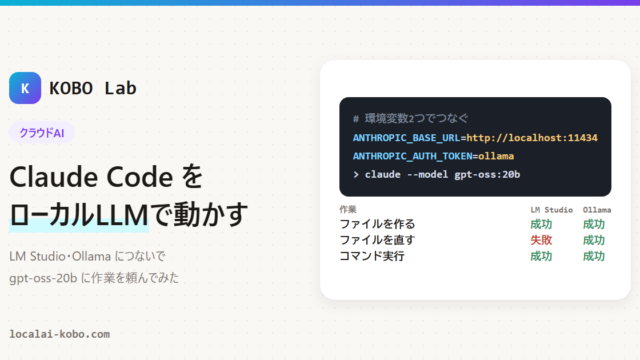
Claude CodeをローカルLLMで動かす方法|LM Studio・Ollamaとのつなぎ方と実際の使用感

Claude Codeは環境変数を3〜4つ設定するだけで、LM StudioやOllamaのローカルLLMにつなげます。Windowsでの設定手順と、gpt-oss-20bにファイル作成・修正・コマンド実行を頼んだ結果を、失敗も含めて紹介します。
PC・GPU環境

ComfyUIとLM Studioを一緒に使う方法|プロンプト自動生成とVRAMの取り合い対策を実測

ComfyUIとLM Studioを同じPCで使うとVRAMを取り合います。LM Studioに英語プロンプトを書かせて画像を作る手順と、VRAMのピーク(対策なし20.7GB、いちばん低い方法で15.3GB)をRTX 5090で実測。
ローカルLLM

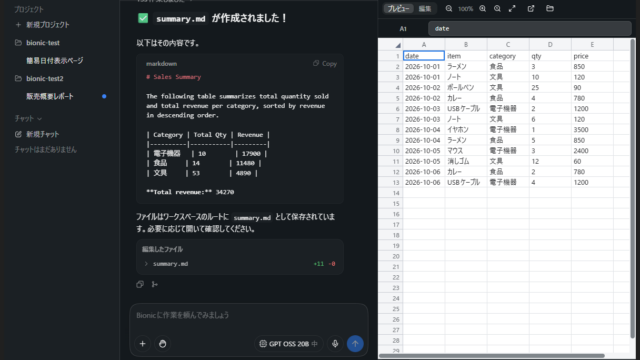
LM Studio Bionicとは?使い方とLM Studioとの違い|ローカルLLMで実際に試した結果

LM Studio Bionicは、LM Studioの開発元が出したAIエージェントアプリです。LM Studioとの違い、無料で使えるローカルモデルでの使い方、実際に頼んだ作業の結果と注意点を、Windows版1.1.9で確かめてまとめました。