MOSS-Image は、OpenMOSS が公開した画像生成モデルです。英語と中国語の文字をきれいに描けて、長い指示(約4,000トークン)や、JSON で「どこに何を置くか」を指定するレイアウト機能もあります。ライセンスは Apache-2.0 です。
ComfyUI が公式に対応していて、テンプレートも入っています。この記事では、公式テンプレートの設定で RTX 5090 を使い、軽い int8 版と大きい bf16 版の生成時間と VRAM を測りました。VRAM が少ない環境を想定した簡易テストもしています。
試した環境
| 項目 | 内容 |
|---|---|
| GPU | NVIDIA GeForce RTX 5090(VRAM 32GB) |
| CPU / メモリ | AMD Ryzen 9 9950X3D / 128GB |
| OS | Windows 11 |
| ドライバ | NVIDIA 621.01 |
| ComfyUI | master(コミット b5a43215、2026-10-30)ポータブル版、カスタムノードなし |
| PyTorch | 2.14.0+cu130 |
| 確認した日 | 2026年10月31日 |
MOSS-Image はどんなモデル?
| 項目 | 内容 |
|---|---|
| 作った人 | OpenMOSS(2026-10-11 公開) |
| 本体 | 50億パラメータの単一ストリーム DiT(画像を作る部分) |
| テキストエンコーダー | Qwen3.5 9B(指示の文章を読む部分) |
| VAE | FLUX.2 の small VAE(絵に戻す部分) |
| 得意なこと | 英語・中国語の文字、長い指示、JSON でのレイアウト指定 |
| ライセンス | Apache-2.0 |
| ComfyUI | 0.42.0 以上 |
モデルは2種類あります。SFT は仕上げの学習まで済んだ版で、テンプレートはこちらを使います。Base は LoRA などを学習するときの元にする版です。
必要なファイルと置き場所
| ファイル | 置き場所(ComfyUI/models/) | サイズ |
|---|---|---|
| moss_image_sft_int8_convrot.safetensors(テンプレート) | diffusion_models | 5.41GB |
| qwen3.5_9b_w4a8_gptq.safetensors(テンプレート) | text_encoders | 7.34GB |
| flux2-vae_small.safetensors | vae | 0.25GB |
| moss_image_sft_bf16.safetensors(大きい版) | diffusion_models | 10.16GB |
| qwen3.5_9b_bf16.safetensors(大きい版) | text_encoders | 19.31GB |
テキストエンコーダーには int8 版(9.75GB)もあります。迷ったら、テンプレートと同じ int8+w4a8 の組み合わせにしてください。
使い方(公式テンプレート)
- ComfyUI を 0.42.0 以上にする(ComfyUI のアップデート方法)
- 上のファイルを置き場所に入れて、ComfyUI を起動し直す
- テンプレートの一覧から「MOSS-Image」の Text to Image を開く
- プロンプトを書いて実行する
テンプレートの設定は、25ステップ、CFG 2.5、サンプラー er_sde、スケジューラー simple です。公式の Base モデルの説明では 50ステップ・CFG 3・euler が勧められていて、テンプレートとは少し違います。今回はテンプレートの設定で測りました。
テンプレートには、短い指示を AI が長い指示に書き直す機能(TextGenerate)も入っていますが、今回は使わず、英語の指示をそのまま入れました。
- MOSS-Image テキストから画像(.json)ComfyUI 公式テンプレートと同じもの
RTX 5090 での生成時間と VRAM(実測)
机の上の PC と「KOBO Lab」と書かれたマグカップの写真風の指示(英語)で、シードを変えて測りました。時間は ComfyUI に送ってから画像が保存されるまでです。
| 組み合わせ | 解像度 | 1枚目(読み込み込み) | 2枚目以降 | VRAM 最大 | ComfyUI の RAM |
|---|---|---|---|---|---|
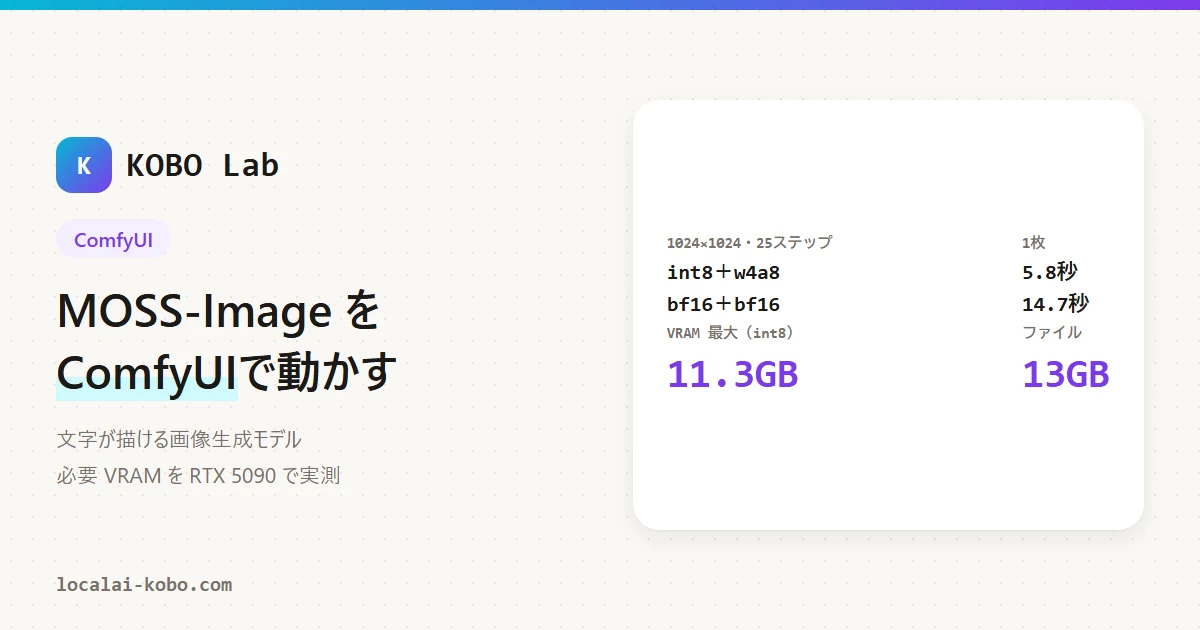
| int8+w4a8(テンプレート) | 1024×1024 | 135秒 | 5.8秒 | 11.3GB | 13GB |
| int8+w4a8(テンプレート) | 1536×1536 | — | 14秒 | 11.6GB | 13GB |
| bf16+bf16 | 1024×1024 | 263秒 | 14.7秒 | 25.9GB | 27GB |
「—」はこの測定で記録していません。VRAM 最大は、Windows の画面表示などのぶん(約1GB)も含めた GPU 全体の使用量で、2枚目の回の値です(int8 の1枚目は約11.4GB)。
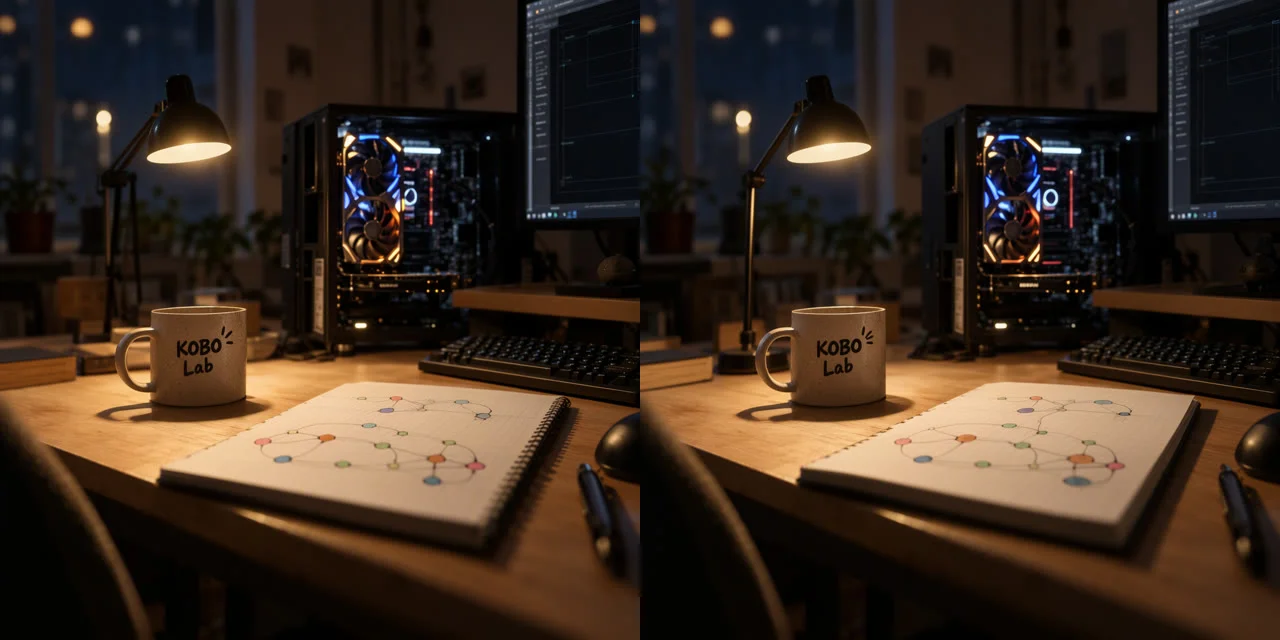
どちらも、指示に入れた「KOBO Lab」の文字がマグカップに描かれました。int8 と bf16 で構図や細部は変わりますが、今回の1組ではどちらも破綻はありません。
RTX 5090 以外の人へ(VRAM が少ない環境を想定した簡易テスト)
ComfyUI の --reserve-vram で VRAM の一部を使わずに残し、使える VRAM が少ない環境を想定して試しました。
| 想定(int8+w4a8・1024×1024) | 結果 | 2枚目の時間 | VRAM 最大(GPU 全体) | ComfyUI の RAM |
|---|---|---|---|---|
--reserve-vram 16 を指定 | 生成できた | 5.8秒 | 11.2GB | 13GB |
--reserve-vram 20 を指定 | 生成できた | 5.8秒 | 11.3GB | 13GB |
| 32GB をそのまま | 生成できた | 5.8秒 | 11.3GB | 13GB |
3つの条件で VRAM の最大は 11.2〜11.3GB とほぼ同じでした。この表は、少ない VRAM で動くかを確かめたものではなく、この設定の RTX 5090 での使用量が約11.3GB だったことを示しています。
8GB 相当は試していません。VRAM の少なさは VRAM 不足の対処法 も参考にしてください。
小型テキストエンコーダーで軽くできる?
Qwen3.5 9B の代わりに、0.8B・2B・4B の小さいモデルを使えるようにする「mini encoder」という第三者の実験的なものが Hugging Face で公開されています(Apache-2.0)。ファイルは 約1〜4GB で、専用のカスタムノードと、モデルの大きさ・量子化の種類に合わせた「アダプター」というファイルを組み合わせて使います。
作者の説明では、元の 9B と比べた似ている度合い(コサイン類似度)は 0.85〜0.90 で、アダプターの組み合わせを間違えると画質が落ちるとされています。公式のものではなく、今回は試していません。
つまずきやすいところ
- テンプレートが出てこない:ComfyUI が 0.42.0 より古いと出ません。
- テキストエンコーダーが選べない:
models\text_encodersに入れたあと、ComfyUI を起動し直してください。 - VAE を間違える:MOSS-Image のテンプレートは
flux2-vae_small.safetensorsを使います。FLUX.2 の通常の VAE(flux2-vae.safetensors)とは別のファイルです。 - LoRA を学習したい:公式の説明では、LoRA の学習には SFT ではなく Base を使います。
よくある質問(FAQ)
Q. MOSS-Image に必要な VRAM はどれくらいですか?
RTX 5090 で公式テンプレート(int8+w4a8・1024×1024)を使うと、GPU 全体で最大 約11.3GBでした。VRAM が少ない環境を想定した簡易テストの結果は本文の表を見てください(実際の GPU での動作を保証するものではありません)。
Q. MOSS-Image は VRAM 8GB で動きますか?
公式の資料では確かめられず、この記事でも試していません。
Q. MOSS-Image は日本語の文字を描けますか?
公式に得意とされているのは英語と中国語の文字です。日本語は今回試していません。
Q. MOSS-Image は商用利用できますか?
ライセンスは Apache-2.0 で、商用利用もできます。
Q. SFT と Base はどちらを使えばいいですか?
画像を作るなら SFT(テンプレートが使う版)、LoRA を学習するなら Base です。
Q. 1枚にどれくらいかかりますか?
RTX 5090 で 1024×1024・25ステップが、int8 版で約5.8秒でした(2枚目以降)。
まとめ
MOSS-Image は、ComfyUI の公式テンプレートで、追加のノードなしで動きます。RTX 5090 では、軽い int8 版で 1024×1024 が約5.8秒でした(今回のテスト条件で)。文字の描画やレイアウト指定を試したい人は、まずテンプレートどおりの int8+w4a8 から始めるのがおすすめです。
検証メモ
- 2枚目以降の時間:同じ指示でシードだけ変えたので、指示の読み込み(テキストエンコーダー)は1枚目だけ動いています。
- 画質:int8 と bf16 の比較は1組だけなので、優劣は言えません。
- 試していないこと:VRAM 8GB での動作、日本語の文字、mini encoder、テンプレートの TextGenerate。